(이 글은 본인이 작성한 사내 Confluence 문서 글을 그대로 옮겨왔다.)
AMS(이투스에서 오프라인 학원의 관리를 위한 시스템) 에서 장애가 발생했다 (2022년 7월 12일 13시 21분) 원인은 컨넥션 누수로 인한 DB deadlock 으로 보인다.
해당 문제를 조사하던 중 AMS는 Multi Datasource 를 Routing 하여 writeDB와 readonlyDB 두 가지를 나눠 쓰는 것을 확인했다. (RDS replica 사용)
그런데 .. 분기처리가 전혀 되지 않고 @Transactionl(readonly = true) 어노테이션을 달아도 무조건 writeDB로 요청이 가게된다.
심지어 Hikari Pool 설정도 하나도 먹고 있지 않고 있다 ..
우선 아래 순서로 3가지 작업이 필요할 것 같다.
- 왜 Routing이 안되는지 살펴보고 Routing부터 되게끔
- Hikari 설정이 왜 안먹는지 찾고 수정
- 컨넥션 누수가 왜 생겼는지 파악 (이게 뭐 파악한다고 되나..?)
1. Routing 왜않되 ..
isReadOnly 값이 true가 떠야 비로소 readOnly DataBase 에서 컨넥션을 가져오려고 하면서 Default Hikari 설정으로 인해 컨넥션 풀을 생성하는 모습이다. (디버거에서 강제로 true를 박은것이다.)
이렇게 되야 정상인건데 문제는 저 isReadOnly값이 항상 false가 떠서 readOnly DataBase 로 가지 않는다 ..
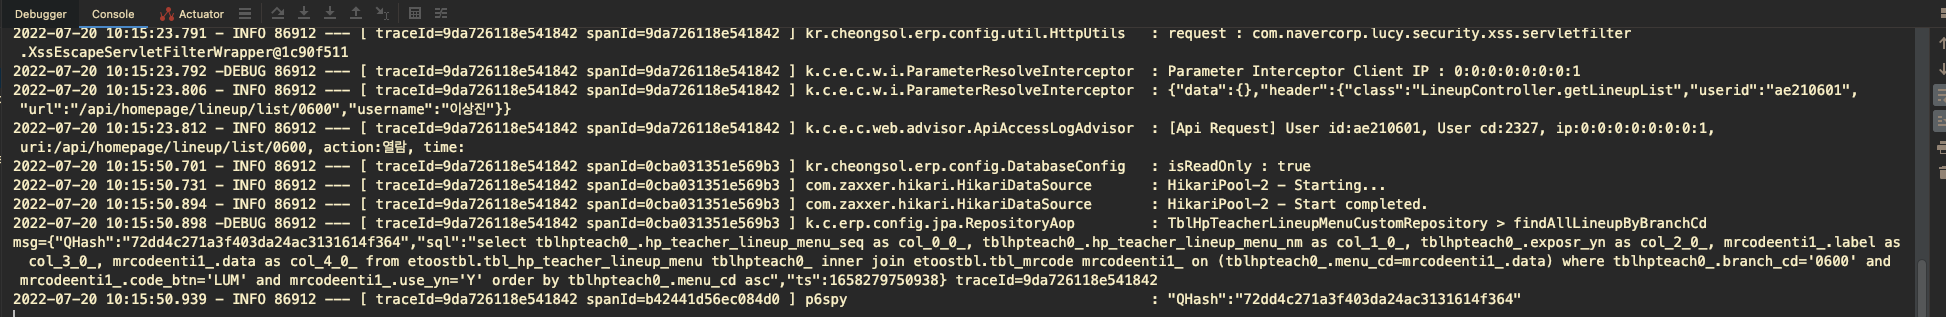
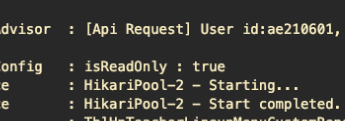
정상적인 케이스라면 이렇게 되어야 한다..
http://localhost:8080/api/homepage/lineup/list/0600 이 요청은 @Transactionl(readonly = true) 가 적용된 url 이다.
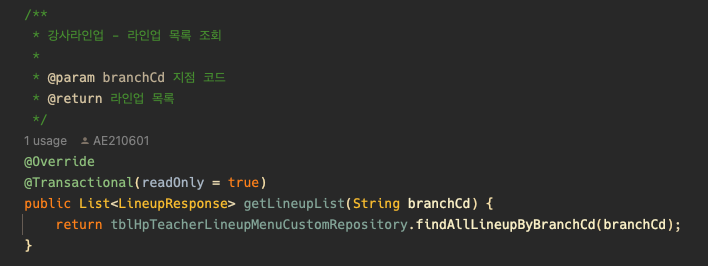
기대 상황은 isReadOnly : true로 나오면서 readOnly DataBase 로 요청이 가야한다.
그런데 Postman으로 요청 날려보면


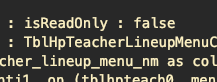
왜 false가 뜨는거냐고 ..
오오

찾았다. 이걸 return dataSourceTransactionManager; 으로 수정하면 우선 readOnly DataBase 로 라우팅 되는것을 확인했다
(그런데 틀렸다. 미리 말하지만 이거 원인 아니다.)
우선 이와같이 코딩된 이유는 써있듯이 JPA와 Mybatis 를 동시에 사용하기 위한 TransactionManager로 ChainedTransacionManager 를 쓰는데..
꼭 JpaTransactionManager 와 DataSourceTransactionManger 두개가 필요한건지, 하나만으로는 안되는건지 (이렇게 하면 Routing 되는 걸 확인했으니까)
아니면 ChainedTransactionManager를 그대로 쓰면서 분기가 되게끔 할 수 있는건지 ..
(지금까지 이 코드로 돌아갔고 위 처럼 수정하면 제대로 돌아가는지 장담이 안되니까)
우선 TransactionManager에 대해서 좀더 찾아보도록 하자
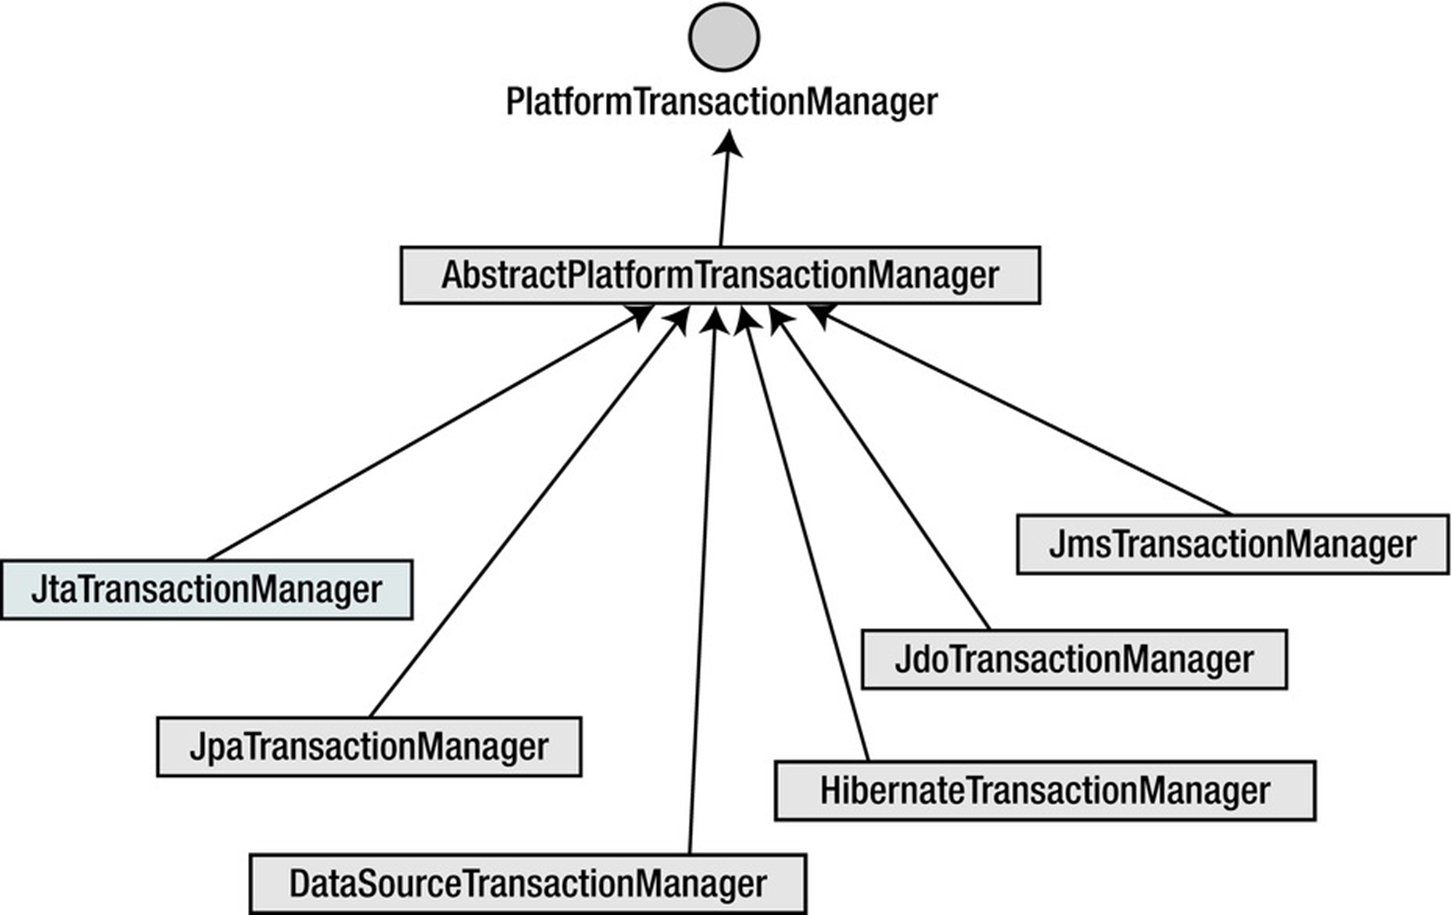
ChainedTransactionManager VS JtaTransactionManager
두가지 종류의 TransactionManager 모두 PlatformTransactionManager를 기본으로 사용.
ChainedTransactionManager의 경우 기존 Datasource마다 가지고있는 TransactionManager를 체인형태로 등록, 연결하여 트랜잭션을 순차적으로 실행시켜준다는 특징이 있으며 이러한 특징으로 인해 하나의 트랜잭션 커밋 완료후, 다음 트랜잭션 커밋과정에서 오류가 발생할 경우 이전에 커밋된 내용에 대해서는 롤백을 보장 할 수 없다.
이러한 상황을 줄여주기 위해서는 실행순서를 고려한 Chain 등록이 필요하다.
그와는 다르게 JTATransactionManager는 하나의 트랜잭션 매니저로 묶어서 관리하여 한번의 커밋/롤백을 진행하여 완전한 트랜잭션을 보장할 수 있다. 다만 실행속도가 비교적 느릴수 있다는 단점이 존재한다.
그런데 다시 말하지만 틀렸다. 이게 아니라p6spy 가 원인이었다.
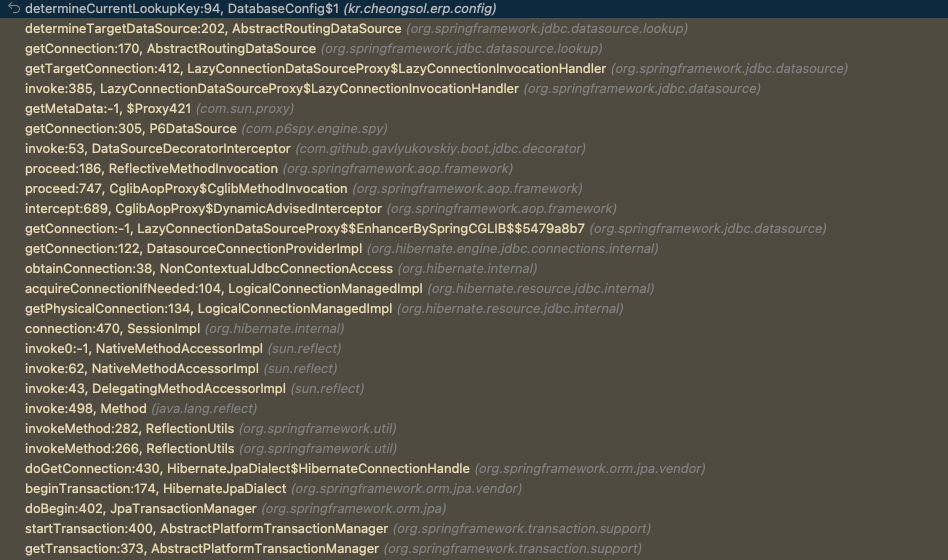
조사하던중 https://devs0n.tistory.com/61 이 블로그의 글을 보게되어 혹시나 싶어 디버깅에서 p6spy쪽 콜 스택을 보았는데
블로그의 내용 대로 P6spy 에서 getMetaData를 통해 실제 컨넥션을 가져오게 되고 이 때문에 LazyConnectionDataSourceProxy로 감싸더라도 가져온 컨넥션을 사용하다 보니 Routing이 정상적으로 동작하지 않은 것이었다 ..
p6spy 를 전부 제거하고 돌리면 Routing이 정상적으로 되며 ro db에서 컨넥션을 가져오는 것을 확인 할 수 있다.
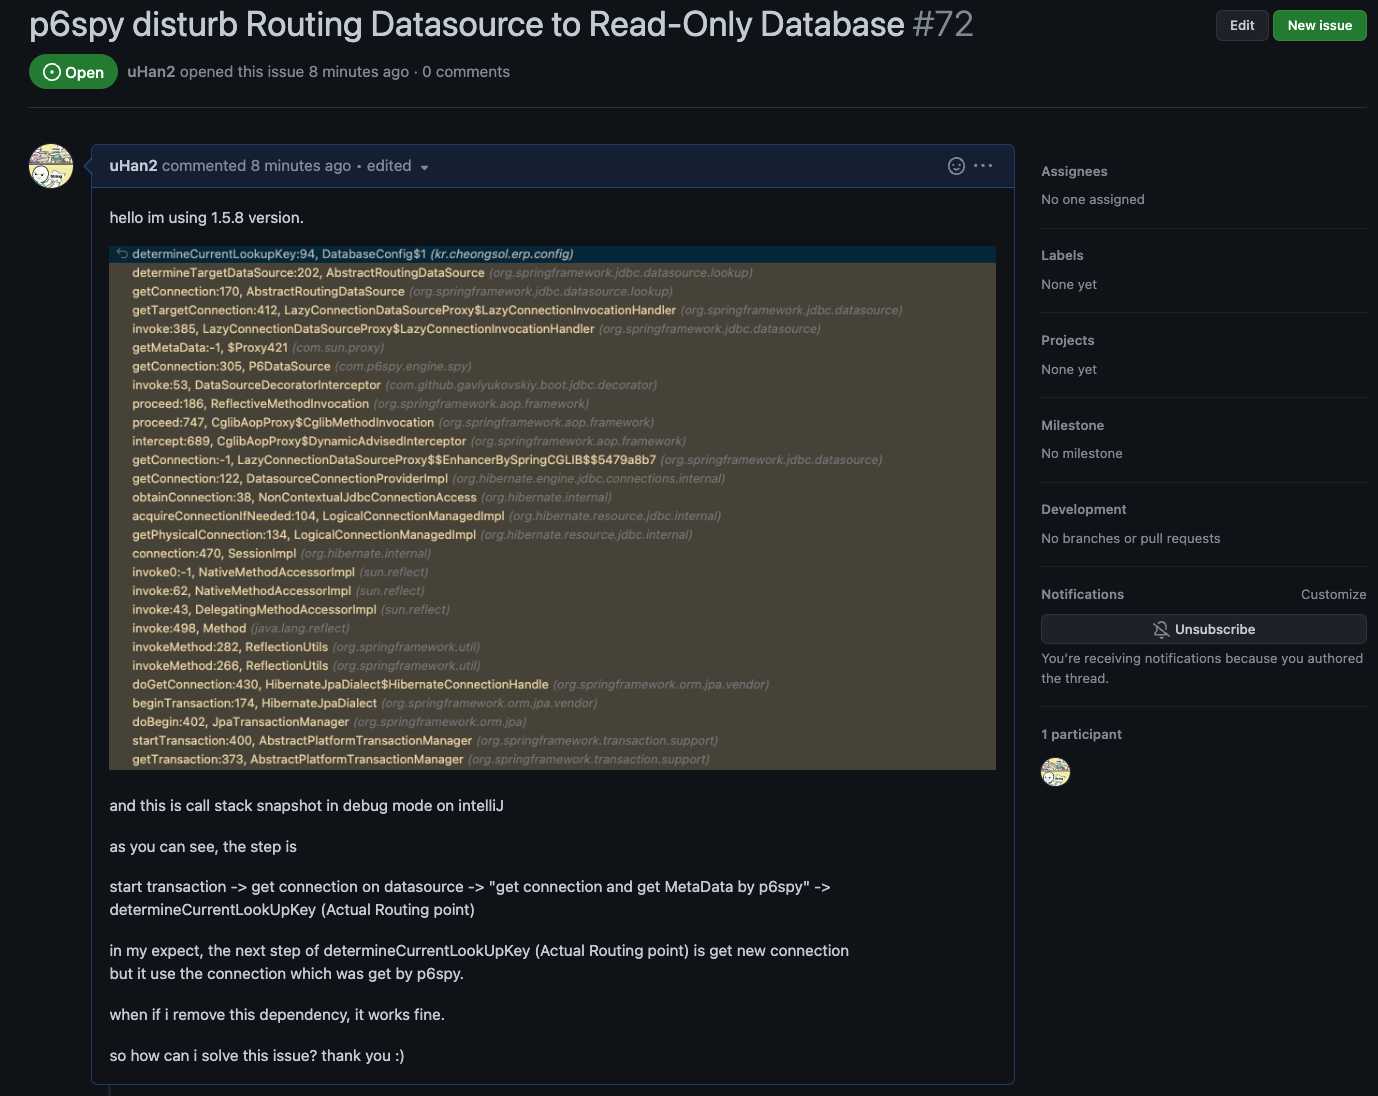
우선 해당 오픈소스 측에 issue 제기를 해놓았다. 답변이 달릴지는 모르겠다 ..
p6spy를 쓰면서는 별 수 없는 것 같다. (p6DataSource를 이용해서 어떻게 하면 될 것 같긴한데 ..)
어차피 현재 p6spy는 실행된 query에 대한 log 가 주요 용도이기 때문에 그냥 다른 logger (logback 등) 으로 교체 하는 작업으로 진행해야 할 것 같다.
우선 logback으로 몇 가지 기본 옵션만 넣고 수행했을때 log 는 잘 찍히는 것으로 확인되었다.
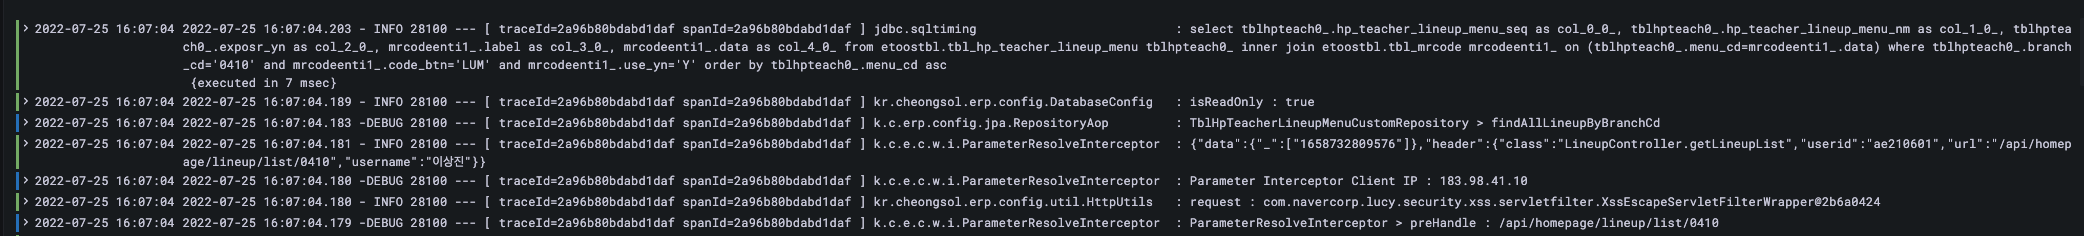
isReadOnly가 드디어 true로 찍힌다 ..
한가지 확인해봐야 할 것은 기존에 p6spy를 쓰면서 쿼리로그를 따로 분리해 놓았다. (로그를 볼때 쿼리 때문에 한눈에 보기 힘들다는 이유로)
logback을 이용해서 기존과 로그를 똑같이 맞출 수 있는지 확인해봐야할 것 같다.(일단 된다. 얏호)
p6spy → logback
본격적으로 p6spy를 logback으로 converting 하기로 했다.
허나 converting 하면서 문제가 생겼는데 우선 기존에 query log는 아래와 같이 작성된다.
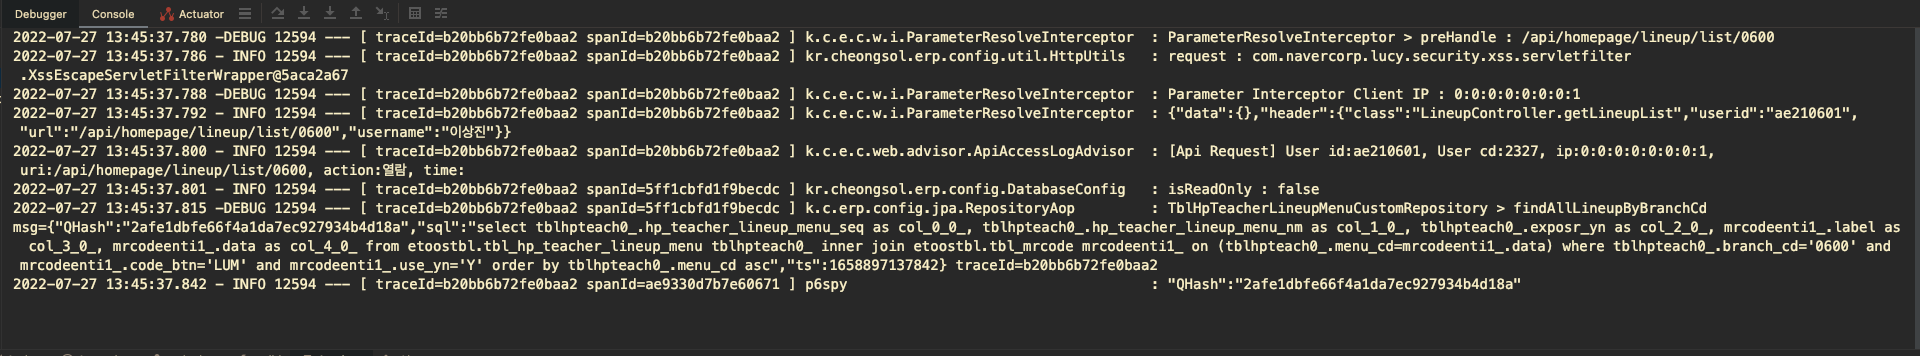
우리는 QHash 라는 값으로 query마다 Hash value 를 부여하고 Query 본문은 Log 를 분리하여 따로 저장하고 있었다. 하지만 logback을 사용 하여 Query Log 를 출력하면
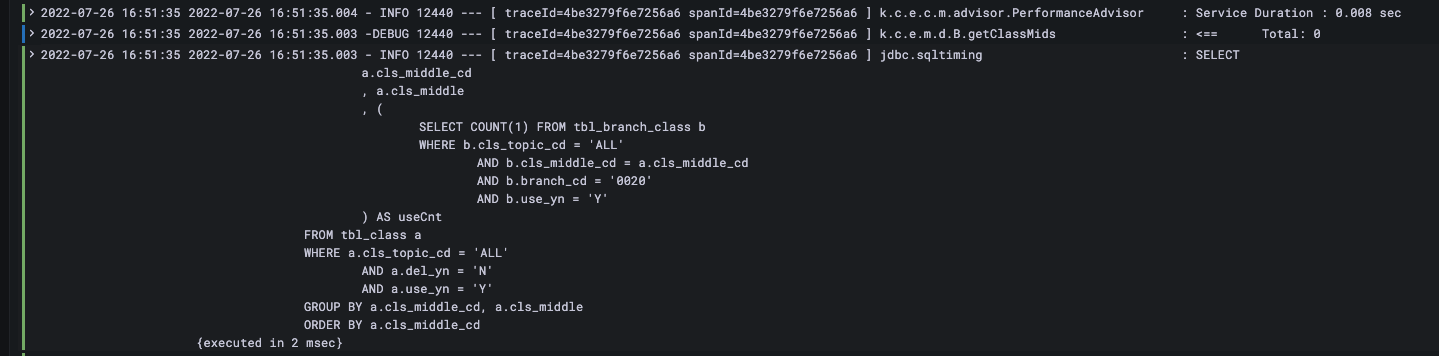
이처럼 Query Log 가 같이 출력되는 현상이 있다. Query 가 길어 한눈에 보기 힘들어서 분리했는데 logback 으로 전환하기 위해서 다시 하나로 봐야한다? 이건 아닌 것 같다.
기존의 방식을 유지하면서 (Query Log 분리) spy의 구현체만 바꾸고 싶었다.
이러쿵 저러쿵 삽질 끝에.. 결국 해냈다.


보면 본 로그에는 QHash 만을 남기고 이 키값으로 Query 를 따로 조회하는 모습을 볼 수 있다. 기존의 방식이 이러했다.

어떤가 똑같지 아니한가. 여기서 차이는 저 QHash를 출력하는 구현체가 p6spy 에서 jdbc.sqltiming 으로 바꿔주었다.

드디어 isReadOnly 도 true 로 잘 찍힌다..

꺠알같이 execTime : 59 msec 처럼 쿼리 수행시간 도 넣어줬다.
음 우선 간단히 설명하자면
p6spy 대신 log4jdbc를 사용하면서 마찬가지로 custom객체를 사용할 수 있는데 (커스텀 메시지 포매팅을 위한)

여기서 사용할 delegator를 지정했고 (기본적으로는 net.sf.log4jdbc.log.slf4j.Slf4jSpyLogDelegator 이것을 쓰라고 아마 블로그 등에 나와있을 것이다. 하지만 커스텀을 위해 직접 만든 클래스를 지정했다.)
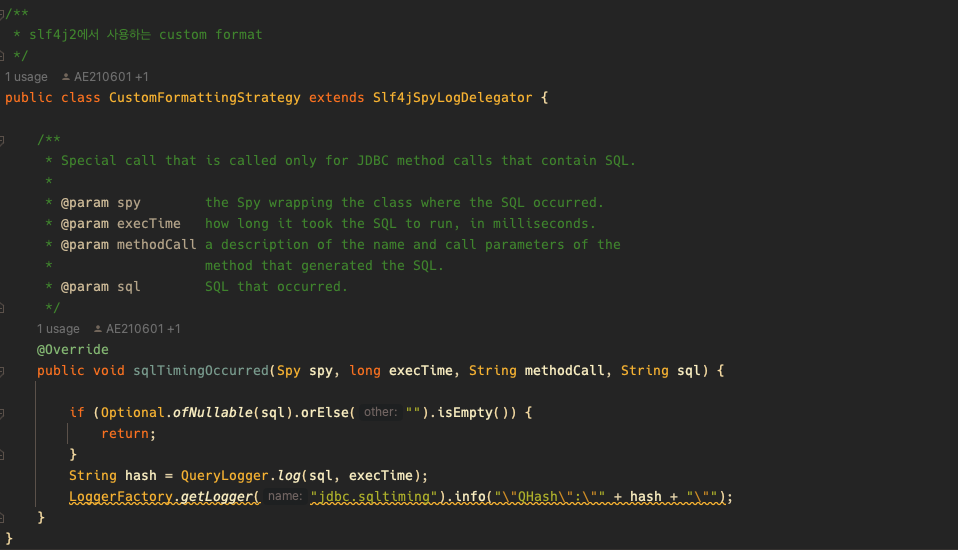
하지만 Slf4jSpyLogDelegator 얘를 바로 쓰지 말고 이 CustomFormattingStrategy 객체에서 얘를 상속하여 특정 기능만 커스텀하는 방식을 사용했다. 이게 될까 했는데 된다 .. (상속 짱짱)
Slf4jSpyLogDelegator 에서 기본적으로 sqltiming 이라는 메소드가 있는데 Query + 수행시간을 같이 출력할 수 있다. 그래서 sql 만을 출력하는 sqlonly라는 method 말고 이걸 선택해서 override 했다.
이제 Hikari Config가 잘 적용되도록 수정하는 작업을 해보자.
2. 히까리풀~~
우선 그냥 DataSource 객체가 아닌 HikariDataSource를 만들어서 bean으로 등록해줘야 할 것 같은데 .. 한 번 해보자
쉬워보였는데 생각보다 쉽지 않았다 .. 그냥 객체 타입만 HikariDataSource로만 바꿔주면 될 줄 알았는데 자꾸 Default Option만 적용되었다. Custom config를 적용하려니 생각보다 삽질이 좀 있었다.
다행히 해결이 되었고 아래와 같이 진행했다.
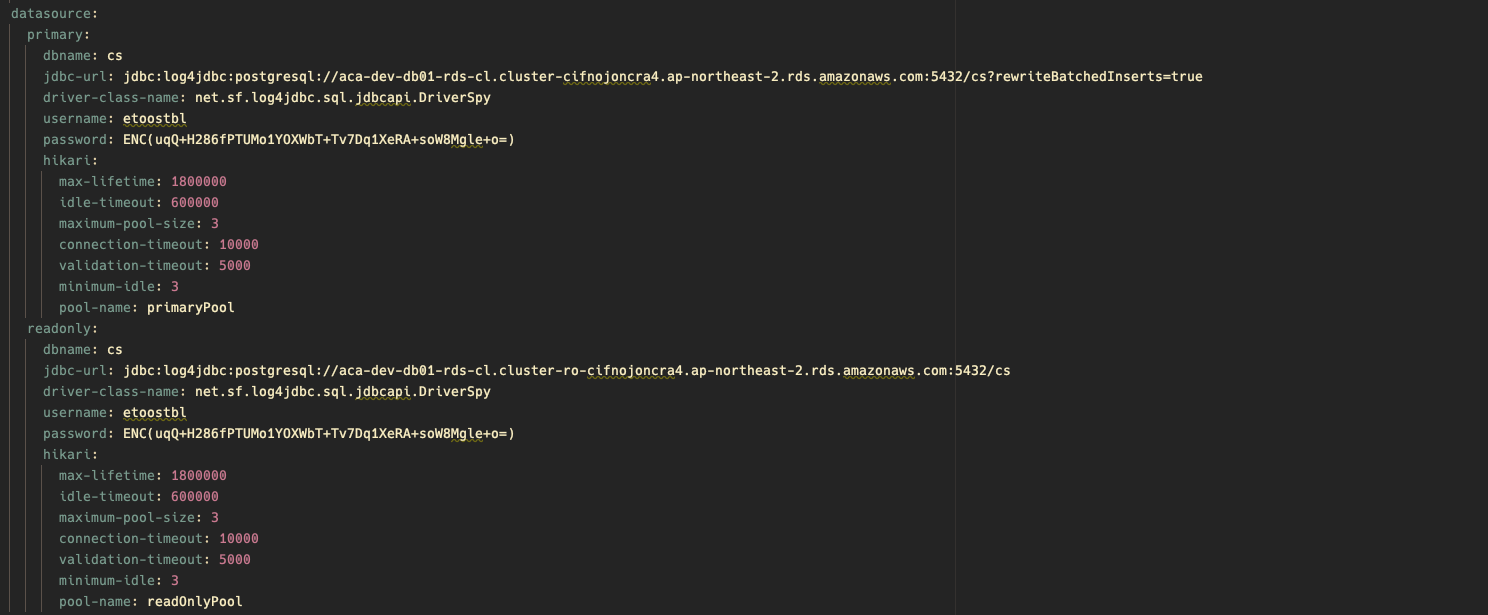
우선 기존에 다른 yml에서 다른 level에 관리되고 있던 datasource info를 spring.datasource... 으로 가져왔다. Hikari 설정과 함께 관리하기 용이하도록 ..
하나의 공통된 hikari config로 적용된 multiple datasource 에 적용이 되나 했는데 같은 pool name으로 (예를 들어 primaryPool이라고 한다면) 각각 datasource에 만들어져서 그냥 pool name도 구분할겸 설정이 나중에 바뀔 수도 있지 않을까 해서 Hikari config도 나눠놨다.
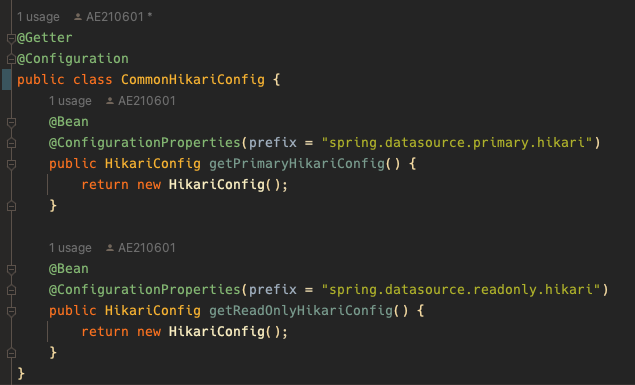
그리고 Config Class 하나 만들어서 각각의 Data Source에 적용해 둔 Hikari Config Info를 가져와 HikariConfig 객체를 return하도록 했다.
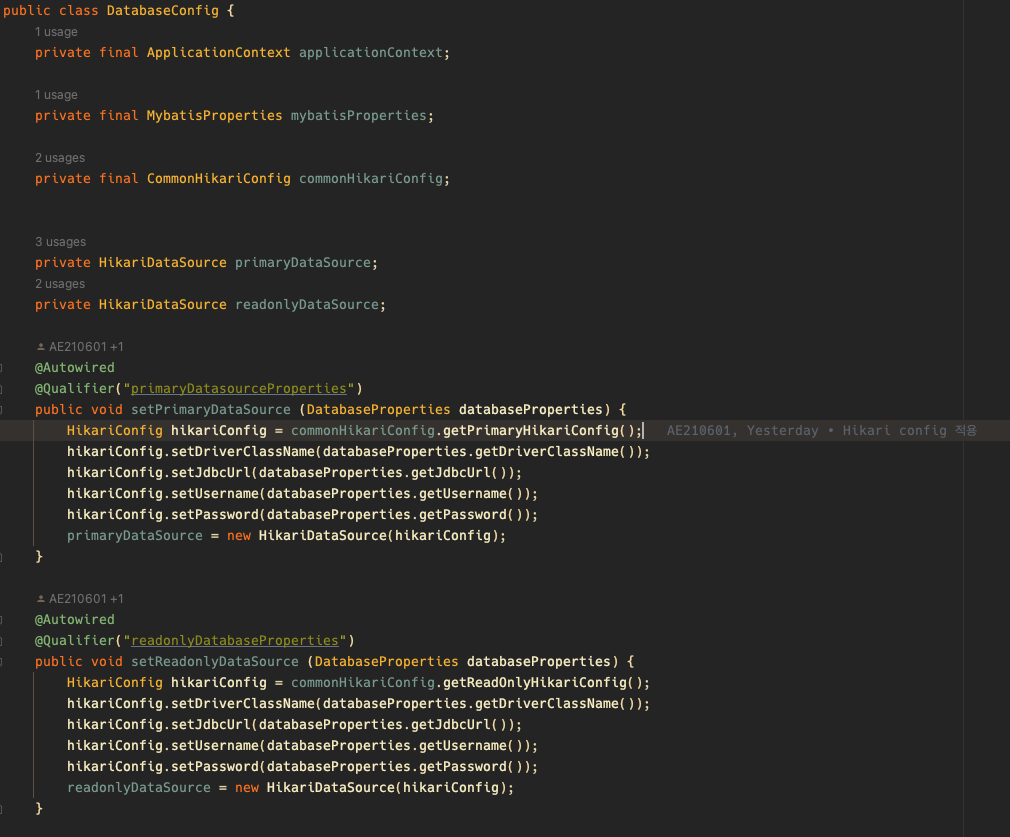
그리고 여기가 좀 중요한데, 기존에는 DataSourceBuilder를 이용해서 info들을 Set 한 다음 미리 선언한 primary, readonly Data Source에 넣어줬는데
먼저 HikariConfig를 각각의 DataSource 에서 Get 한 다음 정보들을 set하고 HikariDataSoucre 타입을 만들어 넣어줬다. (기존에 field에 DataSource Type으로 있던 변수들은 전부 HikariDataSource Type으로 변경해줬다.)
음 근데 primary 랑 readonly랑 url만 중간에 -ro- 이거만 붙고 나머지 정보는 동일한데.. 한번에 처리할 방법은 없을까 모르겠다.
3. connection 누수는 왜 ..
아.. 이건 아무리 찾아봐도 Hikari Config에서 max-life-time 등 설정을 통해서 해결하는 레퍼런스 밖에 나오지 않는다. 생각해보면 당연한건가 .. 처음엔 query 수행 시간과 상관 있을까 싶지만 성능측정 해보면 몇 "초" 단위로 실행되는 query도 아니었다.
https://do-study.tistory.com/97 이런 식의 trouble shooing ref 들을 참고해서 설정 값에 손을 좀 봐야겠다. (근데 누수가 나는지 보려고 일부로 누수를 내는 방법은 없나?)
4. 5252~ 드디어 답변이! (끝난 줄 알았는데...)
위에서 p6psy github에 Issue를 제기했다고 떡밥을 남겼는데 답변이 왔다. https://github.com/gavlyukovskiy/spring-boot-data-source-decorator/issues/72
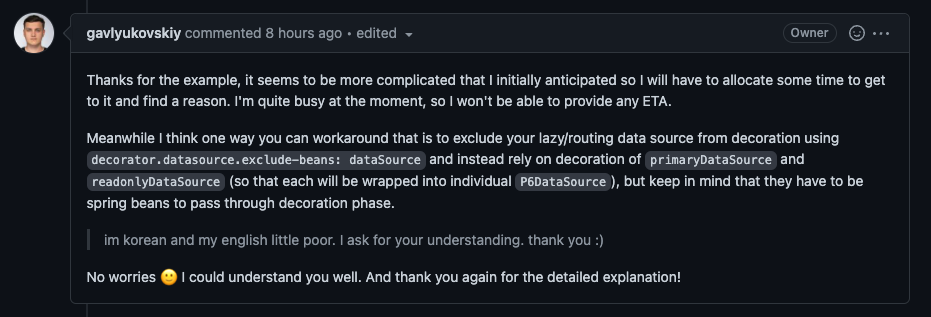
처음 질문에 대해 좀 더 구체적인 example 을 달라하여 설명을 해줬다. "뭐 내가 좀 바빠서 지금은 안되고 시간날때 보고 알려줄게" 라는 답변인데 그래도 밑에 힌트 하나 남겨줬다.
어차피 log4jdbc 로 바꿔서 운영에도 배포한 현재 굳이 뭐 신경쓸 필요는 없지만 그래도 혹시나 궁금해서 한번 해보았다. 그랬더니 ..
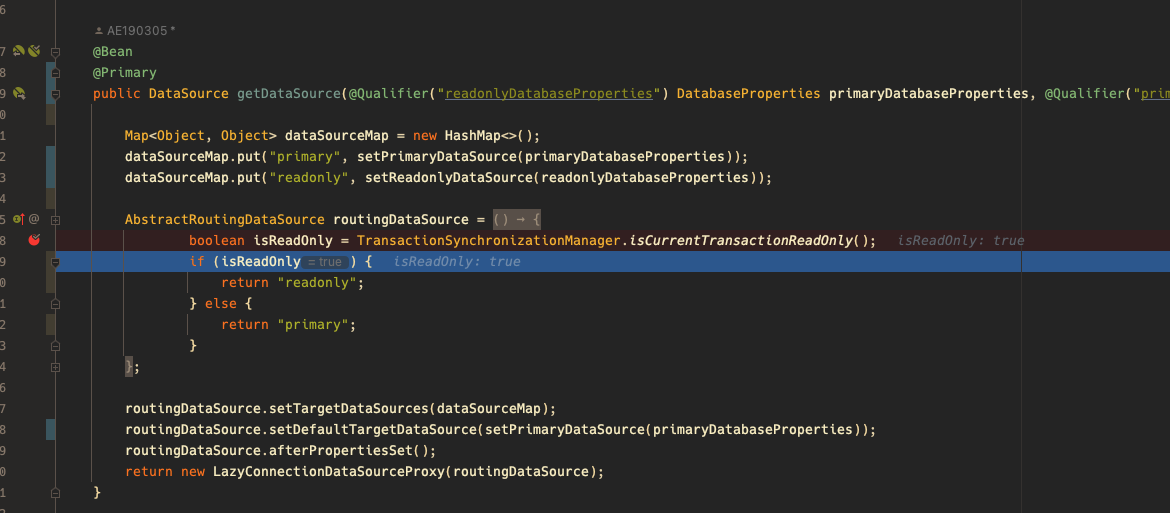
?? 된다? 왜 되지? 뭐지? 사실 저 답변을 온전히 이해 못한 상태에서 중간 부분에
"데코레이터를 입히지 않을 빈 이름을 적고, 두 데이터 소스를 빈으로 등록해보거라"
라는 뉘앙스로 눈치껏 이해해서 그냥 해봤다.
그랬더니 된다 .. 문제가 되었던 getMetaData() 가 실행되지 않으면서 정상적으로 동작했다. P6spy의 데코레이터를 입히지 않았기 때문에 getMataData가 실행되지 않은건가..? 라고 생각이 드는데 이러면 납득이 간다. 그렇다면 어떻게 수행한 쿼리가 로그에 남는거지? 이게 이해가 안간다.
p6spy는 datasource에 강하게 붙어서 수행된 query를 logging 하는 것이지 않았나?
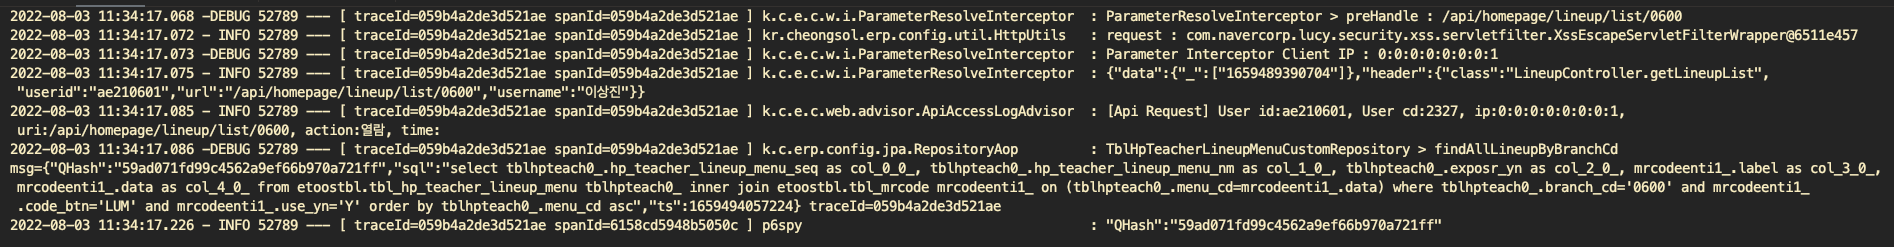
그런데 어떻게 이렇게 잘 가져오지 ..? .. 끝난게 아니었다 ..
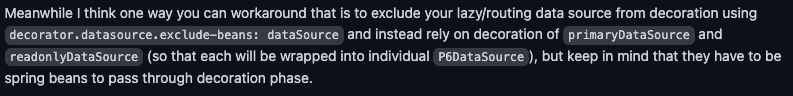
개발자 답변 중 본인이 생각하기에 이렇게 하면 될 것 같은데? 하고 준 힌트이다(감사감사)
사실 내용을 온전하게 이해를 못했지만 그래도 유추한 내용을 바탕으로 차근하게 생각해보자.
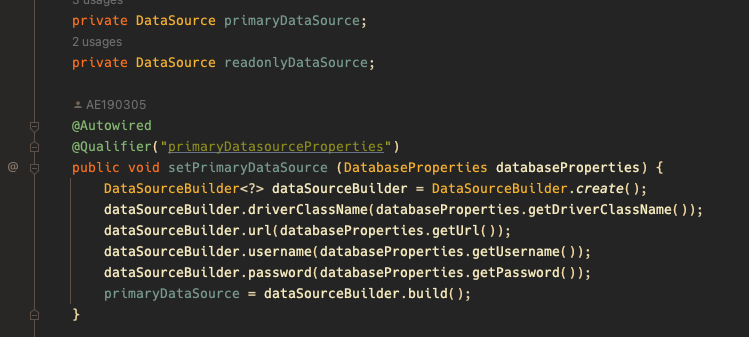
원래는 primary datasource 와 readonly datasource를 그냥 field에다가 만든 후 메소드를 통해 값을 넣어주는 방식이었다. 이런식으로
여기서 저 개발자가 코멘트 준대로 datasource 를 빈으로 등록해주었다. 이런식으로
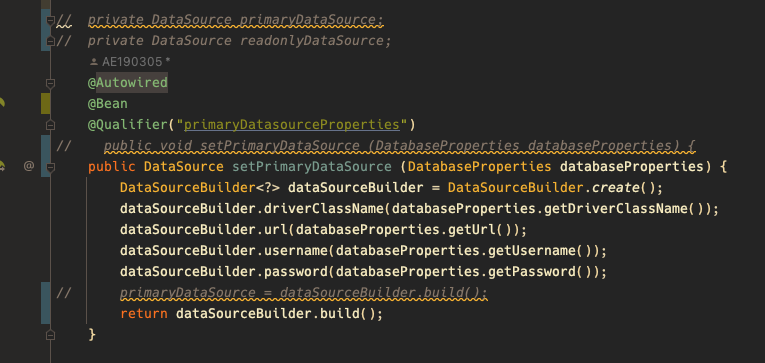
자 여기까지만 설정해두면 p6spy의 decorator가 primary datasoure 와 readonly datasource 두 개를 각각 p6datasource로 감싸고 그다음 LazyConnectionDataSourceProxy 얘를 최종적으로 wrapping하지 않을까 싶다.
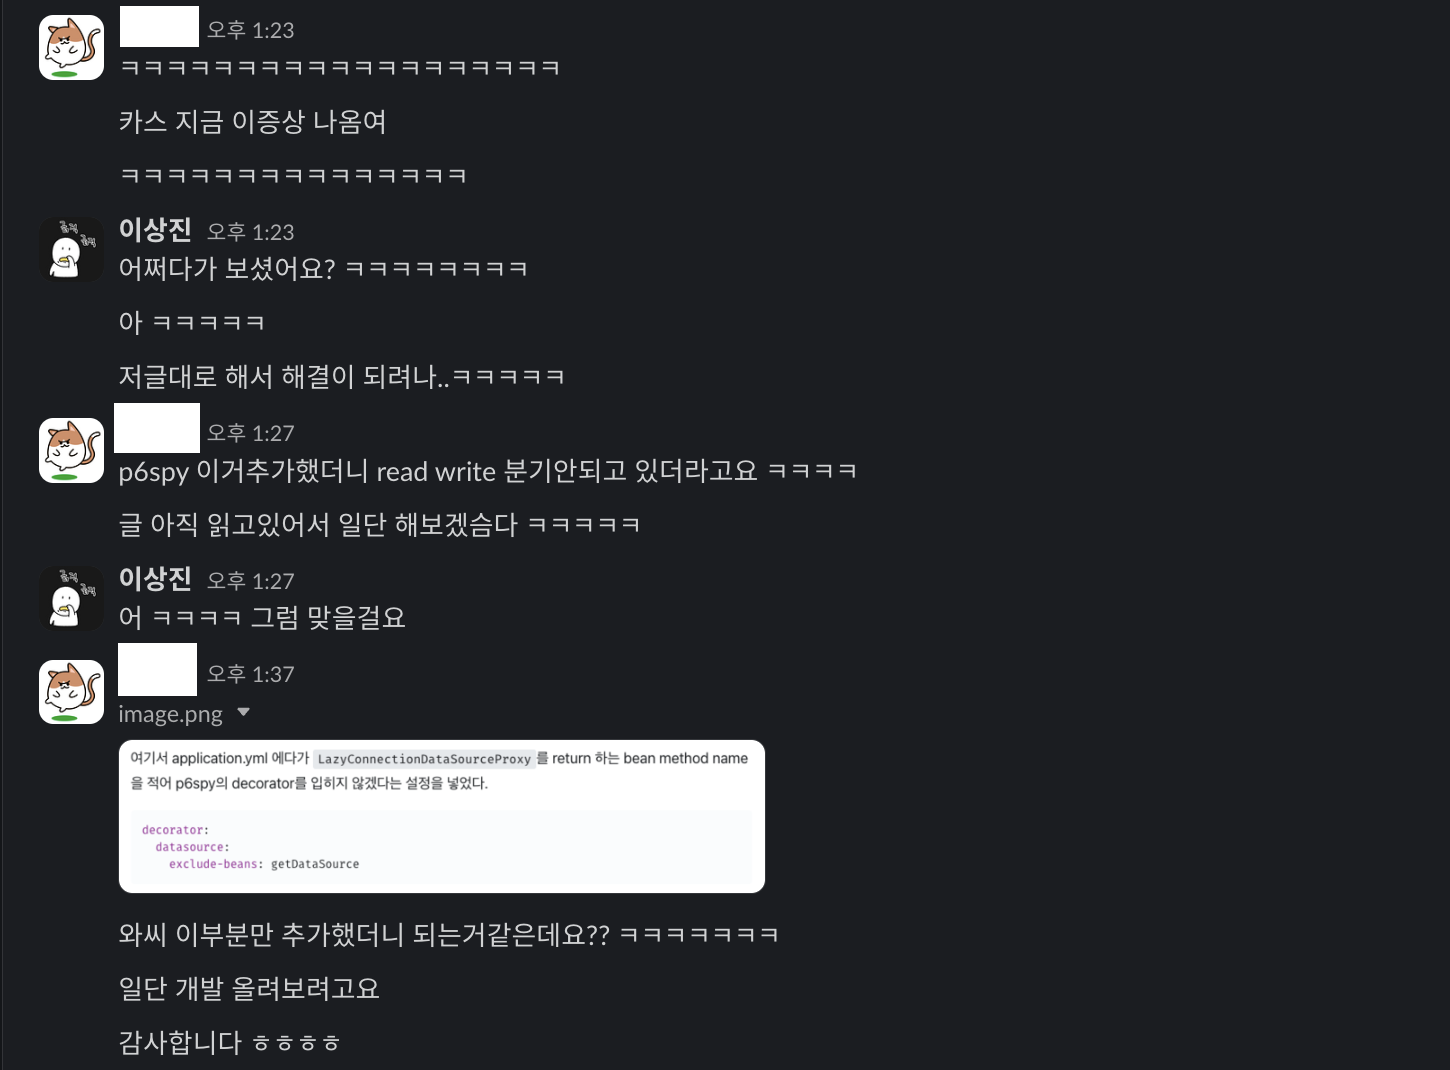
여기서 application.yml 에다가 LazyConnectionDataSourceProxy를 return 하는 bean method name 을 적어 p6spy의 decorator를 입히지 않겠다는 설정을 넣었다.
decorator:
  datasource:
    exclude-beans: getDataSource
이러면 트랜잭션이 들어올때 LazyConnectionDataSourceProxy 는 아무런 decorator 가 없기 때문에 기대했던 대로 동작하고 라우팅 후에 primary 또는 readonly 로 transaction이 갈때 각각의 datasource는 decorator에 감싸져 있기 때문에
그제서야 getMetaData() 등을 거쳐 쿼리를 로깅하는 것 같다.
일단은 Connecion Pool을 확보하는 것으로 일단은 이슈를 마무리 짓고 (다음 업무 때문에 더이상 붙잡고 있을수가 ..) 살아가던 중 문득 생각나서 다시 이슈를 들어가봤다.
사실 왜 되는지 시간되면 설명좀 해달라고 큰 기대 없이 쓰긴했는데 .. 혹시나 써줬나 해서 들어갔는데
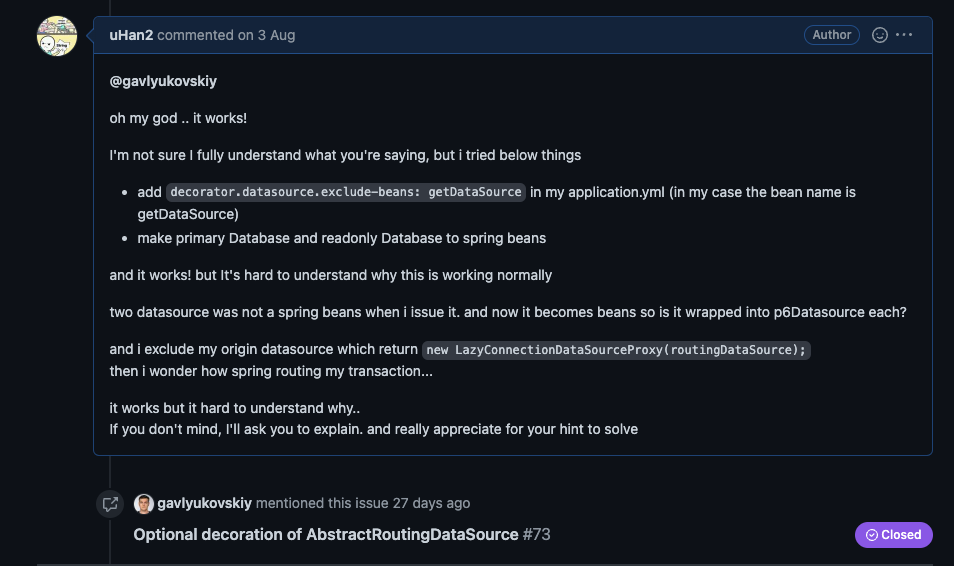
응? 내가 제기한 이슈를 mentiond 했네? (왜 되는지 구체적인 설명이나 해줘ㅏ!~~)
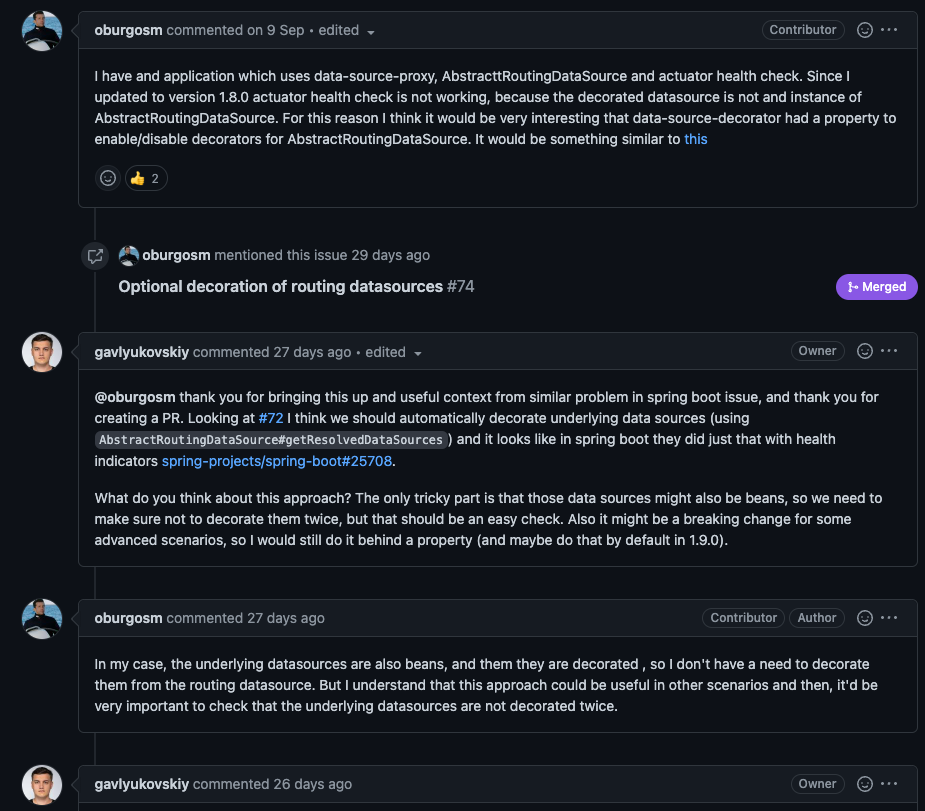
나와 비슷한 문제를 겪은 먼나라 개발자가 관련하여 PR을 올렸나보다 (나도 해보고 싶다 오픈소스 컨트리븉..)
저기에서 언급한 #72 가 내가 제기했던 이슈인데 어쨌든 이 먼나라 개발자의 요지는
p6spy의 decorator 가 AbstractRoutingDataSource를 decorate 할지 말지에 대한 property를 추가하여 enable/disable 할 수 있도로 하는 방안이었다. (자세한건 링크참조.. https://github.com/gavlyukovskiy/spring-boot-data-source-decorator/commit/5f8fb267453b18dd1b8d2723baec2ac6850d5187)
이 pr은 1.8.1 p6Spy에 추가되었다.
(진짜 생겼다..)
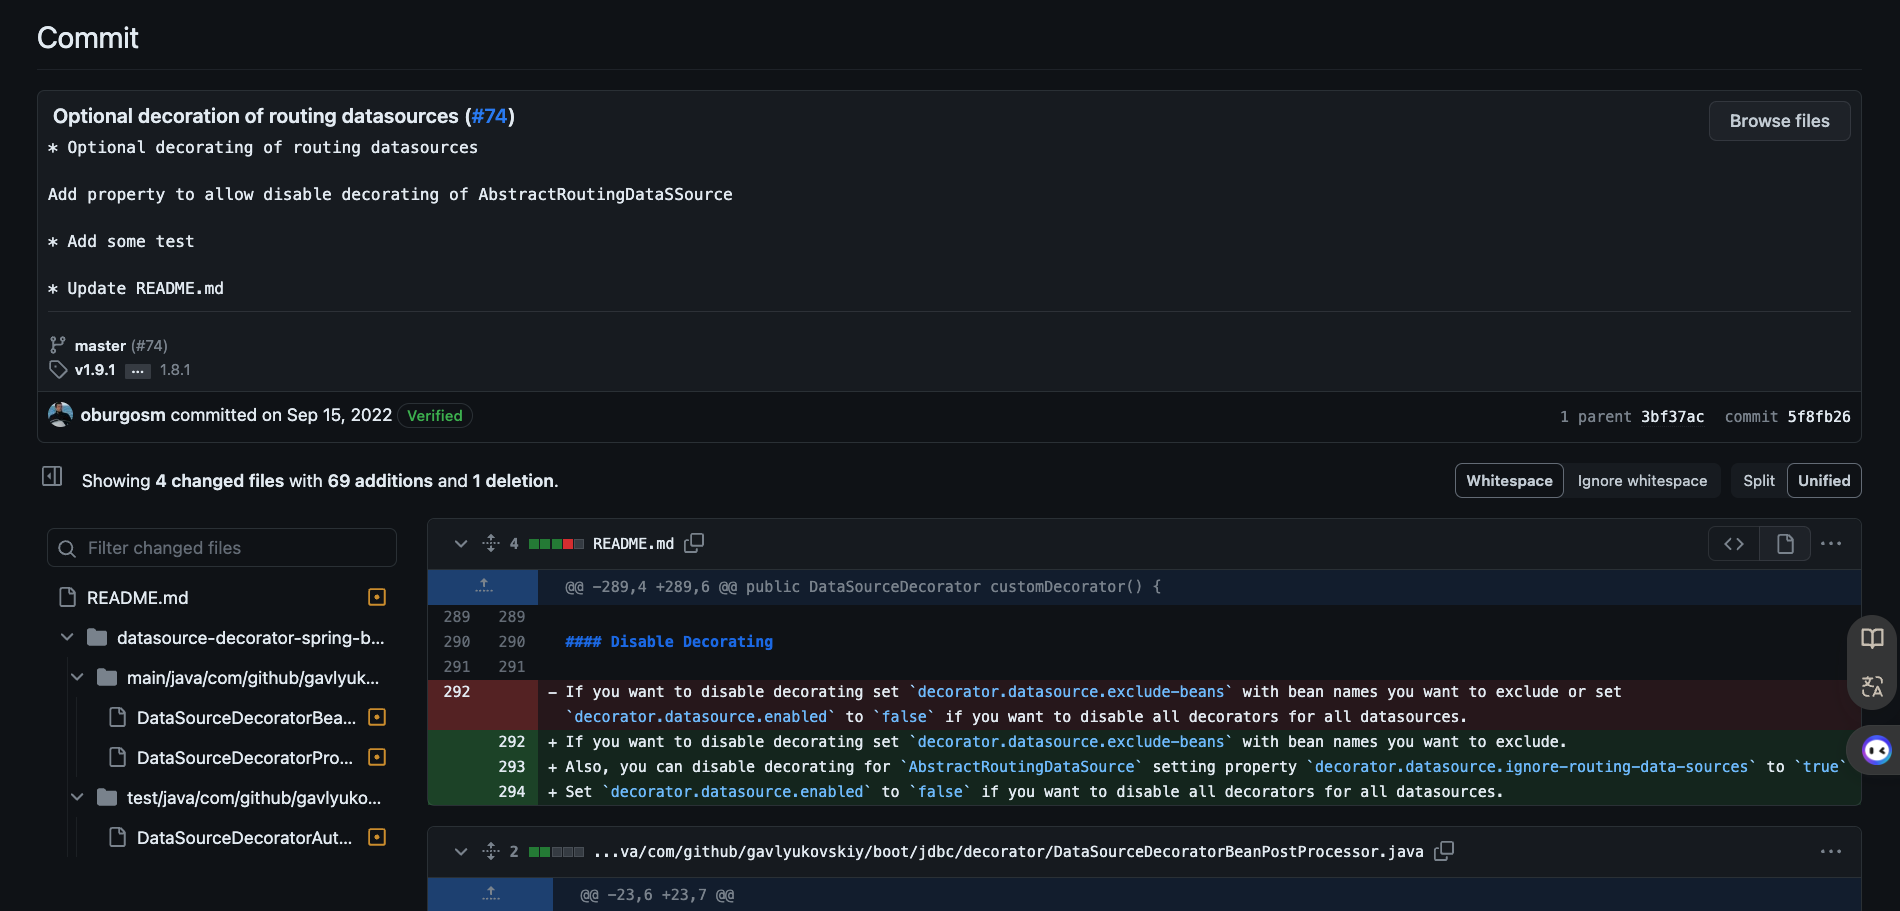
비록 내가 직접 PR을 하여 오픈소스에 기여하진 않았지만 그래도 나의 이슈가 0.1은 도움이 되었을 것 같아 삽질했던 시간에 대해 조금이나마 보상을 받은 기분이 든다..
마무으리
사실 아직 해당 로직에서 왜 메모리 누수가 났는지 완전하게 해결되진 않았다. 하지만 connection pool을 늘리고 나니 이전 대비 DB측 문제 발생률이 현저히 낮아졌다. 메모리 누수 관련해선 업무가 좀 한산해질때 (언제..?) 다시 찾아 볼 계획이다.
이렇게 몇 주 동안 삽질해본건 진짜 오랜만인것 같다. 그런데 삽질할때마다 항상 느끼는건 남는게 참 많다. 할땐 괴롭지만..
시간이 흘러
세상에나, 이 글이 동료 개발자에게 실제로 도움이 되었다 ..
누군가의 도움만 받아봤지, 조금이나마 도움을 준적은 처음이라 감회가 새롭다.

대단하시네요! 저도 이것때문에 몇일동안 삽질해서 결국 p6spy 걷어냈는데 이런 방법으로 해결하셨군요! 감사합니다 도움이 많이 되었어요!