애플리케이션이 발전하면서 내부의 복잡성도 점점 커진다. 객체지향 프로그래밍은 추상화, 캡슐화, 정보은닉, 상속, 다형성 등 시스템의 복잡성을 제어할 수 있는 다양한 장치들을 제공한다. 그래서 현대의 애플리케이션들은 객체지향 언어 위주로 발전해왔다. 하지만 관계형 데이터베이스는 데이터 중심으로 구조화되어 있고 집합적인 사고를 요구한다. 그리고 객체지향에서 이야기하는 추상화, 상속, 다형성 같은 개념이 없다.
객체와 관계형 데이터베이스는 지향하는 목적이 서로 달라 기능과 표현 방법도 다르다. 이것을 객체와 관계형 데이터베이스의 패러다임 불일치 문제라고 한다. 객체 구조를 테이블 구조에 저장하는 데는 한계가 있다. 애플리케이션은 객체지향 언어로 개발하고 데이터는 관계형 데이터베이스에 저장해야 한다면, 패러다임의 불일치 문제를 개발자가 중간에서 해결해야 한다. 이를 해결하는 데는 많은 시간과 코드를 소비해야 한다.
상속
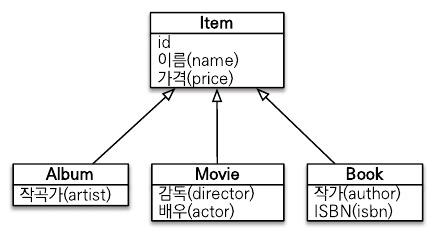
다음 그림처럼 객체는 상속이라는 기능을 가지고 있지만 테이블은 상속이라는 기능이 없다.
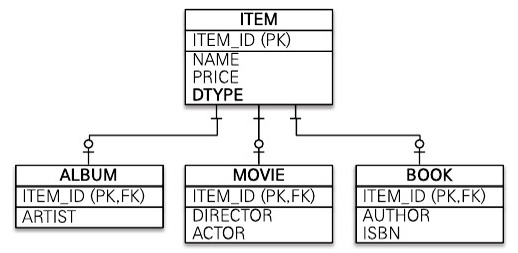
그나마 데이터베이스 모델링에서 이야기하는 슈퍼타입 서브타입 관계를 사용하면 객체 상속과 가장 유사한 형태로 테이블을 설계할 수 있다. 다음 그림에서 ITEM 테이블의 DTYPE 칼럼을 사용해서 어떤 자식 테이블과 관계가 있는지 정의할 수 있다.
객체 모델 코드는 다음 예제와 같다.
abstract class Item {
	Long id;
	String name;
	int price;
}

class Album extends Item {
	String artist;
}

class Movie extends Item {
	String director;
	String actor;
}

class Book extends Item {
	String author;
	Strikng isbn;
}
Album 객체를 저장하려면 이 객체를 분해해서 다음 두 SQL을 만들어야 한다.
INSERT INTO ITEM ...
INSERT INTO ALBUM ...
Movie와 Book도 마찬가지이다.
JDBC API를 사용해서 이 코드를 완성하려면 부모 객체에서 부모 데이터만 꺼내서 ITEM용 INSERT SQL을 작성하고 자식 객체에서 자식 데이터만 꺼내서 ALBUM용 INSERT SQL을 작성해야 하는데, 작성해야 할 코드량이 만만치 않다. 그리고 자식 타입에 따라서 DTYPE도 지정해야 한다. 조회도 ITEM과 ALBUM 테이블을 조인해서 조회한 다음 그 결과로 Album 객체를 생성해야 한다.
이런 과정이 모두 패러다임 불일치를 해결하려고 소모하는 비용이다. 그러나 JPA는 상속과 관련된 패러다임의 불일치 문제를 개발자 대신 해결해준다. 개발자는 다음 예제와 같이 JPA에게 객체를 저장하면 된다.
jpa.persist(album);연관관계
객체는 참조를 사용해서 다른 객체와 연관관계를 가지고 참조에 접근해서 연관된 객체를 조회한다. 반면에 테이블은 외래 키를 사용해서 다른 테이블과 연관관계를 가지고 조인을 사용해서 연관된 테이블을 조회한다.
참조를 사용하는 객체와 외래 키를 사용하는 관계형 데이터베이스 사이의 패러다임 불일치는 객체지향 모델링을 거의 포기하게 만들 정도로 극복하기 어렵다.
다음 그림과 예제를 통해 문제점을 파악해보자.
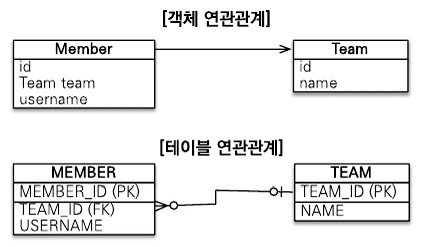
MEMBER 테이블은 MEMBER.TEAM_ID 외래 키 칼럼을 사용해서 TEAM 테이블과 관계를 맺는다. 이 외래 키를 사용해서 MEMBER 테이블과 TEAM 테이블을 조인하면 MEMBER 테이블과 연관된 팀을 조회할 수 있다.
class Member {
	String id;
	Team team;
	String username;

	Team getTeam() {
		return team;
	}
}
예제와 같이 Member 객체는 Member.team 필드에 Team 객체의 참조를 보관해서 Team 객체와 관계를 맺는다. 따라서 이 참조 필드에 접근하면 Member와 연관된 Team을 조회할 수 있다.
객체와 테이블의 차이를 알아보기 위해 객체를 단순히 테이블에 맞추어 모델링 해보았다.
class Member {
	String id;
	Long teamId;
	String username;
}

class Team {
	Long id;
	String name;
}
MEMBER 테이블의 칼럼을 그대로 가져와서 Member 클래스를 만들었다. 이렇게 객체를 테이블에 맞추어 모델링하면 객체를 테이블에 저장하거나 조회할 때는 편리하다. 그런데 여기서 TEAM_ID 외래 키의 값을 그대로 보관하는 teamId 필드에는 문제가 있다. 관계형 데이터베이스는 조인이라는 기능이 있으므로 외래 키의 값을 그대로 보관해도 된다. 하지만 객체는 연관된 객체의 참조를 보관해야 다음처럼 참조를 통해 연관된 객체를 찾을 수 있다.
Team team = member.getTeam();특정 회원이 소속된 팀을 조회하는 가장 객체지향적인 방법은 이처럼 참조를 사용하는 것이다.
Member.teamId 필드처럼 TEAM_ID 외래 키까지 관계형 데이터베이스가 사용하는 방식에 맞추면 Member 객체와 연관된 Team 객체를 참조를 통해서 조회할 수 없다. 이런 방식을 따르면 좋은 객체 모델링은 기대하기 어렵고 결국 객체지향의 특징을 잃어버리게 된다.
따라서 객체는 참조를 사용하도록 모델링해야 한다. 하지만 객체지향 모델링을 사용하면 객체를 테이블에 저장하거나 조회하기가 쉽지 않다. 결국 개발자가 객체 모델과 테이블의 변환 과정을 수행해야 한다.
JPA와 연관관계
JPA는 연관관계와 관련된 패러다임의 불일치 문제를 해결해준다.
예제 1.10과 같이 개발자는 회원과 팀의 관계를 설정하고 회원 객체를 저장하면 된다.
member.setTeam(team); // 회원과 팀 연관관계 설정
jpa.persist(member); // 회원과 연관관계 함께 저장
JPA는 team의 참조를 외래 키로 변환해서 적절한 INSERT SQL을 데이터베이스에 전달한다. 객체를 조회할 때 외래 키를 참조로 변환하는 일도 JPA가 처리해준다.
객체 그래프 탐색
객체에서 회원이 소속된 팀을 조회할 때는 참조를 사용해서 연관된 팀을 찾으면 되는데 이것을 객체 그래프 탐색이라고 한다.
객체 연관관계가 다음 그림과 같이 설계되어 있다.
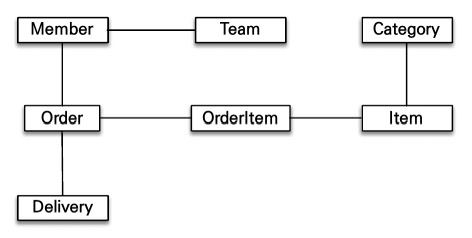
다음은 객체 그래프를 탐색하는 코드이다.
member.getOrder().getOrderItem()객체는 이와 같이 마음껏 객체 그래프를 탐색할 수 있어야 한다. 그런데 마음껏 객체 그래프를 탐색할 수 있을까?
예를 들어 MemberDAO에서 member 객체를 조회할 때 다음과 같은 SQL을 실행해서 회원과 팀에 대한 데이터만 조회했다면 member.getTeam()은 성공하지만 member.getOrder()은 데이터가 없으므로 탐색할 수 없다.
SELECT M.*, T.*
FROM MEMBER M JOIN TEAM T ON M.TEAM_ID = T.TEAM_ID
따라서 SQL을 직접 다루면 처음 실행하는 SQL에 따라 객체 그래프를 어디까지 탐색할 수 있는지 정해야 한다. 이것은 객체지향 개발자에겐 너무 큰 제약이다. 왜냐하면 비즈니스 로직에 따라 사용하는 객체 그래프가 다른데 언제 끊어질지 모를 객체 그래프를 함부로 탐색할 수는 없기 때문이다.
그렇다고 member와 연관된 모든 객체 그래프를 데이터베이스에서 조회해서 애플리케이션 메모리에 올려두는 것은 현실성이 없다. 결국 MemberDAO에 회원을 조회하는 메소드를 상황에 따라 여러 개 만들어서 사용해야 한다.
JPA와 객체 그래프 탐색
JPA를 사용하면 객체 그래프를 마음껏 탐색할 수 있다.
JPA는 연관된 객체를 사용하는 시점에 적절한 SELECT SQL을 실행한다. 따라서 JPA를 사용하면 연관된 객체를 신뢰하고 마음껏 조회할 수 있다. 이 기능은 실제 객체를 사용하는 시점까지 데이터베이스 조회를 미룬다고 해서 지연 로딩이라 한다.
// 처음 조회 시점에 SELECT MEMBER SQL
Member member = jpa.find(Member.class, memberId);

Order order = member.getOrder();
order.getOrderDate() // order을 사용하는 시점에 SELECT ORDER SQL
Member를 사용할 때마다 Order를 함께 사용하면 이렇게 한 테이블씩 조회하는 것보다는 Member를 조회하는 시점에 SQL 조인을 사용해서 Member와 Order를 함께 조회하는 것이 효과적이다.
JPA는 연관된 객체를 즉시 함께 조회할지 아니면 실제 사용되는 시점에 지연해서 조외할지를 간단한 설정으로 정의할 수 있다.
비교 문제
데이터베이스는 기본 키의 값으로 각 로우를 구분한다. 반면에 객체는 동일성 비교와 동등성 비교라는 두 가지 비교 방법이 있다.
- 동일성 비교는 == 비교이다. 객체 인스턴스의 주소 값을 비교한다.
- 동등성 비교는 equals() 메소드를 사용해서 객체 내부의 값을 비교한다.
따라서 테이블의 로우를 구분하는 방법과 객체를 구분하는 방법에는 차이가 있다.
class MemberDAO {
	public Member getMember(String memberId) {
		String sql = "SELECT * FROM MEMBER WHERE MEMBER_ID = ?";
		...
		// JDBC API, SQL 실행
		return new Member(...);
	}
String memberId = "100";
Member member1 = memberDAO.getMember(memberId);
Member member2 = memberDAO.getMember(memberId);
member1 == member2; // 다르다.예제의 코드를 보면 기본 키 값이 같은 회원 객체를 두 번 조회했다. 그런데 둘을 동일성 비교하면 false가 반환된다. 왜냐하면 member1과 member2는 같은 데이터베이스 로우에서 조회했다. 하지만 반환할 때 new Member()로 새로운 인스턴스를 생성해서 반환하기 때문에 객체 측면에서 볼 때 둘은 다른 인스턴스이기 때문이다.
따라서 데이터베이스의 같은 로우를 조회했지만 객체의 동일성 비교에는 실패한다. 이런 패러다임의 불일치 문제를 해결하기 위해 데이터베이스의 같은 로우를 조회할 때마다 같은 인스턴스를 반환하도록 구현하는 것은 쉽지 않다. 여기에 여러 트랜잭션이 동시에 실행되는 상황까지 고려하면 문제는 더 어려워진다.
JPA와 비교
JPA는 같은 트랜잭션일 때 같은 객체가 조회되는 것을 보장한다. 그러므로 다음 코드에서 member1과 member2는 동일성 비교에 성공한다.
String memberId = "100";
Member member1 = memberDAO.getMember(memberId);
Member member2 = memberDAO.getMember(memberId);

member1 == member2; // 같다.
정리
객체 모델과 관계형 데이터베이스 모델은 서로 다른 패러다임을 지향한다. 이 차이를 극복하려면 개발자가 많은 시간과 코드를 소비해야 한다. 자바 진영에서는 오랜 기간 이 문제를 해결하기 위해 많은 노력을 기울여왔고, 그 결과물이 바로 JPA이다. JPA는 패러다임의 불일치 문제를 해결해주고 정교한 객체 모델링을 유지하게 도와준다.
JPA를 사용하면 상속, 연관관계, 객체 그래프 탐색, 비교와 같은 객체지향 프로그래밍의 주요 기능을 데이터베이스와 쉽게 연동할 수 있어 개발자의 생산성을 높이고 코드의 유지보수를 용이하게 한다.