groupby / pivot / merge / map
GroupBy 기초 (단일 기준 집계)
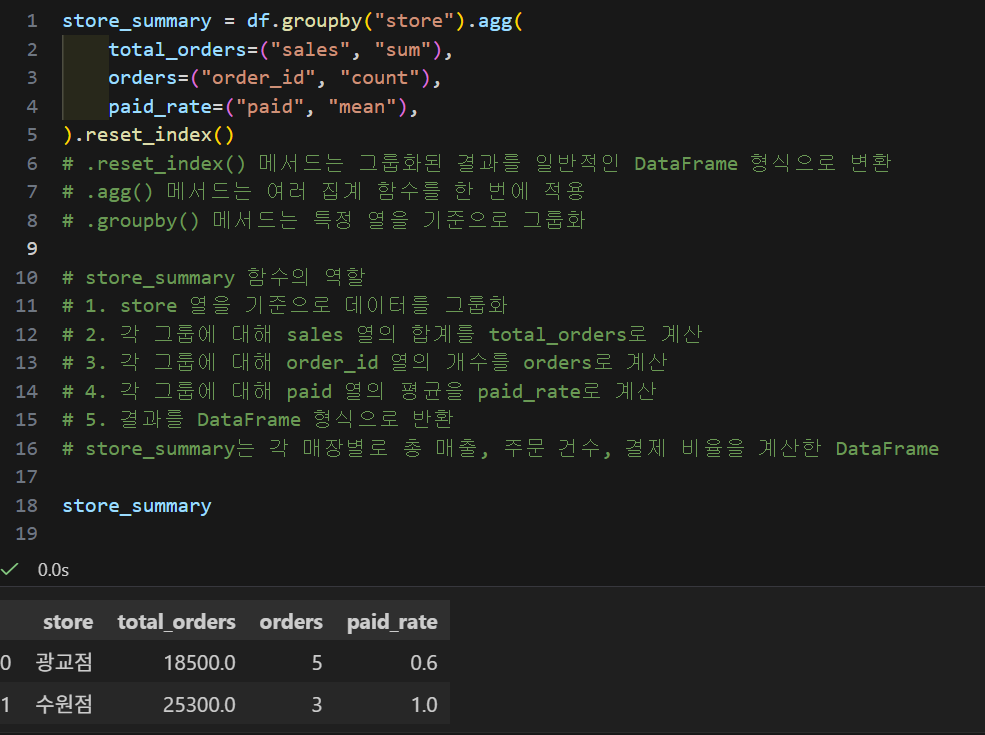
store_summary = df.groupby("store").agg(
    total_orders=("sales", "sum"),
    orders=("order_id", "count"),
    paid_rate=("paid", "mean"),
).reset_index()
groupby("store") : store 값이 같은 것끼리 묶어서 계산하자 ; 매장별 계산
→ 광교점/수원점 두 덩어리로 데이터가 쪼개짐
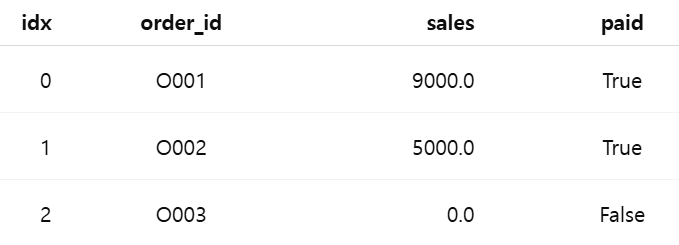
- 광교점
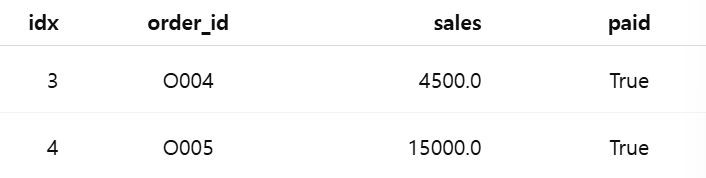
- 수원점
.agg() : 각 그룹에 대해 여러 계산을 한 번에 실행
👉 total_orders = ("sales","sum") :: sales를 전부 더함
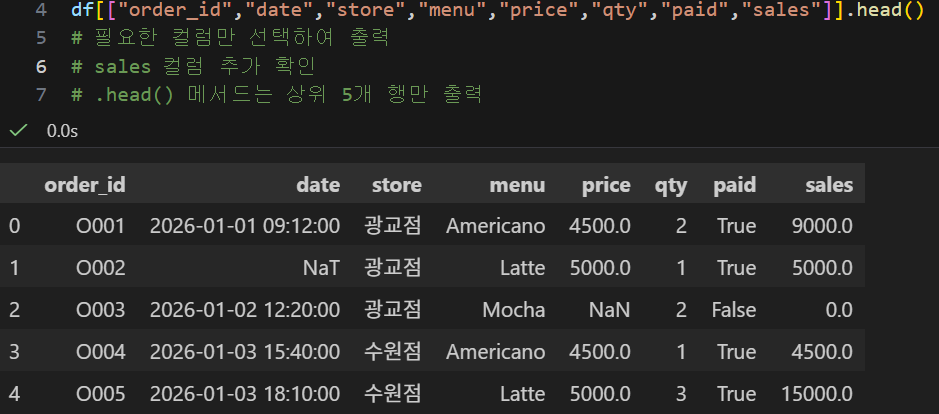
- 광교점 total_orders = 9000+5000+0=14000
- 수원점 total_orders = 4500+15000 = 195000
👉 orders = ("order_id","count") :: 주문 건수 세기
count는 결측치가 아닌 값의 개수를 셈
- 광교점 orders =
order_id가 있는 행의 개수가 3개(O001, O002, O003) - 수원점 orders =
order_id가 있는 행의 개수가 2개(O004, O005)
👉 paid_rate = ("paid", "mean") :: paid의 평균
파이썬/판다스에서 True/False는 각각 1, 0으로도 취급
mean()은 여기서 '결제 비율'을 구한다고 볼 수 있다.
- 광교점 paid_rate = (1+1+0) / 3 = 0.666...
- 수원점 paid_rate = (1+1) / 2 = 1
.rest_index()
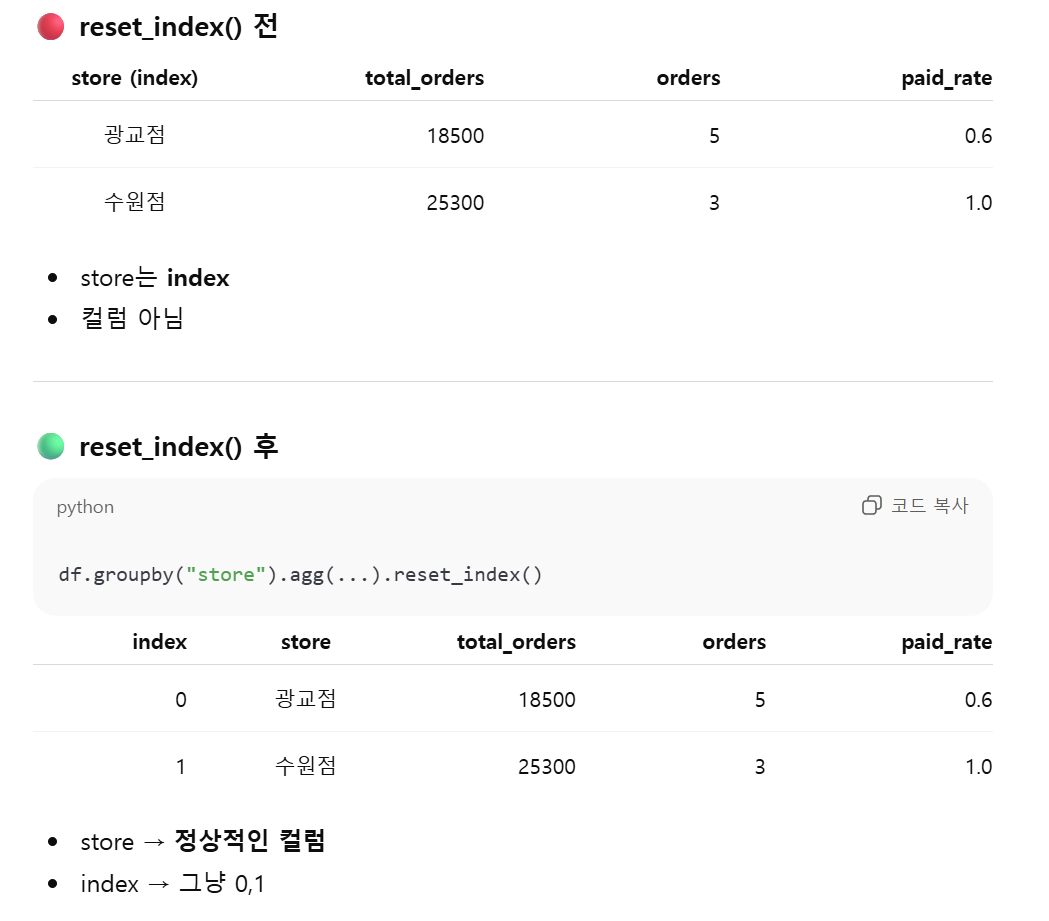
groupby 때문에 index화 된 컬럼을 다시 정상 컬럼 자리로 되돌림
pivot
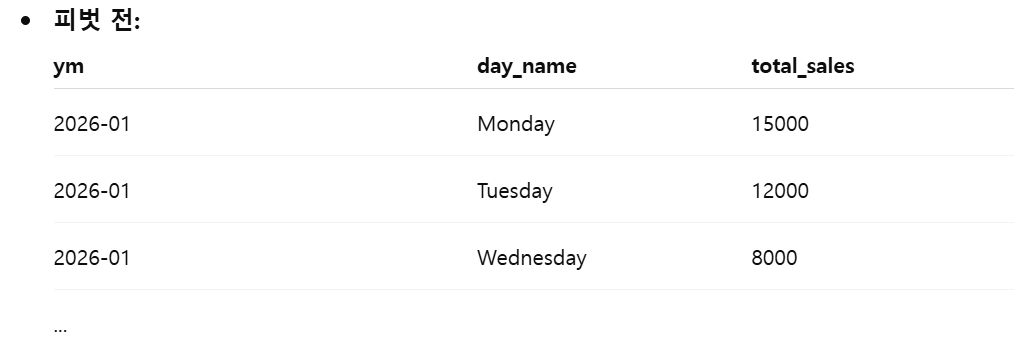
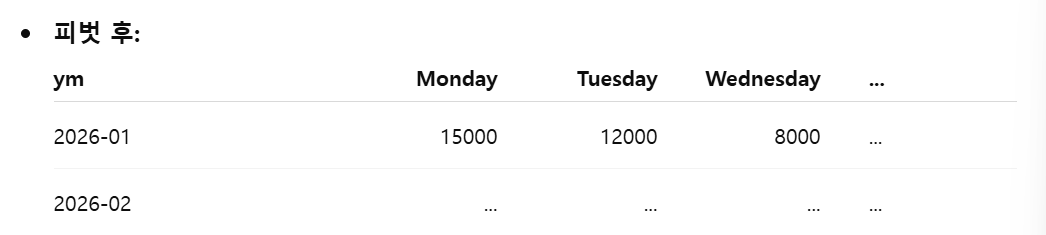
pivot_sales = ym_day.pivot(index="ym", columns="day_name", values="total_sales").fillna(0)
pivot_salesym이 행 인덱스, day_name이 열 컬럼으로 들어가고, 그 교차 지점에 total_sales 값이 채워진 표
merge (데이터 결합)
카테고리 매핑 테이블 만들기
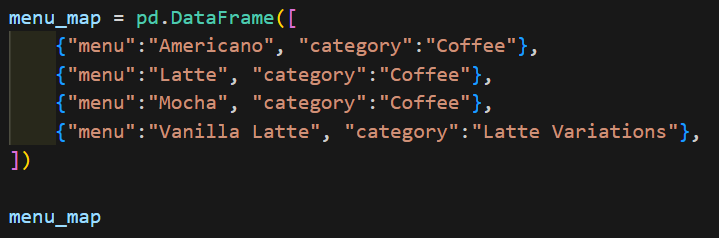
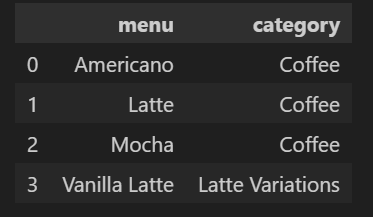
각 메뉴 이름에 어떤 카테고리를 붙일지 정리한 표 생성
merge로 두 테이블 결합하기
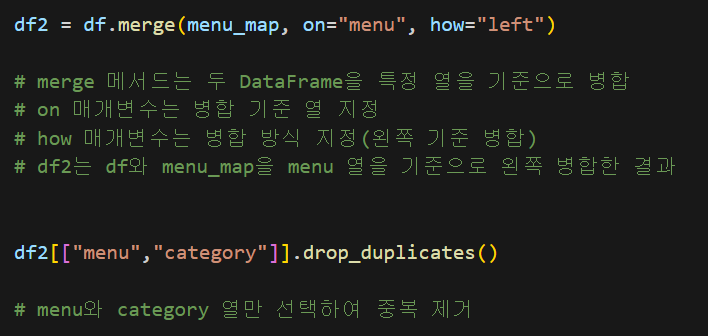
df에 menu_map을 합친 형태의 df2를 생성
on="menu" : 메뉴 이름을 기준으로
.merge() : 두 테이블 병합
how="left": 원래 df 행은 그대로 유지. menu_map에 매칭되는 카테고리가 있으면 붙이고 없으면 NaN 값으로 남겨두기
df2[["menu","category"]].drop_duplicates() : menu와 category열만 선택해서 중복 제거
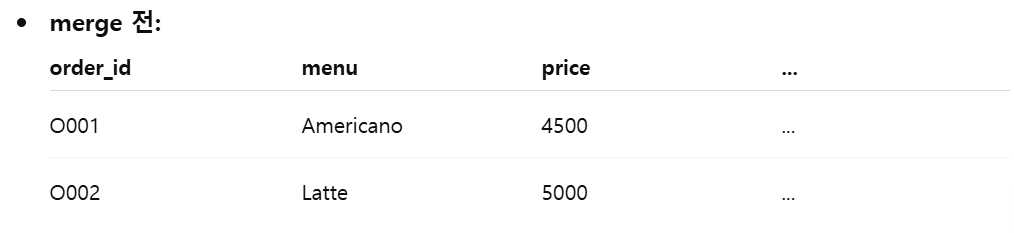
메뉴만 있고 카테고리 정보가 없음
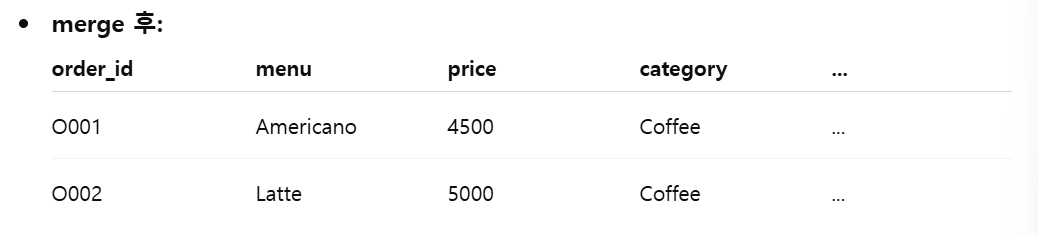
메뉴마다 해당하는 카테고리 정보가 새로 붙음
map (딕셔너리 매핑) : 치환작업
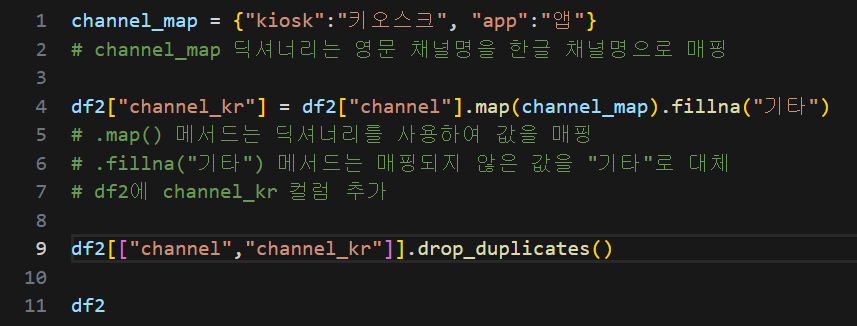
channel_map = {"kiosk":"키오스크", "app":"앱"}
channel_map이라는 딕셔너리 생성- 영어로 된 채널명 "kiosk"를 "키오스크", "app"을 "앱"으로 한글 치환하기 위한 매핑 테이블
df2["channel_kr"] = df2["channel"].map(channel_map).fillna("기타")
df2["channel"]df2 데이터프레임에서channel컬럼 가져와서.map(channel_map)컬럼 내 각 값을channel_map딕셔너리에 맞게 매핑(치환).fillna("기타")만약channel컬럼에channel_map에서 명시하지 않은 값이 있다면 그 자리는 "기타"로 채워넣기- 이렇게 치환한 결과를 df2에 "channel_kr"이라는 새로운 컬럼으로 추가
df2[["channel","channel_kr"]].drop_duplicates()
중복을 제거한 뒤 어떤 채널이 어떤 한글 값으로 매핑되었는지 확인
기타
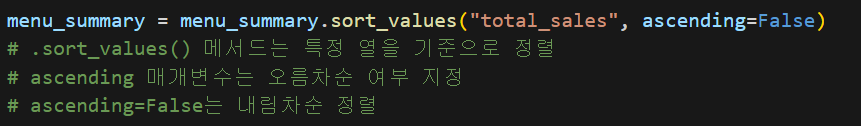
.sort_values()메서드는 특정 열을 기준으로 정렬ascending매개변수는 오름차순 여부 지정ascending=False는 내림차순 정렬