점검
df.describe(include="all")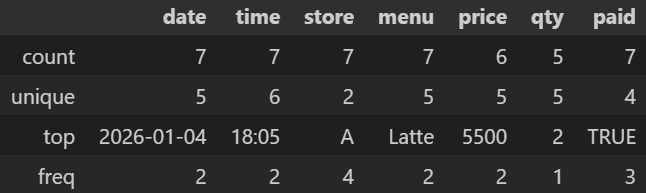
count : null 값을 제외한 개수
unique : 중복값을 제외한 개수. distinct한 값들의 개수
top : 최빈값
freq : top값이 등장한 개수. 최빈값 빈도
인덱싱
- .loc = 라벨(이름) 기반 (행/열 이름으로 접근)
- .iloc = 위치(순서) 기반 (0번째, 1번째…로 접근)
실습 1: “한 행” 뽑기
df.loc[0] # 0번 인덱스 라벨의 행 df.iloc[0] # 0번째 위치의 행
실습 2: “행 범위” 슬라이싱 실수 포인트
df.loc[0:2] # 끝 포함(인덱스 0번부터 2번까지의 행) df.iloc[0:2] # 끝 미포함(0번째부터 1번째까지의 행)
특정 컬럼만 뽑아내서 사용하기
cols = ["date","time","store","menu","price","qty","paid"]
df2 = df[cols].copy()
df2.head()
cols
→ 선택하고 싶은 컬럼 이름 목록
df[cols]
→ df에서
→ cols에 들어 있는 컬럼만
→ 새 DataFrame으로 추출
- 리스트를 인덱스로 쓰는 pandas의 컬럼 선택 문법
- '열 이름들의 리스트'를 넘기면, 그 열들만 묶어서 DataFrame으로 반환
.copy()
→ 원본 df와 메모리 분리
→ df2를 안전하게 수정 가능
- df["col"] → 컬럼 1개
- df[["col1","col2"]] → 컬럼 여러 개
조건 필터링
paid 컬럼을 정리(cleaning)한 뒤,
값이 true인 행만 골라서 새로운 데이터프레임을 만들어보자
df2["paid"] = df2["paid"].astype(str).str.strip().str.lower()
df2["paid"].value_counts()

cond_paid = df2["paid"].isin(["true"])
paid_df = df2.loc[cond_paid]
paid_df
1️⃣ 문자열 정리 단계 (데이터 클리닝)
df2["paid"] = df2["paid"].astype(str).str.strip().str.lower()
(1) df2["paid"]
paid 컬럼 하나만 꺼낸다
이 시점의 형태는 Series (1차원)
(2) .astype(str)
paid 컬럼 안에는 True / False, 문자열, NaN, 공백 섞인 값 등이 섞여 있을 수 있다. 문자열 전용 기능(.str)은 문자열이 아닌 경우 에러가 발생하기 때문에 전부 문자열로 통일한다.
(3) .str.strip()
각 원소별 문자열 양쪽의 공백 제거
" true " → "true"

"True " → "True"
👉 실제 데이터에서는 공백 때문에 필터가 실패하는 경우가 아주 많다
(4) .str.lower()
각 원소별 소문자로 통일
👉 비교 기준을 하나로 맞추기 위한 작업
※ strip()과 lower()는 문자열 하나의 메서드이고,
pandas Series에서는 .str을 통해서만 각 원소에 적용할 수 있다.
(5) 왜 다시 df2["paid"] = ... 인가?
정리된 결과를 원래 paid 컬럼에 덮어쓴다. 이후 작업은 정제된 데이터 기준으로 진행
2️⃣ 값 분포 확인 단계 (중간 점검)
df2["paid"].value_counts()
paid 컬럼에 어떤 값이, 몇 개씩 있는지 확인
3️⃣ 조건 만들기 (Boolean Mask)
cond_paid = df2["paid"].isin(["true"])
(0) .inin()의 역할
“이 값이, 내가 허락한 값들 중 하나인가?”
🔹 == 는 1:1 질문
이 값이 'true'야?
→ 딱 하나만 비교
🔹 isin() 은 1:여러 질문
이 값이 ["true", "yes", "y", "1"] 중 하나야?
→ 목록 중 하나면 OK
(1) .isin(["true"]) 의 의미
paid 컬럼의 각 값이 true 목록 안에 들어 있으면 True, 아니면 False
결과는 다음과 같은 형태:
[True, False, False, True, ...]
👉 불리언 마스크(Boolean mask)
4️⃣ 조건으로 행 필터링
paid_df = df2.loc[cond_paid]
df2에서 cond_paid가 True인 행만 가져오기
- loc[행 조건] : '조건'은 값이 아닌 '판단결과'
- 조건의 길이는 데이터프레임 행 수와 동일
- 행이 100개면 조건도 True/False 100개
👉 True인 행만 살아남고 False인 행은 제거