-
MySQL의 집계 함수(AVG 등)는 별도 언급이 없으면 NULL을 무시하고 계산
-
set은 중복 원소가 없는(duplicate 없음) 컬렉션 -
{"a","b","a"}는 결국{"a","b"}가 되어 길이는 2
Q6 정답: B
- 기본 인자 값은 함수 정의 시 1번만 평가되고, 그 값이 호출 간 재사용됩니다.
- 리스트처럼 가변 객체를 수정(append)하면 누적되어
[1]다음에[1, 2]가 됩니다.
- pd.to_numeric(..., errors="coerce")는 숫자로 못 바꾸는 값을 NaN으로 강제 변환
duplicated() 기본 동작은 첫 등장만 False, 이후 중복은 True
SQL: IN ('OK','SUSPECT')로 다중 조건 필터
SELECT
  u.city,
  ROUND(AVG(r.rating), 1) AS avg_rating,
  COUNT(*) AS rating_cnt
FROM ratings r
JOIN movies m
  ON r.movie_id = m.movie_id
JOIN users u
  ON r.user_id = u.user_id
WHERE DATE(r.rated_at) = '2026-01-03'
  AND m.genre = 'Comedy'
  AND m.is_available = 1
  AND r.review_status IN ('OK', 'SUSPECT')
  AND r.rating IS NOT NULL
GROUP BY u.city
ORDER BY avg_rating DESC, u.city ASC
LIMIT 1;
Q13 중복 제거 + 변환 + merge + 필터
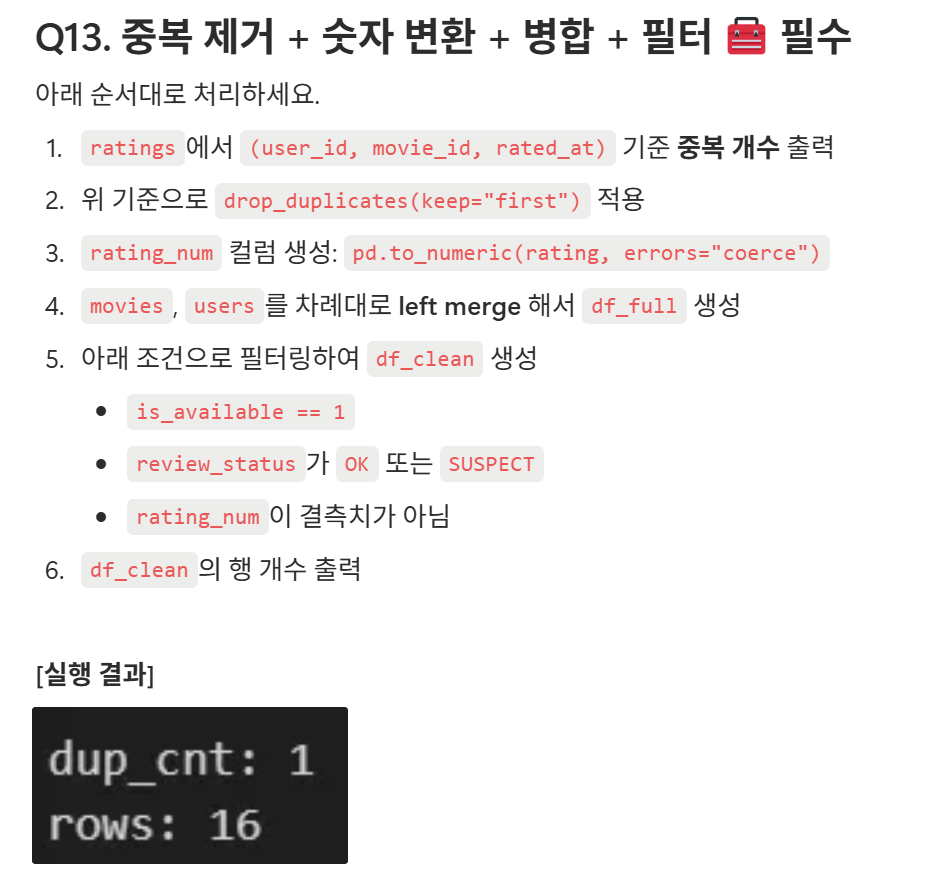
import pandas as pd

users = pd.read_csv("users.csv")
movies = pd.read_csv("movies.csv")
ratings = pd.read_csv("ratings.csv", parse_dates=["rated_at"])

dup_cnt = ratings.duplicated(subset=["user_id", "movie_id", "rated_at"]).sum()
print("dup_cnt:", dup_cnt)

ratings2 = ratings.drop_duplicates(subset=["user_id", "movie_id", "rated_at"], keep="first").copy()
ratings2["rating_num"] = pd.to_numeric(ratings2["rating"], errors="coerce")

df_full = (
    ratings2
    .merge(movies, on="movie_id", how="left")
    .merge(users, on="user_id", how="left")
)

df_clean = df_full[
    (df_full["is_available"] == 1) &
    (df_full["review_status"].isin(["OK", "SUSPECT"])) &
    (df_full["rating_num"].notna())
].copy()

print("rows:", len(df_clean))
Q14 도시×장르 요약
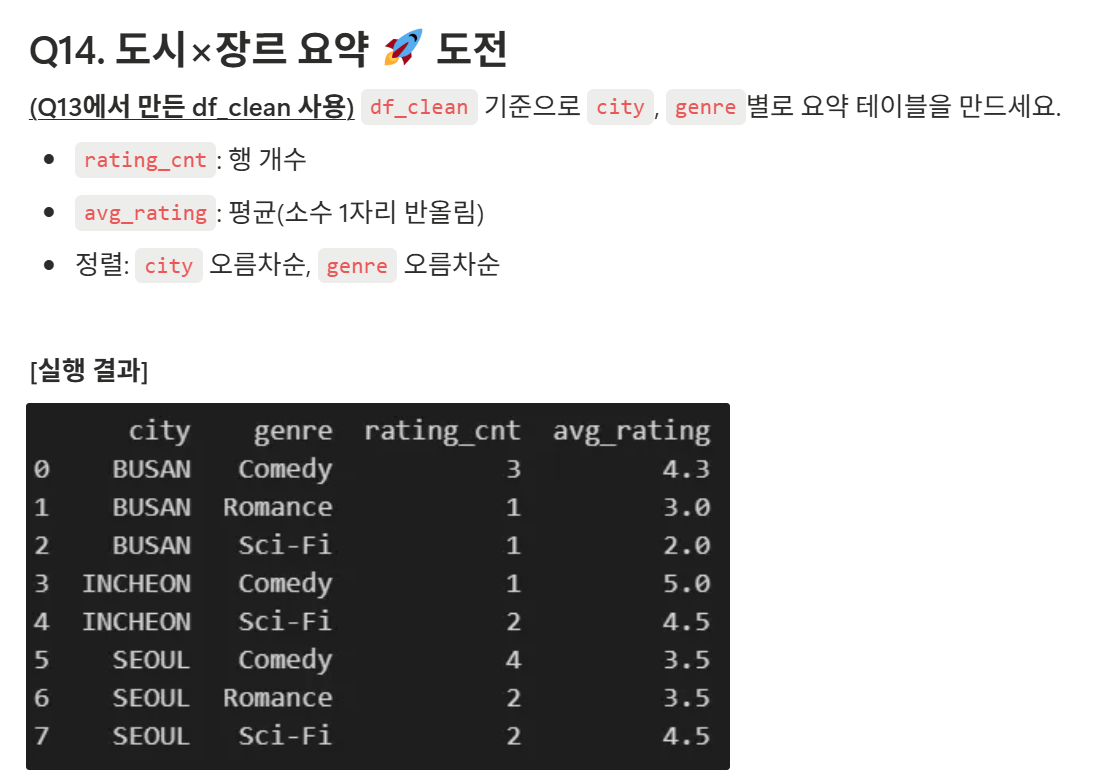
import pandas as pd

users = pd.read_csv("users.csv")
movies = pd.read_csv("movies.csv")
ratings = pd.read_csv("ratings.csv", parse_dates=["rated_at"])

ratings2 = ratings.drop_duplicates(subset=["user_id", "movie_id", "rated_at"], keep="first").copy()
ratings2["rating_num"] = pd.to_numeric(ratings2["rating"], errors="coerce")

df_full = (
    ratings2
    .merge(movies, on="movie_id", how="left")
    .merge(users, on="user_id", how="left")
)

df_clean = df_full[
    (df_full["is_available"] == 1) &
    (df_full["review_status"].isin(["OK", "SUSPECT"])) &
    (df_full["rating_num"].notna())
].copy()

summary = (
    df_clean.groupby(["city", "genre"])
    .agg(
        rating_cnt=("rating_num", "size"),
        avg_rating=("rating_num", "mean"),
    )
    .reset_index()
)

summary["avg_rating"] = summary["avg_rating"].round(1)
summary = summary.sort_values(["city", "genre"], ascending=[True, True])

print(summary)
Q17. 평점 분포 히스토그램
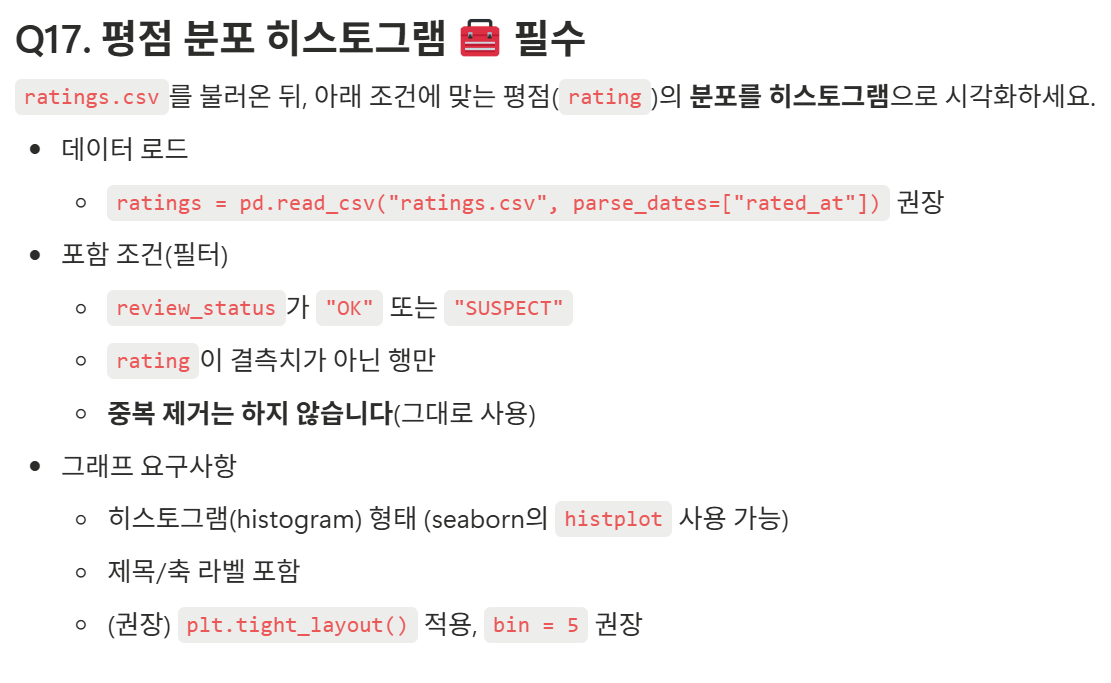
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

ratings = pd.read_csv("ratings.csv", parse_dates=["rated_at"])

df = ratings[
    ratings["review_status"].isin(["OK", "SUSPECT"]) &
    ratings["rating"].notna()
].copy()

plt.figure(figsize=(6, 4))
sns.histplot(data=df, x="rating", bins=5)
plt.title("Rating Distribution (OK/SUSPECT)")
plt.xlabel("Rating")
plt.ylabel("Count")
plt.tight_layout()
plt.show()
https://www.notion.so/teamsparta/2f72dc3ef51480bcaf74cbdd201e669a?source=copy_link