데이터 분할
훈련, 검증, 테스트 세트의 역할
머신러닝 모델에게 수집한 모든 데이터를 한 번에 주고 학습시키면 지명적인 문제가 발생한다.
데이터에 담긴 규칙을 이해하는 것이 아닌, 질문과 답을 통째로 외워버리는 과적합 현상이 발생한다.
이를 방지하기 위해 train_test_split 기능을 활용하여 3개의 독립된 공간으로 분리한다.
- 훈련 세트 ( Train Set ) - 60%, 인공지능이 공식을 학습하고 가중치를 업데이트 하는 주력 교재
- 검증 세트 ( Validation Set ) - 20%, 학습이 잘 진행되고 있는지, 학습률이 적절한지 중간에 평가하여 다이얼을 조율하는 데이터
- 테스트 세트 ( Test Set ) - 20%, 학습이 끝난 후, 모델이 한 번도 본 적 없는 데이터를 주입해 일반화 성능을 평가하는 최종 관문
데이터 분할의 핵심 옵션
데이터를 분할할 때 단순히 앞뒤를 자르는 것이 아닌, 철저하게 섞고 균형을 맞추는 장치가 필요하다.
train_test_split의 하이퍼파라미터
- test_size=0.2 : 전체 데이터 중 몇 퍼센트를 시험용으로 빼둘 것인지 정한다.
- randon_state=42 : 데이터를 섞을 때 사용하는 난수표의 번호, 이 번호를 고정해 둠으로써 다른 컴퓨터에서도 똑같이 쪼개진 데이터가 출력된다. ( 재현성 확보 )
- shuffle = True : 분할 전 데이터를 트럼프 카드처럼 무작위로 섞는다, 특정 정답이나 패턴이 한쪽에만 쏠려 모델이 편향되게 학습하는 것을 막는 역할
- stratify = y : 정답 데이터의 비율이 쪼개진 훈련/테스트 세트 안에서도 동일하게 유지되도록 나눠주는 강력한 옵션
데이터 스케일링과 분할
-
스케일링이 필요한 이유
데이터의 원본 숫자가 너무 크면, 인공지능이 곱셈을 할 때 보폭이 꼬여 오버슈팅이 발생한다. -
MinMaxScaler
- 가장 큰 값을 1, 가장 작은 값을 0으로 맞추어 데이터를 0~1 사이의 비율로 압축해 주는 도구
- StandardScaler
- 데이터의 평균을 0, 표준편차를 1로 맞추어 데이터가 평균으로부터 얼마나 떨어져 있는지 표준 점수(Z-Score)로 변환해 주는 도구
- 실무에서 가장 많이 쓰이는 영점 조절기
- 계산된 결과인 표준 점수가 1이라면 평균보다 조금 높은 값, -2라면 평균보다 한참 낮은 값이라는걸 직관적으로 알 수 있게 된다.
$X_{new} = \frac{X-평균}{표준편차}
분산, 표준편차, 표준점수
-
분산 ( Variance )
- 데이터들이 평균에서 얼마나 멀리 떨어져서 정신없이 흩어져 있는지를 나타내는 수치.
- 값을 제곱하기 때문에, 현실적인 크기를 직관적으로 감잡기 어렵다는 단점이 있다.
시그마 제곱 : 분산
X_i : 각 데이터의 값
뮤 : 데이터의 전체 평균
N : 전체 데이터의 개수 -
표준 편차 ( Standard Deviation )
- 분산에 루트를 씌워 제곱된 단위를 원래대로 되돌린 값.
- 데이터들이 평균을 중심으로 평균적으로 이만큼씩 떨어져 있는지를 나타내는 표준적인 거리
- 표준편차가 크면 데이터들이 평균에서 멀리 퍼져 있고, 작으면 평균 주변에 모여 있는 것.
-
표준 점수 ( Z-Score )
- 어떤 데이터가 평균으로부터 표준편차의 몇 배만큼 떨어져 있는지를 상대적으로 나타낸다.
- 절대적인 수치로 파악하기 힘든 정보를 상대적인 수치를 통해서 확인하기 위해서 사용한다.
Z : 표준 점수
X : 내가 확인하고자 하는 특정 데이터의 값
뮤 : 전체 평균
시그마 : 표준 편차
위의 세 공식은 결국 하나로 연결 된다.
분산 -> 표준편차 -> ( 분모로 활용 ) 표준점수
다중 회귀 & 규제 모델
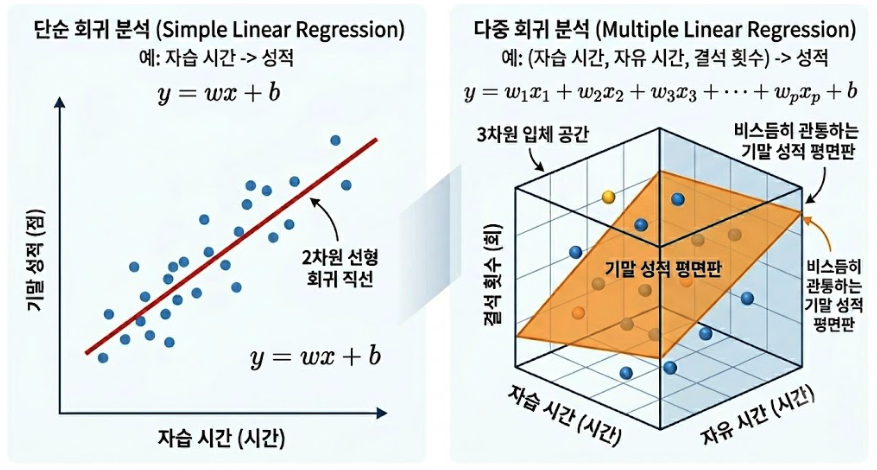
다중 선형 회귀, 다중공선성
y = 예측해 낼 정보
x1 = 첫번째 데이터
x2 = 두번째 데이터
w1, w2 : 각 정보가 최종 결과에 미치는 영향력/중요도 (가중치)
b : 기본적으로 가져가는 값 (편향)
다중 공선성
- 원인 변수들끼리 서로 지나치게 밀접한 상관관계를 가져서 독립적인 기여도를 파악하기 어려워지는 중복 간섭 현상
- 데이터가 아주 조금 바뀌어도 가중치 계수가 날뛰어 모델의 신뢰도가 크게 추락한다.
- 모형의 과적합 위험을 크게 키워 새로운 데이터를 마주했을 때 예측력이 상실된다.
- 분산팽창계수 (VIF)
- 다중공선성이 존재하는지 진단하는 가장 직관적인 핵심 척도 지표로 아래 기준을 따른다.
- VIF = 1
- 다중공선성이 전혀 없다.
- 매우 안전한 변수이므로 그대로 모델 학습에 사용
- 1 < VIF <= 5
- 가벼운 중복 존재
- 모델 성능에 주는 악영향이 미비하여 허용 가능한 수준
- VIF >= 10
- 심각한 다중공선성 존재
- 변수를 제거하거나, 하나의 종합 변수로 합치거나, 규제 모델을 걸어야 한다.
특성 공학 & 규제 모델
- 특성 공학
- 기존의 변수를 가공하여 더 유용한 단서를 새롭게 만들어내는 전처리 과정
- 변수가 급증해 과적합이라는 부작용이 생길 수도 있다.
- 변수에 패널티를 부여해 과도한 영향력을 억누르는 규제가 필요.
- 과적합
- 유용하다는 이유로 다향 변수를 너무 많이 사용하면 인공지능이 훈련용 데이터의 자잘한 정보까지 암기하는 족쇄에 묶이게 된다.
릿지 회귀 L2 규제
- 릿지 회귀 (Ridge)
- 예측 평균 오차를 정밀하게 조율하며, 가중치들의 제곱합을 추가 패널티로 부과해 특정 변수에 쏠리는 현상을 방지
: 최종 손실 함수
- 모델의 '예측 오차'와 가중치들의 '복잡도(크기)'를 동시에 고려하여, 모델이 최종적으로 최소화해야 하는 종합 벌점
- 이 값이 가장 작아지는 지점을 찾는 것이 Ridge 회귀의 학습 목표
: 평균 제곱 오차
- 실제 데이터의 정답과 모델이 예측한 값의 차이를 제곱하여 평균낸 값
- 모델이 데이터의 경향성을 얼마나 잘 맞추고 있는지 평정
- 모델의 데이터 적합도를 담당
" : 규제강도
- 데이터 적합도와 모델의 단순함 사이에서 어느 쪽에 더 무게중심을 둘지 결정하는 조율 계수
- 사용자가 직접 지정하는 값으로, 알파값이 커질수록 모델은 오차를 조금 더 허용하더라도 가중치들을 강하게 압박하여 모델을 단순하게(과적합이 방지되도록) 만든다.
: L2 규제항 / 패널티항
-
모델의 편향을 제외한, 모든 독립 변수들의 가중치를 제곱하여 더한 값.
p : 모델에 사용된 독립 변수의 총 개수
j : 각 독립 변수의 번호를 지정하는 인덱스, 편향을 규제에서 제외하기 위해 0번이 아닌 1번 변수부터 시작 -
특정 가중치가 비대해지는 것을 막아 모델의 과적합을 방지하는 역할
라쏘 회귀 L1 규제
- 릿지 회귀와 마찬가지로 모델이 과적합 하는 것을 막아주는 역할을 하지만 릿지와 달리 불필요 하다고 생각하는 데이터의 가중치를 0으로 만들어 버린다.
- 예측에 도움이 안되는 불필요한 컬럼은 모델이 스스로 판단하여 가중치를 0으로 지워버린다.
- 중요한 핵심 원인들만 골라내어 남기는 효과(변수 선택)가 있다.
- 모델이 최종적으로 최소화해야 하는 종합 벌점, 이 점수가 낮을수록 완벽한 모델
-
모델의 편향을 제외한 모든 독립 변수 가중치들의 절대값 함
p : 모델이 학습하는 독립 변수(컬럼)의 총 개수
j : 각 변수의 인덱스, y절편 역할을 하는 상수항은 전체의 기본 바닥 선을 잡아주어야 하므로, 릿지와 마찬가지로 규제대상에서 제외 한다.
!!! 왜 절대값을 더하면 가중치가 0으로 사멸할까?
릿지는 둥근 원, 라쏘는 뾰족한 다이아몬드다
가중치를 줄이기 위해 패널티를 주는 과정을 그래프로 그리면,
릿지는 가중치들을 둥근 원 모양의 경계선 안으로 압박한다.
라쏘는 가중치들을 마름모 모양의 경계선 안으로 밀어넣는다.
오차가 가장 적은 최적 지점을 찾다 규제 경계선과 처음 마주치는 지점을 찾게 되는데,
릿지는 완만한 곡선 위에서 만나기 때문에, 가중치들이 매우 작아질뿐 완벽한 0이 되긴 어렵다.
반면 라쏘는 뾰족한 모서리에서 처음 만나게 된다.
축 위에서 만난다는 것은 가중치 그래프의 좌표 중 하나가 정확히 0이 된다는 뜻이다.