정의
X와 Y라는 두 가지 확률 변수가 있다고 하자.
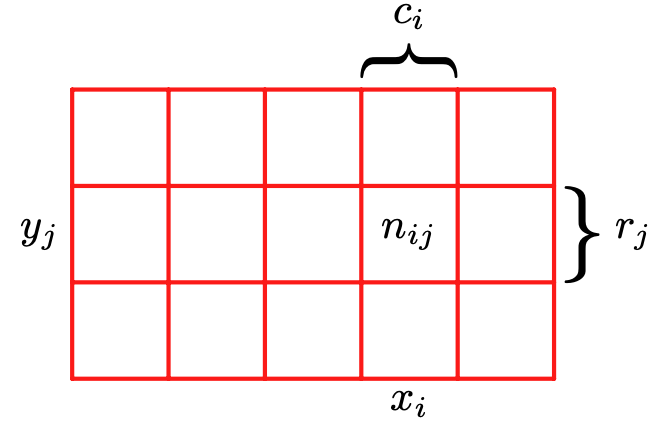
- X는 xi(i=1,…,M) 중 1
- Y는 yi(i=1,…,L) 중 1
- X=xi,Y=yj 인 시도의 개수 = nij
- X=xi인 시도의 숫자 = ci
- Y=yi인 시도의 숫자 = ri
sum rule (합의 법칙)
p(X=xi)=∑j=1Lp(X=xi,Y=yj)
conditional probability (조건부 확률)
p(Y=yj∣X=xi)=cinij
product rule (곱의 법칙)
p(X=xi,Y=yj)=Nnij=cinij⋅Nci=p(Y=yj∣X=xi)p(X=xi)
확률의 법칙
- 합의 법칙
- p(X)=∑Yp(X,Y)
- 곱의 법칙
- p(X,Y)=p(Y∣X)P(X)
Bayes’ theorem (베이즈 정리)
위 개념들을 이용하여 다음 식을 도출할 수 있다.
p(Y∣X)=p(X)p(X∣Y)p(Y)(식 1.12)
베이지안 정리의 분모는 다음과 같이 나타내어 지는데, 정규화 상수로 볼 수 있다. 모든 Y 값에 대하여 식 1.12의 왼쪽 항의 합이 1이 되도록 한다.
p(X)=Y∑p(X∣Y)p(Y)(식 1.13)
고등학교 확통 시간으로 돌아간 기분이 드는데, 빨간 상자를 고를 확률이 40%, 파란 상자를 고를 확률이 60%라고 하자. 그리고 과일이 다음과 같이 있다고 하자.
상자가 주어졌을 때, 고른 게 어느 과일인지 계산하는 것은 매우 쉽다. 하지만, 과일이 주어졌을 때 고른 상자가 뭐였는지 묻는다면?
베이지안 정리를 적용하여 조건부 확률을 뒤집으면 된다. 오렌지를 골랐는데, 그게 빨간 상자에서 나온 것일 확률은
p(B=r∣F=o)=p(F=o)p(F=o∣B=r)p(B=r)=43×104×920=32
이다. 합의 법칙에 따라 고른 오렌지가 파란 박스 출신일 확률은 1/3.
과일을 모르는 상태에서 어떤 박스를 선택했는가? → prior probability 사전 확률 (어떤 과일이 선택되었는지 관찰 전의 확률)
과일이 오렌지라는 것을 알게 되면 p(B∣F) 계산 가능 → posterior probability 사후 확률 (사건 F 관찰 후)
파란 상자를 고를 사전 확률이 더 높음. 하지만, 과일이 오렌지라는 것을 알고 나면 빨간 상자를 고를 사후 확률이 2/3. 오렌지를 골랐다는 증거로 사전 지식을 뒤엎음.
1.2.1 확률 밀도 (Probability densities)
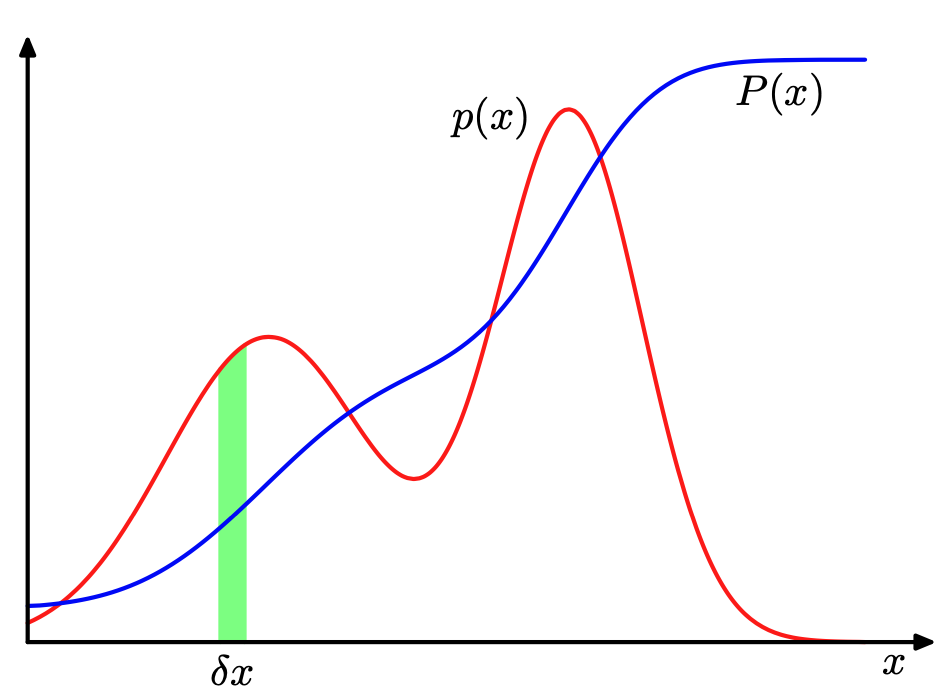
이산적인 사건이 아닌, 연속적인 변수에서는 확률 값을 구간으로 표현한다.
(x,x+δx)
변수의 확률 δx이 0에 수렴하면 p(x)를 x의 확률밀도라고 한다.
p(x∈(a,b))=∫abp(x)dx(식 1.24)
확률 밀도 함수 p(x)는 다음의 두 조건을 만족시켜야 한다.
- p(x)≥0(식 1.25)
- p(x)dx=1(식 1.26)
변수가 비선형 변수로 변환될 때 두 변서의 확률 밀도가 다르므로 확률식도 함께 변환 되어야 한다.
x=g(y)
f(x)→f~ (y)=f(g(y))
(x,x+δx)를 (y,y+δy)로 변환.
py(y)=px(x)∣∣∣∣∣dydx∣∣∣∣∣=px(g(y))∣g′(y)∣(식 1.27)
최종으로는 위와 같이 사용된다.
x 에 대해 확률 함수 p(x) 가 주어졌을 때 구간 (−∞,z) 에 대한 확률 값을 cumulative distribution function 누적 분포 함수라고 한다.
P(z)=∫−∞zp(x)dx(식 1.28)
- 식을 보면 당연한 소리긴 하지만, P(x)를 미분하면 p(x) 구할 수 있다.
벡터로 표현되는 x에 대해서도 결합 확률 밀도 p(x)=p(x1,…,xD)로 정의할 수 있다.
다변량 확률 밀도에서도 다음 두 조건을 만족시켜야 한다.
- p(x)≥0(식 1.29)
- ∫p(x)dx=1(식 1.30)
x가 이산 변수일 때는 p(x)는 probability mass function (확률 질량 함수)라고 부르기도 한다.
연속 변수의 확률 밀도와 이산/연속 변수가 조합된 경우에도 확률 밀도에 합의 법칙과 곱의 법칙, 베이지안 정리를 적용할 수 있다.
- p(x)=∫p(x,y)dy(식 1.31)
- p(x,y)=p(y∣x)p(x)(식 1.32)
1.2.2 기댓값과 공분산 (Expectations and covariances)
평균값을 기댓값이라고 하며, 분포의 종류에 따라 다음과 같이 나타난다.
- 이산 분포
- E[f]=∑xp(x)f(x)(식 1.33)
- 연속 변수
- E[f]=∫p(x)f(x)dx(식 1.34)
- 유한한 N개의 포인트에서 추출된 값의 평균은 기댓값에 근사 (N이 무한으로 수렴하면 거의 정확해짐)
- E[f]≃N1∑n=1Nf(xn)(식 1.35)
변수 여러 개를 사용하는 함수에 대한 평균
- Ex[f(x,y)](1.36)
조건부 기댓값
- Ex[f∣y]=∑xp(x∣y)f(x)(1.37)
분산
- var[f]=E[(f(x)−E[f(x)])2](1.38)=E[f(x)2]−E[f(x)]2(1.39)
- var[x]=E[x2]−E[x]2(1.40)
두 변수 x, y에 대한 공분산
- cov[x,y]=Ex,y[(x−E[x])(y−E[y])]=Ex,y[xy]−E[x]E[y](1.41)
벡터에 대한 공분산
- cov[x,y]=Ex,y[(x−E[x])(yT−E[yT])]=Ex,y[xyT]−E[x]E[yT](1.42)
1.2.3 베이지안 확률 (Bayesian probabilities)
| 빈도론적인 관점 | 베이지안 관점 |
|---|
| 빈도를 통해 모델링을 하므로, 실제 데이터가 존재해야 불확실성을 정량화할 수 있음 | 사건이 발생하지 않은 경우에도 확률을 부여할 수 있음 |
| |
- 데이터가 주어지기 전에 사전 확률 값이 있고, 데이터가 주어지면서 어떻게 변화하는지 계산할 수 있음
- 새 증거가 주어질 때마다 불확실성을 수정하고, 새로운 결과에 따라 최적의 선택을 내리고 싶음
- 관측값들을 이용하여 사전 확률을 사후 확률로 바꾸는 역할
- 사후 확률 ∝ 가능도 × 사전 확률
- 데이터의 개수가 부족한 경우 유용
- 데이터를 계속 추가적으로 얻는 상황에서, 전체 데이터를 새로 분석하지 않고, 이전 분석 결과에 새로운 데이터를 합쳐서 업데이트만 하면 됨
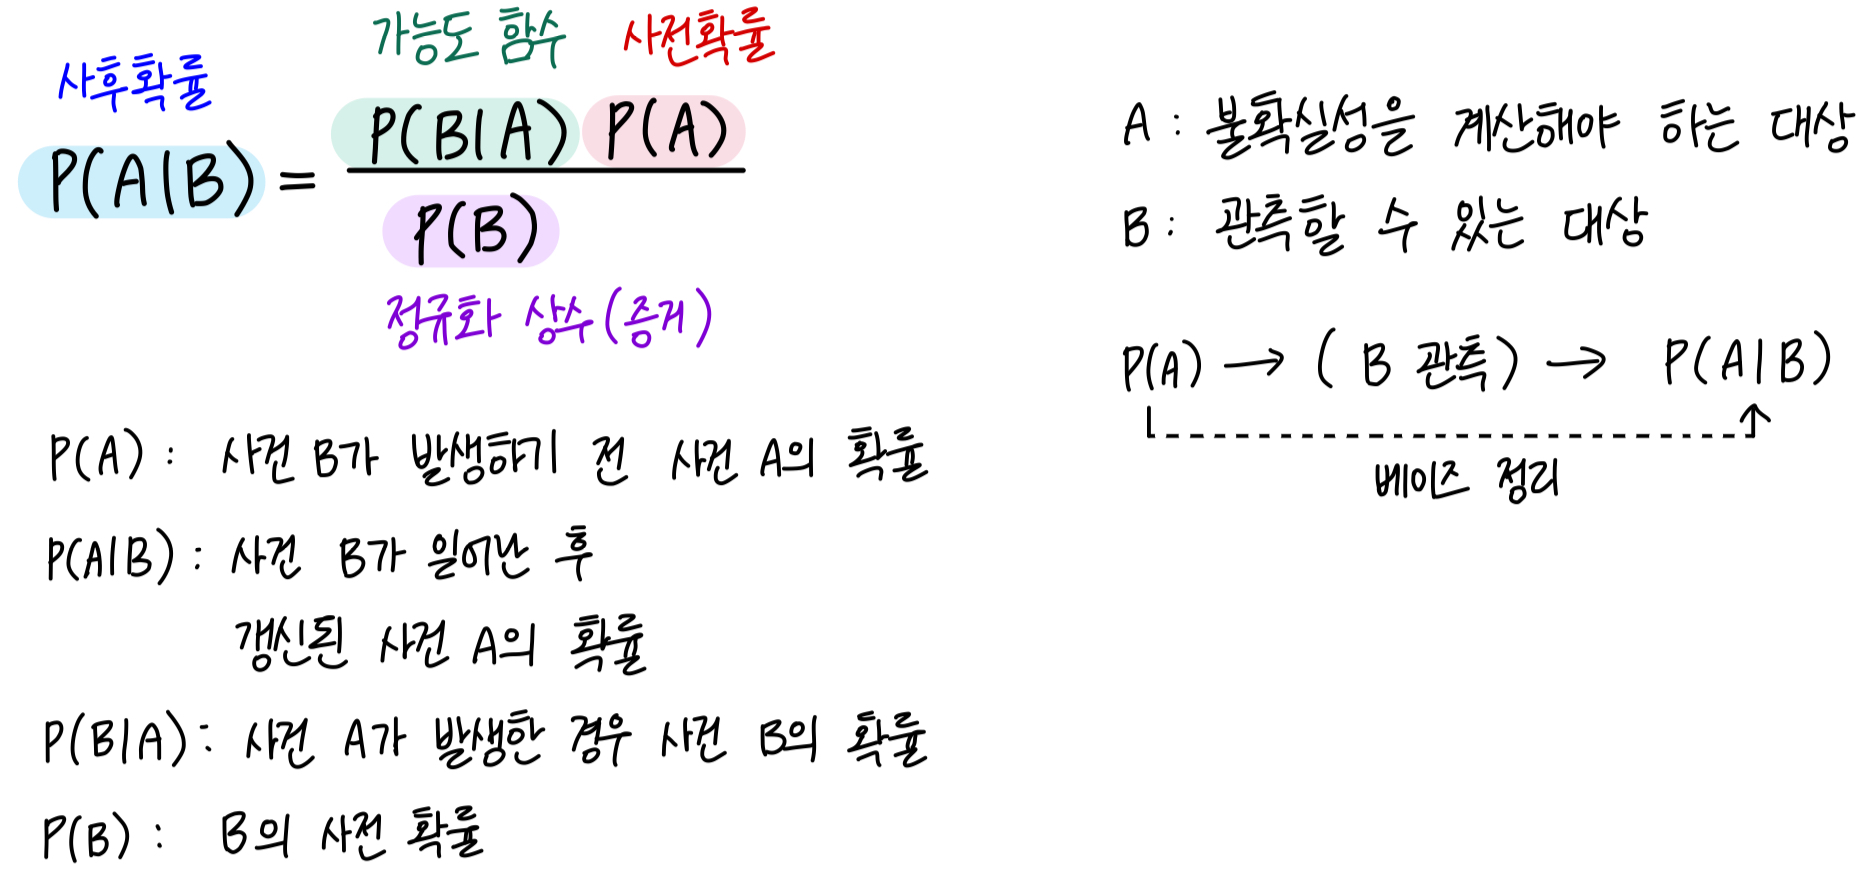
학습 모델의 매개변수 w를 정할 때, 불확실성을 수치화하고 표현하는 데 사용할 수 있음
- 데이터를 관측하기 전의 w에 대한 우리의 가정을 사전 확률 분포 p(w)로 표현
- 관측된 데이터 D={t1,...,tN}은 조건부 확률 p(D∣w)로 작용
- D를 관측한 후에 w에 대한 불확실성 p(w∣D)=p(D)p(D∣w)p(w)
- 가능도 함수 (likelihood function) : p(D∣w)
- 관측 데이터 집합 D를 바탕으로 계산
- 매개변수 벡터 w의 함수. w에 대한 확률 분포가 아님 (적분값 1 아니어도 됨)
- 각각의 매개변수 벡터 w에 대해 관측된 데이터 집합이 얼마나 ‘그렇게 나타날 가능성이 있었는지’ 표현
- 정규화 상수 : p(D)
- 사후 분포가 적법한 확률 분포가 되고, 적분값이 1이 되도록 하기 위한 정규화 상수
- 양변을 w에 대해 적분하면 베이지안 정리의 분모를 사전 확률과 가증도 함수로 표현할 수 있음
- p(D)=∫p(D∣w)p(w)dw
가능도 함수 p(D∣w)
- 빈도적 확률 관점
- w : 고정된 매개변수 (뭔지 모르지만, 데이터로부터 추정함)
- Maximum likelihood 최대 가능도
- p(D∣wML)가 최대가 되는 wML 추정
- 부트스트랩을 통해 데이터 집합을 여러 개 만들어서, 각각의 부트스트랩 데이터 집합에서의 예측치와 실제 매개변수 값과의 차이를 바탕으로 매개변수 추정값의 통계적 정확도 판단
- 베이지안 확률 관점
- 실제로 관측된, 오직 하나의 데이터 집합 D만이 존재하고, 매개변수의 불확실성은 w의 확률 분포를 통해 표현됨
- 실제로는 평균이나 최빈값과 같은 값으로 사용함 (MAP)
이해를 위한 예시
어떠한 질병에 걸릴 확률이 0.5%라고 하자.
이 질병을 진단하는 검사가 질병이 있는 사람을 양성으로 판정할 확률이 99%이고, 질병이 없는 사람을 양성으로 판정할 확률이 2%라고 한다.
- 어떤 사람의 검가 결과가 양성이라고 한다. 실제로 질병에 걸렸을 확률은?
사전 확률 P(A)=0.5%=0.005
검사가 양성으로 뜰 확률 P(B)=0.005×0.99+0.995×0.02=0.02485
실제로 질병에 걸렸는데 진단이 양성일 확률 (가능도) P(B∣A)=0.99
검사가 양성일 때, 실제로 질병에 걸렸을 확률은 다음과 같다.P(A∣B)=P(B)P(B∣A)P(A)=0.024850.99×0.005=0.024850.00495≒0.2 사전 확률이 0.5% 였는데, 양성이라는 증거 관찰 이후, 사후 확률은 20%가 되었다.
- 이 사람이 검사를 한 번 더 했는데, 또 양성이 떴다고 한다. 실제로 질병에 걸렸을 확률은?
사전 확률 P(A)=20%=0.2
검사가 양성으로 뜰 확률 P(B)=0.2×0.99+0.8×0.02=0.214
실제로 질병에 걸렸는데 진단이 양성일 확률 (가능도) P(B∣A)=0.99
검사가 양성일 때, 실제로 질병에 걸렸을 확률은 다음과 같다.P(A∣B)=P(B)P(B∣A)P(A)=0.2140.99×0.2=0.2140.198≒0.925 이 사람이 양성 판정을 한 번 받았을 때, 질병에 걸렸을 확률은 20%였다.
양성 판정을 한 번 더 받고 나니, 질병에 걸렸을 확률이 92.5%까지 올라갔다.
이렇게, 사전 확률에서 사후 확률을 알아내고, 새로운 증거가 들어오면 기존 알고 있던 사후 확률을 다시 사전 확률로 삼아 다시 사후 확률을 계산한다.
1.2.4 가우시안 분포 (The Gaussian distribution)
Gaussian distribution 가우시안 분포는 normal distribution 정규 분포라고도 한다.
단일 실수 변수 x에 대하여 가우시안 분포는 다음과 같이 정의된다.
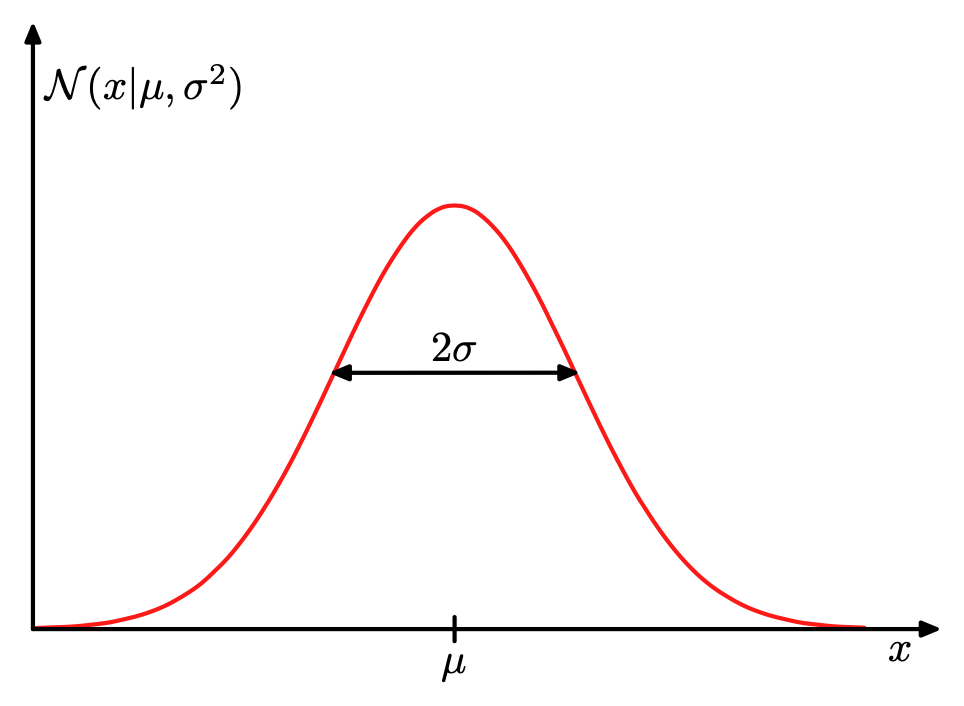
N(x∣μ,σ2)=(2πσ2)1/21exp{−2σ21(x−μ)2}(식 1.46)
- μ : mean (평균)
- σ2 : variance (분산)
- σ : standard deviation (표준 편차)
- β=1/σ2 : precision (정밀도)
- 가우시안 분포는 정규화 되어 있다.
- ∫−∞∞N(x∣μ,σ2)dx=1(식 1.48)
- 가우시안 분포를 따르는 임의의 x에 대한 함수의 기댓값을 구할 수 있다. (평균과 동일)
- E[x]=∫−∞∞N(x∣μ,σ2)⋅xdx=μ(식 1.49)
- E[x2]=∫−∞∞N(x∣μ,σ2)⋅x2dx=μ2+σ2(식 1.50)
- var[x]=E[x2]−E[x]2=σ2(식 1.51)
- 가우시안 분포는 최빈값과 평균값이 동일하다.
이걸 D 차원으로 확장하면 다변량 가우시안 분포가 된다.
N(x∣μμ,ΣΣ)=(2π)D/2∣ΣΣ∣1/21exp{−21(x−μμ)TΣΣ−1(x−μμ)}(식 1.52)
- D×D 크기의 행렬 Σ : 공분산(covariance)
- D 차원 벡터 μ : 평균
MLE (Maximum likelihood estimation)
관측된 데이터 집합 x에 대하여
- x=(x1,…,xN)T
이 데이터 집합이 관찰될 확률을 계산해보자.
모든 데이터 포인트들은 서로 독립적이다. i.i.d (independent and identically distributed)
따라서, 확률 곱으로 표현할 수 있다. 가우시안 분포에서 크기가 N인 데이터셋 x가 추출될 확률은 다음과 같다.
p(x∣μ,σ2)=n=1∏NN(xn∣μ,σ2)(식 1.53)
μ,σ2 의 함수로 보면, 이 식은 가우시안 분포의 가능도 함수이다.
이제 가능도 함수를 최대화 하는 방법으로 가우시안 분포의 μ와 σ2를 찾아보자.
- 가능도 함수를 최대화 하는 이유?
- 주어진 데이터가 관측될 가능성을 최대화 함으로써 적절한 피팅 곡선을 유추해 나가는 방식
어차피 로그 함수도 순증가(단조증가) 하는 함수이므로, 로그를 씌우고 최댓값을 찾는 것도 원래 함수의 최댓값을 찾는 것과 같다. 아래 함수의 값을 최대화 하는 파라미터를 찾자.
lnp(x∣μ,σ2)=−2σ21n=1∑N(xn−μ)2−2Nlnσ2−2Nln(2π)(식 1.54)
- μML : 표본평균에 대한 최대 가능도 해
- μML=N1∑n=1Nxn(식 1.55)
- σML2 : 표본분산에 대한 최대 가능도 해
- σML2=N1∑n=1N(xn−μML)2(식 1.56)
(단변량) 가우시안 분포에서 최대 가능도 방법을 통한 매개변수 계산의 문제점 : bias (편향)
- 분포의 분산을 과소평가하게 됨
- 데이터 집합의 평균 : E[μML]=μ
- 데이터 집합의 분산의 평균 : E[σML2]=(NN−1)σ2
아래에서 계산한 분산 추정치는 비편향이다.
σ~2=N−1NσML2=N−11n=1∑N(xn−μML)2(식 1.59)
limN→∞ 일 때는 σML2이 원래 분폰의 분산과 같아진다.
편향 문제가 다항식 곡선 피팅에서의 과적합 문제의 근본적인 원인이다.
1.2.5 곡선 피팅 (Curve fitting)
곡선 피팅 문제의 목표는 새로운 입력 변수 x가 주어졌을 때 타깃 변수 t를 예측해 내는 것이다.
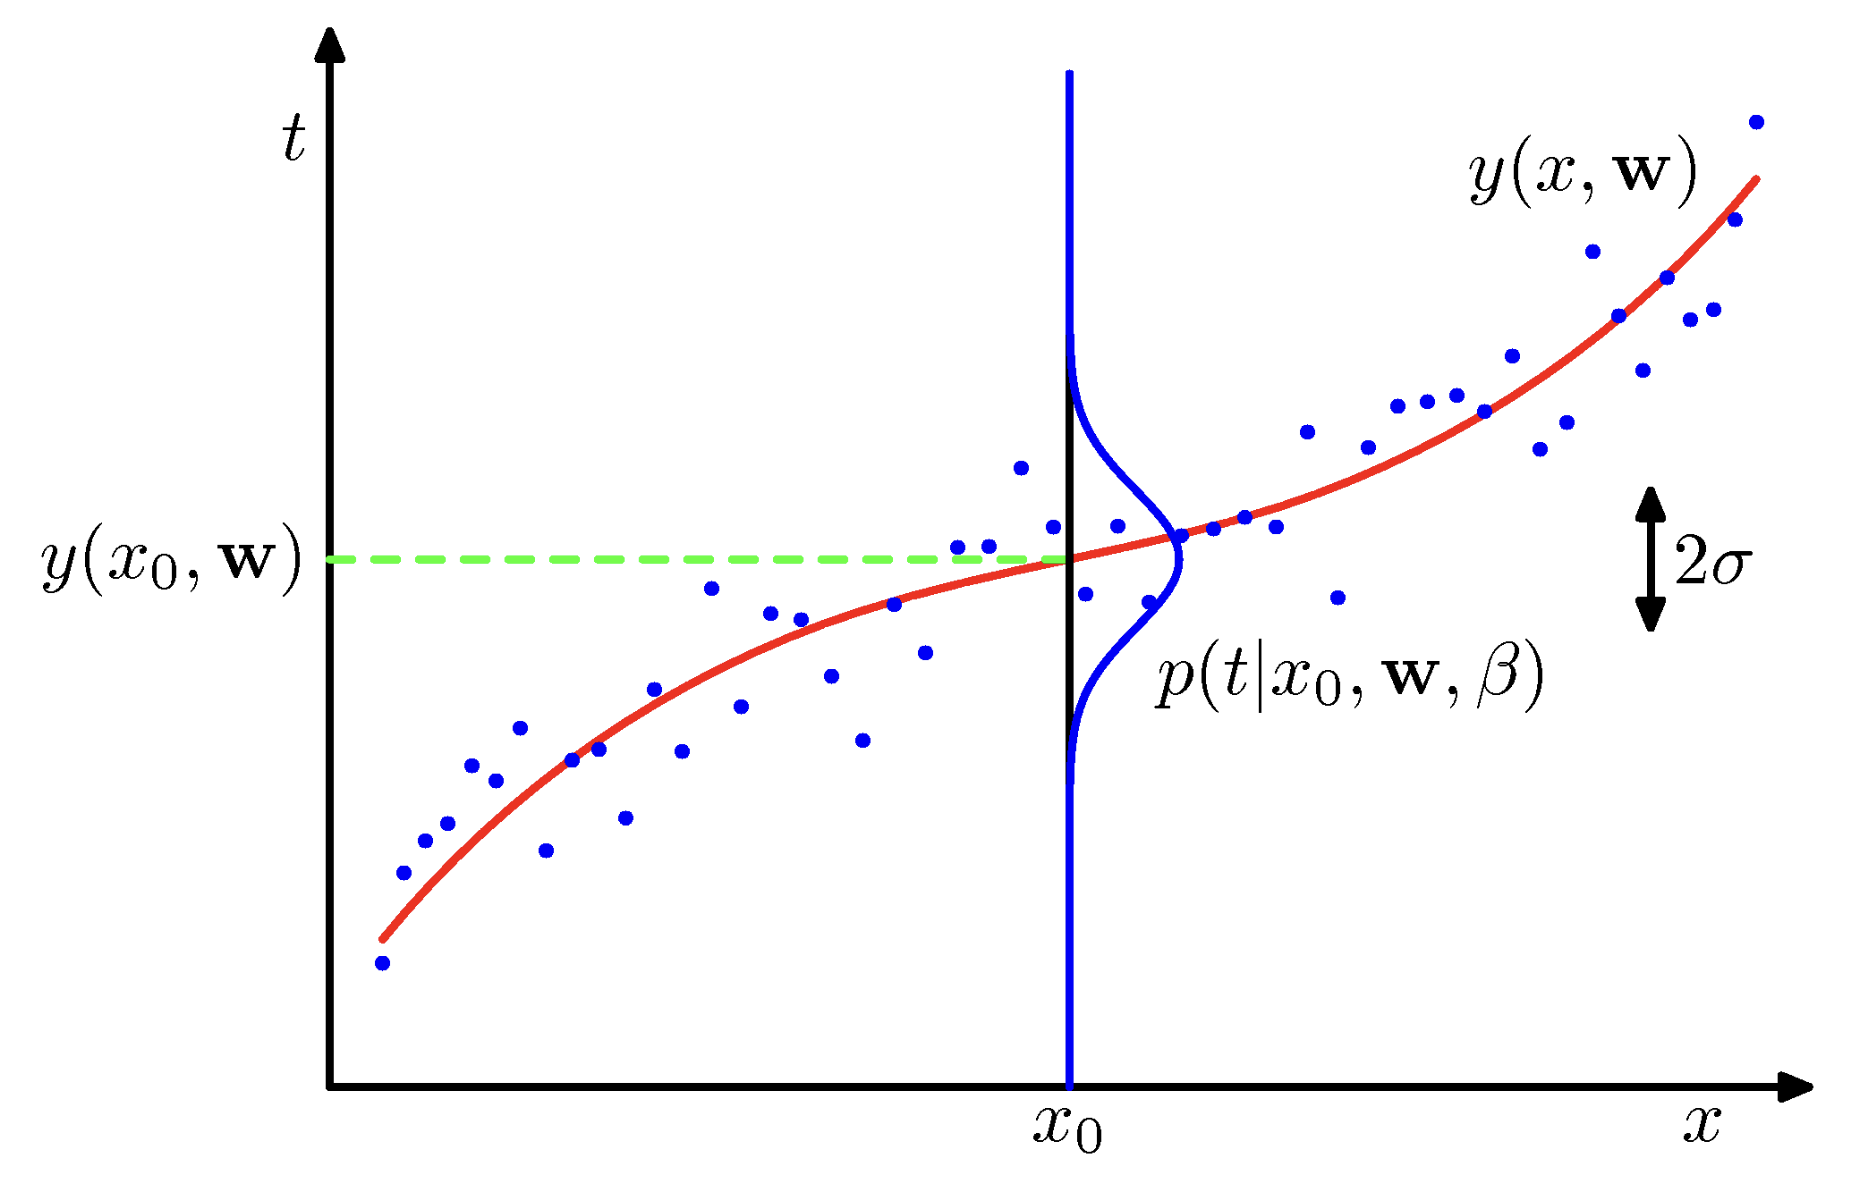
N개의 입력값 x=(x1,…,xN)T과 해당 표적값 t=(t1,…,tN)T가 주어져 있다. x 값에 대한 t 값이 y(x,w)를 평균으로 가지는 가우시안 분포를 가진다. (노이즈가 가우시안 분포로 생성되어 있는 형태)
이때, 조건부 분포는 다음과 같다.
p(t∣x,w,β)=N(t∣y(x,w),β−1)(식 1.60)
- β : 정밀도 매개변수(노이즈의 정확도). 실제 분포의 분산의 역수
이제 훈련 집합 {x,t}를 바탕으로 MLE를 이용해 알려지지 않은 매개변수 w와 β를 구하자.
데이터가 위 분포에서 독립적으로 추출되었다면, 가능도 함수는 다음과 같다.
p(t∣x,w,β)=n=1∏NN(tn∣y(xn,w),β−1)(식 1.61)
식 1.54와 같이 로그를 취해 최댓값을 구하면 편하다.
lnp(t∣x,w,β)=−2β{y(xn,w)−tn}2+2Nlnβ−2Nln(2π)(식 1.62)
이제 여기서 wML을 구하자.
- 우변의 마지막 두 항은 w와 관련이 없다. 날려.
- 로그 가능도 함수에 양의 상수를 곱해도 w 최댓값의 위치는 변하지 않는다. 계수 β/2를 그냥 1/2로 변경.
- 로그 가능도를 최대화하는 대신, (-) 붙여서 최솟값을 찾는 것과 같다.
MLE로 βML도 구할 수 있다.
βML1=N1n=1∑N{y(xn,wML)−tn}2(식 1.63)
MLE로 구한 매개변수들을 식 1.60에 대입하면 t에 대한 predictive distribution (예측 분포)를 얻을 수 있다. 그럼 새로운 x에 대한 t를 예측할 수 있을 것이다.
p(t∣x,wML,βML)=N(t∣y(x,wML),βML−1)(식 1.64)
베이지안은 초기값을 부여할 수 있다.
p(w∣α)=N(w∣0,α−1I)=(2πα)(M+1)/2exp{−2αwTw}(식 1.65)
위 가우시안 분포에서
- α : 분포의 정밀도
- M+1 : M 차수 다항식에서 벡터 w의 원소의 개수
이다. α와 같이 매개변수의 분포를 제어하는 변수들을 hyperparameter라고 한다.
베이지안 정리에 따라, w의 {사후 분포}는 {사전 분포 × 가능도 함수}에 비례한다.
p(w∣x,t,α,β)∝p(t∣x,w,β)p(w∣α)(식 1.66)
이제, 사후 분포를 최대화하는 방식으로 w를 결정할 수 있다.
→ MAP (maximum postetior)
2βn=1∑N{y(xn,w−tn)}2+2αwTw(식 1.67)
사후 확률의 최댓값을 찾는 것은 식 1.67의 최솟값을 찾는 것과 동일하다.
1.2.6 베이지안 곡선 피팅 (Bayesian curve fitting)
사전 분포 p(w∣α)를 포함시켰지만, 완전한 베이지안 방법론에서는 가능한 모든 w값을 나타내야 한다.
모든 w 값에 대해서 적분을 시행하는 주변화를 해야 한다.
예측 분포 p(t∣x,x,t)를 구해보자. 새로운 입력 변수 x에 대해서 타깃 변수 t를 예측해 내야 한다.
베이지안 방법은 확률의 합과 곱의 법칙을 연속적으로 적용하는 것으로, 다음과 같은 형태로 나타내어진다.
p(t∣x,x,t)=∫p(t∣x,w)p(w∣x,t)dw(식 1.68)
p(t∣x,x,t)=N(t∣m(x),s2(x))(식 1.69)
-
m(x)=βϕ(x)TS∑n=1Nϕ(xn)tn(식 1.70)
-
s2(x)=β−1+ϕ(x)TSϕ(x)(식 1.71)
- 첫 번째 항 : 타깃 변수의 노이즈로 인한 예측값 t의 불확실성
- 두 번째 항 : w의 불활실성으로부터 기인한 것이며, 베이지안 접근법을 통해 구해진 것
- S−1=αI+β∑n=1Nϕ(xn)ϕ(xn)T(식 1.72)
- I : 단위 행렬
- ϕ(x) : ϕi(x)=xi (i=0,...,M)인 벡터
cf)
- 기존 샘플 데이터 : 벡터 (x,t)
- 예측할 데이터 : (x,t)
- 특정한 w 값을 고정하는 것이 아니라 w 에 대한 모든 가능성이 확률 함수를 통해 모델에 반영이 되어 있음
