Data Build Tool이 무엇인지 알아보자
dbt란 무엇인가?
- Data Build Tool (https://www.getdbt.com/)
- ELT용 오픈소스: In-warehouse data transformation(이미 웨어하우스에 들어온 데이터를 변화한다!)
- Analytics Engineer라는 말을 만들어냈다.
- 다양한 데이터 웨어하우스를 지원
- Redshift, Snowflake, Bigquery, Spark
- 클라우드 버전도 존재한다.
dbt 구성 컴포넌트
dbt를 생성하면 여러 컴포넌트가 생성된다.
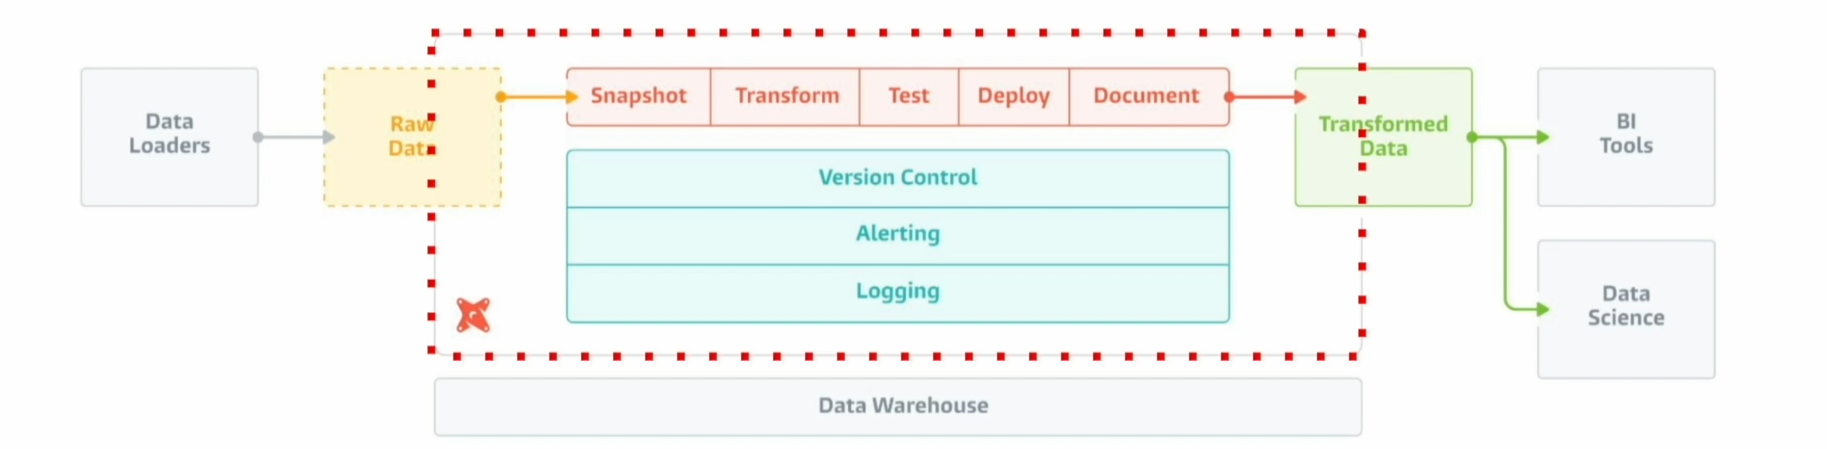
- 데이터 모델
- 테이블들을 몇개의 티어로 관리
- 일종의 CTAS, Lineage 트래킹
- Table, View, CTE 등
- 테이블들을 몇개의 티어로 관리
- 데이터 품질 검증(tests)
- 스냅샷 (snapshots)
dbt 사용 시나리오
dbt는 다음과 같은 요구조건을 달성이 가능
- 데이터 변경 사항을 이해하기 쉽고 필요하다면 롤백 가능
- 데이터간 리니지 확인 가능
- 데이터 품질 테스트 및 에러 보고
- Fact 테이블의 증분 로드
- Fact 테이블 : 분석의 초점이 되는 양적 정보를 포함하는 중앙 테이블
ex)사용자 로그
- Fact 테이블 : 분석의 초점이 되는 양적 정보를 포함하는 중앙 테이블
- Dimension 테이블 변경 추적 가능(히스토리 테이블)
- Dimension 테이블 : Fact 테이블에 대한 상세 정보를 제공하는 테이블
ex)사용자 메타 정보
시간이 지나면서 나이가 변경되는 경우가 있기 때문에 히스토리를 추적할 수 있어야 된다.
- Dimension 테이블 : Fact 테이블에 대한 상세 정보를 제공하는 테이블
- 용이한 문서 작성
dbt를 이용한 ELT 작업 실습
Redshift 사용해서 AB테스트 분석을 쉽게하기 위한 아래 ELT 테이블을 만들어보자
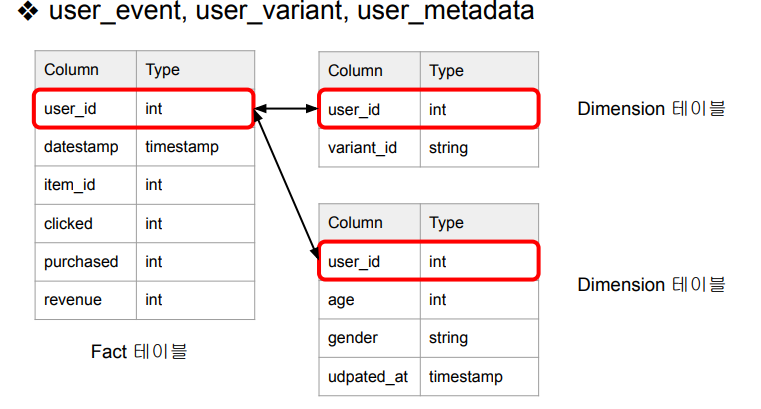
- 입력 테이블:
- user_event
- 사용자의 행동 event에 대한 정보 기록 테이블
- user_variant
- 사용자가 소속한 AB test variant를 기록한 파일 (control vs. test)
- user_metadata
- 사용자 메타 정보(성별, 나이, 주소 등)
- user_event
- 생성 테이블: Variant별 사용자별 일별 요약 테이블
- variant_id, user_id, datestamp, age, gender 컬럼을 사용.
- 총 impression, 총 click, 총 purchase(구매 횟수), 총 revenue(금액)
입력 테이블 요약
Fact 테이블(user_event)과 각 Dimension테이블을 결함.
생성 테이블 (ELT 테이블)
생성 테이블의 코드를 보면 아래와 같을 것이다.
SELECT
	variant_id,
	ue.user_id,
	datestamp,
	age,
	gender,
	COUNT(DISTINCT item_id) num_of_items, -- 총 impression
	COUNT(DISTINCT CASE WHEN clicked THEN item_id END) num_of_clicks, -- 총 click
	SUM(purchased) num_of_purchases, -- 총 purchase
	SUM(paidamount) revenue -- 총 revenue
FROM
	raw_data.user_event ue
	JOIN raw_data.user_variant uv
		ON ue.user_id = uv.user_id
	JOIN raw_data.user_metadata um
		ON uv.user_id = um.user_id
GROUP by
	1, 2, 3, 4, 5;
LV. 1