리버싱 공부를 하자고 했는데 하려면 어셈블리어를 알아야 하더라
그렇게 떠난 긴 여정. 이렇게 길어질 줄 몰랐지.
그렇게 시작된 엉망진창 어셈블리어. 나중에 다시 (언제?) 정리해야지.
https://www.youtube.com/watch?v=Q8xCTztsRmw&list=PL1IheunyylbaYAzQv8bdu3hxq8YX5cKlY
어셈블리어 1. 시작해봅시다
→ 강의에서는 어셈블러마다 지시어가 다르기 때문에 순수하게 어셈블리어만 olly debugger를 사용해 배워볼 생각. 이때, 디버깅이란 프로그램에 버그가 있으면 그것을 열어 버그를 잡아주는 프로그램.
Olly DBG : intel CPU에서 만든 윈도우용 프로그램을 열어 디버깅을 해주는 프로그램
- 기계어 : cpu들이 이해할 수 있는 언어. cpu도 종류가 여러 가지 있는데, intel cpu, ARM cpu 등 존재. 각 cpu 제조사가 이 cpu의 어떤 전기 신호를 보내면 어떻게 작동할 지를 정해 놓았는데, 이 전기 신호를 0과 1로 표현한 것이 바로 기계어.
- 어셈블리어 : 기계어를 일대일로 바꾼 것. 기호, 숫자, 알파벳 단어로 어셈블리어의 규칙을 알면 사람들이 읽기 편하도록 만들어 놓은 것. 기계어도 작업을 하는 단위가 존재, 그 단위를 나눠 일대일로 바꾼 것이 어셈블리어. 어셈블리어는 대소문자를 구분하지 않는다.
- 어셈블러 : 어셈블리어를 기계어로 바꿔준다. 컴파일 작업을 해주는 걸 컴파일러라고 부르는 것처럼, 어셈블을 하는 게 어셈블러. 어셈블은 어셈블리어를 기계어로 바꾸는 것이고, 그 작업을 진행하는게 어셈블러. ANSM, GAS 등 여러 종류가 존재한다. C언어와 다르게 기계어를 바꾼 명령어 set (add, move 등) 인 어셈블리어만 갖고, 어셈블리어를 이용해 프로그래밍을 하기 위한 지시어 (지시어란 섹션을 지정하고, 어느 부분이 데이터를 담도록 표현하는 등의 directive 단, 지시어는 어셈블리어에 따라 각각 다르다.)
어셈블리어 2. 명령어 mov
→ 이번 시간에는 어셈블리어가 어떻게 생겼는지에 대한 공부. 여기서 다루는 어셈블리어는 우리가 PC용으로 많이 쓰는 intel process에서 32bits pc용 어셈블리어에 대해 다룰 예정. (IA-32) 이 아키텍쳐로 만들어진 CPU의 어셈블리어를 배울 예정. 여러 문법 (intel 문법과 ATNT 문법, 비슷하지만 쓰는 구조가 다르다) 중 intel 문법 다룰 예정.
- 어셈블리어의 구조 : 명령어와 피연산자(C언어에서의 인자라는 개념과 비슷. operand, operator) 컴퓨터한테 단어를 이용해 명령을 내리는 기계어&어셈블리어로 무엇을 할 지를 명령하는 게 명령어, 무엇을 할 지를 명령하는 게 피연산자에 해당한다.
가장 기본적인 Olly BDG 사용 방법 :
- 하드웨어 : 어셈블리어는 하드웨어, 기계와 가장 근접한, 하드웨어를 가장 직접적으로 다루는 언어인 기계어를 일대일로 다룬 것이기에 하드웨어를 알아야 한다. 연산은 CPU에서 일어난다. CPU 내부의 저장할 공간인 register (가장 속도가 빠른 저장 공간)이 존재한다. register은 가장 속도가 빠른 저장 공간이다. 대신, 용량이 작기 때문에 프로그램의 전체 데이터를 담을 수 없다. 그건 RAM에 담게 된다. 따라서, 프로그램의 내용은 RAM에 있다. CPU에서 데이터를 쓰거나 읽을 때는 RAM에서, 직접적으로 연산할 때는 register에 저장을 한 후 계산을 한다.
- 범용 레지스터 : 우리가 사용할 수 있는 레지스터 공간으로, EAX, ECX, EDX, EBX, ESP, EBP, ESI, EDI, EIP 이런 이름이 붙어 있는 공간이 있다. 이러한 이름은 intel에서 정의해놓은 것. 32 bits CPU에서 프로그래밍 해서 레지스터를 언급하는 것이기에 각각의 공간이 32 bits, 4 byte를 저장할 수 있다.
- 어셈블리어 볼 수 있는 창 : MOV eax, 1 → 띄어쓰기로 구분된 한 단어가 나오는데 MOV 부분이 operator(연산자, 명령어)이고 띄어쓰기 뒷 부분이 operand. operand는 , 로 구분되어 마치 함수 인자를 여러 개 넣을 수 있는 것 처럼 여러 개를 넣을 수 있다. C의 함수 호출 형태랑 비슷하다. MOV는 2개가 올 수 있다. 뒤에 있는 값을 앞에 넣도록 되어 있다. 메모리 공간을 상자라고 할 때, 상자에 1을 넣는 것.

어셈블리어 3. 범용 레지스터
Olly DBG의 기능
- RETN 맨 윗 줄 마우스 우 클릭 또는 Ctrl + Gray * : New origin. 프로그램은 해당 규칙에 따라 실행 위치를 바꾸기도 하지만 기본적으로 위에서 아래로 한 줄씩 어셈블리어 명령어 리스트를 순서대로 읽으면서 진행.
- register 오른쪽에 있는 값. 2진수를 사용하지 않고 16진수인 자리수가 적은 표현으로 사용. 각각의 레지스터 공간은 4byte이다. 이를 선택 후 더블 클릭하면 Modify EBX로 값을 16진수로 수정 가능하다. 이를 통해 레지스터의 내용인 값을 임의로 변경할 수 있다. → Olly DBG는 숫자를 쓸 때 16진수 값으로 들어간다. 우리가 1이라 작성한 것도 10진수가 아닌, 16진수의 1. 대부분의 어셈블리어에서 16진수의 값이 알파벳으로 시작할 경우, 이가 숫자임을 명시해주기 위해 앞에 0을 붙인다. → AX와 같이 값 지정해 사용도 가능하지만 크기가 다르면 안된다.
- 레지스터 공간 구성 : intel CPU가 32bits CPU가 아닌 16bits인 역사적인 이유로부터 AX, AH, AL → 옛날에 CPU가 16bits 였을 때에는 EAX가 없고 AX가 있었다. 자릿수가 낮은 쪽 1byte를 AL, 높은 쪽 1byte를 AH로 명명해 이용했다. 이제는 16bits가 아닌 32bits로 더 넓게 사용하지만, 예전 이름에 사람들이 익숙해졌고, 낮은 자릿수 bits를 이용하는 것도 상황에 따라 필요하기 때문에 그런 방식으로 사용 가능하도록 이름을 남겨둔 것. 4byte로 확장됐기 때문에 extended AX로 EAX로 이름을 붙였다. 그 중, 낮은 자릿수 2byte를 동일하게 AX, 그중 낮은 자리는 AL, 높은 자리는 AH. 64bits에서는 RAX라는 이름으로 쓰인다.
- 레지스트리 : 윈도우에서 다양한 시스템 값을 결정하기 위함. 레지스터와 혼동하면 안 됨.
- 프로세서 : CPU 같은 처리 장치
- 프로세스 : 하드디스크에 있는 프로그램을 더블 클릭 해 실행하면, 메모리 RAM에 올라간다. RAM에 올라가 있는 상태.
- 레지스트리 : 윈도우에서 다양한 시스템 값을 결정하기 위함. 레지스터와 혼동하면 안 됨.
- MOV reg, (즉시)값과 같이 register 위치에 값을 넣는 작업도 가능하지만, MOV reg(write 장소), reg(read 장소)처럼 register 안에 있는 값을 다른 register로 넣을 수 있다. 덮어쓴다는 표현이 더 정확.
4강
amd : CPU 회사로 intel 기계어를 사용한다.
메모리 ram : 주 기억 장치로, cpu에서 가장 가까운 공간이다. ram은 휘발성 메모리로, 저장용량을 따지면 CPU (Register) < RAM < 하드 디스크 순, 속도는 반대이다. byte 당 가격도 CPU 안에 존재하는 register가 비싸다.
7강
데이터를 메모리에 저장할 때, 저장되는 방식
- little endiam : 낮은 자릿수부터 저장한다.
- big endiam : 큰 자릿수부터 저장한다.
→ 메모리에 데이터를 어떤 방향으로 저장하는지 차이이다.
→ 하드웨어의 구조, 설계를 의미. 데이터를 메모리에 저장하는 방식으로 8바이트로 예를 들면, 다음과 같다. 메모리도 반도체에서 on, off 할 수 있는 비트의 나열로, RAM 저장장치 안에서 byte 단위로 나뉘어져 있지만, byte 안에서는 비트가 존재한다. 8byte를 메모리에 저장할 때는 주소를 준다. 그리고 각각의 주소는 1byte를 의미한다. 어떤 기계에 따라 주소 하나에 2byte를 할당하기도 하지만, intel에서는 주소 하나 당 1byte이다. 메모리에서 작성할 때 항상 낮은 주소부터 큰 주소 방향으로 데이터를 작성하므로 데이터 쓰는 방향은 동일하지만, 읽는 방향은 다를 수 있다.
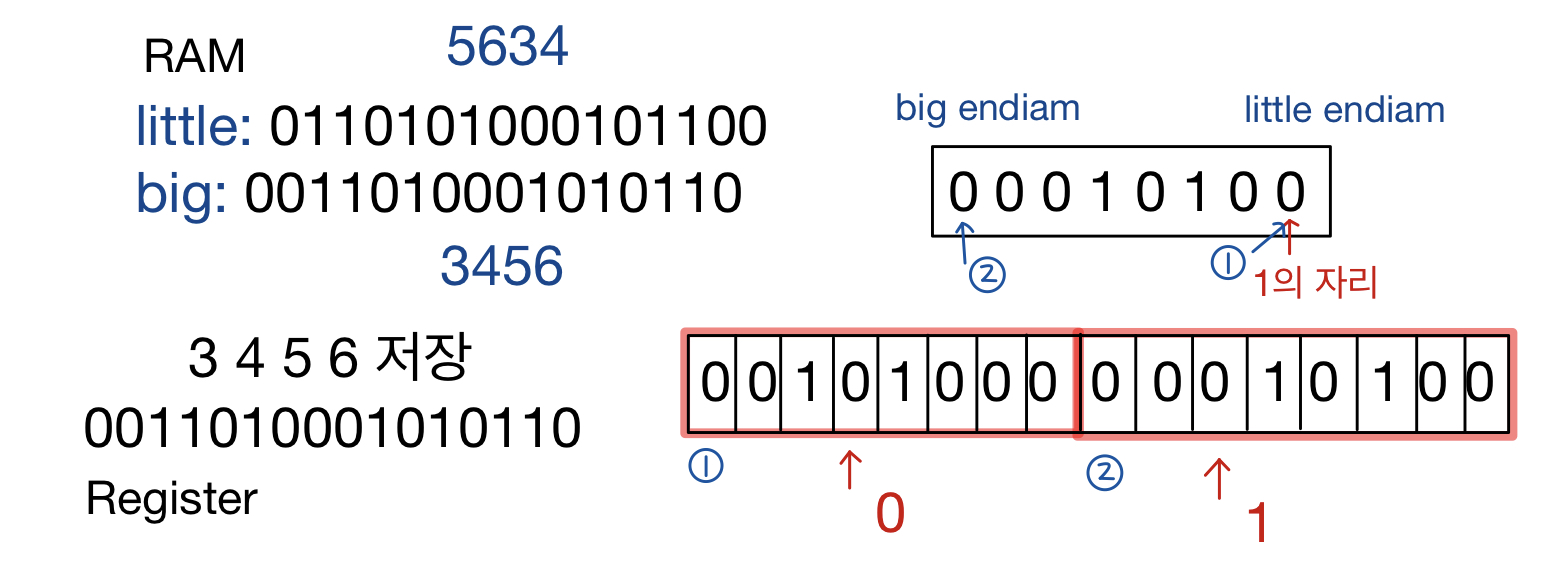
저장은 다음과 같은 방식으로 저장된다. liitle endiam 방식을 사용하면, 주소 낮은 곳부터 큰 방향으로 거꾸로 비트가 들어가게 된다. big endiam 방식을 우리가 글씨 쓴 방향으로 저장한다. 읽는 방식은 저장 방식의 역순으로 읽으면 된다.항상 유의해야 할 점은, 메모리는 항상 낮은 주소부터 높은 주소로 작동한다. big endiam은 먼저 꺼낸 것을 높은 자릿수로 넣는다 → 00110100 01010110 와 같이 읽는다. 이때, 읽는다는 것은 메모리에 있는 데이터를 register에 옮긴다고 보면 된다. 읽을 때 앞에서 꺼내온 것들을 순서대로 register에서 담아 읽는다.
little endiam은 먼저 꺼낸 것을 낮은 자릿수로 넣는다 → 0110101000101100 순서대로 읽는다. 만약, 저장은 2byte로 하고 1byte를 읽어 온다면, 01010110으로 첫 번째 데이터에는 56, 두 번째 byte에는 34가 들어가 있다. 낮은 자릿수 바이트가 먼저 저장되어있다. 프로그램이 위에서 아래로 실행되는 메모리는 시작 주소와 주소 크기를 지정 및 저장하는 방식에서 낮은 주소에서 높은 주소 대로 계속 저장이 된다.
MOV ward PTR [0], 3456 이라 하면 메모리에 이런 식으로 데이터가 들어간다. Olly Debugger의 dump 창에서 1byte 씩 출력 해 각각의 내용물을 출력하면 0번지에서는 56이 들어가 있고, 1번지에는 34가 들어가 있다. AX에 56이 먼저 들어가고 34가 높은 자리에 들어가 3456으로 합쳐진다. → big endiam이라면 높은 자리를 먼저 저장하므로 34 54으로 저장될 것. 읽을 때도, AH에 34, AL에 56이 들어갈 것. 저장의 표현만 다르지, 읽고 나서는 big이나 little이나 3456으로 읽히는 것은 똑같다. 그리고 intel은 little endiam이다.
big endiam으로 저장된 방식을 little endiam으로 읽으면 어떻게 될까?
3456을 big endiam 방식으로 저장하고 읽을 때도 big endiam으로 한다면, 먼저 나온 것이 높은 자릿수가 되게 끔 읽는다. 따라서 제대로 3456이 나온다.
big endiam으로 저장된 걸 little endiam으로 읽는다면, 먼저 나온 데이터가 낮은 자리가 되기 때문에 데이터가 엉망으로 읽히게 된다. 따라서 추후 데이터를 읽고 쓸 때 이를 고려한다. 읽고 쓰는 방식이 똑같으면 데이터는 보존된다.
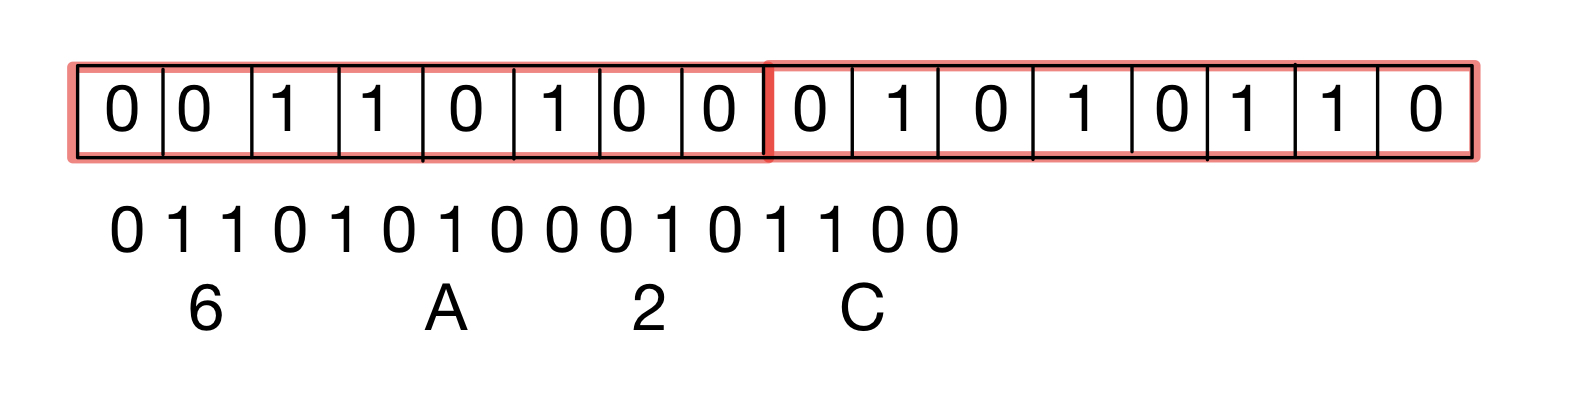
4byte로 저장한 것을 2byte로 읽어온다면, 맨 처음 34를 낮은 자릿수로 보고 12를 높은 자릿수로 보고 읽어와 DX가 1234가 된다.
장단점
little endiam
- 장점 : 낮은 자리의 데이터가 먼저 온다. 12345678 라는 데이터를 저장한다면, 낮은 자리에 해당하는 78, 56, 34, 12 순으로 저장이 된다. 4byte인데 낮은 2byte의 데이터만 읽어오려 한다면, 처음 2byte만 읽어오면 된다. 이런 방식으로 부분을 읽을 때 쉽고, 높은 자릿수의 데이터를 더 추가하려고 하면 다음 byte 수에 넣으면 된다. CPU가 계산을 할 때, 최적화 쪽으로 유리하다. → 형 변환, 수식
big endiam
- 장점 : 이름 방식대로 우리가 통상적으로 사용하는 2진수 자릿수 방식대로 저장하기 때문에 사람이 읽기가 편하다. → 디버깅, 수식 비교
8강
JUMP
jump → 실행의 흐름을 뛴다. JMP로 줄여 사용한다. 어디로 jump 할 지 주소 작성은 어셈블리어 있는 창에서 여러 어셈블리어 코드가 있을 때 원하는 코드로 끼어들 때 메모리 주소를 지정하면 된다. 메모리 주소 이동 명령어. 특정한 구역으로 흐름을 바꾸는 명령어.
실행할 곳의 주소를 담고 있는 레지스터
어셈블리어에서 16진수 의미 → byte
명령어가 위에서 아래로 실행되는 흐름의 이유
CPU 안 EIP 라는 레지스터가 존재한다. 이 곳에 있는 기계어를 가져와 실행하겠다는 의미로 이해하면 된다. 실행 하려 하면 RAM의 기계어 데이터를 가져와야 한다. RAM에서 기계어 데이터를 읽어 온 후, 읽어온 byte 수 만큼 주소 값을 증가 시킨다. 증가 시킨 후, 읽어온 데이터를 실행을 한다. 그런 방식으로 반복을 함으로써 실행을 하게 된다. jump 실행 후, 데이터를 읽어온다. 결과적으로 EIP 레지스터에 우리가 읽어 온 데이터가 들어오게 하는 작업이다. MOV 명령어처럼 해당 레지스터가 들어가게 된다. EIP는 범용 레지스터가 아니라, 일반적 용도로 사용할 수 없으므로 MOV를 사용할 수 없어 jump 명령어를 이용한다. 이때, short은 jump할 위치와 가까우면 사용한다. 기계어로는 EB. EIP에 담겨 있는 주소와 jump할 곳의 주소 차를 이용해 EIP에 더해주는 방식을 이용함으로써 byte를 절약한다. 항상 읽어온 만큼 EIP 증가한다. C언어의 무한루프와 같은 효과.
9강
short에 대비되는 단어인 long → 1byte로 목적 주소와 차이를 저장할 수 없을 때 short이 아닌 long을 사용한다. 이동되는 대상, 화살표로 가르키는 주소와 점프 명령어 실행 후의 EIP 값을 담고 있다. jump 뒤에는 숫자가 올 수 있지만, 다른 저장공간의 값이 올 수 있다. 간단하게 EAX와 같이 레지스터를 작성할 수 있다. 범용 레지스터에 대해 할 수 있다. jump를 특정 공간 안에 있는 값을 이용해 하도록 진행.
10강
증가는 inc, 감소는 dec. 인자가 1 개이다. 저장 장소를 지정해야 하는데 reg가 올 수도 있고, 메모리가 올 수도 있다. 기계어도 일대일이니까 기계어도 눈 여겨 보는 것이 좋다.
11강
더하기는 add, 빼기는 sub. MOV 처럼 2개가 올 수 있다. 레지스터 공간, 메모리, 즉시값 (숫자 데이터) 등 올 수 있는 가짓수는 MOV와 동일하다. 메모리에 어떤 데이터를 더한다. a에 10이라는 값이 들어있다고 가정할 때, add a,10이라고 한다면 a+=10으로 a가 20이 된다. 왼쪽에 있는 변수에 오른쪽에 있는 변수를 더해 넣는 개념. olly debugger는 기본 숫자는 16진수로 본다. EAX의 값에 ECX를 더한다 생각해도 된다. 메모리끼리는 불가능하다.
12강
메모리를 사용할 때 좀 더 다이나미컬 사용 방법 → 바로 주소 값을 간접적으로 사용하는 것.
지금까지는 402000이라는 주소 값에 0을 넣는다고 한다면, mov dword [402000], 0이라고 작성해 주소 값을 직접 적었다. 주소 값을 레지스터에 넣고, 레지스터의 이름을 작성한다. mov eax 402000와 같이 레지스터의 주소 값을 넣은 후에 mov dword ptr[eax], 0 와 같이 레지스터의 이름을 주소 대신하여 넣는다. 간접 접근 방식. 메모리가 존재하고 지금까지는 기계어로 402000이라는 곳의 데이터를 읽어오라고 하면 CPU에서 읽어왔다. 이제는 그 방식이 아닌 402000은 eax에 있고, eax의 주소에서 읽어오라고 해주면 eax에 402000 값이 있으니 402000에서 데이터를 읽어오는 방식이다. mov dword ptr ds:[eax], 10
차이점 : eax 값을 위에서 바꾸면 바뀐 곳에서 데이터를 저장하고 읽는다. 조건문과 분기문을 다양하게 한다면 402000으로 고정이 아닌 방식으로도 작성할 수 있다.
주소가 레지스터가 아닌 메모리에 있다면?
mov dword ptr [402000] 402004 라는 주소 값이 들어가 있다면, 402000이라는 메모리에 주소가 들어가 있다. 여기에 보관해둔 주소를 이용해 데이터를 불러오려면 (이 주소 값을 이용해 402004에 접근하려면) 메모리끼리 못하기 때문에 메모리에 접근하는 대괄호가 두 번 사용할 수 없다. 대괄호 속 대괄호는 불가능하다. 위에서는 레지스터 안에 주소를 넣고 레지스터를 이용해 레지스터 값 안에 있는 주소로 접근을 했다. → 메모리에서 데이터를 읽어서 레지스터에 넣어야 한다. 숫자일 때와 똑같은 mov 명령어로 메모리에서 데이터를 읽어야 하는데, 그 데이터가 주소일 뿐이다. mov dword [eax], 12345678라는 16진수 값을 넣으면, 402000에 12345678이라는 16진수가 들어가게 된다. 이것이 바로 c언어에서는 포인터이다.
포인터 개념
- int a = 0;
→ mov dword ptr [402000], 0 : 0으로 초기화.
- int *p = &a; ← int 형 변수에 주소를 담는 포인터 p에 a라는 주소가 들어가 있다.
→ mov dword[402004], 402000. 이때 a의 주소를 402000이라고 가정해 포인터 변수 p의 값에 넣는 것.
- *p = 4; ← 포인터 간접 접근 연산을 이용해 a에 접근을 한 후, p를 통해서 간접 접근을 해 4라는 데이터를 넣는다.
→ 일단 간접 접근에 해당하도록 주소를 레지스터로 가지고 온다. mov ebx, [402004] 402004의 값을 ebx로 가져온 것.
여기서 402004는 포인터 p 값이 들어있는 공간이라 가정한다.
그 후 이 주소를 이용해 4를 넣어주는 작업인 mov dword ptr [ebx]. 4 라는 값을 넣는다.
간접 접근을 하기 위해 레지스터에 그 주소를 복사해 넣었고 402000이 들어있는 ebx를 이용해 4를 넣는다.
13강
공통점 : 대괄호 안에 메모리의 번지수를 지정한다.
더하기나 곱하기 사용 가능. 옵셋 이용 가능. 옵셋 : 기준에서 떨어진 정도를 지칭할 때 사용하는 말.
예를 들어, 학교 책상에서 철수 위치를 기준으로 오른쪽 3번 → offset
: 일반적으로 변위차를 나타내는 정수 항. 보통 메모리에서 사용. char a[6] 이라 할 때 c언어에서 0번째 +지칭하려는 숫자로 지칭해 사용. 기준 주소 + 거리 → + 이용 가능.
offset 이용해 접근 하는 법
- 기준 주소 402000으로 가정. 지난번에는 그냥 주소를 넣었지만, 이번에는 기준 주소 넣어 사용. mov ebx, [402000] mov byte ptr [ebx + 0],0 mov byte ptr [ebx + 1],1 mov byte ptr [ebx + 2],2 mov byte ptr [ebx + 3],3 mov byte ptr [ebx + 4],4 → ebx가 기준 주소이고 + 값이 offset이 된다.
- 이렇게 사용할 수도 있고 기준 주소를 숫자로 레지스터에 넣는 것도 가능. 기준 주소를 고정으로 하고 offset을 레지스터로 char arr[3] {0,1,2,3} mov dword ptr [ecx],0 mov byte ptr [402000 + ecx] mov byte ptr [402000 + ecx], cl (byte 사용했으니 크기 byte), mov byte ptr [402000 + ecx]. cl
- index를 사용하는 방법. char 주소 하나 당 1byte. int 형 4byte씩 이용하는 경우, 4 byte씩 증가. 4씩 증가해야 한다. ecx를 하나 하나씩 증가하는 방식이 좋은데, ecx 증가에 4를 곱하면 된다. mov dword ptr [ecx*4+402000],ecx → 4 byte씩 뛰어넘어야 하므로 다 4를 곱해준 것. 4 byte 공간 이용. ecx를 넣는 것. index 형태로 주소 지정 후 index 붙일 수 있다. base 주소는 레지스터에 넣을 수 없다. 402000의 값을 ebx + eax로 변경하는 건 불가능.
규칙 : [base + offset + index*scale] 대괄호 안 사용할 수 있는 reg의 개수는 최대 2개이고 index는 반드시 레지스터여야 한다. scale은 자료형이 크게 나타난다. reg[1] 이면 주소가 4 증가되는 것 처럼 해당 요소의 크기를 곱해 배수로 더하는 효과. ecx 부분이 index가 되고 4는 스케일이 된다. scale은 imm으로 많이 표현한다.
14강
상태 플래그 Z
조건 분기문. jump 문에는 여러 종류의 조건이 있지만, 공통적으로 인자를 하나만 받고 그 인자는 주소 (주소에 관한 정보)가 있다. JMP 주소 : 무조건 점프. 조건을 비교해 jump하는 것도 존재. Z : 이전에 했던 결과가 0이 되면 jump를 하는 조건문. flag라고도 부른다.
mov ebx, 1 imc eax (ebx 증가) je short 402000 → 조건 맞으면 jump.
이전에 했던 계산이 0이 됐을 때 jump를 하는 명령어. 계산이 0이 됐을 때 jump가 발생할 때, 어떤 조건을 만족하는지 정리할 생각. 지금은 상태 플래그 집중.
이름이 하나인 레지스터 : 상태 레지스터로 1bits. 상태에 따라 jump의 조건이 결정. mov는 상태 레지스터를 변화시키지 않는다.
종류별로 상태 레지스터 변경하는 것도 아닌 것도 존재. 그저 intel의 설계. z (zero)
상태 플래그 JE
JE도 똑같이 JE 주소 jump if equal의 약자이다. 만약 같으면 점프. 비교를 하는 어셈블리어 명령.cmp로 주는 것도 크기가 같아야 인자 비교 가능. cmp는 compare의 약자로 상태 플래그의 정보를 비교해 취급한다. 같으면 JE를 1로 만들어준다. cmp는 내부적으로 빼기를 이용해 비교를 한다. sub eax, 0 .
eax - 0을 한 후 결과값에 대해서 flag를 setting한다. 두개의 값이 같으면 0 flag가 1로 세팅된다.
JE와 JG는 기계어로 똑같다.
15강
지난 시간에 이어, 여러 가지 조건 분기 문. JE JZ JNE JNZ 이때 n은 not이라는 뜻으로 부정이다. JNE : jump if not equal, JNZ : jump if not zero. 크고 작고를 비교할 수 있는 분기문도 존재. JA, JB. JA : above. JB :below. carry bits → eax를 보면 32비트, 비트 자리 수에 넘어가는 연산이 있다면 carry 비트가 세팅이 된다. 이진법에서 덧셈으로 carry 비트 설명
1111 + 0001 → 올린다. 올림이 영어로 carry. 여기서 carry 는 올린다 의미. carry가 발생을 하는데 비트를 넘어서서 carry가 발생하면 상태 플래그에서 carry를 1로 세팅하는 조건이 된다. 더하기가 아닌 빼기일 때도 마찬가지. carry 빌림과 마찬가지. 빌림이 넘어가면 carry flag에서 세팅이 된다.
32비트를 넘어서 발생하면 빼기 발생. cmp는 빼기만 하는데 0과 0이면 carry가 발생하지 않은데 0가 세팅이 되어 있고 둘이 같다. 같을 때는 jump x. 어셈블리어에서는 상태 플래그를 보고 eax의 값을 뒤에 있는 어셈블리어가 판단 해 jump를 하는 것. 앞의 것이 더 작기 때문에 jump.
정리 : 상태 플래그 중 carry 비트 → 올림의 개념. JA : 앞에 것이 더 크면 (carry = 0, zero = 0), JB : carry가 1일 때 jump를 한다.
16강
JNA, JNB → 각각 JA, JB의 반대. jump 방식은 추가로 상태 플래그를 보고 jump 여부를 결정.
기계어를 보고 어셈블리어를 입력. JAE, JBE와 같이 equal을 붙일 수 있고 맨 마지막에 붙일 수 있다. JNA와 JNB 조건이 같고 기계어로도 일치한다. 그냥 JB는 zero flag를 안 받는다. 같은 경우 carry가 없어도 zero flag 있으면 jump를 한다. carry만 있고 zero는 없으면 jump를 한다. JAE도 비슷한 맥락으로 보면 된다. 같을 경우에는 비활성화. 같은 경우 zero flag 1이 되어 jump. JC는 flag 이름을 이용한 조건 분기문 이름이다. JE JB 두 개의 값을 염두로 두고 만드는 이름. JZ JC 상태 플래그의 여부로 만든 이름. equal은 flag 정보가 아니다. JNAE → jump not above equal 소괄호 붙인 것과 똑같다. equal이 not 보다 우선이다. a ≤ b 결과적으로 above와 똑같다.
17강
JUMP문을 추가로 알아볼 예정. JUMP문에서 JA, JB 에 대해 알아보았다.
오늘은 추가로 JG, JL에 대해 알아볼 예정. 이때 G는 greater의 약자, L은 less의 약자이다. 이것만으로 보면 JA, JB랑 큰 차이가 없어보인다. JA도 큰 것, JB도 작은 것.
단어의 의미는 비슷하다. 다른 점은 데이터가 다르다. 비교하는 데이터를 어떤 데이터로 인식하느냐 그것이 다르다. 일단 부호비트에 대해서 알아볼 예정. 부호데이터를 넣을 수 있다. 2진수를 컴퓨터로 어떻게 표현하는가가 관계가 있었다. 4자리 비트로 표현한다면 1010을 읽어보면 4+8=12로 이 이진수를 12로 읽을 수 있다. 그런데 부호가 있는 표현법에서는 가장 높은 자리수 비트를 부호 취급을 한다. 부호가 붙었다는 건 (-)를 의미. 컴퓨터에서 보통 1은 존재함, 참을 의미하고 0은 거짓, 없음을 의미한다. 가장 높은 자리 비트가 1로 되어 있으면 부호가 있음을 의미한다. 아까와 같은 4자리수 비트인데 이를 부호가 있는 표현법으로 읽으면 가장 높은 자리수의 부호가 있는 걸로 취급해서 -8 +4 = -4가 된다. JG와 JL은 부호가 있는 데이터로써 비교 하는 것이다. JA, JB는 부호가 없는 데이터를 비교한다. 4비트라고 하면 1010과 0001을 부호가 있는 데이터로써 비교하면 -4와 1이 되고 없는 걸로 본다면 12와 1이다. 부호가 없는 데이터로 비교하면 앞이 더 크지만 있는 데이터로 본다면 뒤에가 더 크다. 물론 여기에서는 CMP에서 어떤 데이터를 비교하냐에 따라 그림에서는 4비트로 표현했는데 4바이트라고 하면 32비트가 된다. 예제로 eax에는 -4를 넣고 (mov eax, -4), ebx에 1를 넣겠다.(mov ebx, 1) → 두개를 비교한다. (cmp eax, ebx) → -4라고 작성했는지 실제로 데이터는 FFFFFFFC로 들어가 있다. F는 10진수로는 16, 2진수로는 1111이 된다. F 하나당 1 4자리, 나머지 맨 뒤에 C는 10진수로 12가 되어 4+8이 된다. 부호가 있는 것으로 취급할지 없는 것으로 취급할지가 중요하고 이는 데이터 자체가 의미하는 게 아닌 명령어가 정하는 것. JG, JL과 같이 부호 데이터를 취급하는 명령어를 입력하면 숫자 데이터가 부호값을 가질 수 있는 데이터를 의미하고, JA, JB를 쓰면 부호가 없는 데이터의 표현을 사용한다.
JG short 004100A 회색으로 비활성화가 되어 JUMP를 진행하지 않는다. ollyDebugger의 분석 기능. 그 다음, JL 40100A를 하면 40100A로 JUMP를 하게 된다. JG는 실행을 안하고 JL은 조건이 맞으므로 위로 올라가는 것. 부호가 있는 데이터를 비교할 때 사용. 비교는 cmp도 동일. 비교한 결과를 부호가 있는 데이터로써 작은지 큰지 비교하는 명령어로써 jg와 jl 존재.
zeroflag(결과값이 0이면 zf가 1) = 0 and signflag = of
cmp EAX. EBX (eax - ebx)의 결과값 zeroflag → cmp 빼기 명령어와 다른 점은 빼기 결과값을 첫 번째 오퍼렌드인 eax에 다시 저장하지 않는다는 것. eax - ebx의 값이 0이면 0인 값이 참임으로 zeroflag, ollyDebugger에서 G라고 나와있는 부분이 1
zeroflag가 왜 0이 되어야 하는가? → 1이면 같다는 뜻 이건 jump if greater로써 같은 경우는 배제하고 있다. 같은 경우일 때는 e를 붙이면 되고 똑같이 응용 가능
SF는 레지스터에서 S라고 나와있는 것으로 sign flag이고 OF는 overflow flag이다. 계산결과의 sign 비트 (=최상위, 부호가 있다 가정했을 때 최상위비트를 부호가 가정. sign 비트와 같은 값을 가지게 된다. eax와 ebx는 32비트 4바이트이기 때문에 최상위비트가 32자리수 중 가장 높은 자리수, 계산 결과가 최상위비트가 1이 되었기 때문에 결과로써 sign bit가 1)
overflow 비트 (=지지난시간에 k에 대해 학습, k는 올림이라고 배웠다. 올림으로 인해 표현할 수 없는 자리수 비트가 생길 때 carry 값이 carryflag 비트의 값이 된다. overflow는 sign 비트와 관계가 있다. 0111 + 0001을 더한다고 할 때 결과값이 1000으로 carry는 발생하지 않았는데 sign 비트 값이 0과 0을 더했는데 1이 됐다. 이 숫자들이 부호를 표현할 수 있는 이진수값, 즉 최상위비트가 sign 비트인 경우 계산 결과가 10진수일 때 8이 나와야하는데 부호가 있는 숫자 표현을 읽어보면 -8이 된다. 이 경우 overflow 비트가 세팅이 된다. 이 조건이 바로 overrflow flag에 해당한다. 전문적으로는 계산하는 두 개의 결과값의 sign flag 가 존재하고 같은 경우 1 + 1 이 0이 되거나 0 + 0 이 1이 나오는 건 있을 수 없어 이런 경우 overflow 비트가 세팅.)
→ cmp에서 eax와 ebx 두개를 부호가 있는 숫자로 보고 비교했을 때 앞이 크면 발동
JL SF <> OF (sf와 of가 같지 않을 때) sign flag와 overflow flag 가 같을 때 jg, 반대면, 그렇지 않고 작으면 다르다고 보면 된다. sign flag가 1일 때 음수인 경우 a - b에서 a가 더 작으면 음수가 나옴 a - b < 0 → a < b로 조건에 맞을 때 JUMP 하기 위함. 음수인 경우에서 오버플로우가 일어나지 않았을 때 조건에 맞는 것. 오버플로우가 일어났다면 결과값 양수일 때 JUMP 진행. 여기서 zero flag 판단 안하는 이유는 JG에서 zero flag가 0인 건 결과값이 0이 아님을 의미. 이 조건을 맞는 것 중 0이 되는 게 가능한게 있는지 판단, zero flag 안봐도 되기 때문에 저것만 봄. 결과값이 0이라는 건 sign flag 0, sign flag가 0일 때 overflow 일어날 수 있는지 보면 된다. signflag가 0이고 overlow가 1인 경우 중 결과값이 전부 0인 경우 없어 굳이 확인 필요 x. 결과값이 0이 되려면 1의 자리 경우의 수 보면 0-0, 1-1일 때 결과값이 0. 두 개가 서로 같다 가정 1111 - 1111 = 0000이 나오지만 overflow 세팅 불가능.
18강
E가 붙으면 같은 경우도 포함 이야기. JGE → zero flag가 1인 경우도 JUMP
JGE sign flag랑 overflow 같으면 JUMP 진행. JLE → 결과값이 0일때도 JUMP, 체크 안 하다 체크 해야 한다. N을 붙이면 반대가 됨. JNG == JL JNL == JG
19강
P : parity flag A : auxiliary 보조 캐리 flag
CRC32 → 파일 체크할 수 있고 간단한 오류 복구 할 수 있는 방식 parity 응용
parity란 비트에서 1의 개수의 동등성을 유지시키면서 방식 이용.
odd parity : 비트 개수 홀수로 유지, parity 값을 1로 만듦으로써 이 값에 대한 홀수 parity 만드는 것. 데이터가 깨지고 parity가 안 깨졌을 때 1의 개수가 짝수이므로 데이터의 개수가 깨졌음을 알 수 있다. 비트 하나 이상이 달라졌을 경우 감지 어렵 → 이것의 응용이 CRC, 응용을 하면 복구도 할 수 있다.
even parity : parity까지 개수를 합쳐 짝수가 되도록 유지. 데이터 전송 시 비트 하나 깨지면 1의 개수 홀수이므로 데이터 깨짐을 알아볼 수 있다.
계산 결과 하위 8비트만인 1바이트만을 신경 쓴다. 연산 결과 하위 니블에서 비트 범위를 넘어섰을 때 참이 된다. 이진화 십진법 연산에 사용된다.
4바이트 사용 시 16진수 사용 → 2의 4승이기 때문, 좀 더 자리수가 줄어들기 때문.
이진화 십진법 : 이진수 4자리를 묶어 1자리로 사용. 따라서 4비트까지 체크, 4비트 넘어가는 경우 체크. 9 + 9 18이 아닌 12 발생 → 자릿수 올림이 발생했기 때문에 보조 캐리 플래그가 1이 됨.
20강
carry값을 이용하는 add 명령어 존재.
MOV EAX, 0 ADD EAX, 8. ADD eax, FFFFFFF9 -7이라 나온다. carry flag까지 더해서 3이 된다.
메모리를 이용할 때 4바이트까지밖에 덧셈을 이용할 수 밖에 없다. 8바이트끼리 덧셈을 할 때 ADC를 이용하면 된다. mov dword ptr [402000], 18. mov dword ptr [402004], 20 add dword ptr [402000], dward ptr 402004 → 이런 기계어는 없기 때문에 불가능. mov eax [402000] add eax [402004]
add eax, dword ptr 결과값 mov eax [402008]. C언어로 치면 long long type. move dword ptr [402000], mov dword ptr [402004], 00000001
add eax, [402008]
상위 바이트 쓸 때 그냥 add를 쓰면 올림이 더해지지 않아 adc 로 올림을 더해준다. 뺄셈의 경우는 내림을 처리할 수 있어야 한다. sub 명령어, 내림 빌림 borrow로 B를 사용. 빌림이 발생하면 빌림을 추가로 빼 줘야 한다. 8바이트 데이터 뺄셈, 빌림 발생 220000000 - 190000000 2가 9보다 작으므로 18 - 9 = 9, 빌림이 있어 90000000 으로 결과값이 나온다. 빌림을 빌려오면 잘 빼 준다. SBB는 carry가 세팅되는 부분(SUB에서 세팅)을 빼준다. 빌렸다는 뜻. carry flag
21강
stack 넣는 명령 하나만 있고 꺼내는 명령 하나만 있다. 차곡차곡 넣고 뺀다. pop하면 맨 위가 나온다. 데이터를 어떤 방식으로 저장하는가가 자료구조이고 그 중 stack 존재. 많은 컴퓨터가 사용하기에 지원. 메모리 영역 중 stack 영역 보여줌. 프로그램의 메모리 구조를 볼 수 있다. stack 부분은 프로그램이 켜졌을 때 운영체제가 알아서 메모리 어딘가에서 할당해준다. 어셈블리어 기계어 실행 데이터가 있는 402000과 같은 부분, 범위를 보면 실행 코드가 들어있는 영역, 데이터가 들어있는 영역. 프로그램을 실행시키면 프로그램에서 필요한 메모리 영역 올려준다. ESP랑 EBP 이용. 레지스터 무엇을 의미? esp ebp는 둘다 메모리의 주소를 가지고 있다. pop이라는 명령을 하면 esp가 가르키고 있는 영역의 데이터를 꺼내오고 어디에 저장할지에 대한 저장을 추가로 해준다. esp는 맨 위에 있는 영역을 가르킨다. c언어에서 함수 사용하는 게 스택 사용. 실행되고 있는 함수를 차례로 스택에 넣기 때문. 맨 처음 main을 스택에 넣고, main 안 f1 실행하니까 f1 넣고, f1안 f2 실행하므로 f2 함수 실행 정보 넣는다. f2 끝나면 없애고 f1으로 간다. f1 실행 끝나면 또 pop, 메인으로 다시 가서 f2 다시 실행 등과 같이 컴퓨터가 작동한다.
22강 mul
이번에는 곱셈, 나눗셈을 해볼 예정. 곱셈 연산 (mul) 에는 곱셈 규칙이 있다. 10진수로 설명하자면 한 자릿수와 한자릿수를 곱하면 최대 두 자릿수가 나오고, 세 자릿수는 나올 수 없다. 두 자릿수를 곱하면 최소 세 자릿수, 최대 네 자릿수가 나온다. 컴퓨터에서 이 규칙이 중요한 이유는 메모리가 한정되어 있다. 이진수로 4비트 데이터와 4비트 데이트를 곱하면 최대 8비트까지 나올 수 있다. 이게 왜 중요하냐면 32비트 프로그램이다. 32비트란 건 이진수로 32자리 데이터가 있다는 뜻. 32자리와 32자리를 곱하면 64자리가 나오는데 32비트 프로그래밍에서는 레지스터도 그렇고 64비트 공간이 없다. 레지스터에서 64비트 공간이 없다. 더하기 같은 경우 예를 들어 1 + 2라면 레지스터에 1와 2를 넣고 add eax, ebx와 같은 식으로 넣을 수 있었다. 곱셈도 이런 식으로 하면 좋을 것. 보면 eax는 4바이트, 예를 들어 eax ebx 를 해 어디에 저장하는 곱하기 명령을 하고 싶은데 4 바이트와 4 바이트를 곱하면 8 바이트가 되고 8바이트 데이터는 eax에 못넣고 그렇다고 해서 넣을 공간을 따로 지정해주자니 8바이트짜리 레지스터도 없다. 메모리에도 한 번에 8바이트는 쓸 수 없다. 그렇기 때문에 곱하기에서는 다른 방식을 사용하는 수 밖에 없다. 예를 들어 어떠한 A에 해당하는 숫자와 B에 해당하는 숫자를 곱하고 싶을 때 A에 해당하는 숫자를 미리 eax에 넣는다. 그리고 B에 해당하는 숫자는 mul 명령어를 활용하여 edx로 미리 지정을 해준다. 그럼 결과가 edx와 eax에 걸쳐서 저장이 된다. 4바이트와 4바이트를 하면 곱셈 결과가 8바이트가 되어 이렇게 저장된다. 이때 eax가 낮은 4바이트, edx가 높은 4바이트라고 보면 된다. 4바이트끼리, 4 8 을 한다 하면 처음 mov eax, 4 → mov edx, 8 → mul edx → 이렇게 하면 edx는 eax와 곱하게 된다. edx와 eax에 걸쳐서 8바이트가 저장이 된다. eax 00000020 edx 00000000
edx : eax 로 표현됐는데 하위 4바이트는 eax, 상위 4바이트는 edx에 있다. 따라서 결과값이 0000000000000020 이렇게 8바이트, 16진수 값이 들어갔다고 보면 된다. 16 2 = 32, 결과값이 32가 나왔다는 것. mul이라는 명령어는 부호가 없는 정수에 대해서 곱셈을 하는 것. 덧셈은 상위, 가장 높은 비트가 부호 비트로써 사용될 때 부호가 있는 정수이고 데이터를 나타내는 자릿수일 때는 부호가 없는 정수였다. mul은 부호가 없는 정수에 대한 계산법이다. 더하기 같은 경우 부호가 있든 없든, 즉 - 를 가지는 표현법이든 아니든 상관없이 계산을 할 수 있었다. 예를 들어 0 - 1이라고 할 경우, 00000 - 00001 = 1111 이고 부호가 있는 정수에서 -1 이다. 부호가 있는 정수든 없는 정수든 원하는 대로 잘 되지만 곱셈은 그렇지 않다. edx로 했는데 ebx에 넣고 해도 된다. 그런데 mul에서 곱할 데이터가 들어간 부분은 마음대로 레지스터를 정해서 넣어줄 수 있는데 곱해지는 숫자는 항상 eax에 들어가야 한다. A B 에서 B에 해당하는 데이터는 원하는 레지스터에 넣어서 mul 명령어를 이용해 operand로 지정해줄 수 있지만, A에 해당하는 곱해지는 값은 항상 eax에 들어가야 하는 이유는 eax 가 바로 연산에 특화된 레지스터이기 때문이다. accumulator (계산장치) 의 약자인 A이다. 계산에 특화된 공간이다. A B C D 알파벳 순서로 지어진게 아닌 다 의미가 있다. 곱셈도 계산이다. 곱셈을 할 때 이 eax 여기에 곱셈을 당하는, 곱해지는 데이터를 넣어주는 것. 결과는 eax와 edx에 걸쳐서 나오는 이유는 eax는 계산에 최적화된 용도로써 있는 레지스터이고 edx는 데이터의 약자로 데이터를 담는데 쓰는 레지스터이므로 eax와 edx에 걸쳐서 데이터가 나오는 것. 레지스터를 만들 때 각각 용도가 정해져있고 그 중에서 가장 알맞는 것 두 개를 선택하다 보니 eax와 edx였던 것. mul 에는 숫자는 들어갈 수 없다. 숫자 데이터, 이러한 기계어가 없기 때문. 레지스터와 메모리가 들어갈 수 있다. 메모리를 대괄호로 접근, mul dword ptr [402000] 이런 식으로 가능. 메모리 표현과 레지스터가 들어갈 수 있고 mul에 무엇이 들어가냐에 따라서 몇 비트 연산을 할지가 결정된다. mul의 operand로 4바이트짜리가 주어지면 결과는 8바이트가 된다. 8바이트이기 때문에 결과가 eax, edx에 걸쳐 저장되고 만약 여기에 dword가 아닌 word ptr 즉 2바이트라고 하면 2바이트 곱셈이기 때문에 결과는 4바이트. mov ax, 4 ← 2바이트기 때문에 ax에 넣는다. mul word ptr [402000] 이고 402000 메모리에 08 넣어주면 2바이트인 경우는 dx와 ax에 걸쳐서 저장이 된다. ax값이 0020 dx 값은 0000 이므로 값은 000000020. 4바이트 결과가 32가 나온 것. 4바이트 공간으로써 eax가 있는데 eax를 4바이트 공간으로 안쓰고 왜 dx랑 ax를 이용한 공간을 사용하냐? 역사적으로 의미가 있다. 역사적으로 32비트 프로그래밍, 인텔 cpu 32비트가 있기 전 16비트가 있었다. 16비트였을 땐 eax 존재가 없고 ax, dx만 존재. 그 때도 지금과 똑같이 두개로 나눠 저장해야 했다. 상위 dx, 하위 ax dx : ax에 각각 하위 4바이트, 상위 4바이트를 담아서 저장하는 방식 사용. 그러면 한 바이트는 어떻게 되냐면 mov al, 16 → mul byte ptr [402000] → 402000 값에 16 넣어주면 16진수이므로 22가 된다. 22 * 22는 new origin here 해서 al에 16을 넣고 한바이트와 한바이트 곱셈.. 이번에는 결과 ax에 저장됨. 0124. 바이트끼리 1바이트와 1바이트의 곱셈, 2바이트는 al, dl을 이용하는게 아닌 ax에 저장됨. 16비트 시절에 ax는 있었기 때문. 인텔 cpu는 16비트 시절부터라고 생각.
23강 div
나눗셈. div 명령어 이름. 곱하기와 똑같이 div 한 다음에 operand를 하나 준다. 그럼 operand 크기에 의해서 이 나눗셈이 어떻게 이루어질 것인가에 대한 동작이 달라진다. A * B = C 라고 하면 나눗셈에서는 C / B = A 라고 보면 된다. 무슨 말이냐면 B로 2바이트 나눗셈, div에 operand로 2바이트짜리를 주면 4바이트짜리에서 나누기를 하고 결과값, 몫에 해당하는 값은 2바이트가 된다. 저장되는 영역도 곱하기 때와 똑같이 C에 해당하는 영역이 8바이트인 경우 edx: eax에 걸쳐서 저장이 되고 4바이트인 경우 dx : ax에 걸쳐 저장되고 2바이트인 경우는 그냥 ax, 1바이트인 경우는 al이다. 하지만 C가 1바이트인 경우는 없다. B 나누는 값이 어떤 크기인지에 따라서 나눠지는 값인 C의 크기가 정해진다고 보면 된다. B가 2바이트로 정해지면 C는 4바이트로 정해진다. 이건 곱셈 규칙. B가 2바이트로 주어지면 A를 2바이트로 인식하고 최대가 4바이트이므로 C를 4바이트로 정해진다. 2바이트는 어떤 식으로 주어지냐. div 뒤에 레지스터 혹은 메모리 영역을 준다. div 2바이트 해당하는 영역, 예를 들어 bx, 혹은 word ptr 로 메모리 영역 지정해 줄 수도 있다. 직접 해봐야. 32 / 3 을 해볼 것. 일단 4바이트 나눗셈부터 해볼 것. B가 4바이트라는 거. mov ebx 3 → div ebx → C는 8바이트가 되고 edx:eax에 걸쳐서 이용. 그래서 내용이 중복되면 원하는 계산을 못하므로 edx, eax 안쓰고 ebx 쓴 거. → mov eax. 20 (10진수 32) → 상위 4바이트인 edx에 0 넣음. mov edx, 0 → div ebx 하면 4바이트 나눗셈이 된다. 몫은 4바이트 영역인 eax에 나온다. eax가 몫이 되는 것. 그리고 나머지도 존재. 나머지는 edx에 들어간다. 몫과 나머지가 들어가는 영역은 4바이트 나눗셈에서 나눠지는 수 C가 8바이트라 edx: eax를 이용했으면 eax 영역에 몫이 들어가고 edx 영역에 나머지가 들어간다고 보면 된다. C에 해당하는 공간의 하위 영역에 몫, 상위 바이트 부분에 나머지가 들어간다. 그 다음 2바이트 나눗셈을 하면 .. 메모리 영역 쓰기로, 나누는 수는 레지스터도 되고 메모리도 되지만 나눠지는 수는 공간이 어느 곳을 써야할지 정해져있다. B를 2바이트로 쓰면 C는 4바이트가 된다. C가 4바이트로 결정이 되고 4바이트 공간은 dx와 ax에 걸쳐서 저장이 된다. 이유는 16비트 cpu 일 때 역사에 의해서 … mov ax. 0020 → mov dx, 0000 → div word ptr [402000] 이렇게 하고 나눌값인 3을 402000 자리에 넣어주면 된다. ax 값이 0020 dx값이 0000 으로 4바이트 00000020 에서 2바이트 0003을 나눠주는 것. 몫과 나머지가 결과로 몫은 나눠지는 수의 하위 비트인 ax에 000A로 들어가고 상위 비트 dx에 0002로 나머지가 들어간다. 바이트 나누기, div의 operand 크기로 byte를 주면 B의 크기를 바이트로 준다는 건데 이건 나누기의 규칙은 곱셈의 규칙을 그대로 따라 C가 2바이트 영역이 된다. 2 바이트 영역은 ax라 ax에 나눠질 데이터를 넣으면 된다. cpu 회로가 이렇게 설계 되었기 때문에 바꿀 수 없다. 나눌 수는 메모리 영역으로
두 자릿수와 두 자릿수를 나눠 한 자릿수가 나와야 하는데 두 자릿수가 나온 경우, ex. 99 / 1 = 99 인 경우는 에러가 난다. 실행 중 예외가 발생하는 것. mov ax 0100 , 이고 나누는 수를 1로 하면 몫이 하위 바이트인 1바이트에 들어가는데 거기엔 0100을 다 못 넣어서 integer overflow 예외가 발생. 이게 안일어나게 하려면 문제는 C / B = A 에서 C의 바이트 수가 B보다 크다는 것. 같으면 문제가 될 일이 없다. 존재하는 기계어를 이용하는데 4바이트 나누기 4바이트인 것처럼 이용해야 한다. 상위 edx : eax 이렇게 있는데, 기계어에서 실제로는 8바이트를 이용하지만 하위 4바이트만 이용하면 된다.
24강 IMUL, IDIV
이번에는 부호가 있는 정수에서 곱셈과 나눗셈. 사용법은 비슷. 기계어가 달라서 명령어도 어셈블리어로 따로 있다. IMUL, IDIV. 왜 구분하냐면 더하기 빼기 같은 경우 0000 - 0001 = 1111로 데이터가 부호가 있는, 즉 최상위 비트가 부호 있는 데이터라 할 경우 -1이 되는 것. 연산 방식 부호 없는 데이터일 때도 더하기 빼기는 똑같이 이루어진다. 곱하기는 그게 아니다. 1010 1010 한다고 하면 0000 0101 0000 0101 다 더해서 보면 부호비트 부분이 중간에 들어감. 결과값은 7자리가 되는데 최상위 비트만 부호값 가져야 하는데 중간에 부호값 가진 애가 들어가서 전체적으로 안맞음. 부호값을 고려해서 해야한다. cpu 회로 내부적으로는 최적화 알고리즘에 따라 맞게 처리할 것. I가 붙은 버전으로 부호가 있는 데이터를 데이터끼리 곱셈/ 나누는 명령 따로 있음. 부호가 있는 곱셈이 더 외워야 할 게 많음. mov eax, 7 → imul dword ptr [402000] → 메모리에 8 데이터 넣어줌. 4바이트 4바이트 결과로 8바이트가 나온다. 8바이트는 하위 4바이트는 eax, 상위는 edx. 사용 방법이 mul과 똑같음. 2바이트와 2바이트의 곱은 4바이트. 몇바이트끼리의 곱셈이냐에 따라 기계어가 다르다. 어셈블리어로는 비슷한 계열의 명령어. 인자가 2개인 것도 있는데 더하기 빼기처럼 작동. add eax, ebx 하면 계산 값이 첫 번째 operand로 지정된 곳에 들어감. destination, source 이런 규칙으로 이루어진다. sub eax, ebx 하면 eax - ebx 한 결과가 eax에 들어감. IMUL도 이런 버전이 있다. eax, ebx하면 eax와 ebx가 계산이 돼서 eax에 들어간다고 보면 된다. 이걸로 7 8을 해볼 것. mov eax,7 mov ebx,8 → imul eax, ebx. imul A,B A와 B에 각각 들어올 수 있는 type의 경우의 수를 적어보면 A는 레지스터밖에 못 온다. B도 16비트 레지스터가 올 수 있다. 예를 들면 ax, bx 이런 식으로. a에 16비트 레지스터, B에는 16비트 메모리도 올 수 있다. 숫자값도 올 수 있다. imm16. a에는 r16밖에 b에는 r16, m16, imm16, imm8. 8비트짜리 직시값도 가능함. 32비트인 경우에는 a에는 r32, a가 32비트 레지스터인 경우 b도 32비트로 r32, m32, imm32 (16진수로 표현 시 0000007), imm 8. 직시값 8비트 추가로 이용 가능. operand 3개짜리는 경우의 수가 얼마 없다. 16비트인 경우, 32비트인 경우 역시 첫 번째 operand가 그렇게 온다. IMUL A,B,C 면 A B = C. A는 여전히 레지스터만 올 수 있고 B는 레지스터 혹은 메모리, C는 즉시값이 올 수 있다. A가 16비트 레지스터인 경우 B 16비트 레지스터/메모리, 즉시값으로는 16비트/8비트 즉시값 올 수 있다. A가 32비트 레지스터인 경우 B 32비트 메모리/레지스터, C 즉시값 32비트/8비트가 가능하다. IMUL AX,BX,7 이면 AX = BX 7 인 거. operand 가 3개짜리인 경우. IMUL eax, eax, 7을 줄여 IMUL eax, 7로 표현한 것. 어셈블리어로는 다른 표현이지만 기계어로는 같은 표현이다. IMUL eax, 7 이면 eax = eax 7이고 이는 IMUL eax, eax, 7과 같은 표현이자 기본이고 이 표현을 줄인 표현이 다음과 같은 표현이다.
나누기는 곱하기 만큼 복잡하진 않음. 맨 앞에 I는 signed에서의 I. 나누기의 경우는 DIV와 경우의 수가 똑같다. IDIV bl. 한바이트 나누기. IDIV BX. 2바이트짜리 나누기. IDIV eax, 3바이트짜리 나누기. 메모리로는 IDIV byte ptr [402000], IDIV word ptr [402000], IDIV dword ptr [402000] 이렇게 있다. 4바이트인 경우 나눗셈의 결과가 4바이트이다. 몫이 4바이트이고 나머지도 4바이트. 하위에 몫, 상위에 나머지. 4바이트짜리 2개 해서 8바이트 한 것. 나누는 수가 2바이트인 경우 나눠지는 수는 4바이트. 나누기는 추가로 볼 것 없이 명령어가 바뀐다.
25강
종류 2개 존재. st, cl 뒤에 상태 flag 이름이 들어간다고 보면 된다. st는 set의 약자. st c라고 하면 c를 1로 설정한다. 1은 있는 것의 개념, 0은 없는 것의 개념. cl은 clear의 개념. cl c 라고 하면 carry flag를 비워주는 것. STC, CLC. 모든 상태 flag에 대해 set과 clear가 있는 게 아니라 있는 게 있고 없는 게 있다. C, D 존재. D는 direaction flag로 문자열 할 때 나중에 사용. D flag가 쓰이는 어셈블리어 명령어가 따로 있다. 오른쪽에 없지만 상태 flag로 I가 있는데 interrupt flag. 하드웨어 장비나 소프트웨어에서 다른 거 발생시킬 때 사용. 이거 설정하고 비워주는 flag 존재. 32비트 사용자 응용 프로그램 할 때는 설정 못할 때 함. 운영체제나 드라이버 할 때 사용.
26강: 비트연산
비트 연산을 위해 사용. 논리 연산으로 and, or, xor이 있다. and로는 그리고, or는 또는, xor로는 배타적 or, exclusive. 1010 or 1110 → 1110. 비트끼리 연산. 이걸 해주는 어셈블리 코드, 명령어는 논리연산 이름을 그대로 따왔고 쓰이는 규칙은 +/-와 똑같다. 편리를 위해서 레지스터 공간을 이용하도록 하기로. mov eax,0A → mov ebx,0E → and eax, ebx → 00001010 으로 결과값 000000A 저장된 것. 둘다 레지스터 무엇이든 올 수 있는데 크기 같아야 하고 한쪽이 메모리면 나머지 한쪽은 메모리 표현이 아니어야 한다. 물론 즉시값으로도 표현할 수 있다.
27강: test
지난 시간 배운 비트연산과 관련있는데 test는 저장하지 않는다. 두개를 and 연산하는데 저장하지는 않는다. flag들을 설정하는 의미. cmp가 결과값 저장하지 않는 것과 같다고 보면 된다. test 언제 쓰냐면 여러 가지 크기 데이터가 어떠한 데이터의 값이 참인지 거짓인지 dword 판별할 때 사용된다. 예를 들어 eax값이 1로 설정됐다 하고 test eax,eax 하면 0이 아닌 값은 다 참 나오는데 0끼리 and연산하면 얘는 거짓이 나온다. 0000 and 0000. 그래서 컴퓨터에서 0이면 거짓 0이 아닌 값은 참. 결과가 0이면 zero flag 세팅됨. 세팅되어있으면 test로 확인한 값이 거짓이다, 아니면 참이라는 걸 알 수 있다. eax 값 판단. test한 eax 안 내용이 참인지 거짓인지 판단. 판단을 해서 JZ 401005 이런 식으로 만약 거짓이면 점프해라 이렇게 줄 수 있다. c언어에서 if문 테스트 명령어가 사용된다. 더 자세하게 c언어 어셈블리어로 알아보는 건 나중에 .. test 이런 용도로 사용. 메모리 영역끼리만은 안된다. 메모리, 레지스터 자주 사용되는 표현은 아님. 레지스터, 레지스터가 주된 사용법. 비트연산은 순서가 바뀌어도 상관 없다. test는 계산 결과 저장 안하기 때문에 순서 바뀌어도 상관 x. 기계어 표현으로는 같은 표현.
32강:call, ret
어셈블리어에서 함수 호출 및 리턴에 대한 내용. 지난 시간 스택 push, pop 에 대해 스택은 왜, 프로그램에서 어떨 때 쓰이는지 이야기. c언어 코드에서 함수가 호출될 때 프로그램은 스택을 사용한다. 스택은 나중에 넣는게 마지막에 넣는 구조이다. 계속 넣었다 뺐다 하는 과정을 통해서 알 수 있다.
1 #include <stdio.h>
2 void f (void) {
3 	int a, b;
4 }
5 void g(void) {
6 	int a;
7     f();
8 }
9
10 void h(void) {
11 	int a;
12     f();
13     g();
14 }
15 int main()
16 {
17     int a;
18     f();
19     g();
20     h();
21 }
처음에 main을 실행하면 스택 안에 main에 대한 정보를 넣는다. 위에서 봤을 때 가장 먼저 보이는 함수를 실행한다고 보면 된다. 후 , f 라는 함수를 만나면 f를 넣어 f를 실행 후 f실행이 끝나면 f를 버린다. f 실행이 끝난 후에 g 함수를 만나면 g를 실행한다. g를 실행하면 g 안에서 f가 실행되고 있으므로 f를 넣는다.f에서 실행이 끝나면 f를 내버린 후 g로 온 후 g도 끝났으므로 내다 버린다. h를 실행하는데 f를 호출하고 f가 끝나면 f를 빼고 g 안에서 f가 호출되고 있으므로 f 호출 후 끝나면 빼고 g도 끝나므로 뺀다. 후 h도 끝나므로 h도 빼고 main도 끝나므로 main도 뺀다.
더 자세하게 이야기 하자면, 코드마다 줄번호를 넣고 몇 줄 실행하고 있는지를 이용해서 어느 부분이 실행하다 말았는지를 넣는다. main이 실행되고 있다. 18번째 줄에서 f를 실행하라고 한다. f 실행되고 f 실행이 끝나면 19번째 줄로 갈 것이다. f를 실행하면 어셈블리어로 치면 실행 흐름을 바꾸는 걸 jump라고 쳐도 된다. 따라서 f를 실행한다는게 2번째 줄로 jump한다고 볼 수 있다. 어디를 계속 실행해야할지 기록을 안하려 잃어버린다. 따라서 실행이 끝나면 어디를 실행할지 적어둔다. 19번째 줄, 그 숫자를 스택에 넣어놓는다. 후 f가 있는 2번째 줄을 실행 후 끝나면 스택에 있는 데이터인 19를 꺼내 19번째 줄부터 다시 실행한다. g라는 함수가 호출되므로 함수 호출 끝난 후 어디로 갈지 기록해야 한다. 20번째 줄에 대한 호출 number, 위치를 기록하고 g 를 실행시킨다. g 함수 실행하다가 7번째 줄에서 f 함수 호출을 마주친다. 이때도 다음에 실행할 줄인 8을 스택에 넣고 f를 실행한다. f 실행이 끝나면 스택에서 하나를 꺼낸다. 8번째 줄에 대한 정보를 꺼내고 실행하면 또 함수가 끝나므로 스택에서 하나를 꺼내 20번째 줄을 실행한다. h 호출이 진행하므로 스택에 21을 넣고 f 호출되므로 13을 넣고 끝난 후 꺼내고 g가 호출되므로 14를 넣고 g에서도 함수가 호출되므로 8을 넣고 g가 끝나면 빼고 g 함수도 끝나므로 스택에서 14를 꺼내 14번째 줄로 돌아간다. 후 h 함수가 끝나면 21을 빼 21번째 줄로 돌아가면서 프로그램이 종료된다. 정확하게는 main을 호출하고 어디서부터 계속 해야할지 정보가 바닥에 있겠지만 c언어에서는 알 수 없으므로 생략.
이 과정이 어셈블리어로 함수를 호출하고 리턴할 때 그 동작이 일어나고 확인 가능하다. 코드 상에서 줄 번호고 썼지만 어셈블리어에서 각 어셈블리어 명령 코드들이 메모리에 몇 번지에 존재하는지 알 수 있다. 따라서 줄 번호로 비유한 건 실재로는 메모리 주소로 이용된다. 함수를 호출하는 명령어는 CALL, 함수 호출이 끝나고 반환하는 명령어는 RET이다. 줄 번호로 비유한 건 실제로는 메모리 주소로 이용된다.
CALL 00401015
//00401015 자리를 함수로 만들어준다. 함수에서 수행하고 싶은 계산식을 작성한 후 RET를 작성해준다.
- PUSH EIP
- JMP <주소>
이 두 작업을 실행한 것과 같은 결과를 지니지만, EIP는 범용 레지스터가 아니므로 push 불가능. Push EIP 라는 기능은 없으므로 call만을 쓰는 메리트가 있는 것.
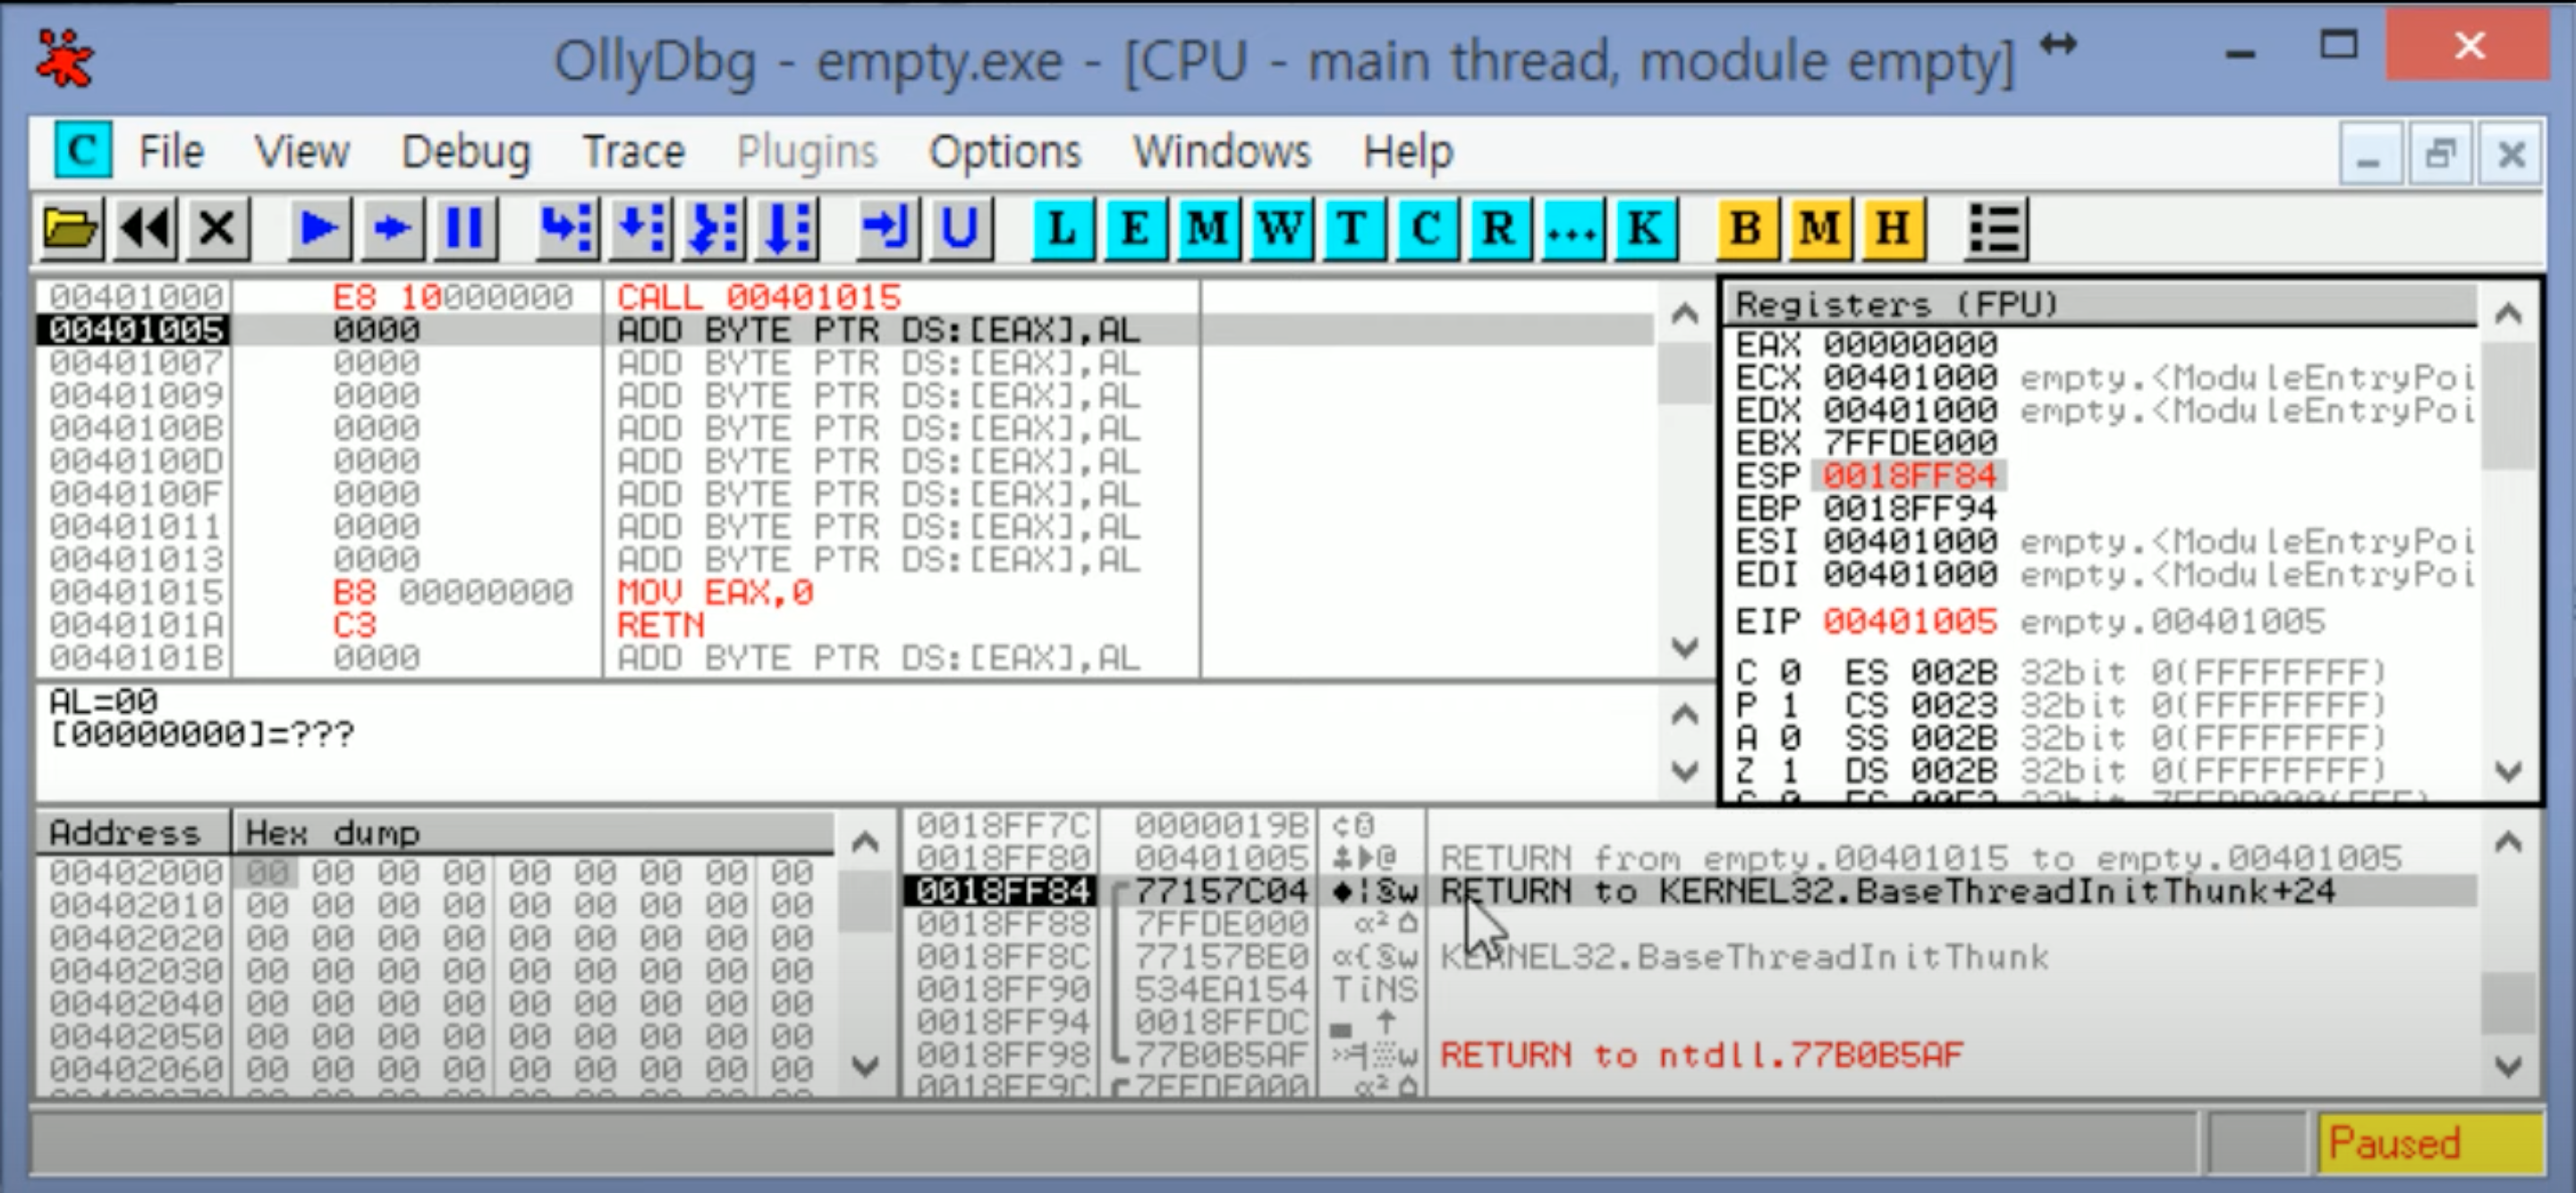
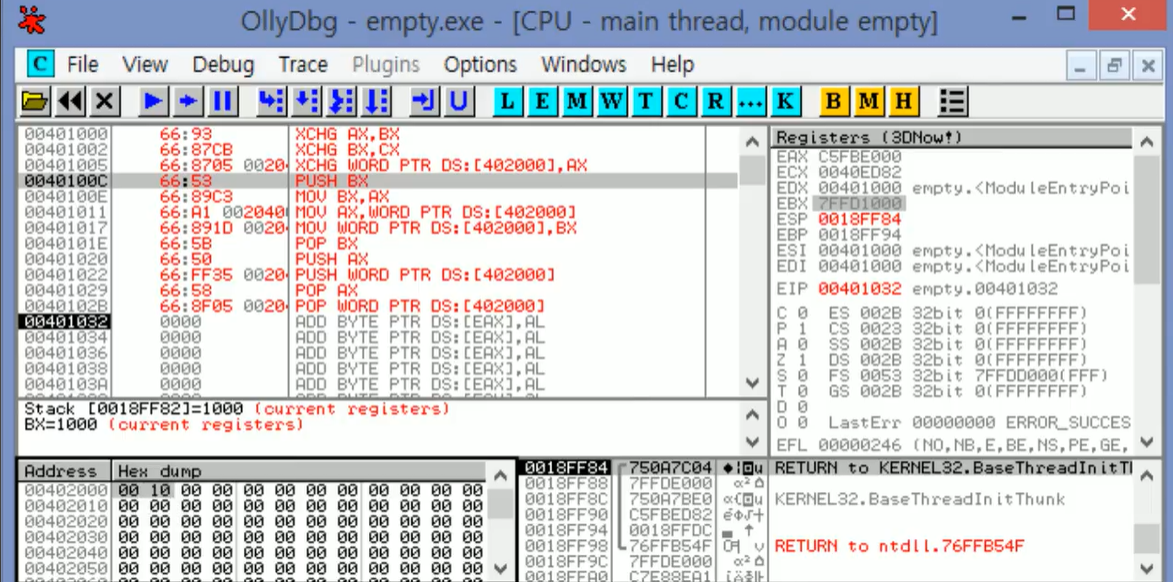
stack, queue에서 배웠던 내용을 상기시켜보면 ESP에 있는 주소가 stack, queue에 보면 0018FF84로 들어가 있다. 이 검은 색으로 하이라이트 되어 있는 부분이 맨 위에 있는 데이터임을 나타낸다. 다시 실행해보면 call은 eip 값을 push하고 주어진 주소, 여기서는 00401015로 jump를 한다. push라는 것은 스택의 맨 위에 데이터가 존재하는데, 그 위에 데이터를 추가하는 것이고, esp 레지스터는 스택 맨 위의 공간을 가르키는 레지스터이다. 스택의 포인터. push를 진행하면 0018FF80에 데이터가 들어가고 esp 값도 0018FF80으로 변경된다. 계속 데이터를 넣을 수록 주소가 4씩 감소가 된다. 32비트 프로그래밍을 하기 때문에 4바이트씩 감소된다. 한 바이트는 주소값 하나에 해당되기 때문.
+ F8을 누르면 call은 실행한 거 내부 기능을 생략한다. stack over 기능이므로 stack into를 해야 스택 내부로 들어갈 수 있으므로 F7를 해줘야 한다. 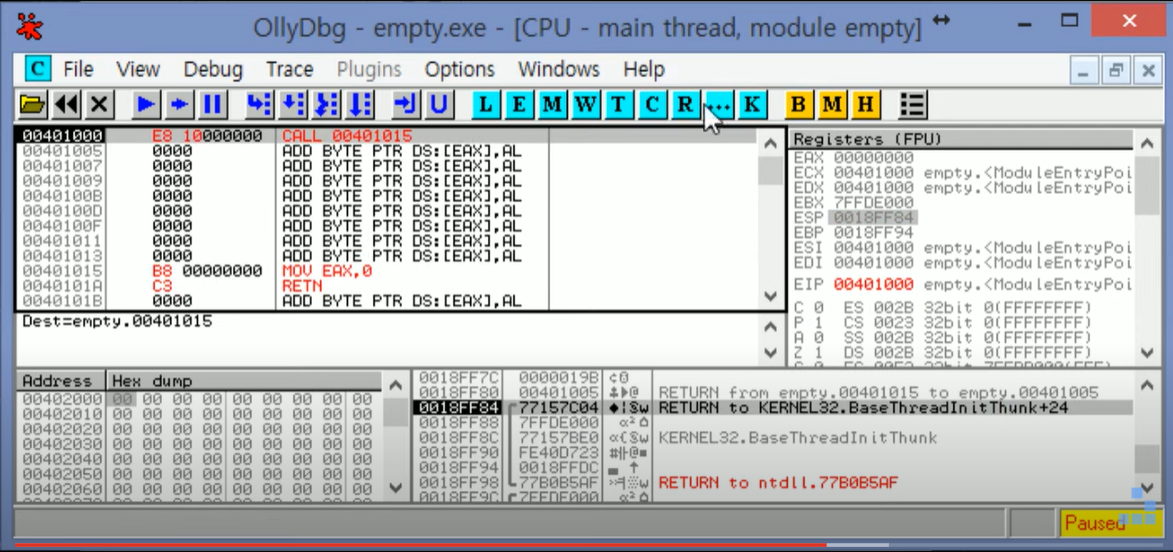
EIP 주소를 push 한다 했었는데 call을 실행하기 직전의 주소는 401000 이었고 EIP 주소도 401000이었다. 근데 왜 push값은 401005로 되냐하면 전에 jump 시 설명 했는데 어셈블리어, 기계어가 어떻게 프로그램에서 작동되냐면 첫번째로는 eip에서 기계어를 읽어오고 2번째로는 읽어온 바이트 수만큼 EIP 값을 증가하고 기계어를 실행한다. 기계어가 5 바이트이므로 5바이트를 읽어오고 읽어온 수 만큼 증가가 된 것이다. EIP가 call 명령이 실행되기 전에 이미 증가된 상태에서 call 명령어를 실행할 때 eip 값을 push 하고 jump 하는 거라서 eip 값이 증가가 되어 있는 401005 값이 push가 되는 것.
return 은
- 메모리에서 pop을 한다. pop EIP <- 실제로 이런 기계어는 없다.
맨 위의 데이터를 꺼내 온다는 것. 스택의 맨 위 데이터는 ESP가 주소를 가지고 있다. 18FF80 이 위치에 있는 데이터가 맨 위에 있는 데이터이다. 이 데이터인 00401005 이 주소를 EIP에 넣는다. jmp의 의미. ->
JMP 401000
MOV 401000 EIP, 401000 (실제로는 불가능)
EIP에 어떤 숫자를 넣는다는 건 메모리에 해당하는 주소로 흐름을 이동시킨다는 것과 같기 때문에 이동이 되는 것. 꺼내서 EIP에 넣고, 그 주소가 다음 실행될 부분임을 디버거에서 준비. POP에서 꺼내면 주소값이 증가한다. 메모리는 연속적으로 주소가 매겨져 있고 각 숫자는 한 바이트를 의미하기 때문. 32비트, 즉 4바이트 프로그램이기 때문에 4바이트씩 데이터를 넣고 꺼내 4씩 증가/감소되고 메모리의 중간부터 시작하기 때문에 18FF부터 시작한다.
33강: frame, framepointer
함수 호출과 관련. frame은 함수가 실행되는 상태에 대한 데이터를 담고 있다. 어떤 주소가 들어가는지 직접 보면서 해보았다. 호출한 뒤 돌아갈 주소 -> return address. 함수를 호출할 때 return 주소를 넣는 것.
frame은 함수 호출 후 return 주소 넣으면 함수 실행. 함수 안에 지역 변수 존재. 변수는 메모리 공간 사용하는 장치 마련해야 -> int b라고 하면 int 들어갈 만큼의 공간 존재해야. 함수가 끝나면 더 이상 지역 변수 사용 x -> 어떻게? : 함수 사용동안 지역변수 확보해두는 방식. 그 후 g를 실행하면 return 주소를 넣는다. 지역변수에 대한 정보가 frame에 해당. 스택의 일정 부분에 값을 넣어두고 그걸 변수 위치로 사용해주면 됨.
f 함수 내에서 f를 호출하는 경우 main에서 처음 f를 호출하고 return address를 넣고 f 함수에 대한 지역변수 공간을 확보하고 f가 나오면 또 return address를 넣고 f가 시작되면 또 지역변수 공간을 확보해줘야한다. -> b의 공간이 2개 생기게 된다. b의 위치는 정해져있는 위치가 아니다. main에서 g를 호출 후 f를 호출하면 또 b의 위치가 달라진다. 이 위치 어떻게 계산? frame pointer를 기준으로 계산. frame 공간 중에서 가장 낮은 주소값을 갖게 만든다. frame pointer + 0 이 변수 b의 공간이라고 하면 항상 b의 공간 이용 가능. 고정값으로 주면 지역변수 어디에 할당될지 모르고 복잡하다. b가 생기고 f에서 f함수를 또 호출할 때 return 주소 넣고 b를 호출한다. frame pointer.
함수에서 실행 끝난 후 돌아간 주소가 들어가 어디로 돌아갈 지 알 수 있는데 b 위치를 가르키는 frame pointer는 이 방식으로 되돌릴 수 없다. 컴퓨터 입장에서는 다 숫자값이기에 어디가 frame인지 모르기 때문에 이전 frame 위치를 기억하고 넣어둬야 한다. ret 때 직후 실행 값을 넣어줬던 것 처럼 지역변수 위치, 예전 함수 frame의 위치인 예전 frame pointer도 넣어준다. 지역변수의 선언이 함수 호출 위에 나와야 한다는 예전 규칙은 함수 호출 전 frame 위치를 확보해야하기 때문에 생겼던 규칙. 함수 호출이 끝나면 지역 변수 할당 공간을 pop 하고 이전 framepointer 값을 다시 framepointer에 넣어서 framepointer를 복구시킨다. 그 후 return 주소를 꺼내서 다시 함수 호출 후 실행해야하는 위치로 실행한다.
실제로 어셈블리어는 framepointer 공간은 EBP라는 공간이다. base pointer로 frame pointer로 사용한다. frame이 여기부터 stackpointer, 데이터가 들어간 맨 윗부분까지라고 봐주면 된다. 함수 호출 시 운영체제가 함수를 호출해준다.
PUSH의 작업이 현재 스택 포인터, 최근에 넣은 데이터의 주소를 넣어서 스택의 맨 위를 가르킨다. 이 주소를 좀 더 위로 설정만 하면 push 여러 번 한 효과와 똑같다. 이렇게하면 esp가 위로 올라가 push 했을 때와 똑같이 공간 확보는 가능하지만 쓰레기값이 들어가있게 된다. 따라서 지역변수 만들고 초기화 안하면 쓰레기값이 들어가는게 이러한 원리로 발생한다. 실제로 데이터는 안넣었지만 공간을 확보.
mov dword ptr[ebp-4],0이런 형태로 작업할 수 있다.
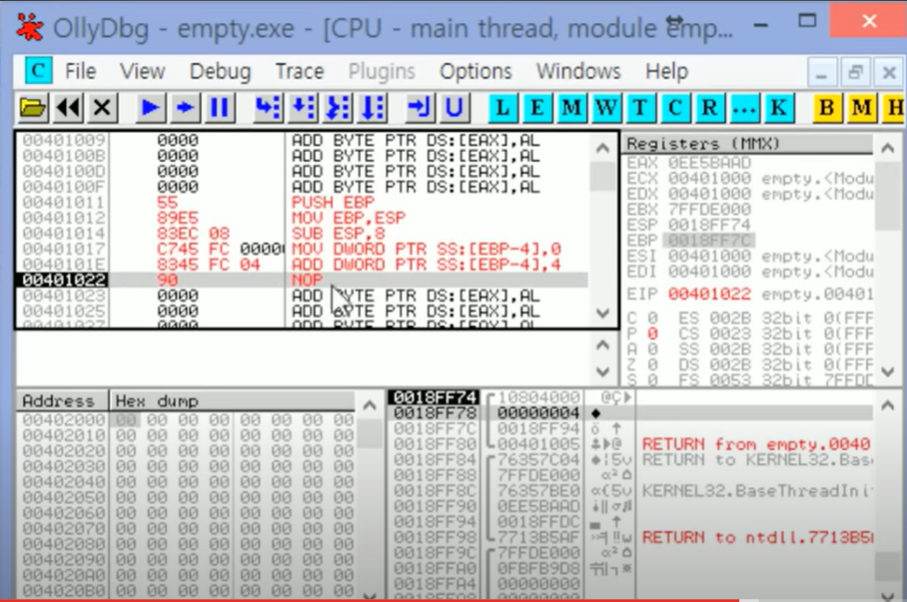
반대 작업은 다음과 같이 해주면 된다.
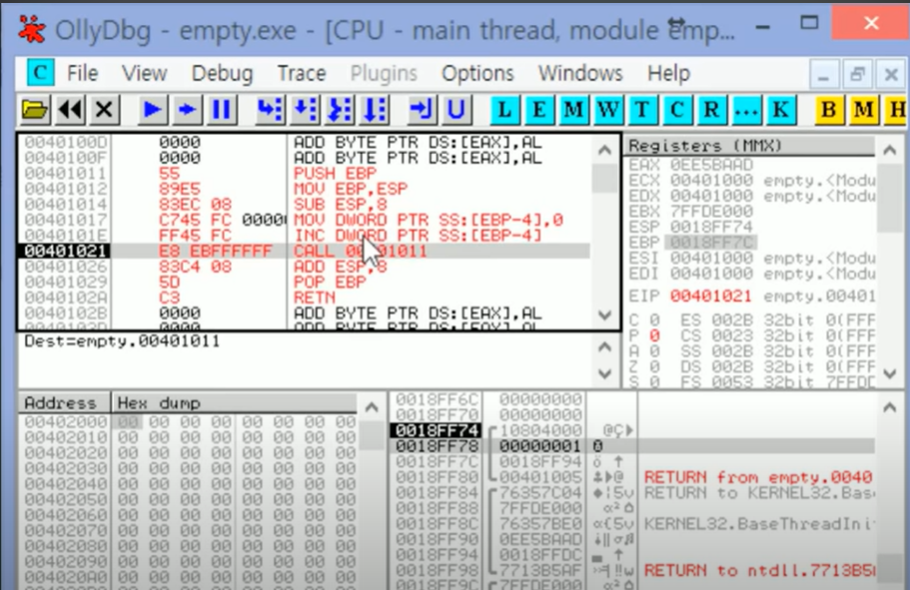
- 새로운 함수의 포인터로 함수 설정
- 지역변수 같이 함수에서 사용할 공간 확보. 시작부분 프롤로그.
함수 호출이 끝나고 리턴할 때는 역순으로 한다.
1. 지역변수 공간 해제
2. 저장한 framepointer를 꺼내서 복구
3. return 주소로 return.
pop : 꺼냄과 동시에 특정 레지스터 정보 할당. 함수의 frame은 현재 실행되고 있는 함수 정보. frame pointer는 현재 순간 실행되고 있는 frame 의 pointer, frame의 가장 낮은 주소를 가르키는 주소, 그 주소값을 담는 포인터가 EBP.
34:xchg
서로 데이터를 교환하는 명령어. 올 수 있는 경우의 수 오퍼랜드는 XCHG, EAX, 16.. 이 경우의 수로 보건데 EXA와 AX, 다른 레지스터 ..와 오퍼랜드를 받는 경우와 8비트 메모리 경우의 레지터 혹은 메모리, 두번째 오퍼랜드도 레지스터 혹은 메모리 .. 레지스터 - 레지스터, 레지스터 - 메모리 교환하는 경우가 있다.
xchg AX, BX
xchg BX, CX
제약이 있으면 최적화 되어 있고 기계어, 명령어가 차지하는 공간이 적는 경향성 존재.
16비트로 예를 들면
xchg word ptr ds:[402000], ax양쪽에 동시에 메모리가 올 수는 없다. 이 경우는 mov와 사용할 수 있는 오퍼랜드의 종류가 같다. eax 혹은 ax를 이용한 버전이 있는데 실제로 보면 byte 수가 더 적다.
사용 이유 :
- ax 402000 각각 2바이트 있다 가정, 앞에 00 2바이트 들어가 있다 가정. 두 데이터를 막 바꾼다고 하면 원래 데이터 다른 공간으로 옮겨놔야 한다. 복잡해짐.
- 실행 꼬일 걱정 x도 되는 장점.
exchange 없이 구현하면 다음과 같다.