사전 집계 구조의 트레이드 오프
이전 포스트에서 볼 수 있듯이, 쿼리 성능 개선을 위해서 통계성 데이터를 사전집계하는 구조를 도입했다. 이로 인해 발생한 트레이드 오프는 다음과 같다.
1. 동시성 문제
사전 집계 테이블을 업데이트하는 과정에서 동시성 문제가 발생했다. 다수의 요청이 동시에 같은 row를 업데이트하면서 갱신 손실이 발생할 수 있는 상황이었다. 이 문제는 Atomic Update 쿼리를 사용해 해결했다. 단일 SQL에서 값을 증가시키는 방식으로 처리하면서 갱신 손실 없이 동시 요청을 처리할 수 있었다.
2. Row Lock 경합으로 인한 지연
두 번째 문제는 라이프사이클이 다른 작업 간 Row Lock 경합이었다.
예를 들어, 조회수 증가 트랜잭션이 특정 스터디 row의 Row Lock을 획득한 상태에서 스터디장이 스터디 상세 설명을 수정하려는 요청이 들어오면 Row Lock 경합으로 인해 수정 요청이 지연될 수 있다.
이는 사용자 입장에서 즉각적인 반응이 필요한 수정 작업이 막히는 구조이기 때문에 UX적으로 좋지 않다고 판단했다.
트래픽 특성과 DB 부하 문제
현재 서비스에서 고려하고 있는 최대 부하는 약 300 RPS 수준이다. 이를 조회수 기준으로 환산하면 1분에 최대 9,000번의 조회수 업데이트 시도가 발생할 수 있다.
MySQL은 MVCC를 사용하기 때문에 읽기 성능 자체는 큰 문제가 없을 수 있다. 하지만 수정 작업이 빈번하게 발생하는 상황에서는 Row Lock 경합이 누적되면서 서비스 전체 안정성을 떨어뜨릴 수 있다. 특히 스팟은 단일 DB 구조로 운영 중이기 때문에, DB로 유입되는 트래픽 자체를 줄여줄 수 있는 구조가 필요하다고 판단했다.
쓰기 지연(Write-Behind) 패턴 도입
스팟이 선택한 해결책은 쓰기 지연 패턴(Write-Behind) 이었다. 요청이 들어올 때마다 RDB에 바로 쓰기 요청을 보내는 대신, 일정 주기 동안 발생한 증가분(delta) 을 모아서 한 번에 DB에 반영하는 구조다.
이 방식으로 전환하면 1분에 최대 9,000번 발생하던 UPDATE 요청을 1회 UPDATE로 처리할 수 있고 결과적으로 DB에 들어오는 쓰기 요청을 약 99.9% 감소시킬 수 있다.
트래픽 특성 비교
스팟에서 관리하는 통계성 데이터는 좋아요 수와 조회수다. 두 데이터는 성격이 다르기 때문에, 동일한 전략을 적용하는 것은 적절하지 않다고 판단했다.
좋아요
좋아요는 사용자 의사에 기반한 명시적인 액션이다. 중복 방지가 필수적이며 멱등성을 보장해야하는 행동이다. 조회수에 대비해서 발생 빈도가 낮은 편이며, 정합성 유실 시 사용자 경험에 직접적인 영향을 미칠 수 있다. 분명 내가 좋아요를 눌렀는데, 갯수가 업데이트 되지 않는다거나 내가 좋아하는 스터디 리스트에서 조회되지 않는 등 다양한 문제가 발생할 수 있다.
좋아요 액션은 서비스 규모를 고려할 때, RDB에서 직접 처리를 하되, 추후 트래픽이 부담될 정도로 커진 경우에 다른 구조를 도입하는 쪽으로 선택했다. 쓰기 지연 패턴을 당장 도입해서 얻는 이점보다 구현 복잡도, 운영 난이도, 정합성 보장을 위한 보정 작업 등 트레이드 오프가 더 크다고 판단했다.
조회수
조회수 업데이트 시도는 페이지 조회 시마다 발생하는 이벤트다. 좋아요에 비해서 정합성이 매우 중요한 데이터는 아니다. 약간의 유실도 허용할 수 있는 데이터다. 좋아요 처럼 실제로 존재하는 컬럼의 갯수를 나타내는 데이터가 아닌 이 글을 몇 번 조회 했는지를 간접적으로 나타내는 데이터다. 또한 조회할 때 마다 업데이트 시도가 발생하기 때문에 좋아요에 비해 발생 빈도도 높다.
따라서 조회수는 쓰기 지연 패턴을 통해서 비동기 집계 구조를 도입하는 것이 더 적합하다고 판단했다.
중복 증가
당시 스팟은 한 회원이 동일한 스터디를 반복해서 조회하면 제한 없이 조회수가 증가하는 구조였다. 이를 필터링 하는 로직이 부재한 상황이라, 이 역시 방지할 수 있는 로직이 필요했다.
Write-Behind 패턴
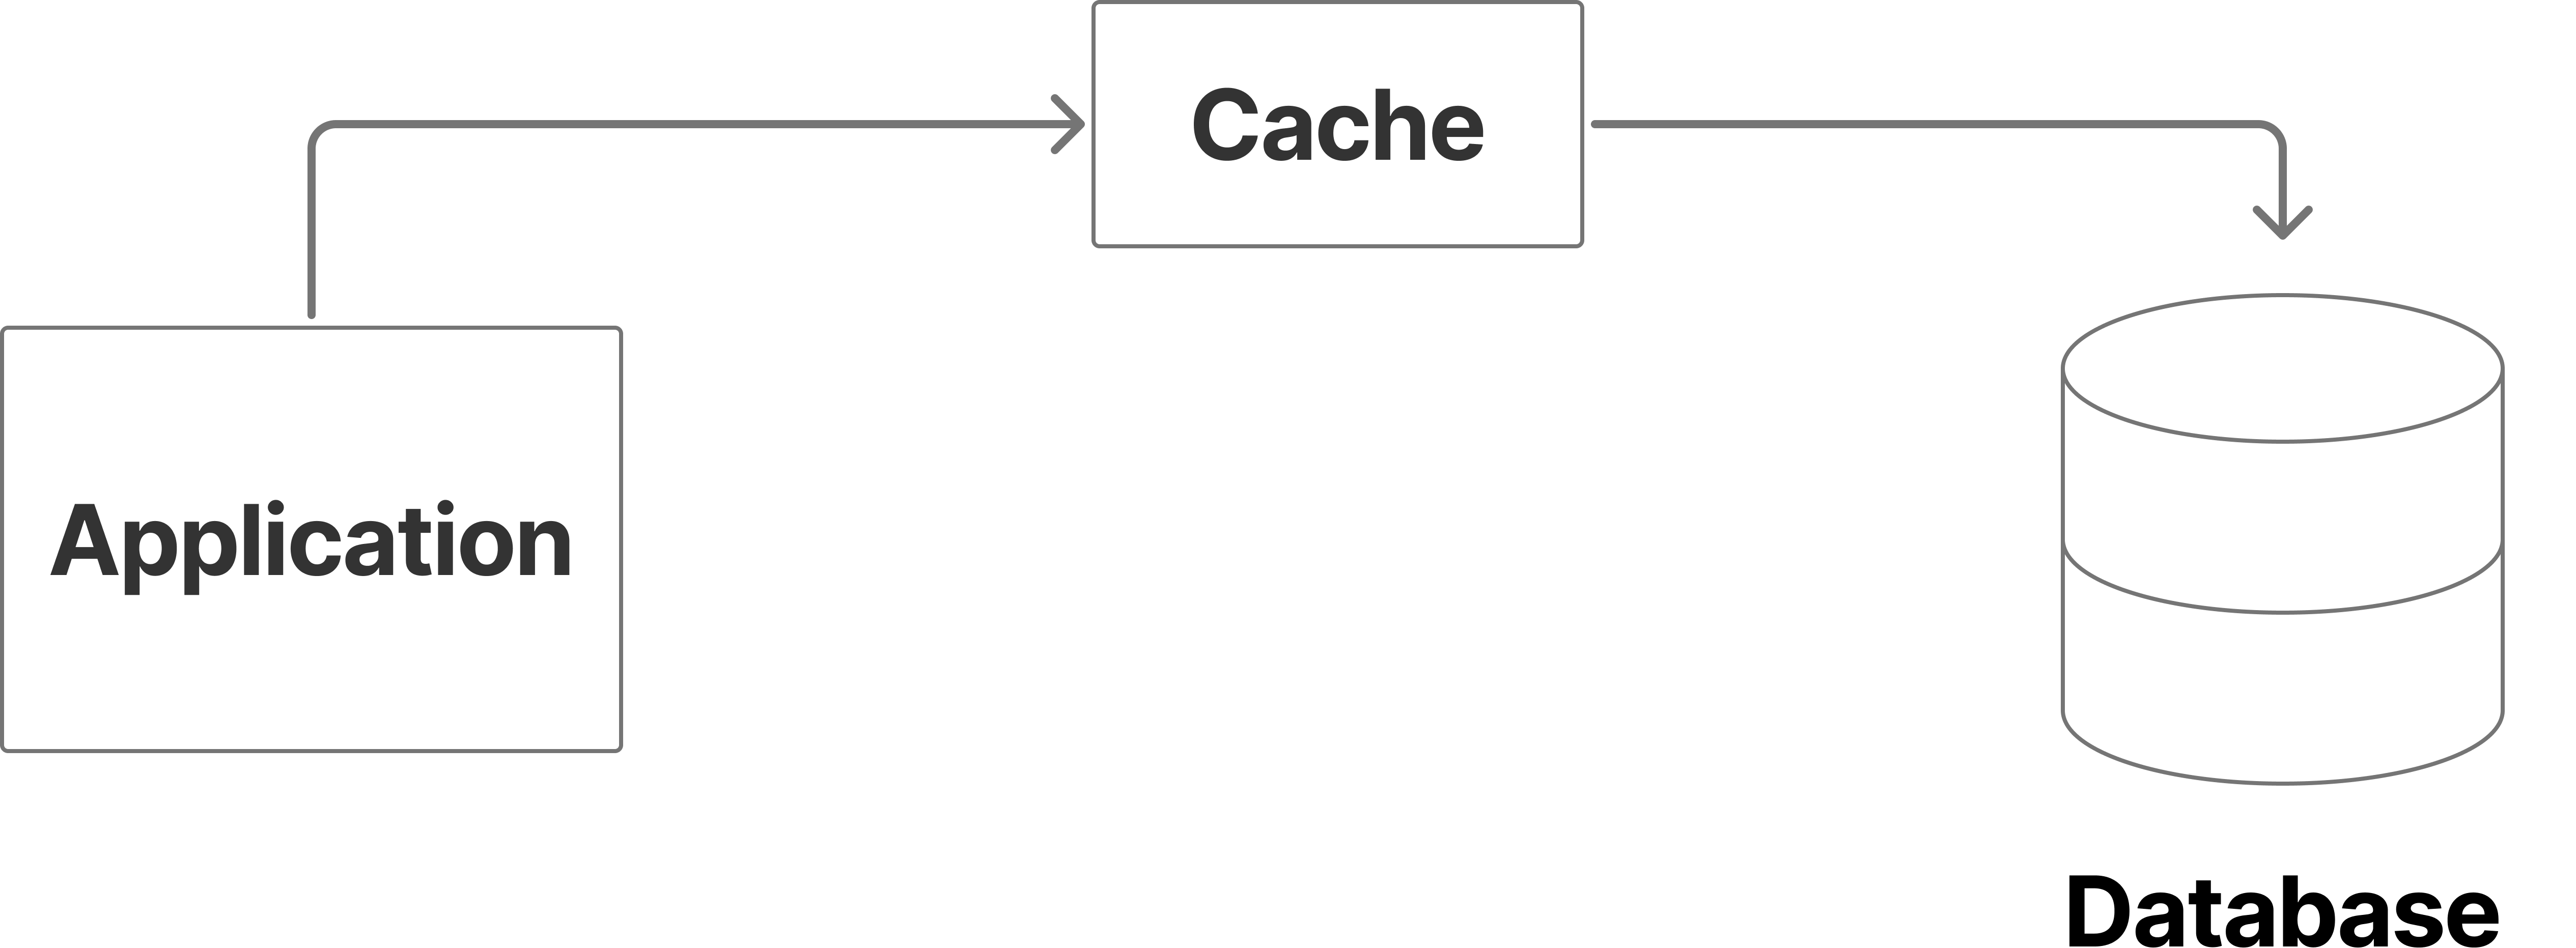
스팟은 조회수에 대해서 Write-Behind 패턴을 도입했다.
Write-Behind 패턴은 애플리케이션이 DB가 아닌 Cache에 읽기/쓰기를 수행하고, Cache가 변경된 데이터를 비동기로 DB에 반영하는 전략이다.
DB에 대한 직접적인 접근을 제거할 수 있어 DB 부하를 크게 줄일 수 있다. 반면, 장애 상황에서는 데이터 유실 가능성을 고려해야 한다. 조회수는 약간의 유실을 허용할 수 있는 데이터라고 판단했기 때문에 이 패턴이 적합하다고 판단했다.
캐시 저장소 검토
해당 패턴 도입에 활용할 캐시 저장소로는 크게 두 가지를 고려했다.
- 인 메모리 저장소
- Redis
인 메모리 저장소는 성능 면에서는 가장 빠르지만,
현재 스팟은 2대 이상의 인스턴스로 운영되고 있기 때문에 분산 환경을 고려해야 했다.
Redis는
- 분산 환경 지원
- 중복 방지 로직 구현 용이
- 집계 및 TTL 관리에 적합
또한 AOF/RDB를 통한 영속성 옵션도 선택할 수 있기 때문에 Redis를 선택했다.
구현
중복 조회 방지
동일 사용자의 단시간 반복 조회로 인한 불필요한 조회수 증가를 방지하기 위해 Redis를 활용했다.
- Redis SETNX + TTL 사용
- Key: view:guard:{studyId}:{viewerId}
- TTL: 10분
TTL 내에 동일 사용자가 같은 스터디를 재조회할 경우 조회수 증가를 차단한다.
조회수 집계
조회 시점에 DB를 직접 갱신하지 않고, 증가분만 Redis에 적재한 뒤 주기적으로 DB에 반영하도록 설계했다.
- 조회 발생 시 Redis에 증가분(delta) 기록
- 배치 작업을 통해 Redis → DB로 누적 반영
- 실시간 조회수는 DB 값 + Redis delta로 계산
배치 작업 시 Redis 키를 조회할 때는 KEYS 대신 SCAN을 사용해 Redis 블로킹을 최소화했다.
일정 주기 마다 Redis에 존재하는 Delta 값을 읽어서 유효성 검증 후 DB에 반영하는 구조로 설계했다. 만약 DB 반영에 실패한 경우에는 해당 값을 Redis에 유지해서 다음 배치에 반영될 수 있도록 설계했다.
성과
이 구조를 적용한 결과, 조회수 갱신으로 인해 발생하던 UPDATE 쿼리는 분당 최대 9,000회에서 1회 수준으로 줄어들었다. 또한, 성능 테스트 시 급격하게 치솟던 DB CPU 사용률은 85%에서 35% 수준으로 감소했다. 그로 인해 간헐적으로 발생하던 타임아웃 역시 더 이상 발생하지 않게 되었다.