무료 클라우드 인스턴스에 자리가 없을 때, 일정 간격으로 생성을 다시 요청하는 도구를 만들기 시작했다. 처음에는 반복문 하나로 끝날 줄 알았다.
while True:
    try_create_instance()
    time.sleep(600)
문제는 요청을 보낸 뒤 응답을 받기 전에 연결이 끊겼을 때였다. 인스턴스 생성에 실패했을 수도 있지만, 서버에서는 이미 생성 중이고 응답만 사라졌을 수도 있다. 그 상태에서 새 요청을 보내도 괜찮을까?
지난 글에서 API의 멱등성을 설계 기준으로 정리했다면, 이번에는 OCI Always Free Ampere A1 생성 재시도기에 그 기준을 적용했다. Python으로 도구를 만들고 기존 Micro 인스턴스에서 systemd 서비스로 실행하면서, 요청 기록과 오류 분류, 재시작 후 복구를 구현했다.
확인 범위 · 2026년 9월 12일 오전 작업 기록 기준
로컬 테스트 32개, 실제 서버의 자동 재호출, 재부팅 후 저장된 예약 복원까지 확인했다. 목표 A1 인스턴스 생성은 아직 성공하지 않았으며, 성공 후 부팅·SSH 확인과 알림까지 완료한 후기는 아니다.
이 글의 흐름은 세 가지 질문으로 요약할 수 있다.
| 질문 | 구현에서 남기는 근거 |
|---|---|
| 이전 요청이 실행됐는가? | 요청 전에 저장한 journal과 기존 인스턴스 조회 |
| 같은 요청을 이어 가는가? | opc_retry_token과 원래 생성 설정 |
| 언제 다시 실행하는가? | 디스크에 저장한 next_attempt_at |
상태 전이와 재시작 복구를 먼저 읽고 싶다면 1·2·5절을, 운영 중 확인한 한계를 보고 싶다면 마지막 검증 표를 보면 된다.
1. 실패와 결과 불명을 구분하기
자동화에서 가장 먼저 정한 규칙은 “오류가 났다”를 하나의 상태로 다루지 않는 것이었다.
- 용량 부족: 이번 요청이 capacity 오류로 거절됐다면 다음 후보나 다음 주기를 검토한다.
- 결과 불명: 타임아웃이나 특정 서버 오류 뒤에는 요청이 처리됐는지 알 수 없으므로 기존 요청 기록을 유지한다.
- 영구 오류: 인증·설정·한도 문제라면 자동 재시도를 멈추고 원인을 확인한다.
여기서 멱등성이란 같은 논리적 작업을 다시 요청하더라도 중복된 결과를 만들지 않도록 하는 성질이다. 같은 응답을 매번 받는다는 의미와는 구분한다. 재시도 요청을 식별할 키와, 그 키를 다음 실행까지 기억하는 저장소가 함께 필요했다.
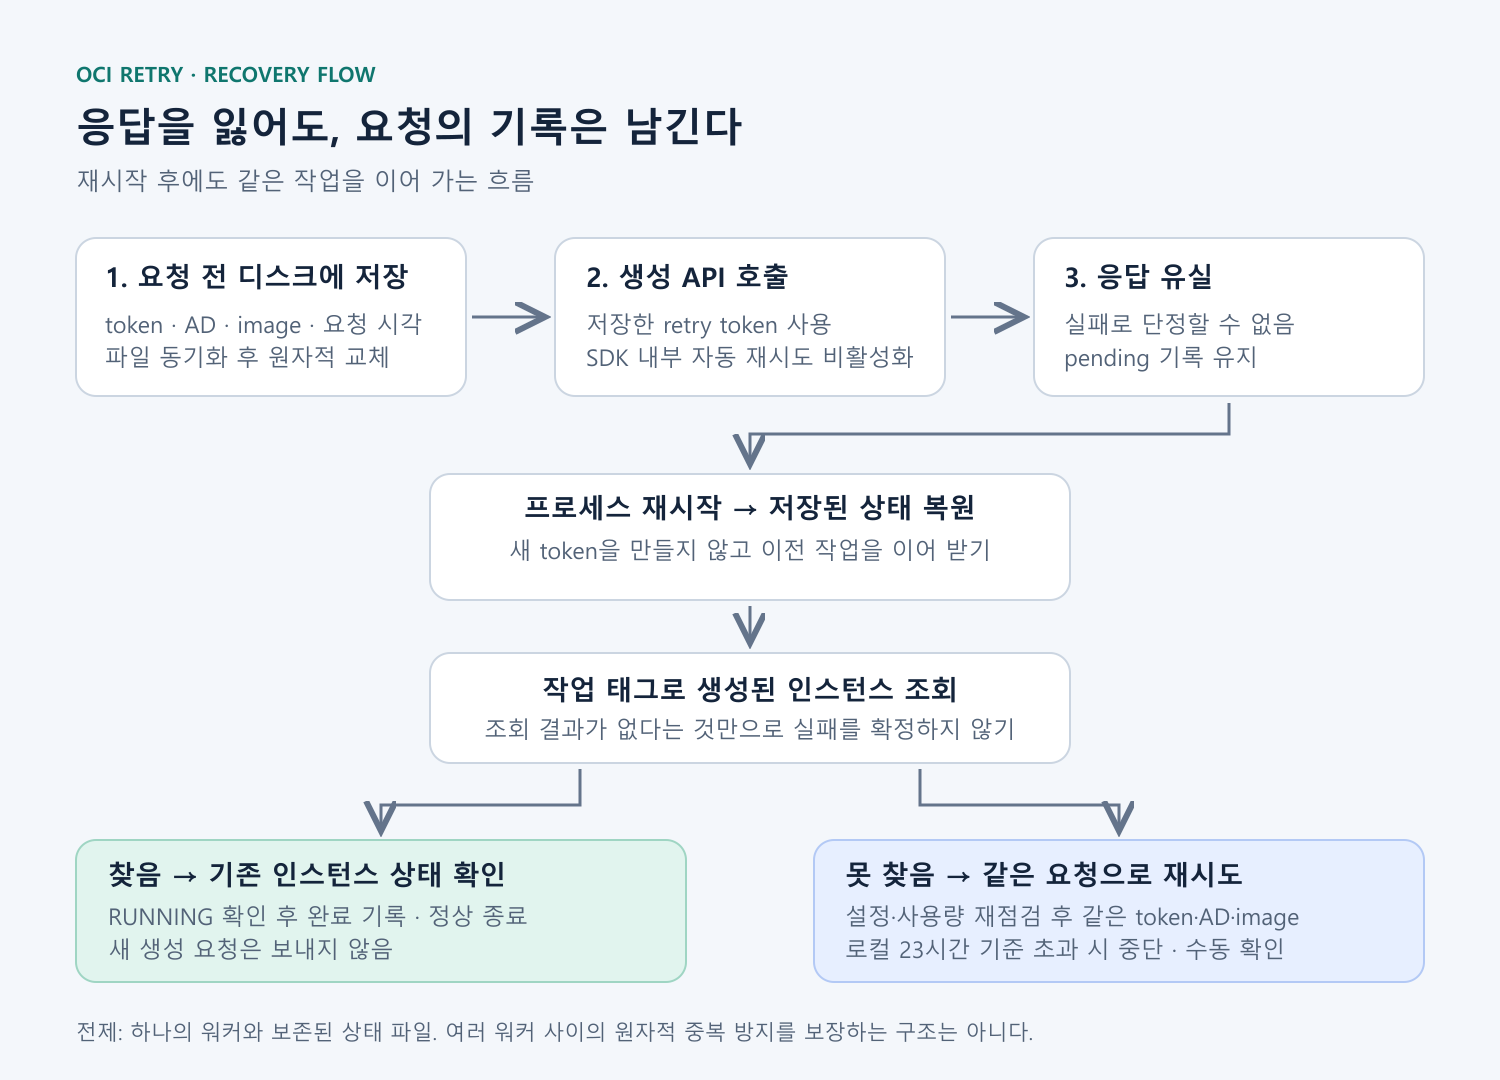
결과를 찾지 못했다고 새 작업을 시작하지 않는다. 기존 작업을 조회하고, 필요하면 같은 요청을 이어 간다.
그림은 하나의 워커와 보존된 상태 파일을 전제로 한 복구 흐름이다. 여러 서버가 서로 다른 작업 기록으로 동시에 생성하는 상황까지 원자적으로 막는 구조는 아니다.
2. API를 호출하기 전에 요청을 디스크에 남긴다
요청 후 상태를 저장하면 다음 구간이 비게 된다.
생성 API 처리 완료 → 프로세스 종료 → 상태 저장 실패재시작한 프로그램은 이전 요청을 기억하지 못한다. 그래서 요청 순서를 바꿨다. 아래는 실제 생성 루프의 핵심을 발췌한 코드다.
pending = self.state.data.get("pending")
if pending is None:
    pending = {
        "ad": ad.name,
        "image_id": image.id,
        "token": str(uuid.uuid4()),
        "created_at": time.time(),
    }
    self.state.data["pending"] = pending

if time.time() - pending["created_at"] >= 23 * 3600:
    raise FatalOCIError("미확정 요청의 결과를 수동으로 확인해야 합니다")

self.state.data["next_attempt_at"] = (
    time.time() + self.policy.initial_seconds
)
self.state.save()  # 네트워크 요청보다 먼저 저장

response = self.compute.launch_instance(
    self._launch_details(pending["ad"], pending["image_id"]),
    opc_retry_token=pending["token"],
    retry_strategy=self.oci.retry.NoneRetryStrategy(),
)
AD는 Availability Domain, 즉 OCI 리전 안의 가용성 영역이다. 결과가 불명확할 때는 token뿐 아니라 원래 AD와 이미지도 재사용한다. 재시작 사이에 새 Ubuntu 이미지가 공개돼도 요청 내용이 바뀌지 않게 하기 위해서다. CPU·메모리·네트워크 등 주요 생성 설정은 해시로 기록해, 설정이 달라지면 그대로 재개하지 않도록 했다.
상태 파일은 단순히 메모리에 들고 있지 않는다. 임시 파일에 JSON을 쓰고 flush와 fsync를 수행한 뒤 원래 경로로 교체한다. Linux에서는 교체 후 부모 디렉터리도 fsync한다. 이 기록을 글에서는 journal, 즉 복구를 위한 작업 기록이라고 부르겠다.
OCI의 opc_retry_token은 타임아웃이나 서버 오류 뒤 동일 요청을 식별하는 데 사용한다. 토큰은 24시간 후 만료되며, 충돌하는 작업으로 그 전에 무효화될 수도 있다. Oracle Python SDK 문서
이 도구는 재요청 전에 로컬 생성 시각과 비교해 23시간 이상 지난 미확정 요청이면 멈춘다. 이는 자체적으로 둔 보수적인 중단 기준이며, 23시간 동안 토큰이 반드시 유효하다는 보장은 아니다. 새 token을 발급하기 전에 실제 생성 결과부터 확인해야 한다.
3. 모든 오류를 같은 방식으로 재시도하지 않는다
용량이 없는 상황과 권한이 없는 상황은 대응이 다르다. 구현에서는 다음처럼 분류했다.
| 분류 | 판단 예시 | 현재 처리 |
|---|---|---|
| capacity | Out of host capacity | 결과가 미확정인 이전 요청이 없다면 다음 AD 후보를 검토 |
| throttled | HTTP 429, 요청 제한 | 이번 AD 순회를 멈추고 다음 주기에 재시도 |
| transient | 특정 500·502·503·504와 InternalError·ServiceUnavailable 조합 | pending 요청을 보존하고 같은 token으로 재시도 |
| fatal | 인증·설정·한도 오류 등 위 조건에 해당하지 않는 응답 | 자동 재시도 중단 |
전송 오류도 생성 결과를 알 수 없는 상황으로 취급한다. 모든 5xx를 무조건 재시도하는 구현은 아니다.
한 가지 더 주의했다. 앞서 응답을 잃은 요청이 있다면, 나중에 capacity나 429를 받았다고 이전 요청이 처리되지 않았다고 단정하지 않는다. 이 경우에도 기존 token을 유지하고 다른 AD로 넘어가지 않는다.
현재 429 처리에는 자체 백오프만 적용한다. Retry-After 헤더를 해석해 서버가 제안한 대기 시간을 반영하는 기능은 아직 없다.
4. 오래 실행돼도 계산이 넘치지 않는 백오프
실패할 때마다 같은 간격으로 호출하는 대신, 대기 시간을 늘리고 작은 무작위 편차인 jitter를 섞었다. 기본 설정은 최소 600초, 최대 3,600초, 증가 배율 1.5, jitter 비율 20%다.
단순히 아래처럼 작성하면 상한이 있어 보여도 문제가 남는다.
base = min(initial * multiplier ** failures, maximum)min이 적용되기 전에 거듭제곱부터 계산되기 때문이다. 실패 횟수가 아주 커지면 그 단계에서 overflow가 발생할 수 있다. 실제 구현은 상한에 도달했는지 먼저 계산한다.
exponent = max(0, failed_cycles - 1)

if policy.multiplier == 1:
    base = policy.initial_seconds
elif exponent >= (
    math.log(policy.max_seconds / policy.initial_seconds)
    / math.log(policy.multiplier)
):
    base = policy.max_seconds
else:
    base = min(
        policy.max_seconds,
        policy.initial_seconds * policy.multiplier ** exponent,
    )

jitter = base * policy.jitter_ratio
delay = min(
    policy.max_seconds,
    max(600, round(rng.uniform(base - jitter, base + jitter))),
)
첫 실패는 지수 0에서 시작한다. 마지막에 다시 범위를 제한하므로 기본 설정에서는 jitter를 적용해도 10~60분 안에 들어온다. 위 코드는 검증된 RetryPolicy를 입력받는 함수의 본문이다.
재시작을 위해서는 대기 시간뿐 아니라 다음 시도 예정 시각도 저장했다. 프로그램을 껐다 켰다는 이유로 곧바로 API를 다시 호출하지 않게 한다.
여기에는 남아 있는 한계가 있다. 예약 시각과 token 경과 시간 계산은 time.time()에 의존하므로 시스템 시계 변경을 별도로 감지하거나 보정하지 않는다. 인스턴스의 RUNNING 상태를 기다리는 제한 시간에는 time.monotonic()을 쓰지만, 그것이 전체 예약 로직의 시계 변경 문제까지 해결해 주지는 않는다.
5. 재시작 복구와 중복 방지의 범위
프로그램을 시작하면 새 요청을 만들기 전에 다음 순서로 복구한다.
- 완료 기록이 있으면 새 인스턴스를 만들지 않고 종료한다.
- 저장된 instance ID가 있으면 그 인스턴스의 상태를 확인한다.
- ID를 저장하지 못했지만 pending 기록이 있다면 작업 태그로 생성된 인스턴스를 찾는다.
- 대상을 찾지 못하면 저장된 예약 시각까지 기다린 뒤 설정·사용량을 다시 점검하고 기존 요청을 이어 간다.
같은 상태 파일의 동시 사용은 OS 파일 잠금으로 차단했다. 파일 잠금은 프로그램이 비정상 종료돼도 OS가 해제한다.
다만 다른 상태 파일이나 다른 서버의 워커는 이 잠금을 공유하지 않는다. 클라우드의 태그·이름 조회도 “조회 후 생성” 방식이므로 여러 워커 사이의 경쟁 조건까지 제거하지는 못한다. 현재 운영 전제는 워커 하나, 상태 파일 하나다.
생성된 인스턴스가 RUNNING이 되면 instance ID와 completed_at을 저장하고 정상 종료한다. 완료된 작업을 systemd가 다시 실행하더라도 새 생성 요청을 보내지 않는 경로는 테스트로 검증했다. 실제 생성 성공 이후의 서비스 종료는 아직 확인하지 못했다.
6. 사용자 개인 키 대신 Instance Principal 사용
기존 Micro 서버에 개발 PC의 사용자 API 개인 키를 복사하지 않도록, 서버 자체의 신원을 사용하는 Instance Principal을 선택했다.
signer = oci.auth.signers.InstancePrincipalsSecurityTokenSigner()
compute = oci.core.ComputeClient({}, signer=signer)
위는 인증 방식만 보여 주는 최소 예시다. 실제 도구는 signer에서 얻은 region과 tenancy 정보도 사용한다. 동적 그룹과 IAM 정책을 통해 워커에 필요한 조회·생성 권한을 부여한다. Oracle SDK 인증 방식
Instance Principal을 사용한다고 서버의 권한이 사라지는 것은 아니다. 서버에 접근한 주체가 그 권한을 사용할 수 있으므로, 워커 접근 통제와 IAM 범위를 함께 관리해야 한다.
무료 범위에 맞추기 위한 사전 검사도 넣었다. 홈 리전의 전체 활성 compartment와 AD를 순회해 A1 사용량, 부트 볼륨과 블록 볼륨 사용량을 합산한다. 필요한 조회가 실패하면 사용량을 0으로 간주하지 않고 해당 생성 시도를 진행하지 않는다.
이 검사는 과금 차단 장치를 대체하지 않는다. 검사와 생성 사이에 다른 작업이 자원을 만들 수 있고, 검사하는 항목 밖의 비용까지 보장하지도 않는다. 적용 시점의 무료 대상 조건과 실제 계정 사용량을 확인해야 한다. Oracle도 리소스 사용량 통제를 위한 compartment quota를 안내한다. Always Free 리소스 문서
실제 배포에서 테스트를 보강한 두 가지 오류
설계를 구현한 뒤 실제 서버에서 사전 점검을 돌리자, mock 위주 테스트에서 놓친 SDK 연동 문제가 나왔다.
첫 번째는 볼륨 목록 조회의 인자 전달 방식이었다. list_boot_volumes와 list_volumes 호출에서 SDK가 요구하는 keyword 인자 형태를 맞춰야 했다. 이후 테스트에 실제 BlockstorageClient의 시그니처를 따르는 autospec을 사용해, 존재하지 않는 호출 형태를 mock이 그대로 받아 주지 않게 했다.
두 번째는 Ubuntu 이미지 필터였다. operating_system_version만 넘긴 요청에서 operatingSystem 누락 오류가 발생했다. OCI에서 사용하는 OS 이름인 Canonical Ubuntu를 버전과 함께 넘기도록 수정했다.
images = compute.list_images(
    compartment_id,
    operating_system="Canonical Ubuntu",
    operating_system_version="24.04",
    shape="VM.Standard.A1.Flex",
)
위 코드는 필터 조합을 보여 주는 발췌다. 실제 도구에서는 페이지네이션을 포함해 결과를 조회한다. 테스트에도 OS 이름과 버전 필터 조합을 확인하는 사례를 추가했다.
이 두 오류 덕분에 테스트의 역할이 더 분명해졌다. 내부 상태 전이가 맞는지 검증하는 테스트와, 실제 SDK·서비스의 계약에 맞게 호출하는지 확인하는 작업이 모두 필요했다.
어디까지 검증했나
2026년 9월 12일에 프로젝트 가상환경에서 다음 명령으로 테스트를 다시 실행했다.
python -B -m unittest test_oci_free_retrier test_server_reliability -q

Ran 32 tests
OK
이 테스트들은 실제 OCI 인스턴스를 생성하지 않는다. mock과 임시 상태 파일을 사용해 token 재사용, 원래 이미지 복원, 오류별 분기, 잠금, 사용량 검사와 완료 기록을 검증한다.
| 검증 항목 | 확인한 결과 | 범위 |
|---|---|---|
| 로컬 테스트 | 32개 통과 | 상태 전이·SDK 호출 형태·일부 실패 시나리오 |
| 실제 사전 점검 | Instance Principal 인증과 리소스 조회 통과 | 인스턴스 생성 성공을 의미하지 않음 |
| 자동 재호출 | 9월 11일 첫 용량 부족 뒤 예약된 재신청 확인 | 실제 서버에서 수행 |
| 재부팅 후 복구 | 9월 12일 오전 부팅 후 예약 복원과 자동 재신청 확인 | 해당 복구 사례 1회이며 모든 장애를 검증한 것은 아님 |
| 목표 A1 생성 | 아직 미확인 | 생성·부팅·SSH·성공 알림까지의 전체 검증은 남아 있음 |
운영 중에는 워커의 SSH 응답 문제도 있었다. 이후 복구 작업 기록에서 재부팅 뒤 서비스가 자동 시작하고 기존 작업 기록을 유지한 채 다시 신청한 것을 확인했다. 그 재신청 역시 용량 부족으로 끝났으며, 이를 생성 성공이나 장기 안정 운영의 증거로 해석하지는 않았다.
마치며
이번 구현에서 가장 오래 고민한 부분은 API를 몇 분마다 호출할지가 아니었다. 응답을 받지 못한 요청을 다음 실행이 어떻게 기억할지였다.
요청 전에 작업을 기록하고, 결과가 불명확하면 같은 token과 요청 내용을 유지하고, 다시 시작할 때는 기존 결과부터 찾는다. 이 원칙을 코드와 테스트로 옮기면서 재시도기의 동작 범위를 구체적으로 설명할 수 있게 됐다.
앞으로는 실제 A1 생성 이후 부팅·SSH 확인과 성공·중단 알림을 검증할 예정이다. Retry-After 반영과 시스템 시계 변경 대응도 보완 항목으로 남겨 두었다.
