🧩 임베딩 초기화: 새로운 토큰 추가 시 주의사항
-
LLM을 커스터마이징하거나 도메인 특화 모델을 구축할 때, Tokenizer를 확장하여 새로운 토큰을 추가하는 경우가 자주 발생합니다.
-
하지만 이때, 새로운 토큰의 임베딩을 무작위로 초기화(random init) 하면 심각한 문제가 발생할 수 있습니다.
⚠️ 무작위 초기화의 문제점
-
임베딩은 로짓(logit) 계산에 직접 영향을 주는 요소입니다. 따라서 새로운 토큰의 임베딩이 임의로 너무 큰 값을 갖게 되면, 모델은 학습 초기에 해당 단어만 반복적으로 출력하는 비정상적 현상이 발생할 수 있습니다.
-
또한, 무작위 초기화는 사전 학습된 임베딩 분포와 불일치하게 되어, 기존 언어 패턴에 기반한 문맥 예측 능력을 저하시킬 수 있습니다.
✅ 해결책: 평균 임베딩 초기화
- 이러한 문제를 방지하기 위해, 새로운 토큰의 임베딩을 기존 임베딩의 평균값으로 초기화하는 방법이 효과적입니다.
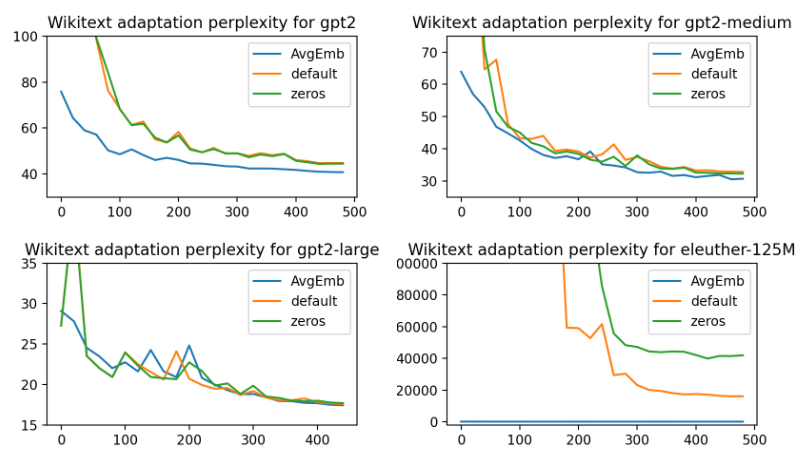
- 그래프에서는 무작위 초기화, 0으로 초기화, 임베딩 분포 평균값 초기화 중에서 현재 임베딩 벡터 분포의 평균값으로 초기화 할 때 Perplexity 점수가 낮아, 안정적인 학습을 수행할 수 있음을 볼 수 있다.
- Llama2 임베딩 초기화
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, TextStreamer

BASE_MODEL = "meta-llama/Llama-2-7b-hf"
model = AutoModelForCausalLM.from_pretrained(BASE_MODEL, device_map='auto',token='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',cache_dir='/data')
tokenizer = AutoTokenizer.from_pretrained('./llama-ko-tokenizer')
streamer = TextStreamer(tokenizer)

# 모델의 임베딩 레이어 크기를 조정
model.resize_token_embeddings(len(tokenizer))

params = model.state_dict() # embed_tokens.weight, layers, lm_head.weight로 구성

# LLM은 크게 embed_tokens, layers, lm_head로 구성되어 있는데, 여기서 입력 임베딩 값인 embed_tokens를 가져온다.
embeddings = params['model.embed_tokens.weight']

# 그 후, 현재 Llama2 모델의 기존 단어에 대한 Vocab_size는 32000으로, 기존 단어를 가져온 후, 각 단어에 대한 임베딩 평균값과 분산을 통해 정규분포로 초기화
pre_expansion_embeddings = embeddings[:32000,:]
mu = torch.mean(pre_expansion_embeddings, dim=0)
n = pre_expansion_embeddings.size()[0]
sigma = ((pre_expansion_embeddings - mu).T @ (pre_expansion_embeddings - mu)) / n
dist = torch.distributions.multivariate_normal.MultivariateNormal(
        mu, covariance_matrix=1e-5*sigma)

# 그 후, 새롭게 추가한 단어의 임베딩을 우선 0으로 초기화를 진행
new_embeddings = torch.stack(tuple((dist.sample() for _ in range(n))), dim=0) # 여기서 n은 토크나이저를 확장할 때, 추가한 토큰의 갯수입니다.
embeddings[32000:,:] = new_embeddings

# 앞에서 구한 기존 단어의 임베딩 평균값을 새로운 단어의 임베딩값으로 초기화
params['model.embed_tokens.weight'][32000:,:] = new_embeddings
model.load_state_dict(params)- 위와 같이 **기존 단어의 임베딩 평균을 새로운 단어의 임베딩에 초기화를 하면 성공적으로 임베딩 초기화를 수행할 수 있다.
- 이제 여기에 사전학습을 수행하면 성공적으로 영어 LLM에서 한국어를 학습하여, 한국어 LLM을 만들 수 있습니다.
참고자료
- Initializing New Word Embeddings for Pretrained Language Models(https://nlp.stanford.edu/~johnhew/vocab-expansion.html)

NLP Developer