contetns
- 왜 스파크일까?
- 파이썬과 데이터
- 파일 유형
- 클라우드
summary
-
스파크란?
Apache Spark는 SQL, 스트리밍, 머신러닝 및 그래프 처리를 위한 기본 제공 모듈이 있는 대규모 데이터 처리용 통합 분석 엔진.
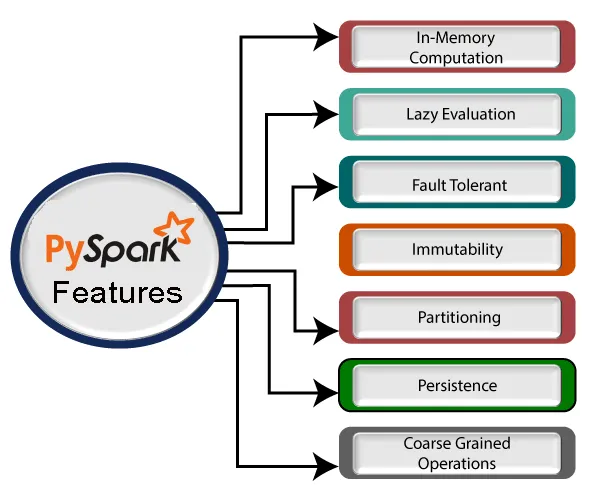
- Pyspark: Python을 기반으로 하여 별도의 언어 공부가 필요 없음
- 대용량 데이터: 대용량 데이터를 다루는 기술에 대한 이해
- 분산 처리: 여러 대의 컴퓨터를 사용한다는 것에 대한 이해
-
스파크를 쓸 수 밖에 없는 이유
- 800G이상의 대용량 데이터의 경우 선택해야함.
- 하루에도 수십억 건의 데이터가 발생하는 상황 → 하나의 머신으로는 감당 불가
-
파이썬과 데이터
- 파이썬과 데이터, 메모리
이는 일반적으로 컴퓨터 공학에서는 OOM(Out of Memory)이라 하며, 특히 대용량 데이터를 처리할 때는 자주 만나게 될 문제(메모리 문제)
- 파이썬과 데이터, 메모리
메모리
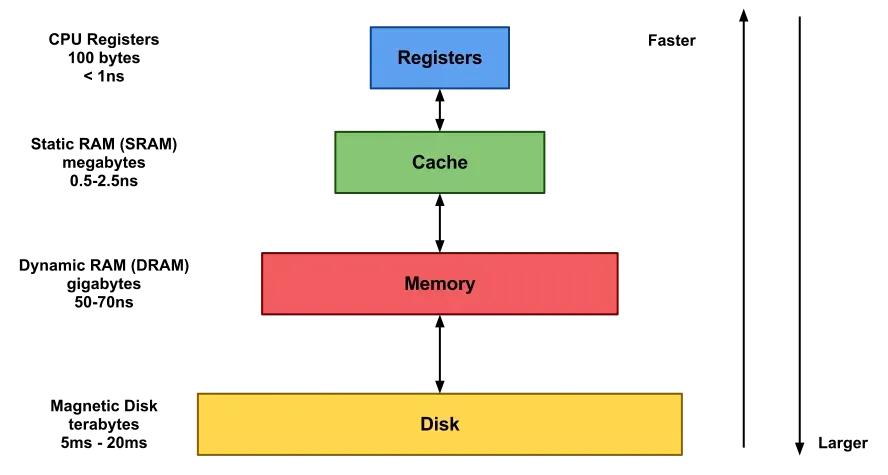
- 메모리란 기억 장치로, 굉장히 세분화가 되어있지만 …
- RAM과 Disk(SSD)
- RAM은 쉽게 말해 작업 공간
- 데이터를 갖고 작업 하기 위해
우리는 데이터를 RAM이란 곳에 올린다 (read_csv등) - 여기에 OS(윈도우 등)와 기본적인 프로그램을 올리면 2~6GB 정도 차지
- 컴퓨터를 끄면 RAM에 올라간 데이터는 삭제
- 데이터를 갖고 작업 하기 위해
- Disk는 쉽게 말해 저장 공간.
- 장기적으로 데이터를 보관(저장)하는 공간
- 컴퓨터를 꺼도, Disk의 데이터는 사라지지 않는다.
CPU
-
CPU는 일꾼입니다. 보통 컴퓨터는 여러 일꾼을 가지고 있다.
-
우측은 정말 직관적인 설명.
-
모두 이해할 필요는 없으며, 가장 중요한 것은 코어의 수라고 봐도 된다.
*같은 코어 수라도, 고성능의 CPU는 수배 이상 빠를 수 있다. -
하나의 작업을 위해 여러 코어를 사용하는 것을
병렬 처리라고 함.
- 스파크 또한 여러 대의 PC를, 그리고 각 PC의 여러 코어를 모두 사용함.
Data type
- 오버플로Overflow
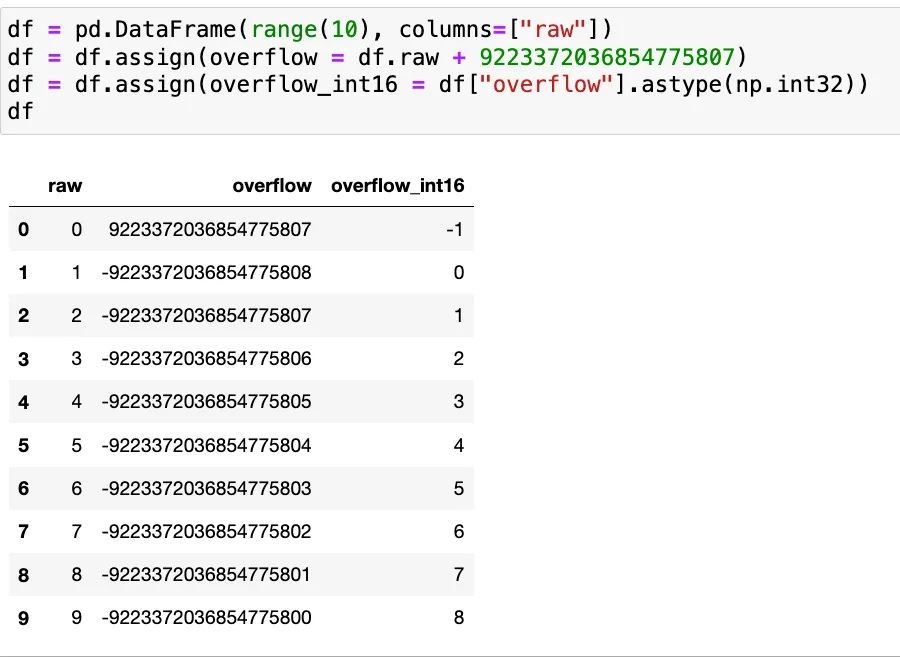
- 크기에 맞지 않는 데이터를 넣어 의도하지 않은 결과가 나오는것을 오버플로overflow라고 함.
*정확한 정의는 좀 더 복잡 - 파이썬의 데이터 타입은 기본적으로 동적Dynamic이기 때문에 자동으로 데이터형이 바뀐다
- 따라서 큰 숫자를 다루는 것은 굉장히 주의!
부동소수점Floating points
- 부동소수점은 사람에게 직관적이지 않지만, 컴퓨터는 부득이 사용하는 개념
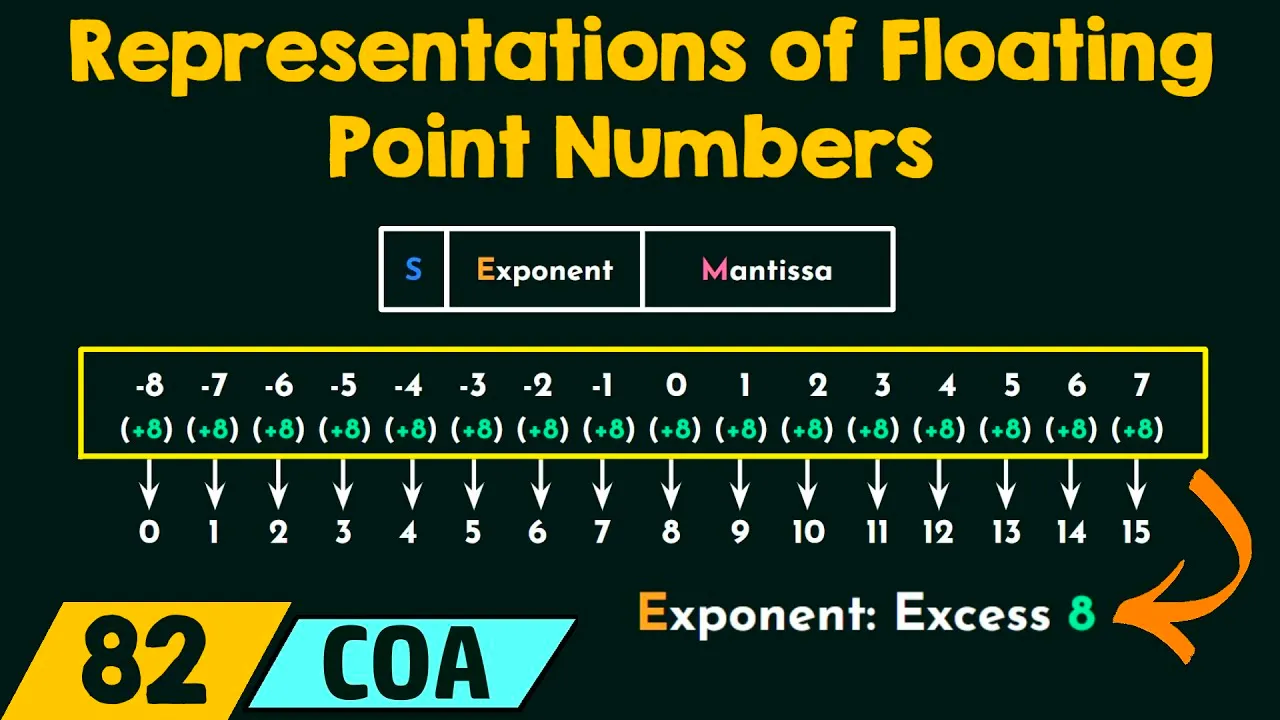
- 부동소수점은 하나의 숫자를 형태와 자릿수로 구분하여 표현하는 것.
- 예를 들면, ,
- 일부의 데이터는 형태(4.78224)를, 나머지 데이터로 자릿수(2)를 표현
*이진법이고, 소수부와 정수부가 다르기 때문에 정확하게는 조금 다름
- 부동소수점 또한 정수와 마찬가지로 float16, float64 등을 사용하는데,
더 큰 메모리를 사용할수록 값이 정확해지지만 데이터가 더 무거워진다.
부동소수점 오차 - 부동소수점은 그 원리상 필연적으로 오차를 동반.- 부동소수점은 그 원리상 필연적으로 오차를 동반.
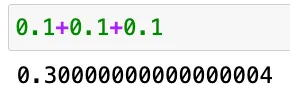
이러한 오차는 더 많은 메모리(16 → 32)를 사용할수록 줄어들지만
이론적으로는 무한히 많은 메모리를 사용해야만 이 오차를 정확히 없앨 수 있다.
String, Category
메모리를 굉장히 많이 차지한다는 것을 기억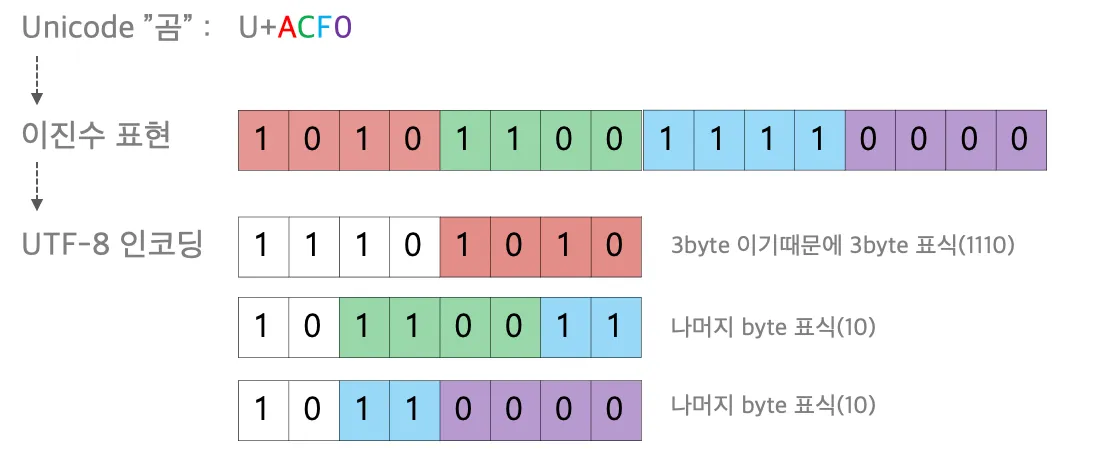
- 파일 유형(디스크에 올리는 데이터의 유형과 용도)
File format
디스크에는 데이터를 어떻게 저장하는지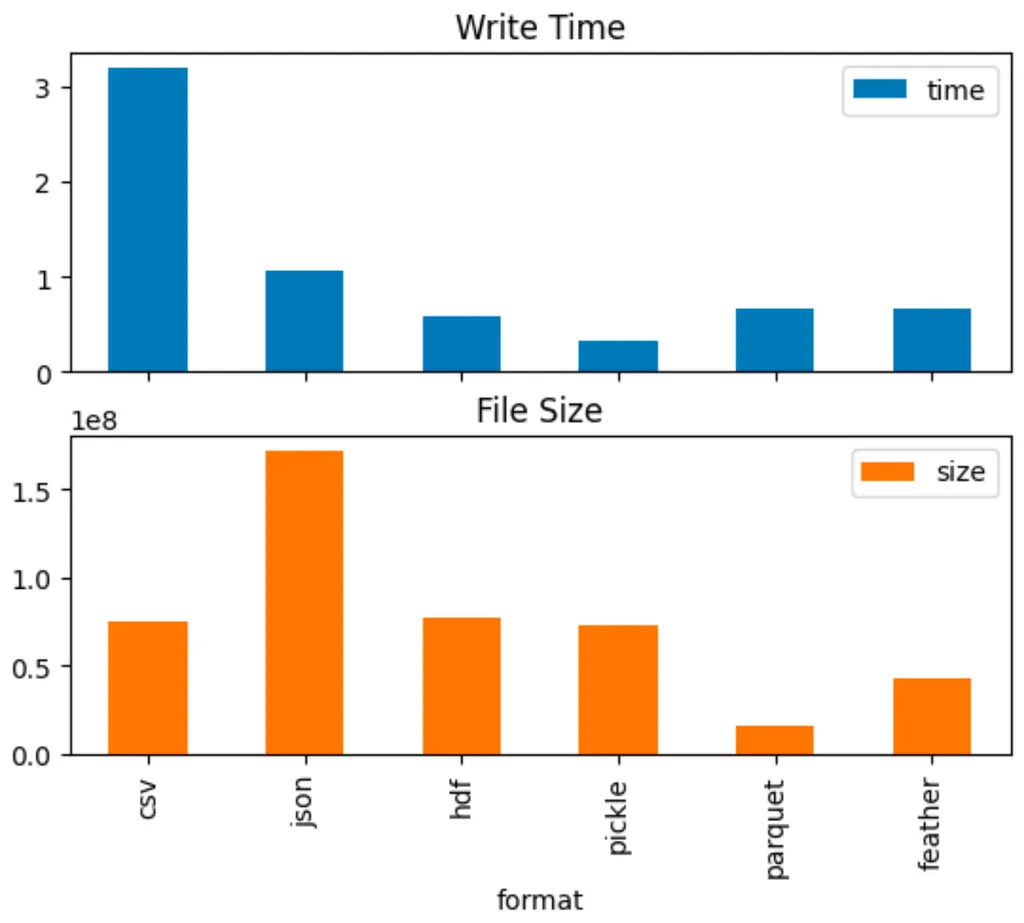
- 시간적 비용: 읽고 쓰는데 걸리는 시간
- 파일 유형에 따라 수십배까지 차이가 남
- 공간적 비용: 저장된 파일의 크기
- 마찬가지로 파일 유형에 따라 수십배까지 차이가 남.
- 좀 더 나아가, 입/출력 시에 필요한 메모리도 굉장히 중요.
csv, txt
- 가장 흔한 포맷으로, 개발이나 분석 직군이 아닌 사람도 많이 다룬다
- CSV는 Comma-separated values의 약자로, 콤마로 구분된 정형 데이터를 가리킨다.
- Comma(
,) 대신 Tab(\t)과 같은 다른 구분자seperator를 사용할 수도 있다 - 데이터 안에 구분자가 들어있는 경우, 방어할 수는 있지만 깨질 위험이 있다.
- Comma(
- 가장 느리고, 무거워서 소규모 데이터가 아니면 부적절
- 내부적으로는 encoding(utf-8, cp949 등)에 따라 다르게 저장.
json
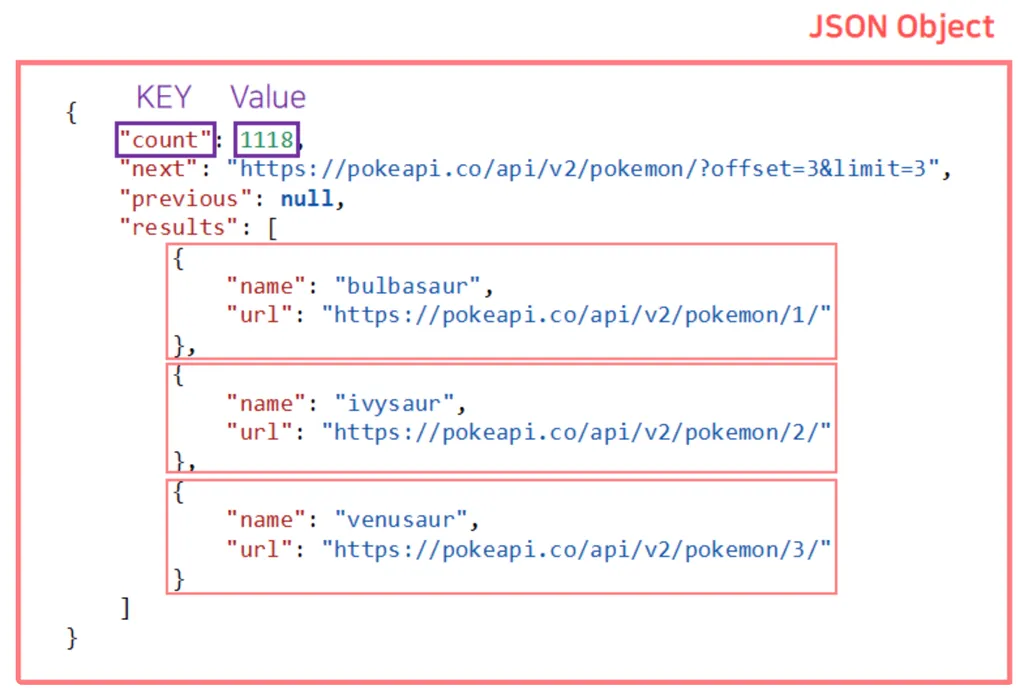
- 저장된 자료를 python의 dictionary와 같은 형식으로 강제하며, 이를 JSON Object라 한다.
- ex)
{”키”:”값”} - dict와 같은 것은 아님. 파이썬의 dict를 json으로 변환하여 사용할 수 있으며, 이를 dump한다고 함.
*좀 더 자세히 들어가면 byte serialize를 이해해야겠지만, 여기서는 생략
- ex)
- 여러 JSON Object를 JSON Array에 담을 수 있다.
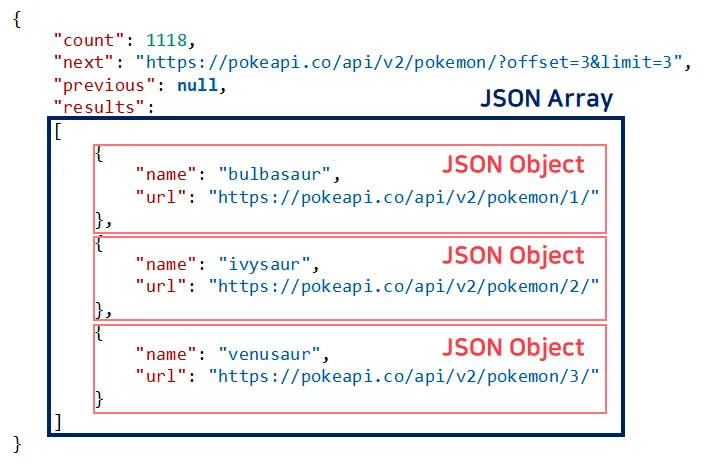
- 비교적 개발자의 선호도가 높으며, 비교적 대용량의 데이터도 JSON으로 관리하는 경우가 많다
- API 통신도, 보통 JSON 형식
- 하지만 여전히 무거워서 대용량 데이터를 다루는데는 불편
- txt와 마찬가지로 encoidng방법에 따라 다르게 저장되는데, utf-8을 사용하는 것이 일반적
Pickle
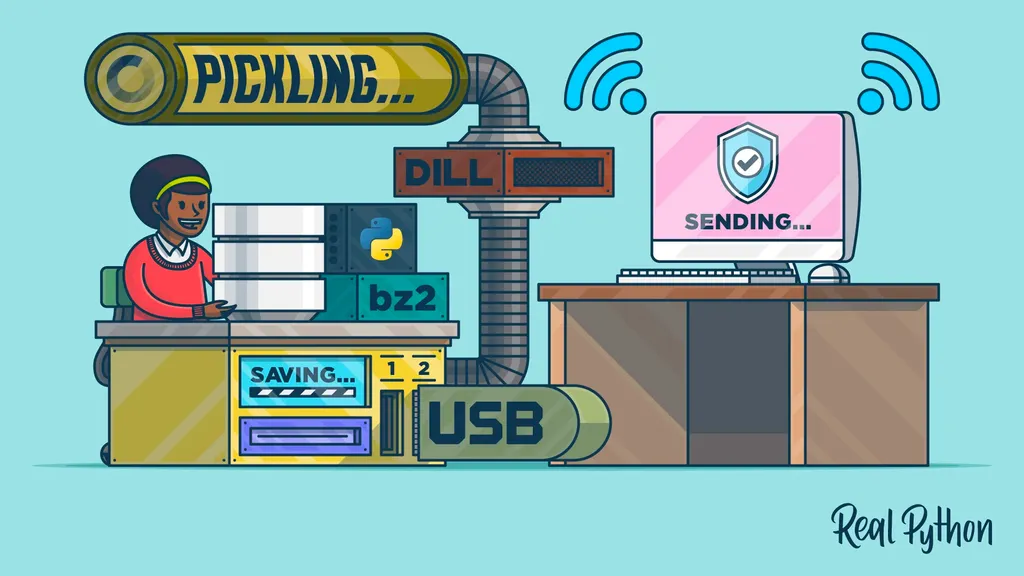
- 하나의 컴퓨터로 개인용 프로젝트에서 데이터를 관리할 때 편리한 데이터 형식
- 버전과 운영체제에 대한 의존Dependency이 있기 때문에 협업할 때 데이터를 주고 받으면 작동하지 않을 위험이 있다
- 위의 유형(csv, json)보다 2~30% 정도 용량이 가볍
- read/write 속도가 수십배 이상 빠름
- (고급) nested type을 지원.
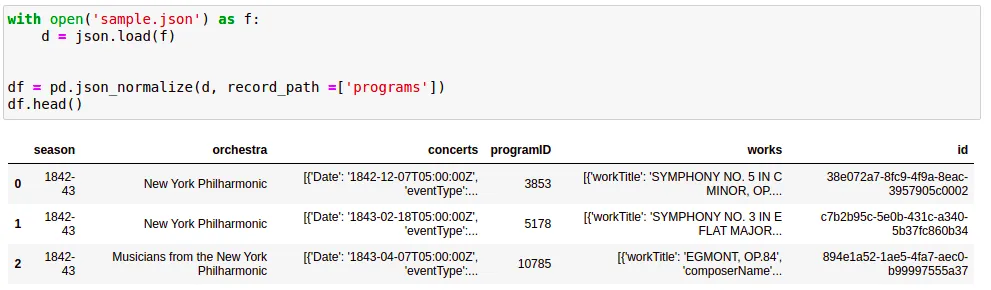
Parquet
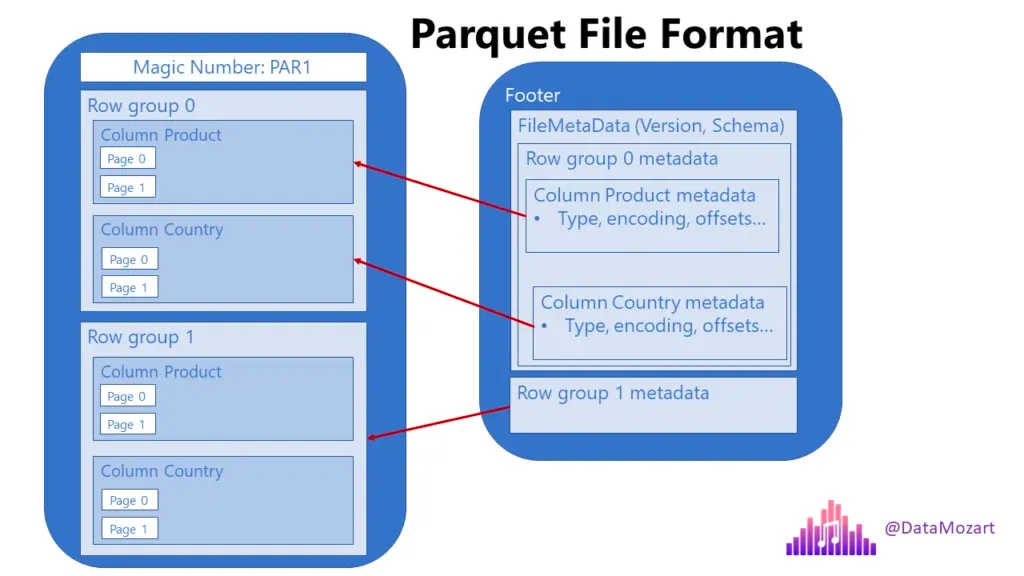
- 대용량 데이터 저장에서 표준입니다. 보통 “파케이”라고 읽음
- 굉장히 가볍고, 빠름! 개인적으로는 거의 parquet를 사용
- 다수의 OLAB Database가 내부적으로 parquet를 사용하여 데이터를 저장
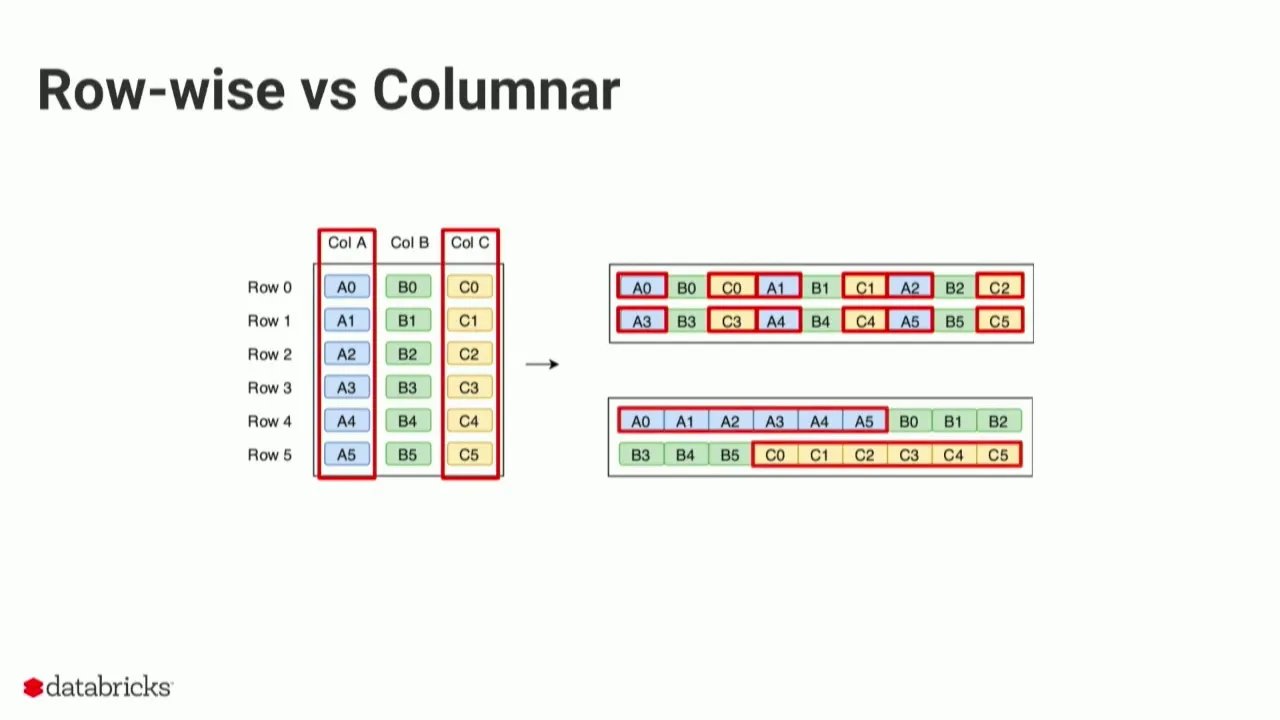
I/O
- Input & Output을 가리킵니다.
- 다양한 맥락에서 쓰이지만, 여기서는 데이터의 입출력의미.
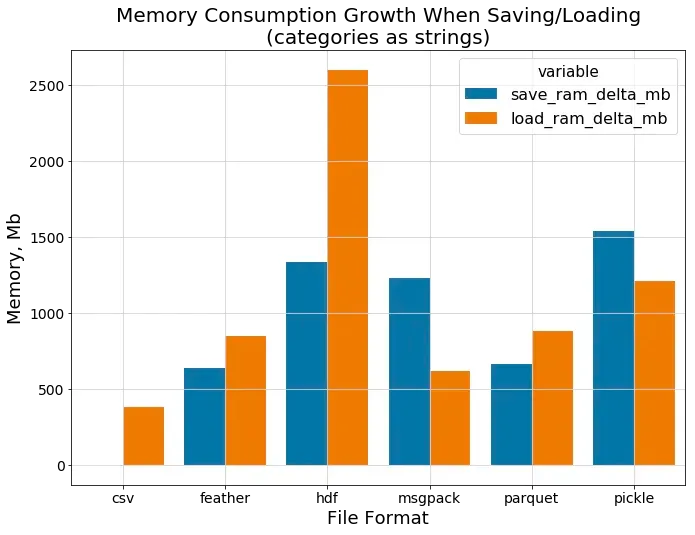
I/O의 메모리 사용
전처리에서 잘 돌던 데이터가, 저장save에서 터지는(OOM) 경우가 있다
I/O Speed
- 언급한 것 중 가장 빠른 데이터 수급은 메모리
- 좀 더 자세히는 Network < Disk < Memory
- 이러한 이유로 In-memory DB를 사용하기도 함.
- 스파크는 기본적으로 모든 데이터를 Memory에서 처리
- 내부적으로는 lazy computation 등으로 좀 더 복잡
- 클라우드
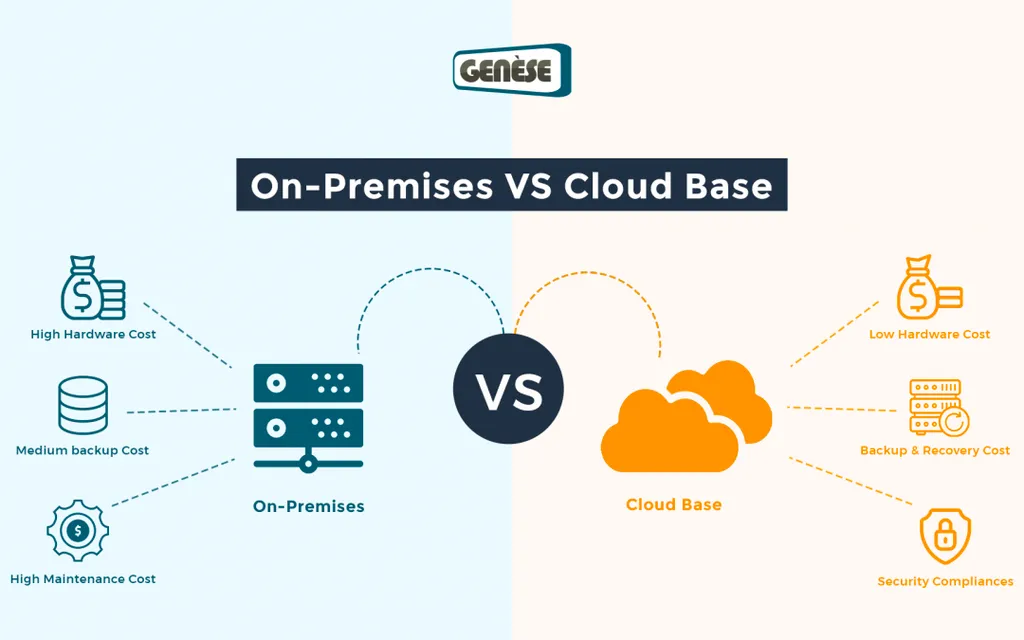
관리가 훨씬 쉽고, 보안이 뛰어나며, 가용성 굳.
클라우드 3대장
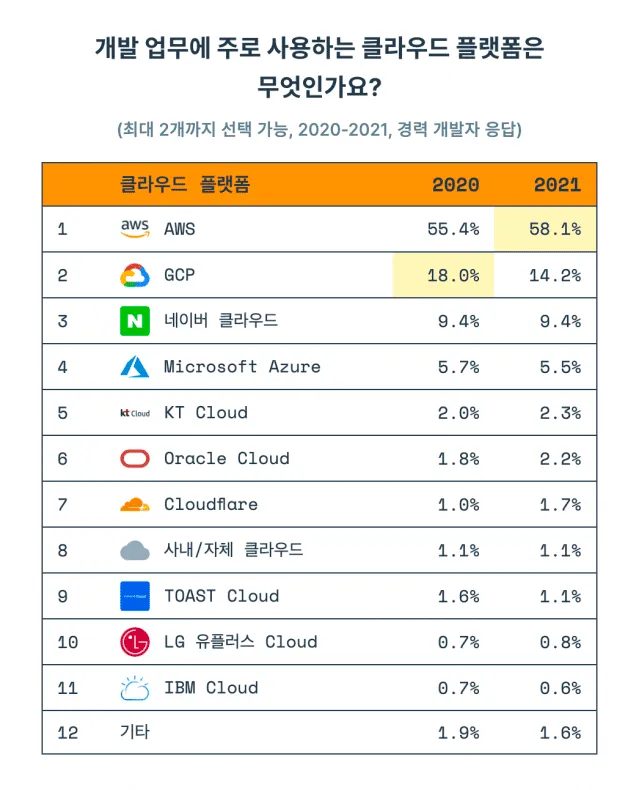
- AWS는 지금까지 시장을 지배해왔고, 앞으로도 그럴 가능성이 높다
- 한 번 시장을 지배한 이후로, 모든 것의 기준이 되었다
- GCP는 Bigquery 원툴일 수 있지만, 그 원툴이 너무 강력
- Azure는 편하지만, 비쌈.
- 그 외 여러 가지 이유(지원, 투자, 계열사 등)로 기타 클라우드를 사용하는 경우도 많다
스토리지
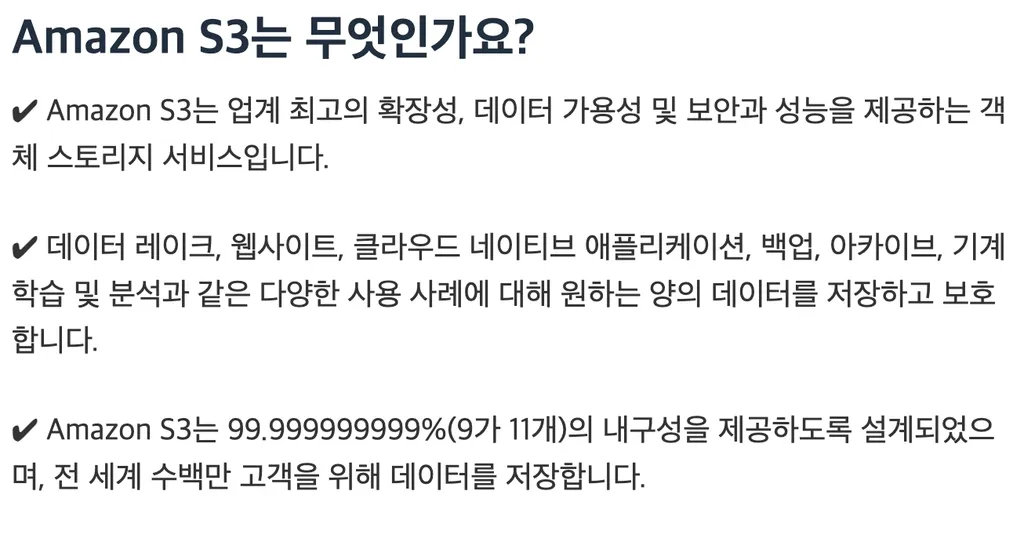
- AWS를 이용하게 되면 기본적으로 대부분의 파일(데이터)를 S3에 보관
- 내 컴퓨터에 보관하는 것보다 안전하며, 임의의 팀원이 접근할 수 있다
- 그 데이터를 다시 데이터베이스에 연결하여 사용할 수도 있다
- 스파크는 S3에서 직접 읽을 수도, DB를 통해 읽을 수도 있다.
- 비용에 주의
엔진
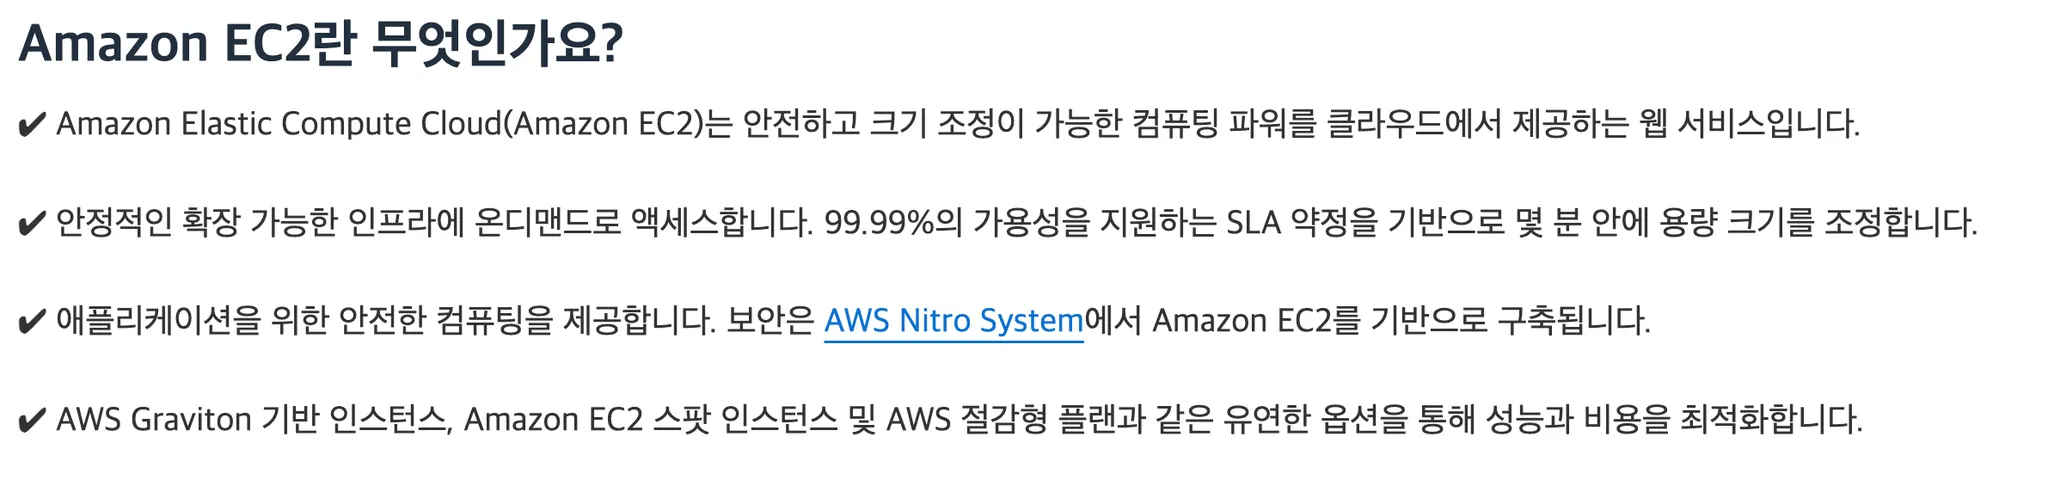
- 쉽게 말해 컴퓨터를 빌리는 것
- 단일 기기를 빌릴 수도 있고, 여러 대를 빌려쓸 수도 있다
- 접속은 보통 ssh를 이용하고, vscode를 이용하면 좀 더 편리할 수 있다
데이터베이스
- 왜 데이터베이스를 사용하나?
- 데이터 공유: 데이터베이스는 여러 사용자가 동시에 접근하여 데이터를 공유할 수 있다.
- 데이터 보호: 데이터베이스는 데이터를 보호하기 위해 다양한 보안 기능을 제공.
- 데이터 검색: 데이터베이스는 데이터를 쉽게 검색할 수 있도록 인덱싱 기능을 제공.
- 데이터 백업과 복원: 데이터베이스는 데이터를 백업하고 복원하는 기능을 제공하여 데이터 손실을 방지. 이를 통해 중요한 데이터를 안전하게 보호할 수 있다.
- 수십가지 데이터베이스가 있는데, 서로 다른 세 가지 유형
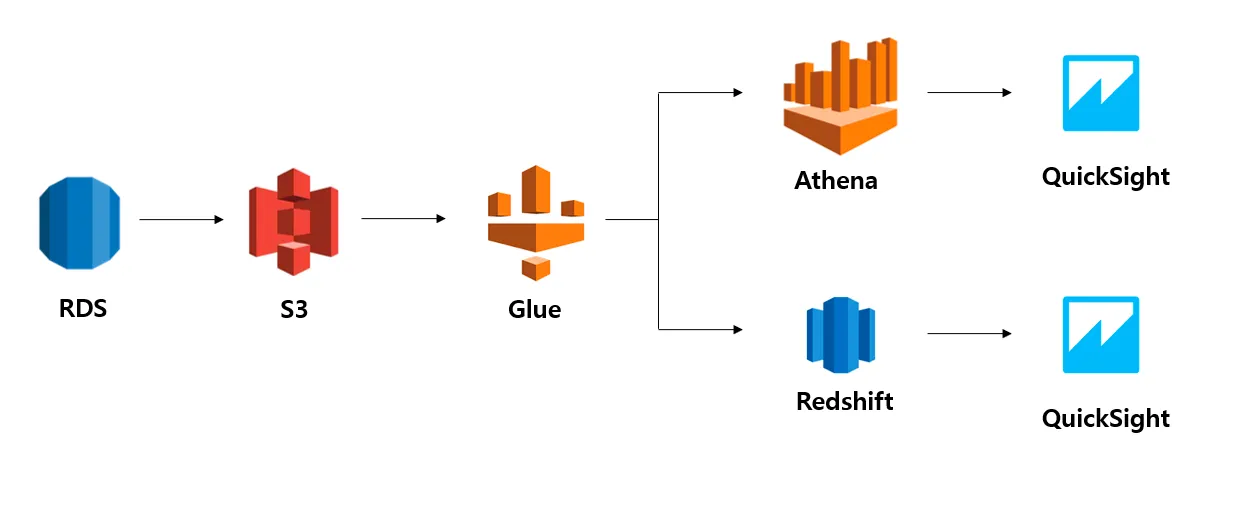
- RDS: 관계형 데이터베이스
- postgres와 mysql 등 다양한 옵션이 있는데, 보통 엔지니어가 결정한 걸 따르면 된다.
- 대동소이하며, 위에서 언급한 인덱싱을 잘 활용하면 좋다
- 항상 서버가 떠 있어야 하며, 그렇기 때문에 그 비용이 나간다
- Athena: S3에 있는 데이터를 직접 간편하게 분석할 수 있는 대화형 쿼리 서비스
- 보통 S3에 있는 데이터와 연동
- Serverless라고 하여, 쿼리를 운용할 때만 잠시 기기를 빌려 연산한 뒤 다시 반납
- 따라서 비용이 저렴한 것이 보통
- 바로 Spark와 연동할 수도 있다
- Redshift: 빠르고 강력한 데이터 웨어하우징이빈다
- 구동을 위해서는 클러스터(여러 대의 컴퓨터)를 구성하여 운영하여야함. 비쌈.
- 복잡한 연산에 조금 더 효율적
- 역시, Spark와 연동할 수 있다
아키텍쳐 예시
EMR
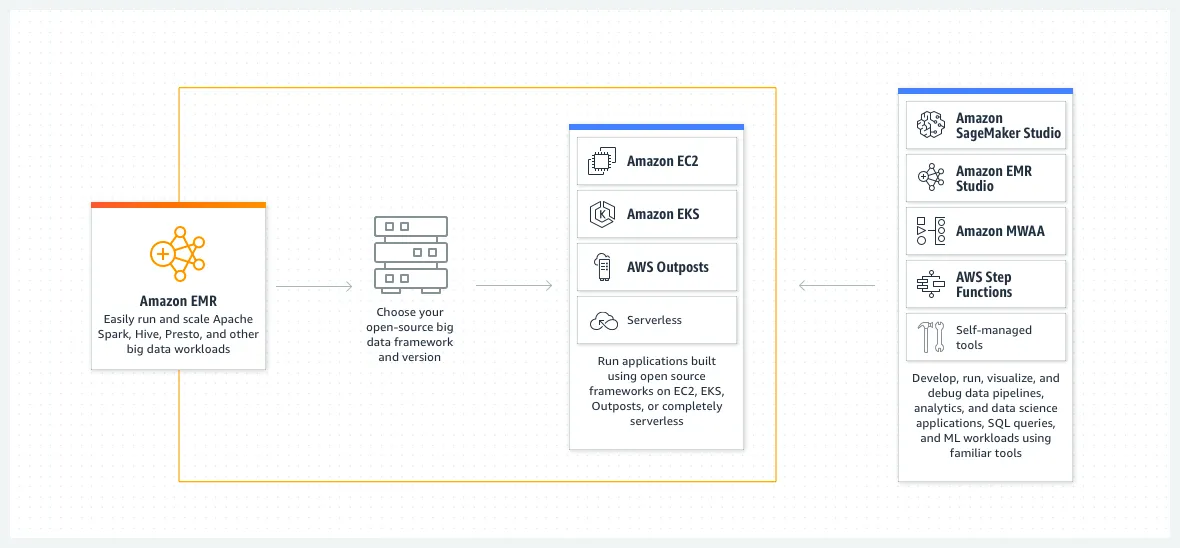
- 페타바이트급 데이터 처리, 대화식 분석 및 기계 학습을 위한 빅 데이터 솔루션
- AWS에서 Spark를 사용하면, 보통 EMR을 이용
key points
대용량 데이터 처리
- 스파크: 800GB 이상의 데이터를 효율적으로 처리하며, 단일 머신으로는 한계가 있음.
- PySpark: Python 기반 API로 데이터 과학자들이 쉽게 활용 가능.
- 분산 처리: 여러 대의 컴퓨터와 코어를 활용하여 병렬 처리.
- 메모리 관리: RAM과 Disk(SSD)를 사용하며, OOM(Out of Memory) 문제 발생 가능.
- CPU 성능: 여러 코어를 활용하여 병렬 처리, 고성능 CPU가 더 빠름.
데이터 타입
- 오버플로: 데이터 크기에 맞지 않는 값 입력 시 발생.
- 부동소수점: 숫자 표현 시 오차 발생 가능.
- 문자열 및 범주형: 메모리 사용에 주의 필요.
파일 포맷
- CSV/TXT: 일반적이지만 대규모 데이터에 부적합.
- JSON: 유용하나 대용량 처리에 불편.
- Pickle: 개인 프로젝트에 적합하지만 OS와 버전 의존.
- Parquet: 대용량 데이터 저장의 표준 포맷.
I/O (입출력)
- 메모리 사용: 저장 과정에서 OOM 오류 발생 가능.
- 속도: Memory > Disk > Network 순으로 속도 결정.
클라우드
- AWS, GCP, Azure: 각각의 장점이 있는 주요 클라우드 서비스.
스토리지
- AWS S3: 안전하고 접근 용이, Spark와 데이터베이스 연동 가능.
데이터베이스
- RDS: 관계형 데이터베이스, 인덱싱 활용.
- Athena: S3 데이터 분석, 서버리스.
- Redshift: 데이터 웨어하우징 솔루션.
- EMR (Elastic MapReduce)
AWS에서 Spark를 사용할 때 주로 이용되는 빅 데이터 솔루션.
Be DBA