AI Scientist, 2024-2026
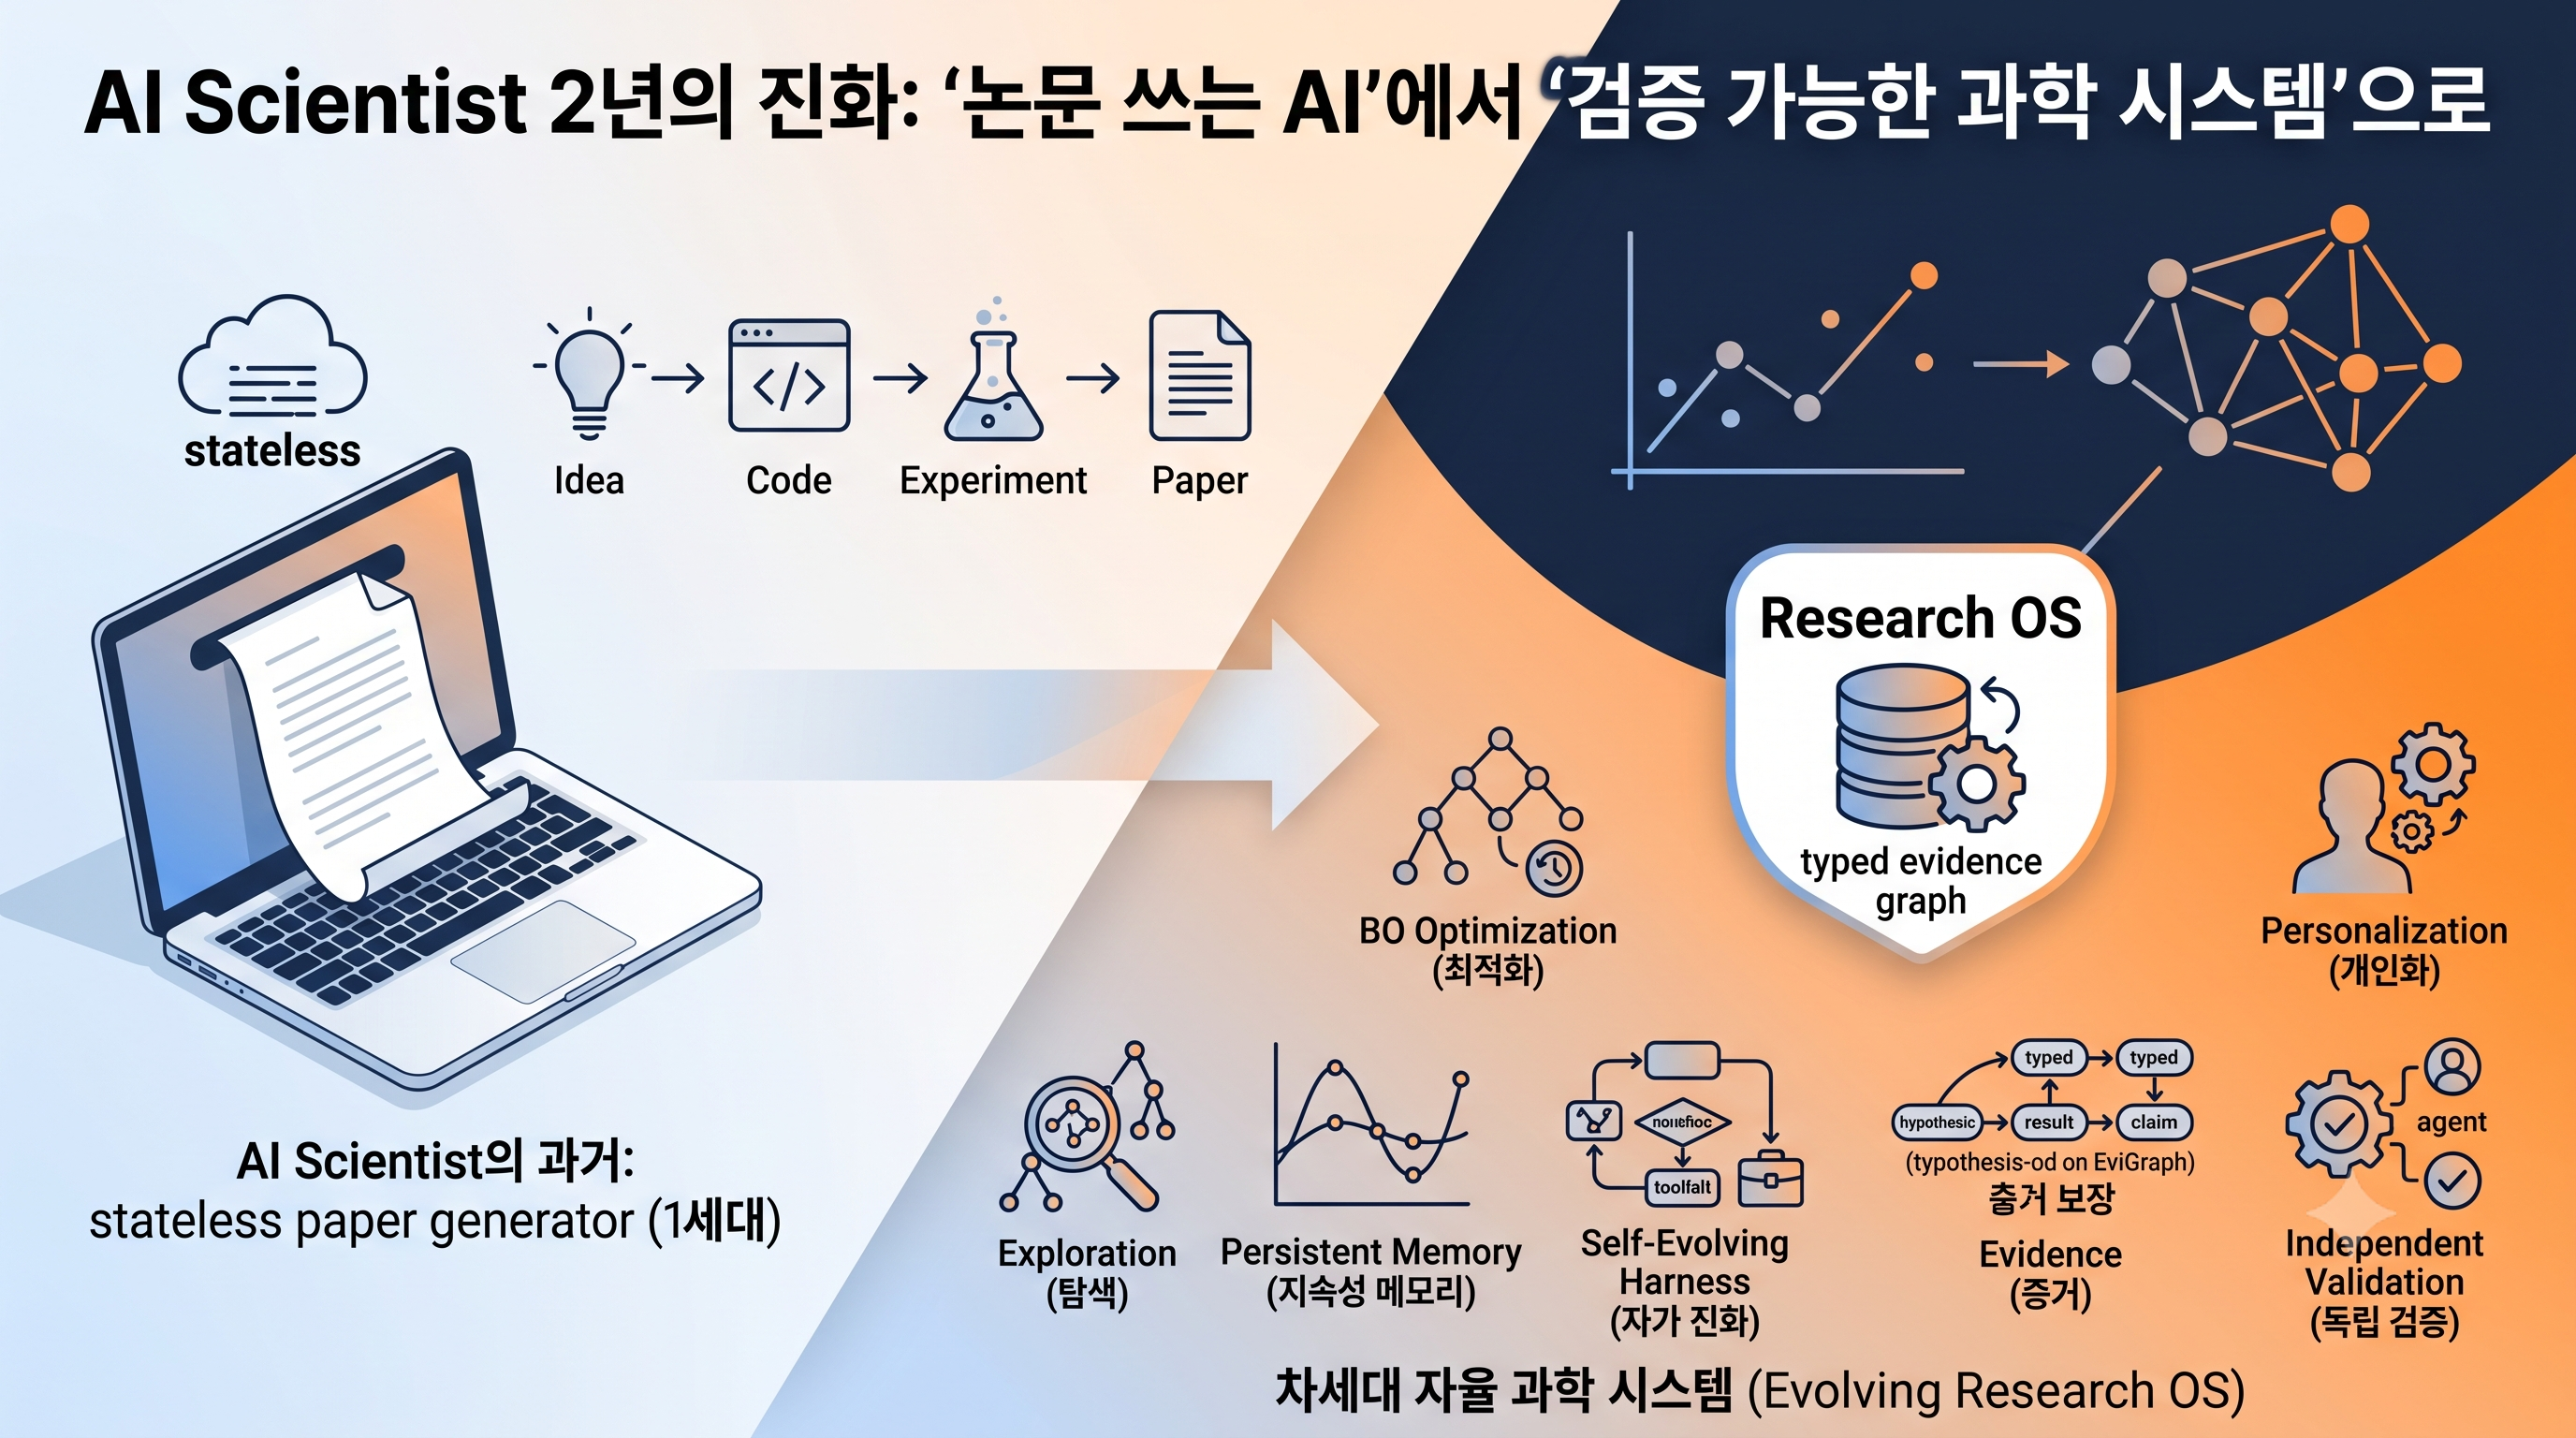
AI Scientist 2년의 진화: 논문 자동 생성에서 ‘검증 가능한 과학적 발견’으로
2024년 Sakana AI가 연구 아이디어 제안부터 코드 작성, 실험, 논문 집필, 자동 리뷰까지 전 과정을 하나의 루프로 연결한 The AI Scientist를 공개한 이래, AI 기반 연구 에이전트 분야는 매우 빠른 속도로 진화해 왔습니다.
이 진화 과정을 관통하는 핵심 축은 크게 세 가지로 요약할 수 있습니다.
| 핵심 축 | 핵심 질문 | 대표 연구 계보 |
|---|---|---|
| 탐색 (Exploration) | 어떤 연구 가설을 탐색할 것인가? | AI Scientist AI Scientist-v2 DeepScientist |
| 적응 (Adaptation) | 과거의 실패와 경험에서 어떻게 배울 것인가? | EvoScientist NanoResearch AutoSci / Sibyl |
| 신뢰성 (Reliability) | 도출된 연구 주장을 논리적으로 어떻게 검증할 것인가? | EviGraph Trustworthy Autonomous Science |
하지만 이러한 가파른 발전과 함께 근본적인 의문도 함께 제기되고 있습니다.
"대규모 자동 탐색이 과연 인류 지식의 과학적 지평을 실제로 넓혀주고 있는가?"
2026년 발표된 논문 AI Research Agents Narrow Scientific Exploration은 이 문제에 대해 매우 냉정한 실증적 경고를 던집니다.
결국 지난 2년간의 역사는 단순히 LLM의 성능이 좋아진 과정이 아니라, "AI 연구 시스템이 내부적으로 유지·관리해야 하는 '연구 상태(Research State)'가 고도화되어 온 과정"으로 해석하는 것이 가장 정확합니다.
1. 2024 — The AI Scientist
연구 프로세스 전체를 실행 가능한 파이프라인으로 구축
The AI Scientist(코드: SakanaAI/AI-Scientist)의 가장 큰 공헌은 파편화되어 있던 연구 작업들을 하나의 자동화된 엔드투엔드(E2E) 루프로 묶어냈다는 점입니다.
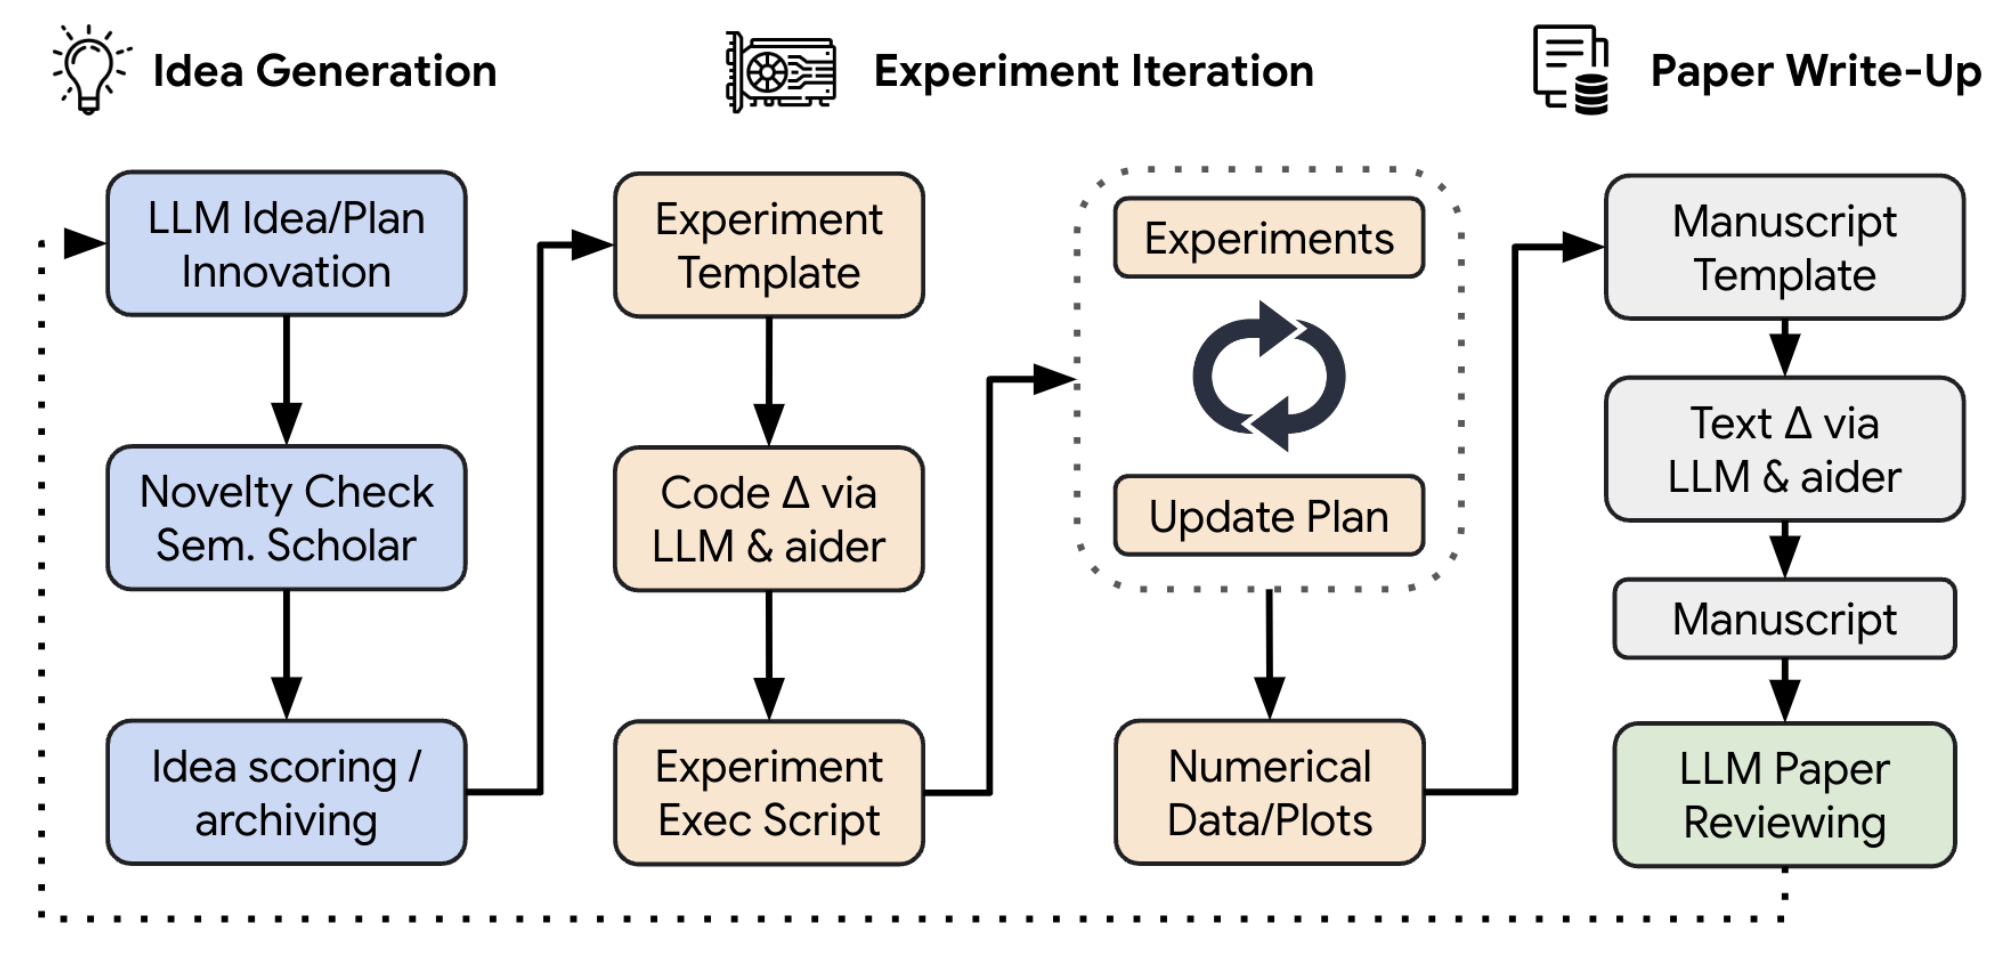
디퓨전 모델, 트랜스포머, 학습 동역학 등 3가지 머신러닝 분야에서 논문 1편을 작성하는 데 드는 비용을 15달러 미만으로 낮추며 가능성을 시연했습니다.
- 기능적 전환: 기존 AI for Science가 문헌 검색, 속성 예측 등 '부분 태스크 자동화'에 머물렀다면, 연구 과정 전체를 하나의 계산 가능한 '워크플로우 자동화' 영역으로 끌어올렸습니다.
- 명확한 한계: 연구자가 미리 작성해 둔 코드 템플릿 안에서만 작동했으며, 피어 리뷰 또한 AI 자체 평가에 의존했습니다.
- 연구의 상태 (State):
[현재 아이디어 + 현재 코드 + 현재 실험 결과]수준에 머물렀으며, 실행 세션이 끝나면 시스템의 모든 맥락이 초기화되는 비저장형(Stateless) 구조였습니다.
2. 2025 — AI Scientist-v2
고정 파이프라인에서 '에이전틱 트리 검색'으로의 전환
AI Scientist-v2(코드: SakanaAI/AI-Scientist-v2)는 고정된 일직선 파이프라인을 점진적 에이전틱 트리 검색(Progressive Agentic Tree Search) 구조로 전환했습니다.
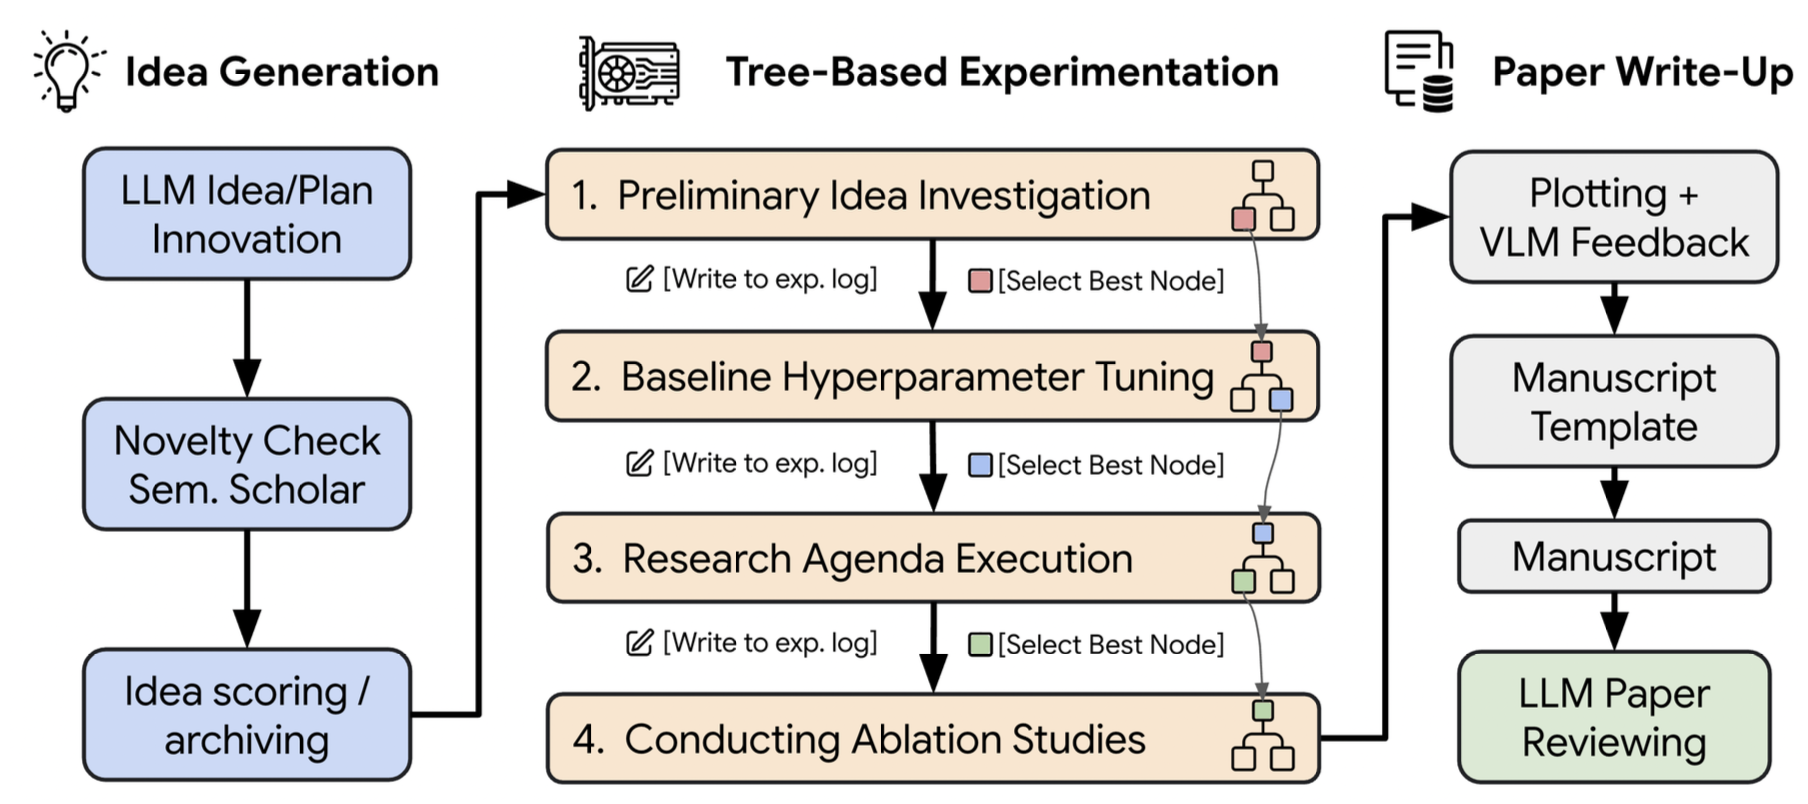
실험 관리자(Experiment Manager)가 여러 연구 경로를 동시 다발적으로 생성한 뒤, 중간 결과를 평가하며 유망한 가지(Branch)를 확장해 나가는 방식입니다. 인간의 코드 템플릿 의존성도 완전히 제거했습니다.
- 내부 표현의 변화: 단선적 실행에서
아이디어 → {경로1, 경로2, 경로3...} → 평가 및 선택 → 확장구조로 바뀌면서, 연구 프로세스가 '탐색 및 검색 문제(Search Problem)'로 재정의되었습니다. - 의의: 실제 완전 자동 생성된 논문 3편을 ICLR 2025 워크숍(I Can't Believe It's Not Better)에 제출하여 1편이 실제 피어 리뷰 통과 기준을 충족했습니다.
- 새로운 병목: 단순히 탐색 공간을 넓히는 것만으로는 "수많은 가능성 중 어느 경로를 깊게 파고들어야 하는가"에 대한 자원 배분 문제를 해결하지 못했습니다.
3. 2025 — DeepScientist
연구 탐색을 베이지안 최적화 문제로 다루다
DeepScientist(코드: ResearAI/DeepScientist)는 과학적 발견 자체를 평가 비용이 비싼 블랙박스 최적화 문제로 정의했습니다.
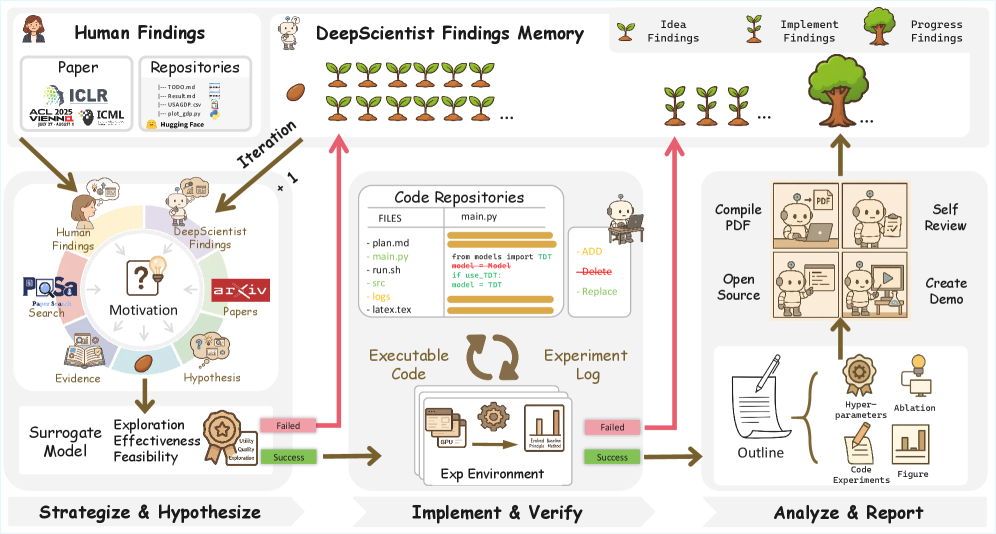
아이디어()를 저비용 가설 검증부터 시작하여 유망한 후보만 고충실도(High-fidelity) 실험으로 승격시키는 베이지안 최적화(Bayesian Optimization) 매커니즘을 도입했습니다.
- 규모 및 효율: 20,000 GPU-hour 이상을 투입해 약 5,000개의 아이디어를 제안하고, 1,100여 회의 실험 검증을 거쳐 21건의 의미 있는 성능 개선을 이뤄냈습니다.
- 시사점:
5,000개 생성 → 1,100회 실험 → 21건 성공이라는 수치가 보여주듯, 연구의 핵심 병목이 아이디어 양산이 아니라 '유망한 후보를 선별하는 필터링(Validation & Filtering)'으로 이동했습니다. - 한계: 열린 과학 영역 전체보다는 명확한 목표 지표가 존재하는 벤치마크 문제에 특화된 국소 최적화 도구(Local Optimizer)에 가깝다는 한계가 존재합니다.
4. 2026 — EvoScientist
단발성 실행을 넘어 경험을 축적하는 지속성 메모리 구축
EvoScientist(공식 사이트: EvoScientist)는 이전 실행(Run)이 끝나면 경험이 소멸하던 상태 비저장(Stateless) 한계를 극복하고자 했습니다.
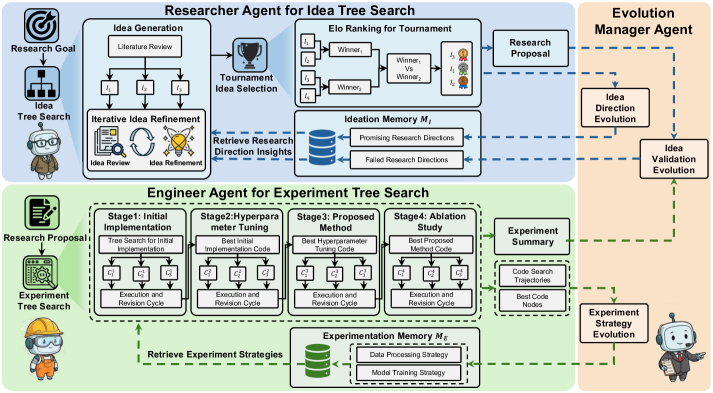
연구자(Researcher), 엔지니어(Engineer), 진화 관리자(Evolution Manager) 에이전트가 역할을 분담하고, 시스템 내에 두 가지 형태의 지속성 메모리(Persistent Memory)를 구축했습니다.
- 아이디어 메모리: 성공 가능성이 높은 방향과 더불어 실패했던 비효율적 가설(Negative Results)을 함께 저장하여 중복 탐색 방지.
- 실험 메모리: 효과적이었던 데이터 전처리, 모델 학습 전략, 디버깅 파이프라인 등 실무적 성공 패턴 축적.
- 학습의 정의: 파운데이션 모델의 가중치를 직접 재학습(Training)하지 않고,
경험 체득 → 메모리 구조화 → 검색 → 행동 변화를 구현하는 '시스템 수준의 경험적 학습(System-level Experiential Learning)'을 완성했습니다.
5. 2026 — NanoResearch
연구 기법을 넘어 '연구자의 암묵적 취향'을 학습
NanoResearch는 "자동화 시스템이 누구를 위해 작동하는가?"라는 질문을 던집니다. 모든 연구자는 선호하는 가설 검증 방식, 해석 가능성에 대한 비중, 요구하는 증거의 수준이 다릅니다.
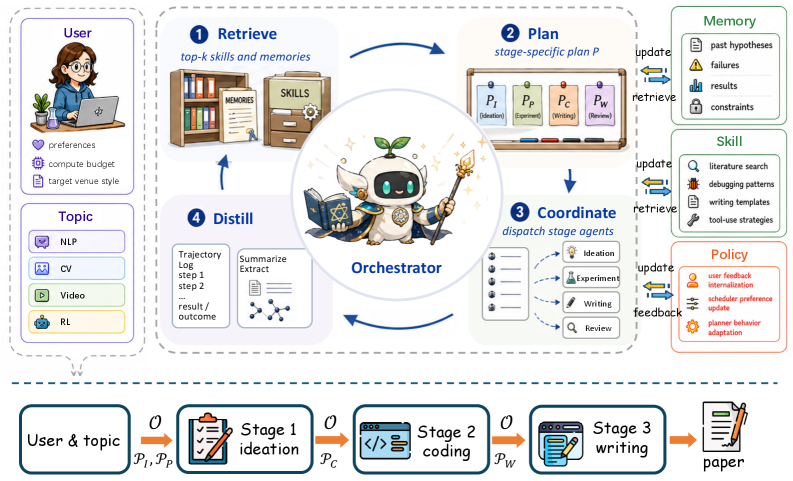
NanoResearch는 연구자 개인화를 세 가지 레이어로 분리하여 관리합니다. (위 그림에서 오른쪽 위의 세 가지 항목)
- 메모리 (Memory): 특정 프로젝트 및 사용자의 과거 실행 이력.
- 스킬 (Skill): 프로젝트 전반에서 재사용 가능한 절차적 작업 능력.
- 정책 (Policy): 주관식 피드백과 선택 이력에서 추출한 연구자의 암묵적 선호를 플래너 매개변수에 반영하는 정책 적응(Policy Adaptation).
💡 주의점: 인식론적 에코 챔버 (Epistemic Echo Chamber) > 지나친 개인화는 연구자의 기존 편향과 선입견을 AI가 그대로 강화해 버리는 부작용을 낳을 수 있습니다. 뛰어난 연구 에이전트는 연구자의 취향에 맞추면서도, 때로는 기존 틀을 깨는 반대 가설과 낯선 시도를 의도적으로 제안하는 탐색과 적응 사이의 밸런스를 가져야 합니다.
6. 2026 — AutoSci & Sibyl
단순 기억(Memory)을 넘어 시스템 자가 진화(Research OS)로
단순히 실패 기록을 DB에 저장해 둔다고 해서 AI가 실제로 학습했다고 볼 수 있을까요? 이 의문에 답하기 위해 두 연구가 등장했습니다.
AutoSci: 연구 환경 자체를 지속성 환경으로 다루다
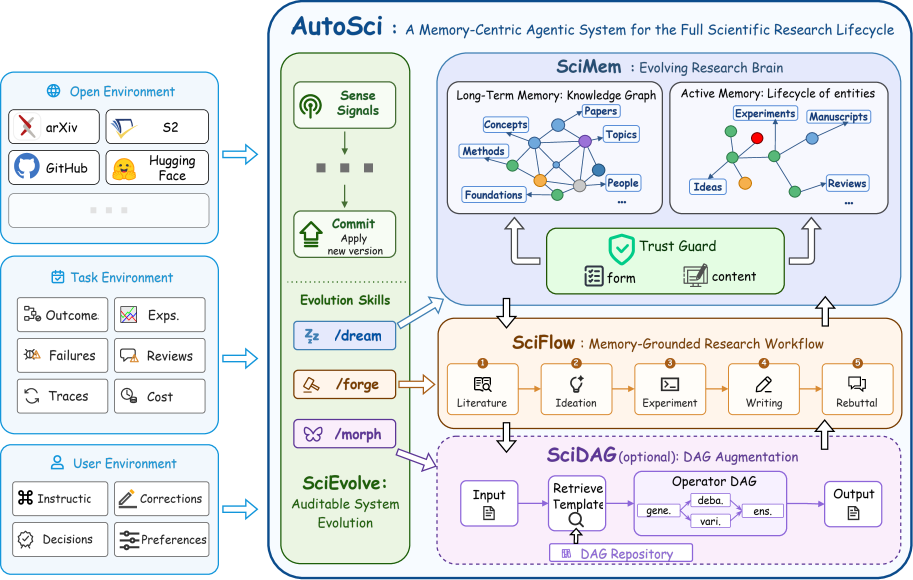
AutoSci(코드: skyllwt/AutoSci)는 지식 메모리(SciMem), 생애주기 관리(SciFlow), 멀티에이전트 워크플로우(SciDAG), 시스템 진화(SciEvolve)의 4개 계층을 통해 시스템 전체를 버전 관리되는 연구 전용 운영체제(Research OS)로 확장했습니다.
Sibyl: "메모리 저장은 행동 변화가 아니다"
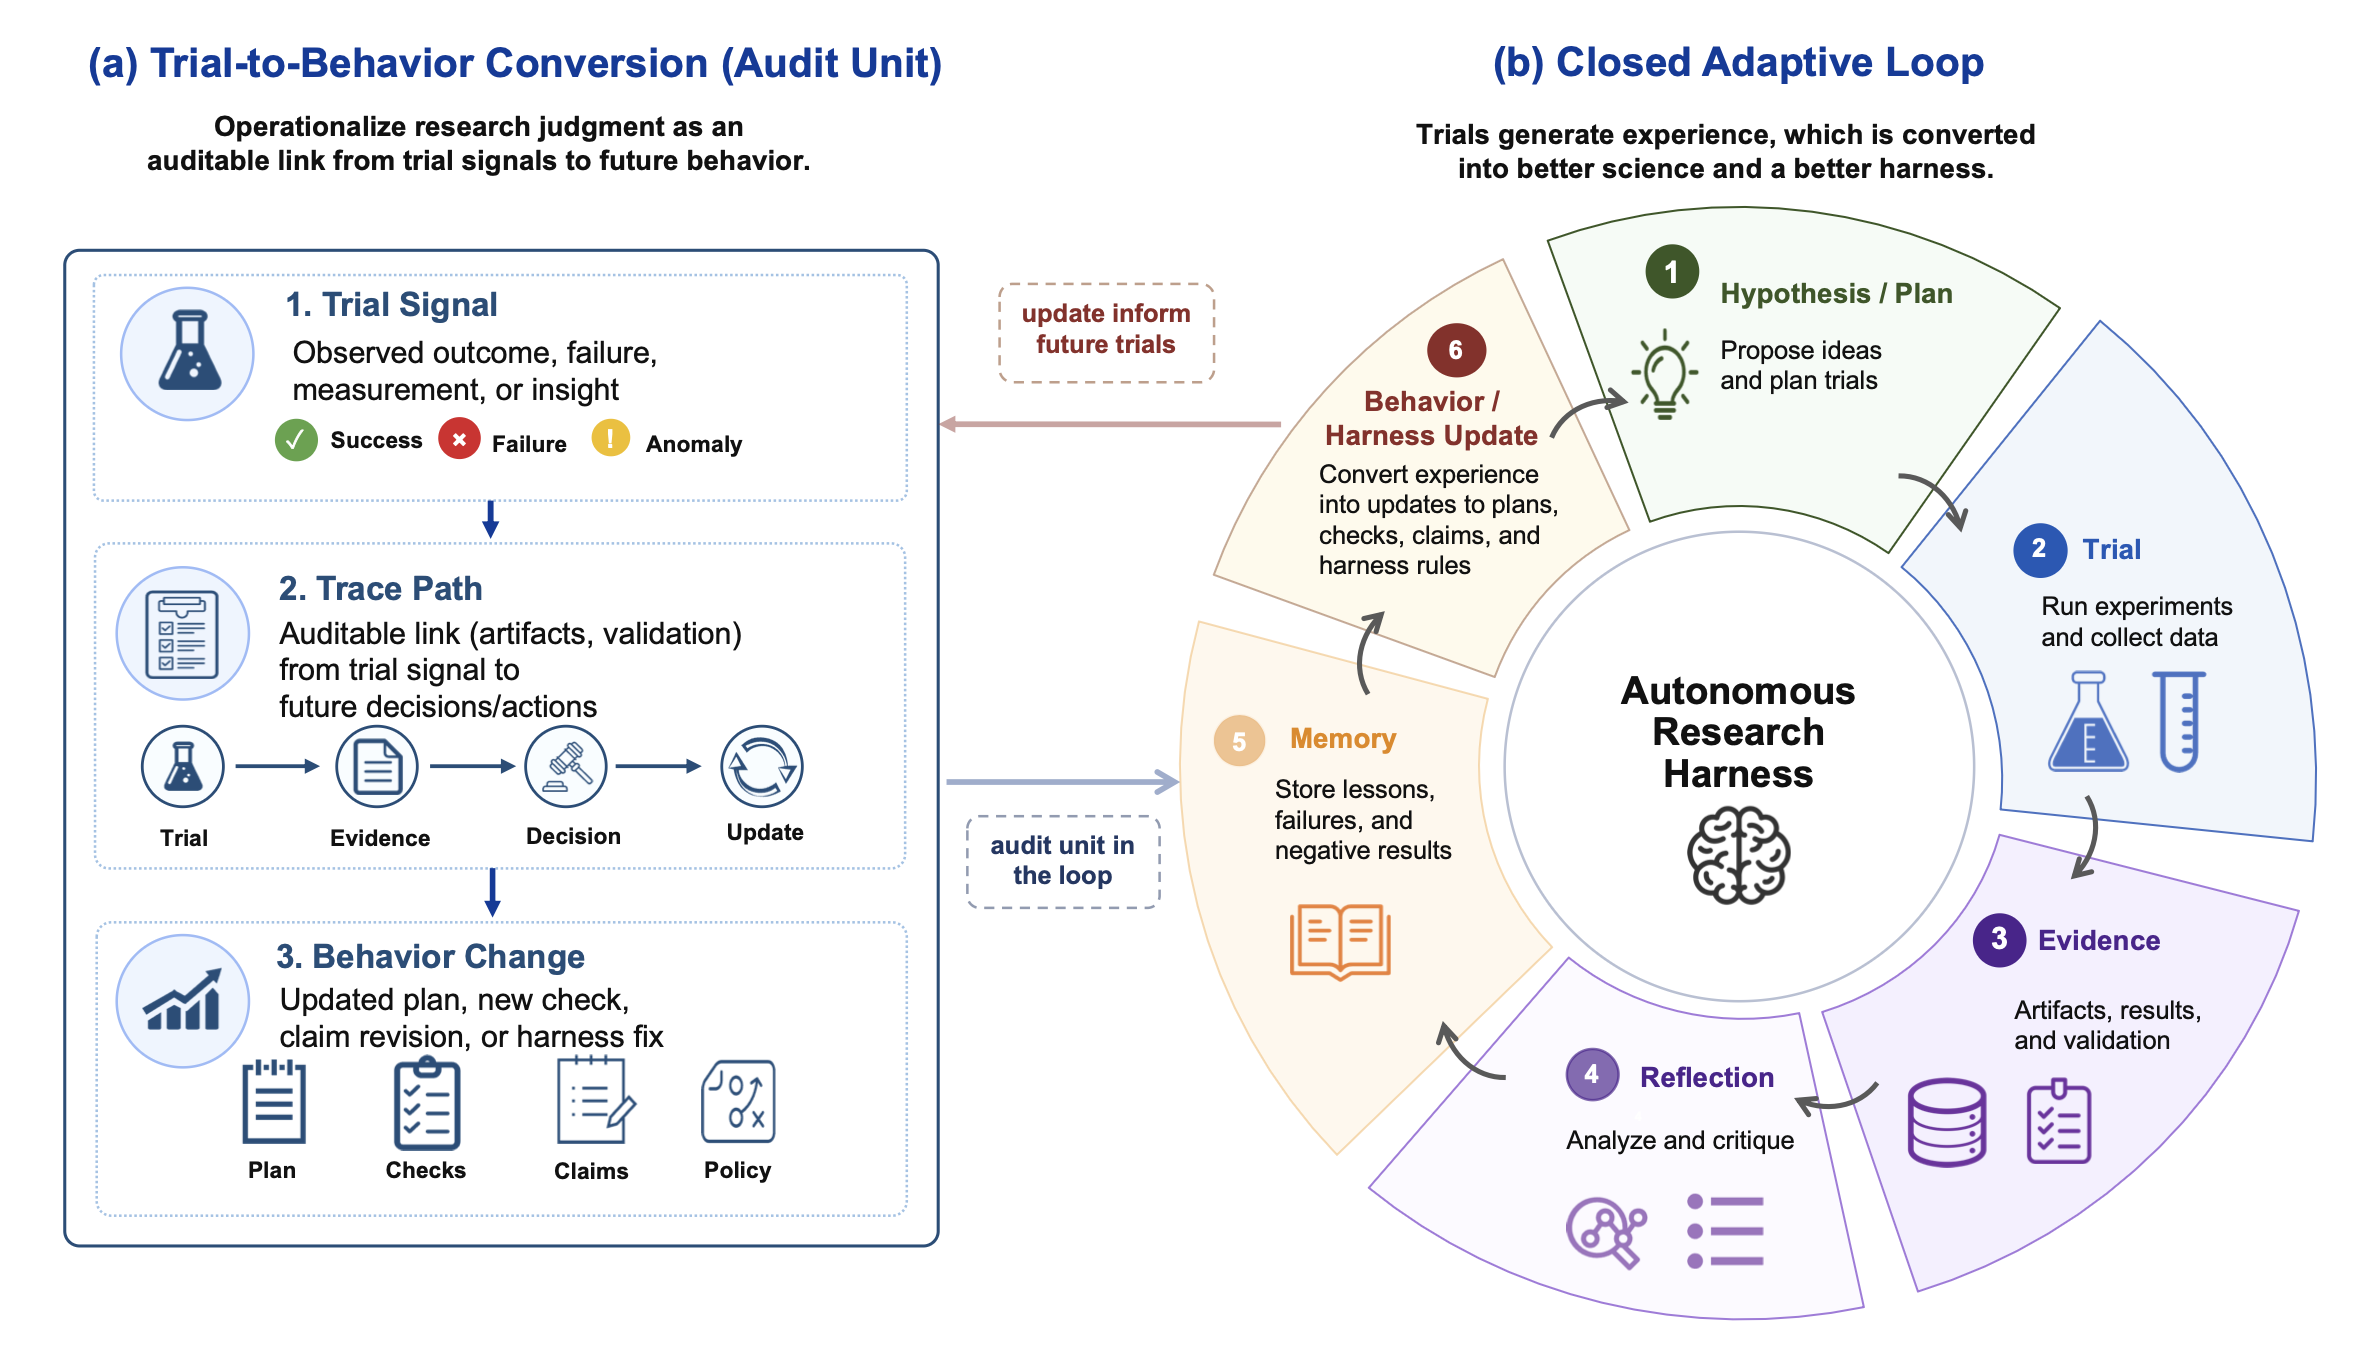
Sibyl-AutoResearch(코드: AutoResearch-SibylSystem)는 부실한 증거가 과장된 주장으로 이어지거나, 메모리는 축적되면서도 행동은 바뀌지 않는 '착시 현상'을 감지하기 위한 엄밀한 평가 기준을 제시했습니다.
- 시도-행동 전환 (Trial-to-Behavior Conversion): 개별 실험의 실패/성공 결과가 향후 계획 수립 및 주장의 범위를 실제로 수정했는가?
- 시도-하네스 행동 전환 (Trial-to-Harness-Behavior Conversion): 반복적인 프로세스 결함이 실행 프레임워크(Harness) 및 가드레일 자체의 수정으로 연결되었는가?
사후 감사를 통해 8건의 고신뢰 전환 사건을 확인했으며, 진정한 학습 평가의 기준을 "무엇을 기억했는가"에서 "그 경험으로 인해 다음 행동이 실제로 어떻게 변했는가"로 전환했습니다.
7. 2026년 8월 — EviGraph
논문 생성을 넘어 '주장-증거 구조'의 논리적 검증
EviGraph는 AI가 생성해 낸 그럴듯한 서술 속에 숨겨진 논리적 단절 문제를 해결하고자 합니다.
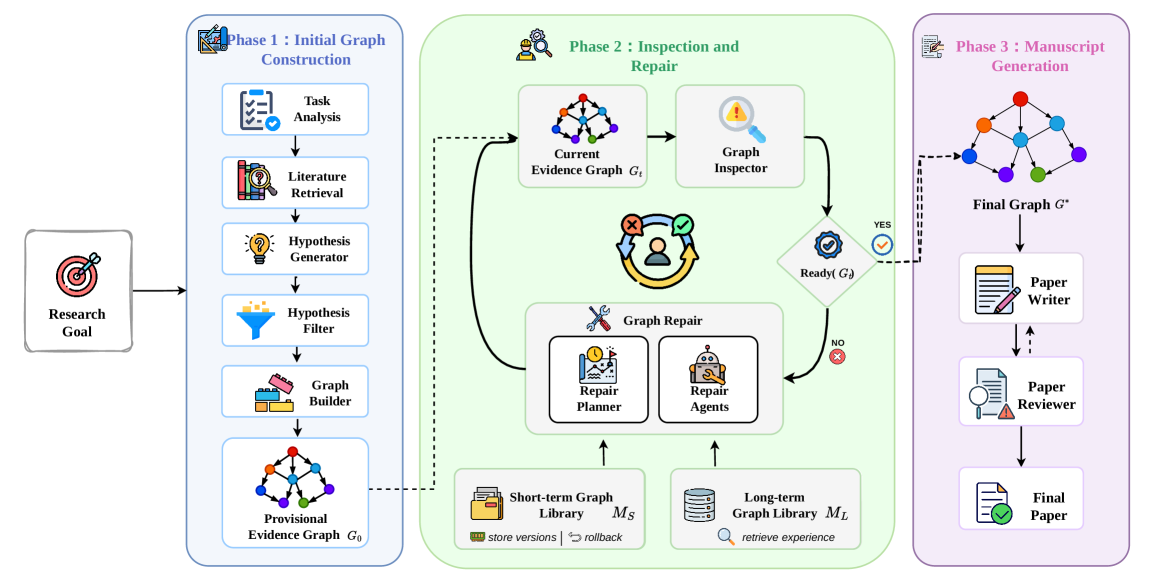
연구의 핵심 상태를 문제 정의 → 연구 공백 → 가설 → 실험 → 발견 → 최종 주장으로 이어지는 유형화된 증거 그래프(Typed Evidence Graph)로 유지하며 작동합니다.
- 자발적 수정 및 검증: 증거 연결망에서 논리적 비약이나 결과-주장 간 부조화가 감지되면, 결함이 발생한 노드로 돌아가 하위 연구를 자동으로 재수행합니다. 모든 주장이 검증된 증거 체인에 연결된 후에야 최종 논문 초안을 작성합니다.
- 증거 검증(Verification) vs 과학적 입증(Validation): EviGraph가 수행하는 것은 데이터와 주장 간의 '논리적 무결성 검증(Verification)'입니다. 해당 주장이 현실 세계에서 실제로 참인지를 밝히는 '과학적 입증(Validation)'을 위해서는 독립적인 재현 실험 및 외부 데이터셋 교차 검증이 별도로 필요합니다.
반전: AI 에이전트가 과학 탐색의 지평을 오히려 좁히고 있는가?
그렇다면 AI Scientist의 규모를 무한히 확장하면 인류의 과학적 발견 범위도 그만큼 넓어질까요?
21만 개 이상의 연구 아이디어를 정밀 분석한 연구 AI Research Agents Narrow Scientific Exploration은 그렇지 않을 수 있다는 결과를 보여줍니다.
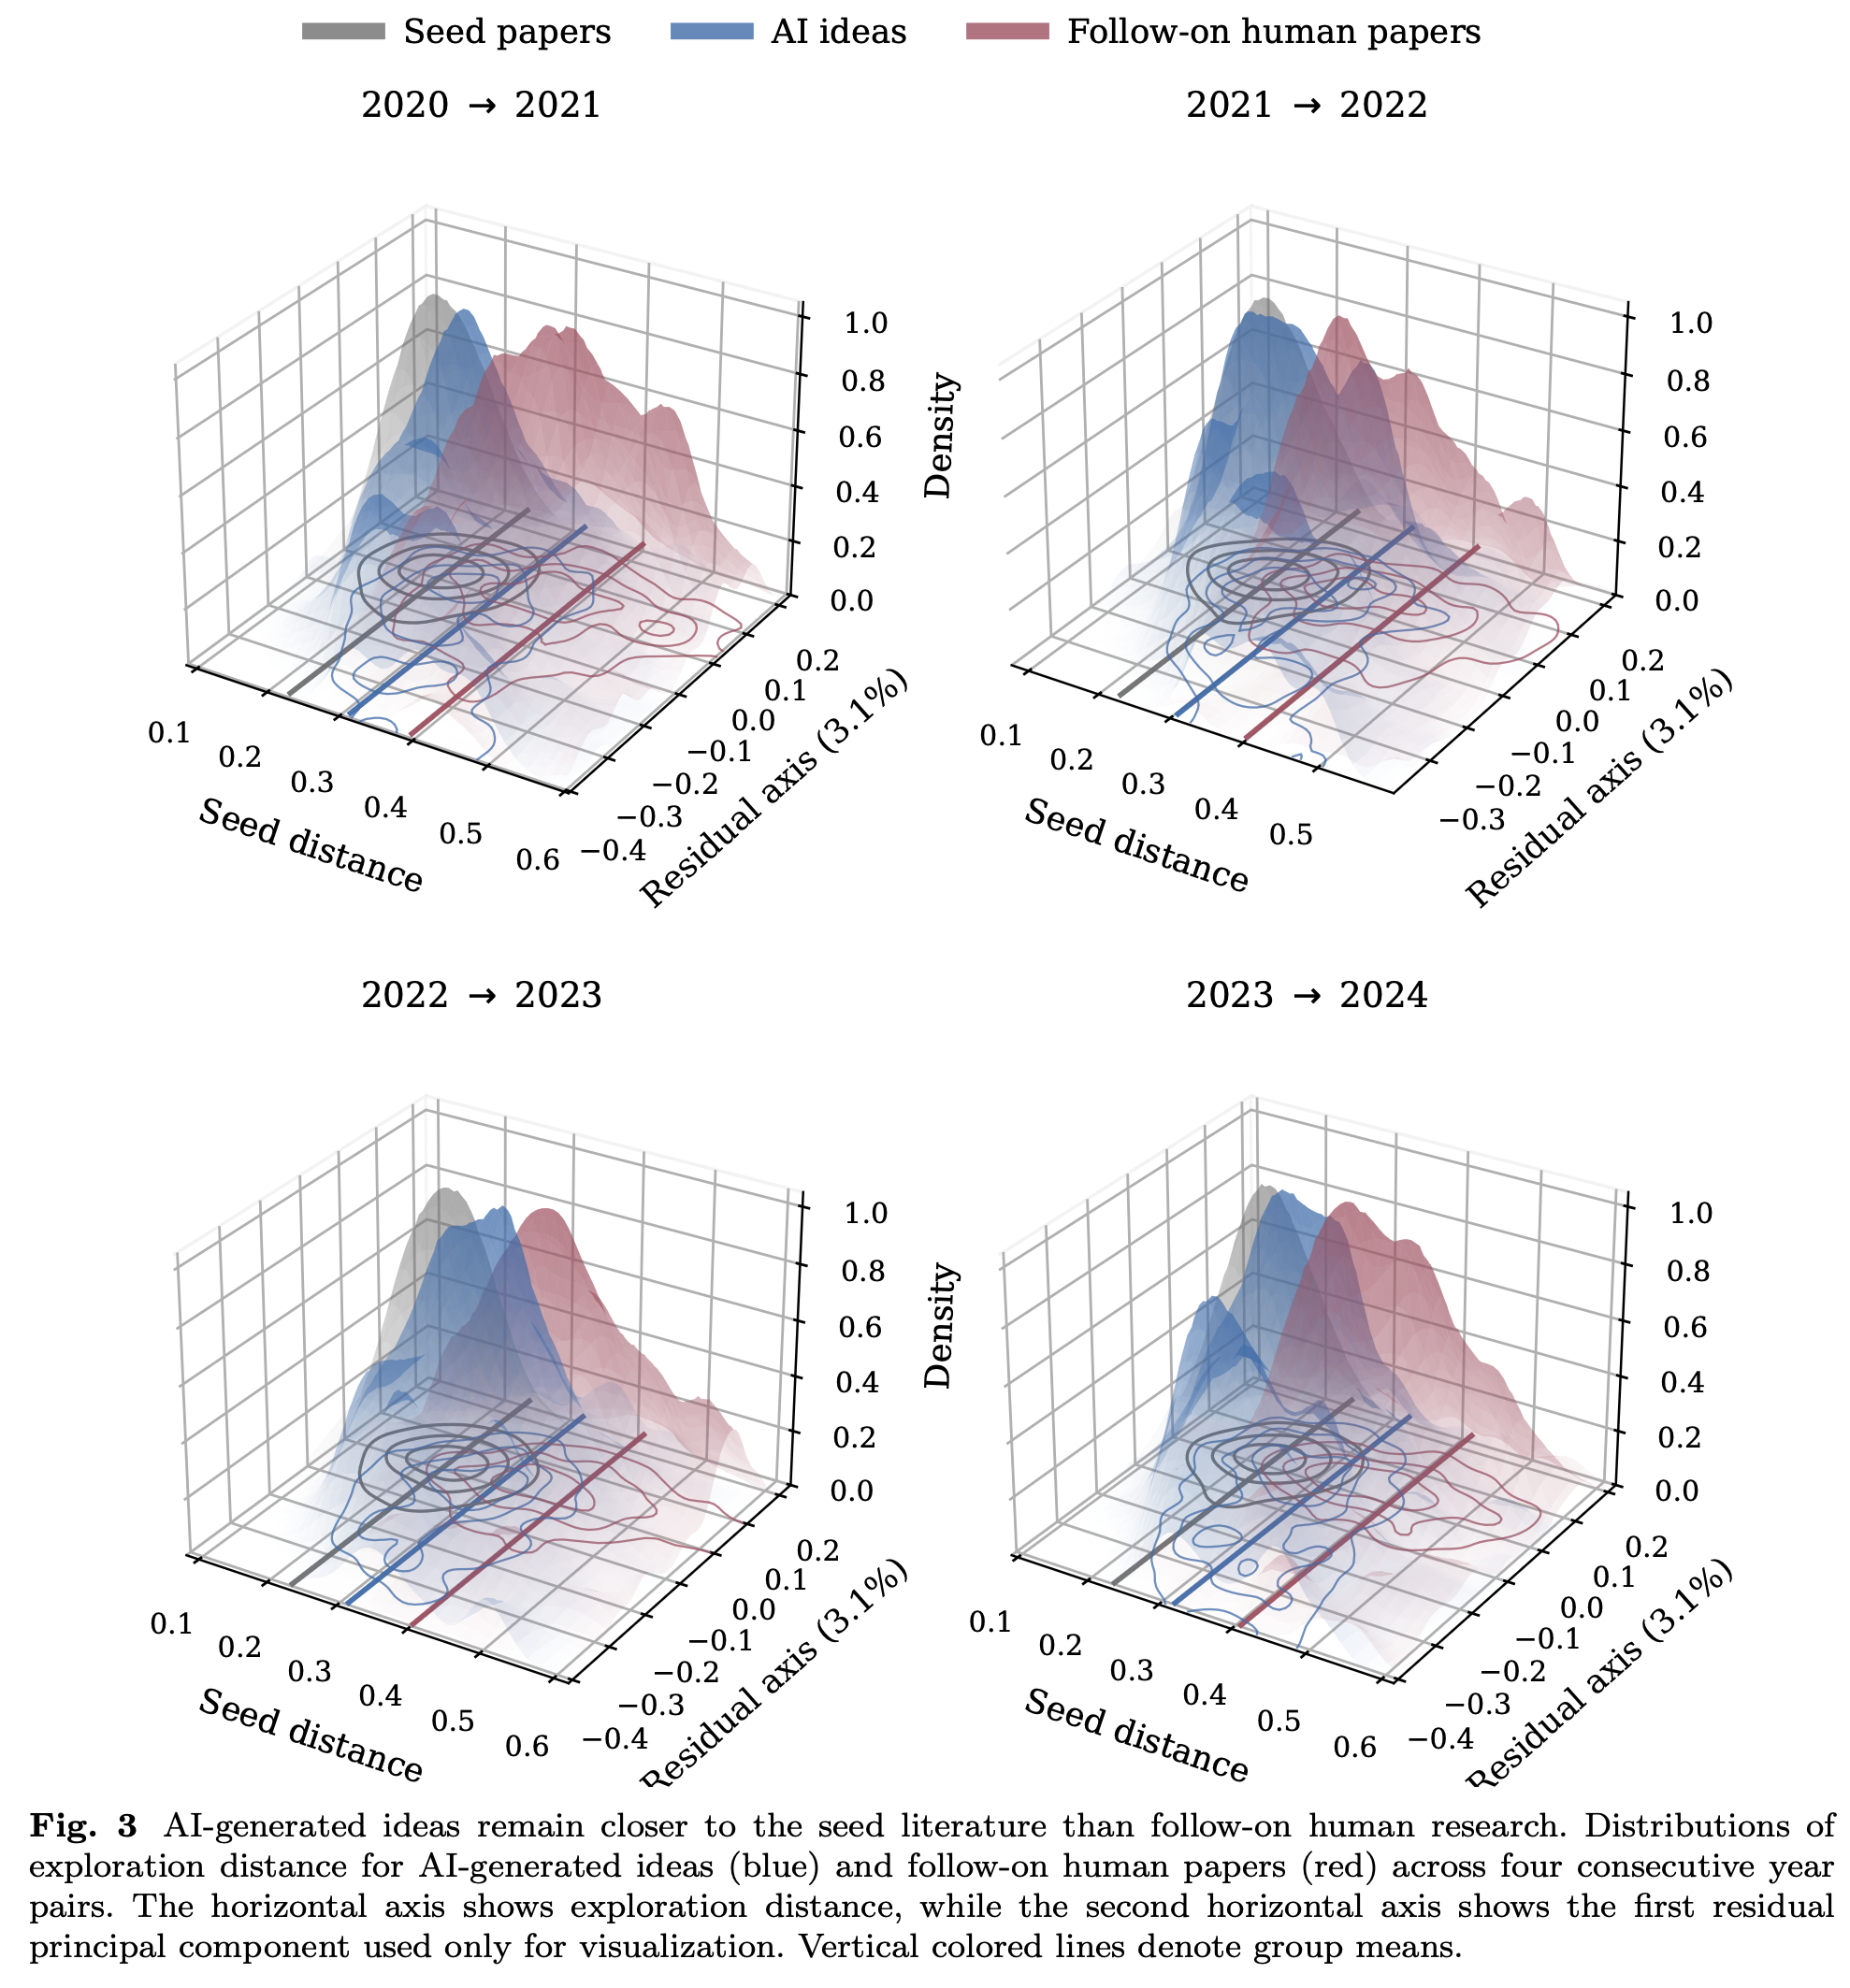
- 지식의 밀집화: AI가 제시한 아이디어들은 인간 연구에 비해 기존 지식 주변에 훨씬 더 빽빽하게 밀집되어 있었습니다.
- 보수적 탐색: 씨앗 문헌(Seed Literature)의 영향권에서 멀리 벗어나지 못하고 주변부만 반복 탐색했습니다.
- 낮은 학술적 영향력: 엄청난 양의 아이디어를 쏟아냈음에도, 실제로 파급력 있는 시도로 이어진 비율은 낮았습니다.
이는 국소 최적화를 잘 하는 도구(Local Optimizer)가 광범위한 과학적 탐색을 잘 하는 도구(Scientific Explorer)는 아니라는 점을 명백히 보여줍니다.
시스템 아키텍처의 세대별 진화 요약
지난 2년간 AI Scientist의 진화는 모델 자체의 단일 성능 향상이 아니라, 에이전트가 유지 관리하는 '연구 상태(Research State)'의 고도화 과정이었습니다.
| 세대 / 대표 연구 | 확장된 핵심 연구 상태 (Core State) | 핵심 전환점 |
|---|---|---|
| 1세대 (The AI Scientist) | 단일 실행 건의 아이디어·코드·실험 | 연구 전 과정의 단순 워크플로우 자동화 |
| 2세대 (AI Scientist-v2) | 연구 브랜치 및 탐색 트리 | 고정 파이프라인에서 탐색 공간 검색으로 전환 |
| 3세대 (DeepScientist) | 후보 가설 + 가치 평가 + 결과 저장소 | 연구 자원 배분을 고려한 베이지안 최적화 |
| 4세대 (EvoScientist) | 프로젝트 간 실패/성공 경험 이력 | 단발성 실행을 넘어선 지속성 메모리 도입 |
| 5세대 (NanoResearch) | 경험 + 사용자의 성향 + 재사용 스킬 | 연구자 맞춤형 정책 적응(Policy Adaptation) |
| 6세대 (AutoSci / Sibyl) | 연구 생애주기 + 가변적 실행 프레임워크 | 메모리 저장을 넘어 시스템 자가 진화(Research OS) |
| 7세대 (EviGraph) | 가설-실험-발견-주장 간 증거 구조 | 논문 생성을 넘어 주장의 논리적 증거 체인 검증 |
차세대 AI Scientist를 위한 7가지 필수 계층
오크리지 내셔널 랩에서 최근 공개한 로드맵 보고서 Toward Trustworthy Autonomous Science 에 수록된 내용 등을 종합할 때, 차세대 자율 과학 시스템은 다음 7가지 계층이 유기적으로 결합되어야 합니다.
- 탐색 계층: 다양성 중심의 가설 생성 및 탐색 트리 확장.
- 자원 할당 계층: 베이지안 최적화를 통한 제한된 실험 자원의 효율적 배분.
- 지속 학습 계층: 실패 경험을 기억하고 이후 행동 방침을 실제로 수정.
- 개인화 계층: 연구자의 성향에 적응하되, 편향 갇힘(Lock-in) 방지 장치 마련.
- 자가발전 하네스: 반복되는 오류 발생 시 에이전트 가드레일 및 워크플로우 자체를 수정.
- 증거 및 출처 추적 계층: 모든 연구 주장의 출처와 데이터 근거 추적성 보장.
- 독립적인 입증 계층: 생성 에이전트와 독립된 검증 에이전트 및 외부 실험계를 통한 교차 검증.
결론: AI Scientist의 궁극적인 KPI 변화
초기 AI Scientist의 평가 기준이 단순히 "논문 한 편을 완성할 수 있는가?"였다면, 앞으로 자율 과학 시스템의 가치를 평가하는 성과 지표(KPI)는 다음과 같은 형태로 바뀌어야 합니다.
단순히 수만 개의 아이디어를 생성하거나 수백 편의 논문을 자동 작성하는 양적 수치는 더 이상 핵심 지표가 될 수 없습니다.
앞으로 AI Scientist 연구의 본질적인 프런티어는 다음 두 가지 질문으로 집약될 것입니다.
- 기존 문헌의 주변부를 벗어나 어떻게 진짜 새로운 과학적 질문을 발견할 것인가?
- AI가 도출한 주장이 참이라는 것을 어떻게 독립적이고 객적으로 검증할 것인가?
결국 AI Scientist의 진화는 '논문을 대신 써주는 AI'에서, '경험을 축적하고, 탐색 전략을 스스로 교정하며, 연구자에게 적응하고, 자신의 주장에 대해 명확한 증거를 제시하는 신뢰할 수 있는 과학적 발견 시스템'으로 나아가고 있습니다.