BO는 매번 처음부터 시작해야 할까?
반도체 공정을 위한 전이 학습 베이지안 최적화
이전 공정 캠페인에서 축적된 데이터를 신규 공정 개발에 재활용한다면, 베이지안 최적화의 콜드 스타트(Cold Start) 구간을 얼마나 단축할 수 있을까요? 본 글에서는 Multi-task GP 기반의 공유 표현(Shared Representation) 학습부터 실제 화학 반응 실험, 그리고 부정적 전이(Negative Transfer)에 관한 연구까지 이어지는 흐름을 살펴보고, 이를 반도체 공정에 최적화한 연구 설계로 이어 보았습니다.
한 캠페인에서 끝나는 BO는 아쉽습니다
반도체 공정 개발은 대표적인 '고비용 블랙박스 최적화' 문제입니다. 온도, 압력, 가스 유량, RF 파워, 시간 등 조절 변수는 다양하지만, 이 변수들이 박막 두께, 균일도, 저항, 결함 밀도, 응력, 박막 품질, 에칭 선택비 등에 미치는 영향을 명확한 수식으로 나타내기는 불가능에 가깝습니다. 더욱이 실험마다 장비 사용료, 웨이퍼, 소재 비용 뿐 아니라 결과 평가 과정에서 계측비도 발생하며, 부적절한 조건으로 실험할 경우 장비 오염이나 안전 문제로 이어질 위험도 큽니다.
이런 상황에서 베이지안 최적화(BO)는 훌륭한 해결책이 됩니다. 현재까지 누적된 데이터를 바탕으로 대리 모델을 만들고, 예측값의 평균과 불확실성을 활용해 최적의 다음 실험 조건을 제안하기 때문입니다. 이미 ALD, CVD, 스퍼터링 등 여러 박막 공정에서 BO의 유용성이 입증되고 있으며, CVD 성장, Mo 박막의 스트레스·면저항 최적화 등에 적용된 사례도 보고된 바 있습니다. [1] [2]
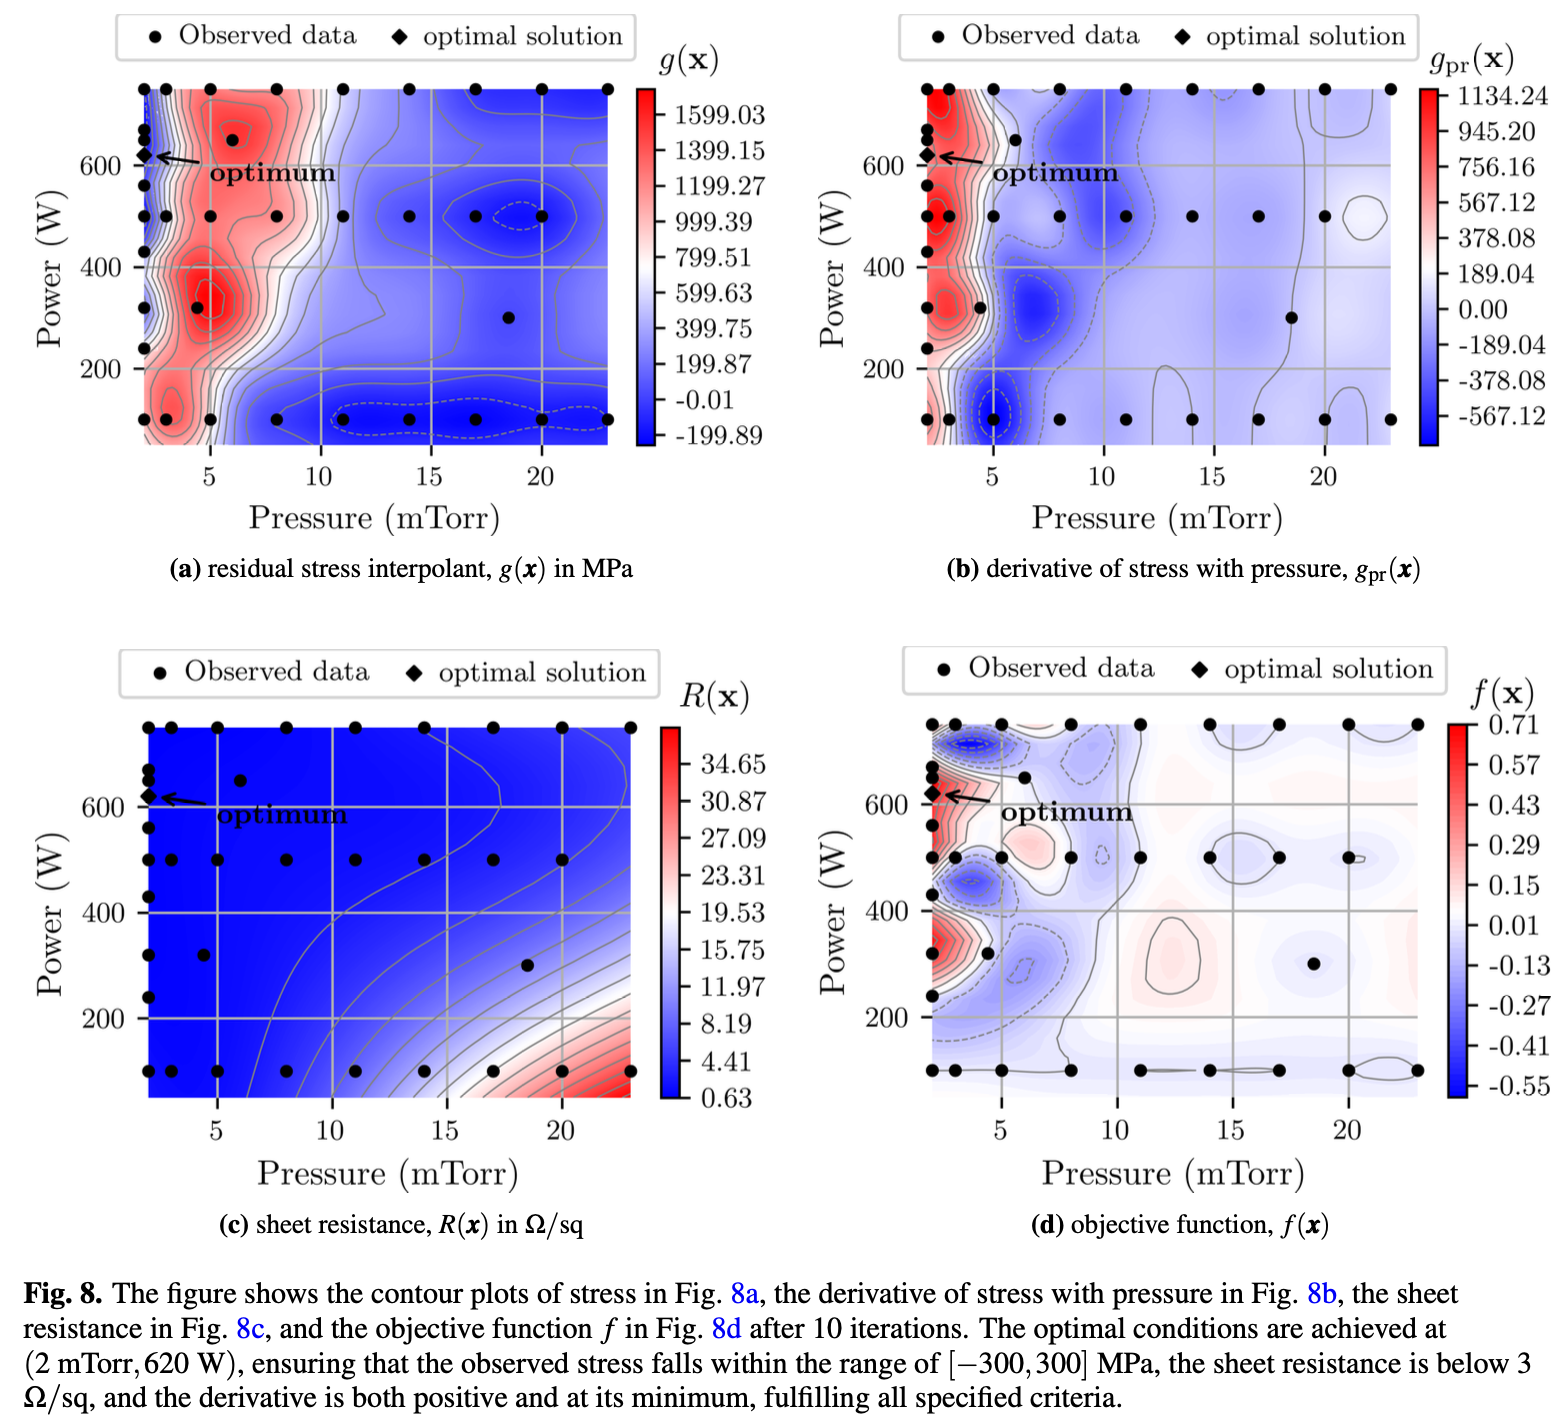
10회 반복 뒤 얻은 Mo 스퍼터링의 응력·민감도·면저항·통합 목적함수 지도. 별표는 선택된 최적 조건을 나타냅니다. 출처: [2] Fig. 8.
그러나 표준적인 베이지안 최적화(BO)에는 명확한 효율상의 한계가 존재합니다. 기판(Substrate), 전구체(Precursor), 챔버(Chamber), 혹은 목표 박막이 바뀔 때마다 기존 모델을 활용하지 못하고 매번 처음부터 학습을 다시 시작하는 경우(Cold Start)가 많기 때문입니다.
하지만 실제 반도체 공정 개발 현장은 그렇게 단절되어 있지 않습니다.
- 동일한 장비에서 유기적으로 유사한 박막을 지속해서 개발합니다.
- 전구체가 변경되더라도, 온도나 도즈 변화에 따른 화학적 반응성에는 공통적인 메커니즘이 존재할 수 있습니다.
- 챔버가 교체되어도 이전 장비에서 확보한 포화 경향성이나 공정 마진이 완전히 무용지물이 되지는 않습니다.
- 나아가 파일럿 장비와 양산 장비, 조각 샘플과 풀 웨이퍼, 그리고 시뮬레이션과 실제 실험 사이에도 분명한 상관관계가 존재합니다.
그렇다면 질문은 자연스럽게 다음 단계로 확장됩니다.
이전 공정 캠페인에서 축적된 지식을 새로운 캠페인의 베이지안 최적화에 전이할 수 있을까?
이것이 바로 이종(異種) 작업 간 전이 학습(Cross-task Transfer Learning)을 베이지안 최적화에 접목하고자 하는 핵심 연구 주제입니다.
전이 학습을 BO의 언어로 이해하기
전이 학습은 데이터가 풍부한 소스 작업에서 학습한 지식을, 데이터가 부족한 타깃 작업에 재사용하여 학습 효율을 극대화하는 방법입니다.
컴퓨터 비전 분야에서 이미지넷으로 사전 학습된 특징 추출 능력을 의료 영상 분석에 적용하는 것이 대표적인 예시입니다. 다만 베이지안 최적화에서의 전이 학습은 모델의 분류 정확도를 높이는 것이 아니라, 최소한의 실험 횟수로 최적점을 찾아내는 것을 최종 목표로 삼습니다.
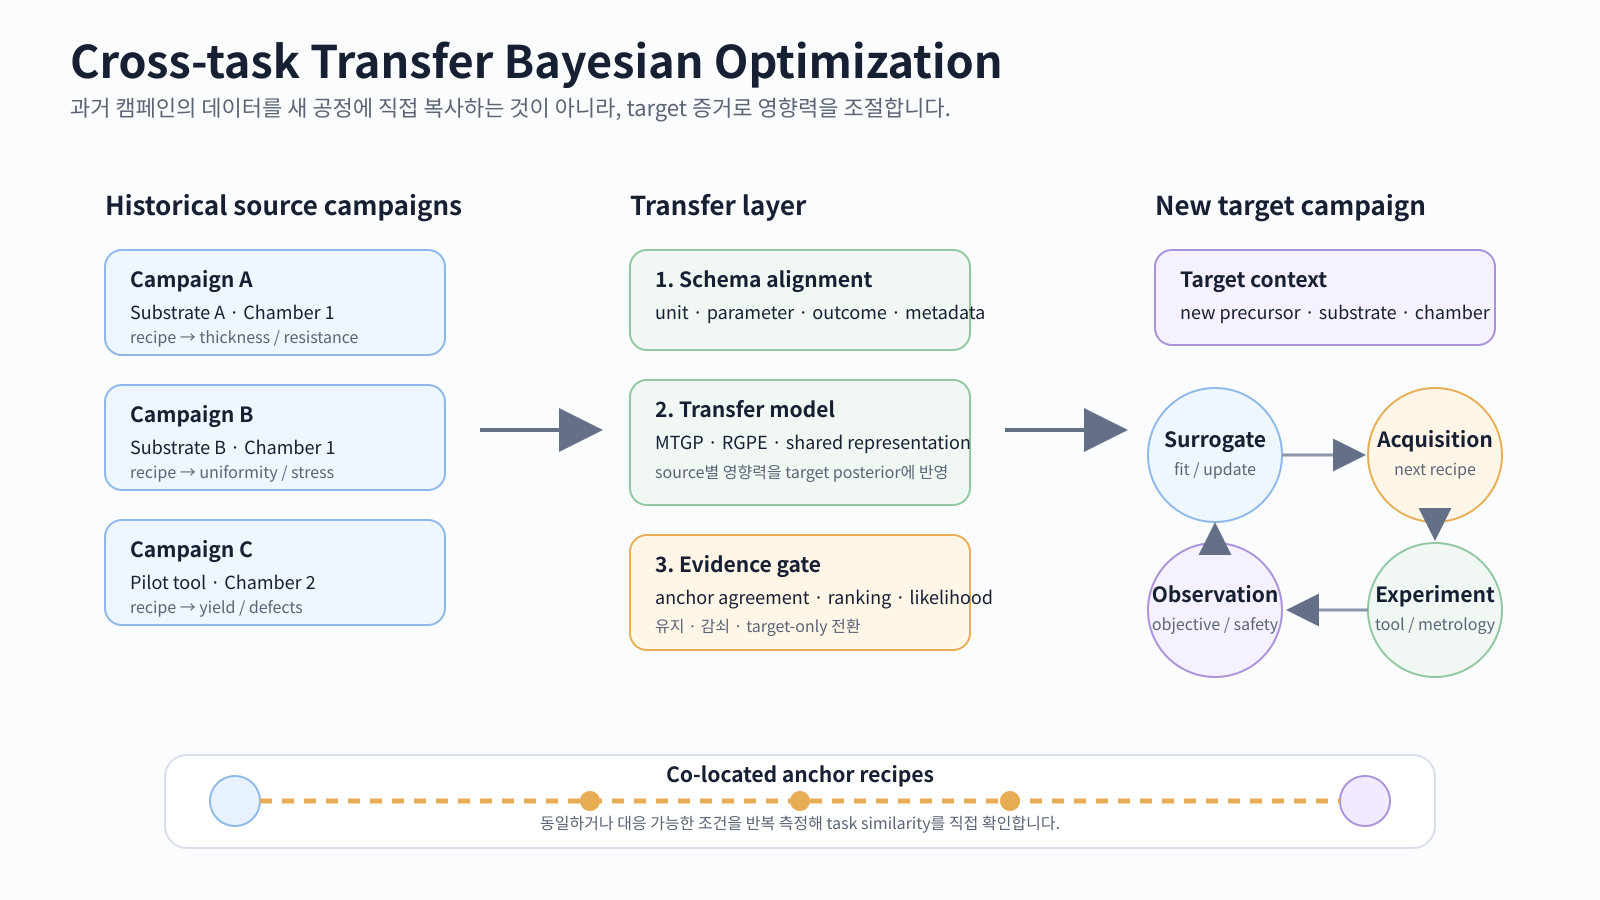
이를 도식화하면 다음과 같습니다.
여기서 소스 작업은 과거에 진행했던 특정 전구체–기판–챔버 조합의 공정 데이터가 될 수 있으며, 타깃 작업은 새롭게 최적화하려는 조합이 됩니다. 각 작업은 서로 다른 목적함수 를 가지지만, 기저에 흐르는 물리·화학적 구조의 일부를 공유한다고 가정합니다.
여기서 이종 작업 간 전이(Cross-task transfer)와 다중 충실도(Multi-fidelity) BO의 차이를 명확히 구분하는 것이 중요합니다.
| 구분 | Cross-task transfer BO | Multi-fidelity BO |
|---|---|---|
| 주요 차이점 | 캠페인·물질·장비·제품의 변경 | 계산·측정의 정확도(정밀도)와 비용의 차이 |
| 소스 예시 | 이전 기판 기반의 공정 데이터 | 저해상도 시뮬레이션, 간이 계측 데이터 |
| 타깃 예시 | 새로운 기판 기반의 신규 공정 최적화 | 고정밀 시뮬레이션, 실제 웨이퍼 평가 데이터 |
| 최적화 중 소스 추가 평가 | 보통 과거 데이터로 고정 (추가 불가) | 충실도를 선택하여 실시간 추가 평가 가능 |
| 핵심 연구 과제 | 작업 간 유사도 측정 및 네거티브 전이 방지 | 충실도 간 상관관계 파악 및 지원(비용) 배분 최적화 |
둘은 수식적으로 닮아있지만 연구 방향성은 전혀 다릅니다. 이전 캠페인의 수치 데이터를 새 캠페인에 활용하는 것은 '공정 간 전이'이며, 같은 레시피를 서로 다른 정확도로 평가하는 것은 '다중 충실도'입니다.
BO에서는 무엇을 이전할 수 있을까
전이 BO 서베이 연구에 따르면, 전이 대상을 크게 네 가지 유형으로 분류할 수 있습니다. [3]
- 초기점 전이: 과거 캠페인에서 발굴한 우수 조건을 새로운 캠페인의 웜 스타트 포인트로 재활용합니다.
- 탐색 공간 전이: 과거에 유망했던 최적화 범위를 우선 탐색하거나, 효과가 없었던 영역을 사전에 배제하여 탐색 효율을 높입니다.
- 대리 모델 전이: 과거 작업과 타깃 작업을 연계하여 함께 모델링하거나, 공통 표현 및 GP 사전 분포를 학습합니다.
- 획득 정책 전이: 다양한 작업을 거치며 다음 실험 조건을 최적화하는 규칙(획득 정책; acquisition policy) 자체를 메타 학습(Meta-learning) 형태로 습득합니다.
이 중 반도체 공정 데이터에 가장 직접적이고 효과적인 접근법은 대리 모델 전이(Surrogate transfer)입니다. 다만 단순히 과거 데이터를 모두 결합하는 단순한 방식부터 다중 작업 가우시안 프로세스(Multi-task GP), 소스 모델 앙상블(Source model ensemble), 공유 신경망 표현(Shared neural representation)에 이르기까지 아키텍처 설계의 선택지가 매우 다양합니다.
출발점: Multi-task Gaussian Process
이종 작업 간 전이 BO의 고전적 기원은 Swersky 등의 2013년 논문 Multi-Task Bayesian Optimization입니다. 연구진은 이전의 하이퍼파라미터 최적화 경험을 새 데이터셋 최적화에 재활용하기 위해 Multi-Task GP(MTGP)라는 방법론을 제시했습니다. 나아가 비용 민감형 다중 작업 설정으로 엔트로피 탐색(entropy search)을 확장하여, 최소 비용으로 목표 작업의 최적점 정보를 가장 많이 얻을 수 있는 탐색 경로를 다루었습니다. [4]
가장 단순한 형태의 MTGP 커널은 다음과 같이 이해할 수 있습니다.
- : 공정 레시피 조건 간의 유사도
- : 작업 와 사이의 공분산
- 소스와 타깃의 연관성이 높게 학습될수록, 소스 데이터가 타깃 사후 분포 확정에 미치는 영향이 커집니다.
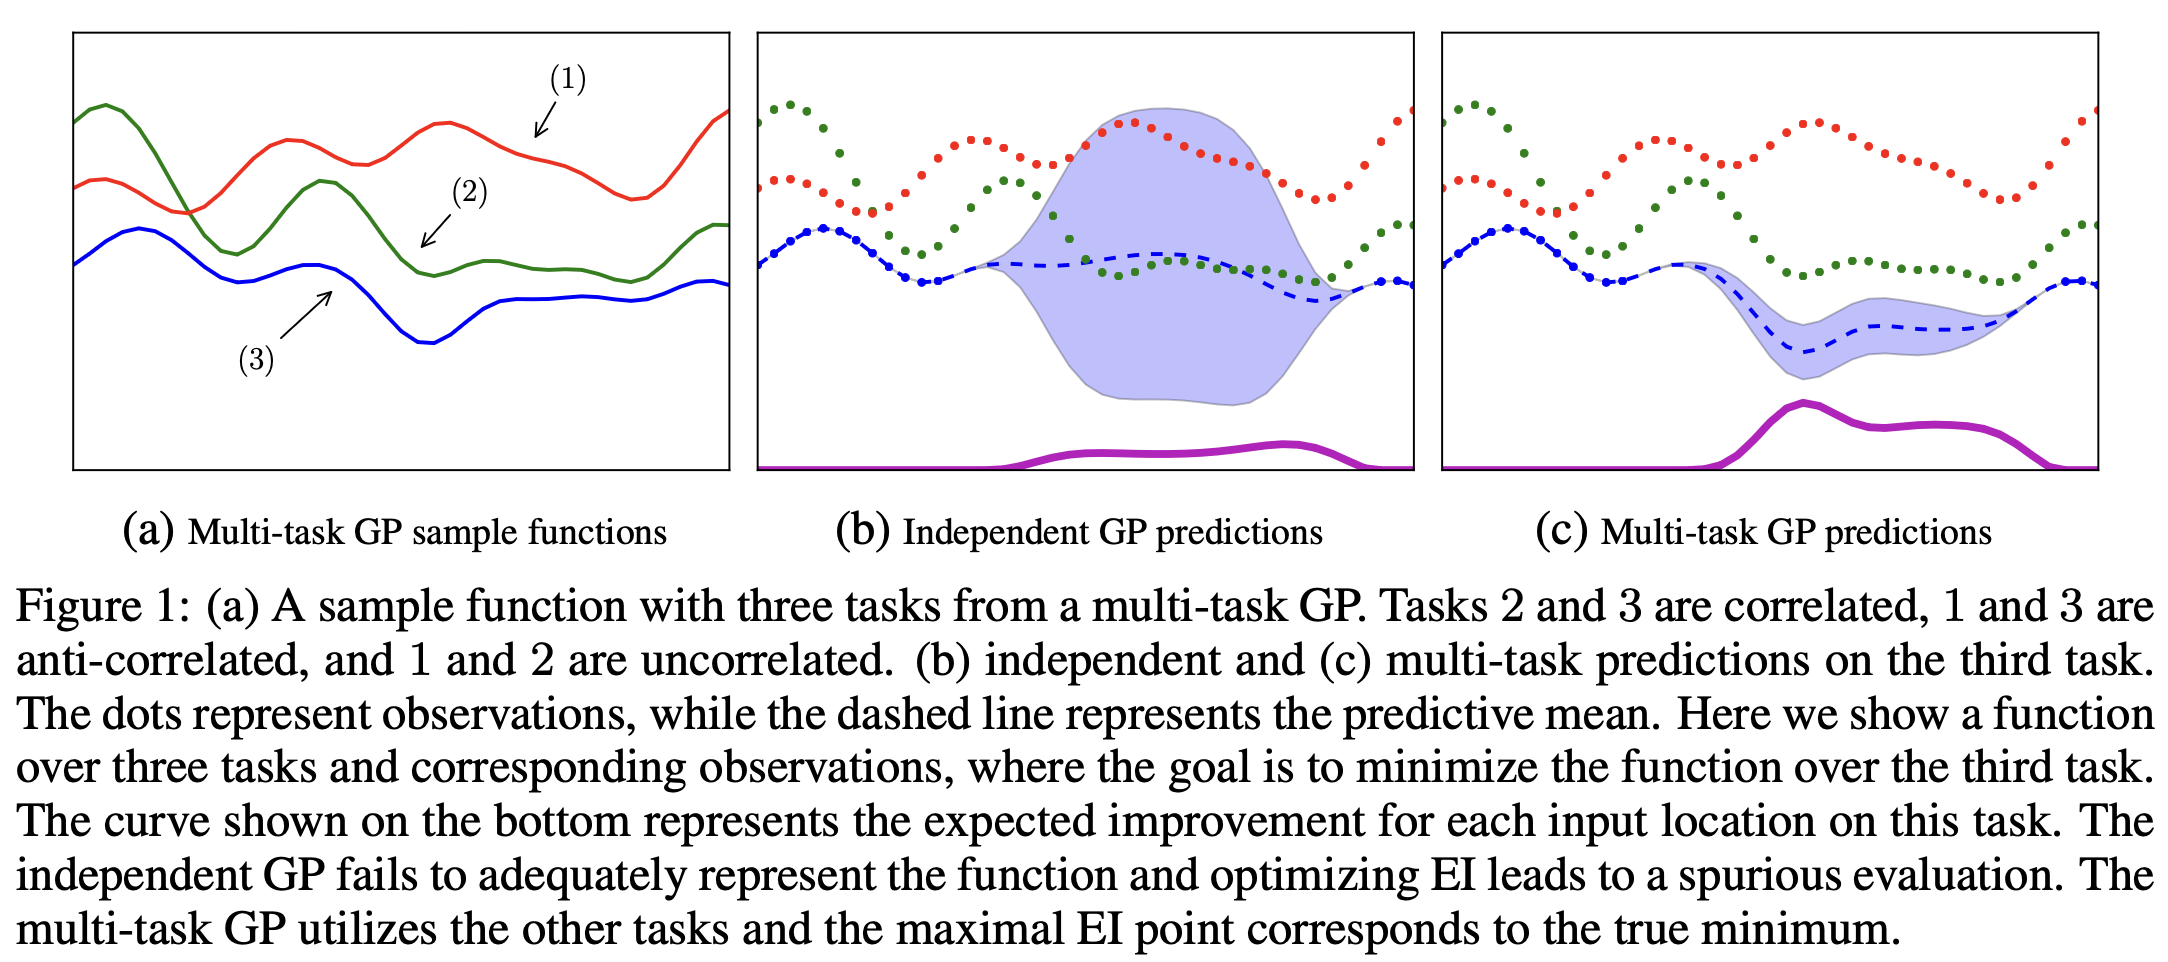
MTGP를 사용하지 않은 경우와 사용한 경우의 차이를 보여주는 그림. 출처: [4]
반도체 공정 맥락에서 입력 는 온도, 압력, 유량, 시간이며, 작업 인덱스 는 기판, 전구체, 챔버, 또는 제품 세대에 대응합니다.
이 방법의 매력은 GP의 불확실성 추정 성능을 유지하면서 작업 간 연관성을 데이터로 직접 학습할 수 있다는 점입니다. 하지만 전체 관측치를 하나의 Joint GP에 집어넣으면 계산 부하가 커지며, 작업 상관관계를 오판할 경우 과거 데이터가 타깃 모델을 왜곡할 위험이 있습니다.
이 문제를 피하고자 소스별 GP를 개별 학습한 후 타깃 순위 적합도에 따라 가중치를 매기는 RGPE(순위 가중치 GP 앙상블), 소스-타깃 차이를 계층 구조로 다루는 계층 구조형 GP, GP 사전 분포 자체를 메타 학습하는 방식들이 등장했습니다. Tighineanu 연구진은 이들을 비교 정리하며, Joint 모델은 불확실성 전달이 엄밀하지만 계산 비용이 크고, 독립 소스 앙상블은 확장성이 뛰어나지만 불확실성 전파가 완전한 베이지안 형태는 아니라는 상충 관계를 짚어냈습니다. [5]
이 시점에서의 첫 번째 교훈은 다음과 같이 요약할 수 있습니다.
전이 BO는 과거 데이터를 얼마나 쏟아붓느냐의 문제가 아니라, 타깃 증거에 맞춰 소스의 개입 정도를 얼마나 정교하게 제어하느냐의 문제입니다.
핵심 논문 1: Perrone et al. - task별 모델보다 공유 표현을 학습합니다
2018년 아마존의 Perrone 등이 발표한 Scalable Hyperparameter Transfer Learning은 GP의 확장성 문제를 새로운 방향에서 해결했습니다. [6]
이 방법론은 모든 작업이 하나의 심층 신경망 특징 맵(Deep neural network feature map) 을 공유하도록 구성하고, 그 상위에 작업별 베이지안 선형 회귀(Bayesian Linear Regression, BLR) 헤드를 배치하는 구조입니다.
- 공유 신경망: 여러 작업에 걸쳐 공통으로 적용되는 탐색 공간 표현(Search-space representation)을 학습합니다.
- 작업별 BLR 헤드: 각 작업의 고유한 스케일(Scale), 노이즈(Noise), 출력 관계를 전담합니다.
- BLR 가중치(Weight): 대수적 적분이 가능하므로, 예측 평균뿐만 아니라 획득 함수 계산에 필수적인 불확실성까지 함께 도출할 수 있습니다.
전통적인 MTGP가 작업 간 공분산을 직접 학습하는 방식이라면, 이 기법은 여러 작업에서 공통으로 유용하게 작용하는 입력 특징(input feature)이 무엇인가를 학습합니다. 계산 복잡도 역시 관측 데이터 수에 비례해 선형적으로 스케일링되며, 연구진은 기존 벤치마크 방법론 대비 최소 한 자릿수 이상 빠른 연산 속도를 보고했습니다.
이 논문에서 배운 점
첫째, 전이의 대상이 단순한 관측값이나 작업 간 상관관계에만 국한되지 않는다는 점입니다. 여러 캠페인에서 반복적으로 나타나는 비선형적 물리·화학 구조 자체를 '공유 표현' 형태로 학습할 수 있습니다.
둘째, 공유 표현(Shared representation)과 작업별 적응(Task-specific adaptation)을 분리하는 아키텍처는 실제 공정 환경에도 매우 자연스럽게 부합합니다. 예를 들어, 공유 네트워크는 도즈 × 사이클, 온도, 압력 간의 복잡한 상호작용을 학습하고, 작업별 헤드는 장비나 기판에 따른 고유한 바이어스를 흡수하는 형태로 설계할 수 있습니다.
셋째, 누적되는 과거 데이터의 규모가 커질수록, 모든 데이터를 단일 GP에 집어넣는 방식보다 확장성 측면에서 훨씬 유리합니다.
비판적으로 볼 부분
이 연구에서 다룬 실험 대상은 주로 머신러닝의 하이퍼파라미터 최적화(HPO)에 편향되어 있습니다. 이는 입력 변수의 의미가 작업마다 명확히 일치하고, 다수의 과거 작업과 방대한 관측치가 이미 확보된 환경입니다. 반면 실제 반도체 공정에서는 누적된 캠페인이 단 몇 개에 불과할 수 있으며, 변수의 정의 자체가 바뀔 수도 있습니다. 새로운 전구체 캠페인이 시작되면 기존에 없던 캐니스터 온도 같은 독립 변수가 추가되거나 할 수도 있습니다.
또한, 공유 표현 방식은 소스 작업의 수와 다양성이 충분하지 않으면 쉽게 과적합될 위험이 있습니다. 모델의 복잡도가 높은 만큼, 이것이 전이 학습의 실질적인 효과인지 아니면 단순히 모델 용량이 커지면서 얻을 수 있는 이점에서 온 것인지 구분하기 어렵다는 한계도 있습니다. 따라서 실제 공정 적용 시에는 타깃 데이터만 사용한 MLP 및 소스 데이터로 사전 학습을 거친 MLP 등과의 다각적인 비교 검증이 필수적입니다.
FSBO(Few-Shot Bayesian Optimization)는 이 아이디어를 딥 커널 GP(Deep Kernel GP)로 발전시켜 여러 작업에서 커널 표현을 메타 학습하고, 신규 작업에 대해 몇 번의 실험만으로 적응(Few-shot adaptation)하는 방식을 제안한 바 있습니다. [7] 그러나 Perrone 방식과 FSBO 모두 '비교 가능한 다수의 과거 작업이 존재한다'는 전제 조건이 충족될 때 강력한 성능을 발휘하는 방법론입니다. 만약 확보된 과거 캠페인 수가 너무 적다면, 오히려 더 단순한 형태의 GP 전이 방식이 안정적일 수 있습니다.
핵심 논문 2: Taylor et al. - 실제 화학 반응 캠페인 데이터도 전이할 수 있음을 증명했습니다
2023년 Taylor 등이 발표한 Accelerated Chemical Reaction Optimization Using Multi-Task Learning은 전이 베이지안 최적화(Transfer BO)를 실제 자동화 실험 환경에 적용하여 유효성을 입증한 대표적인 사례입니다. [8]
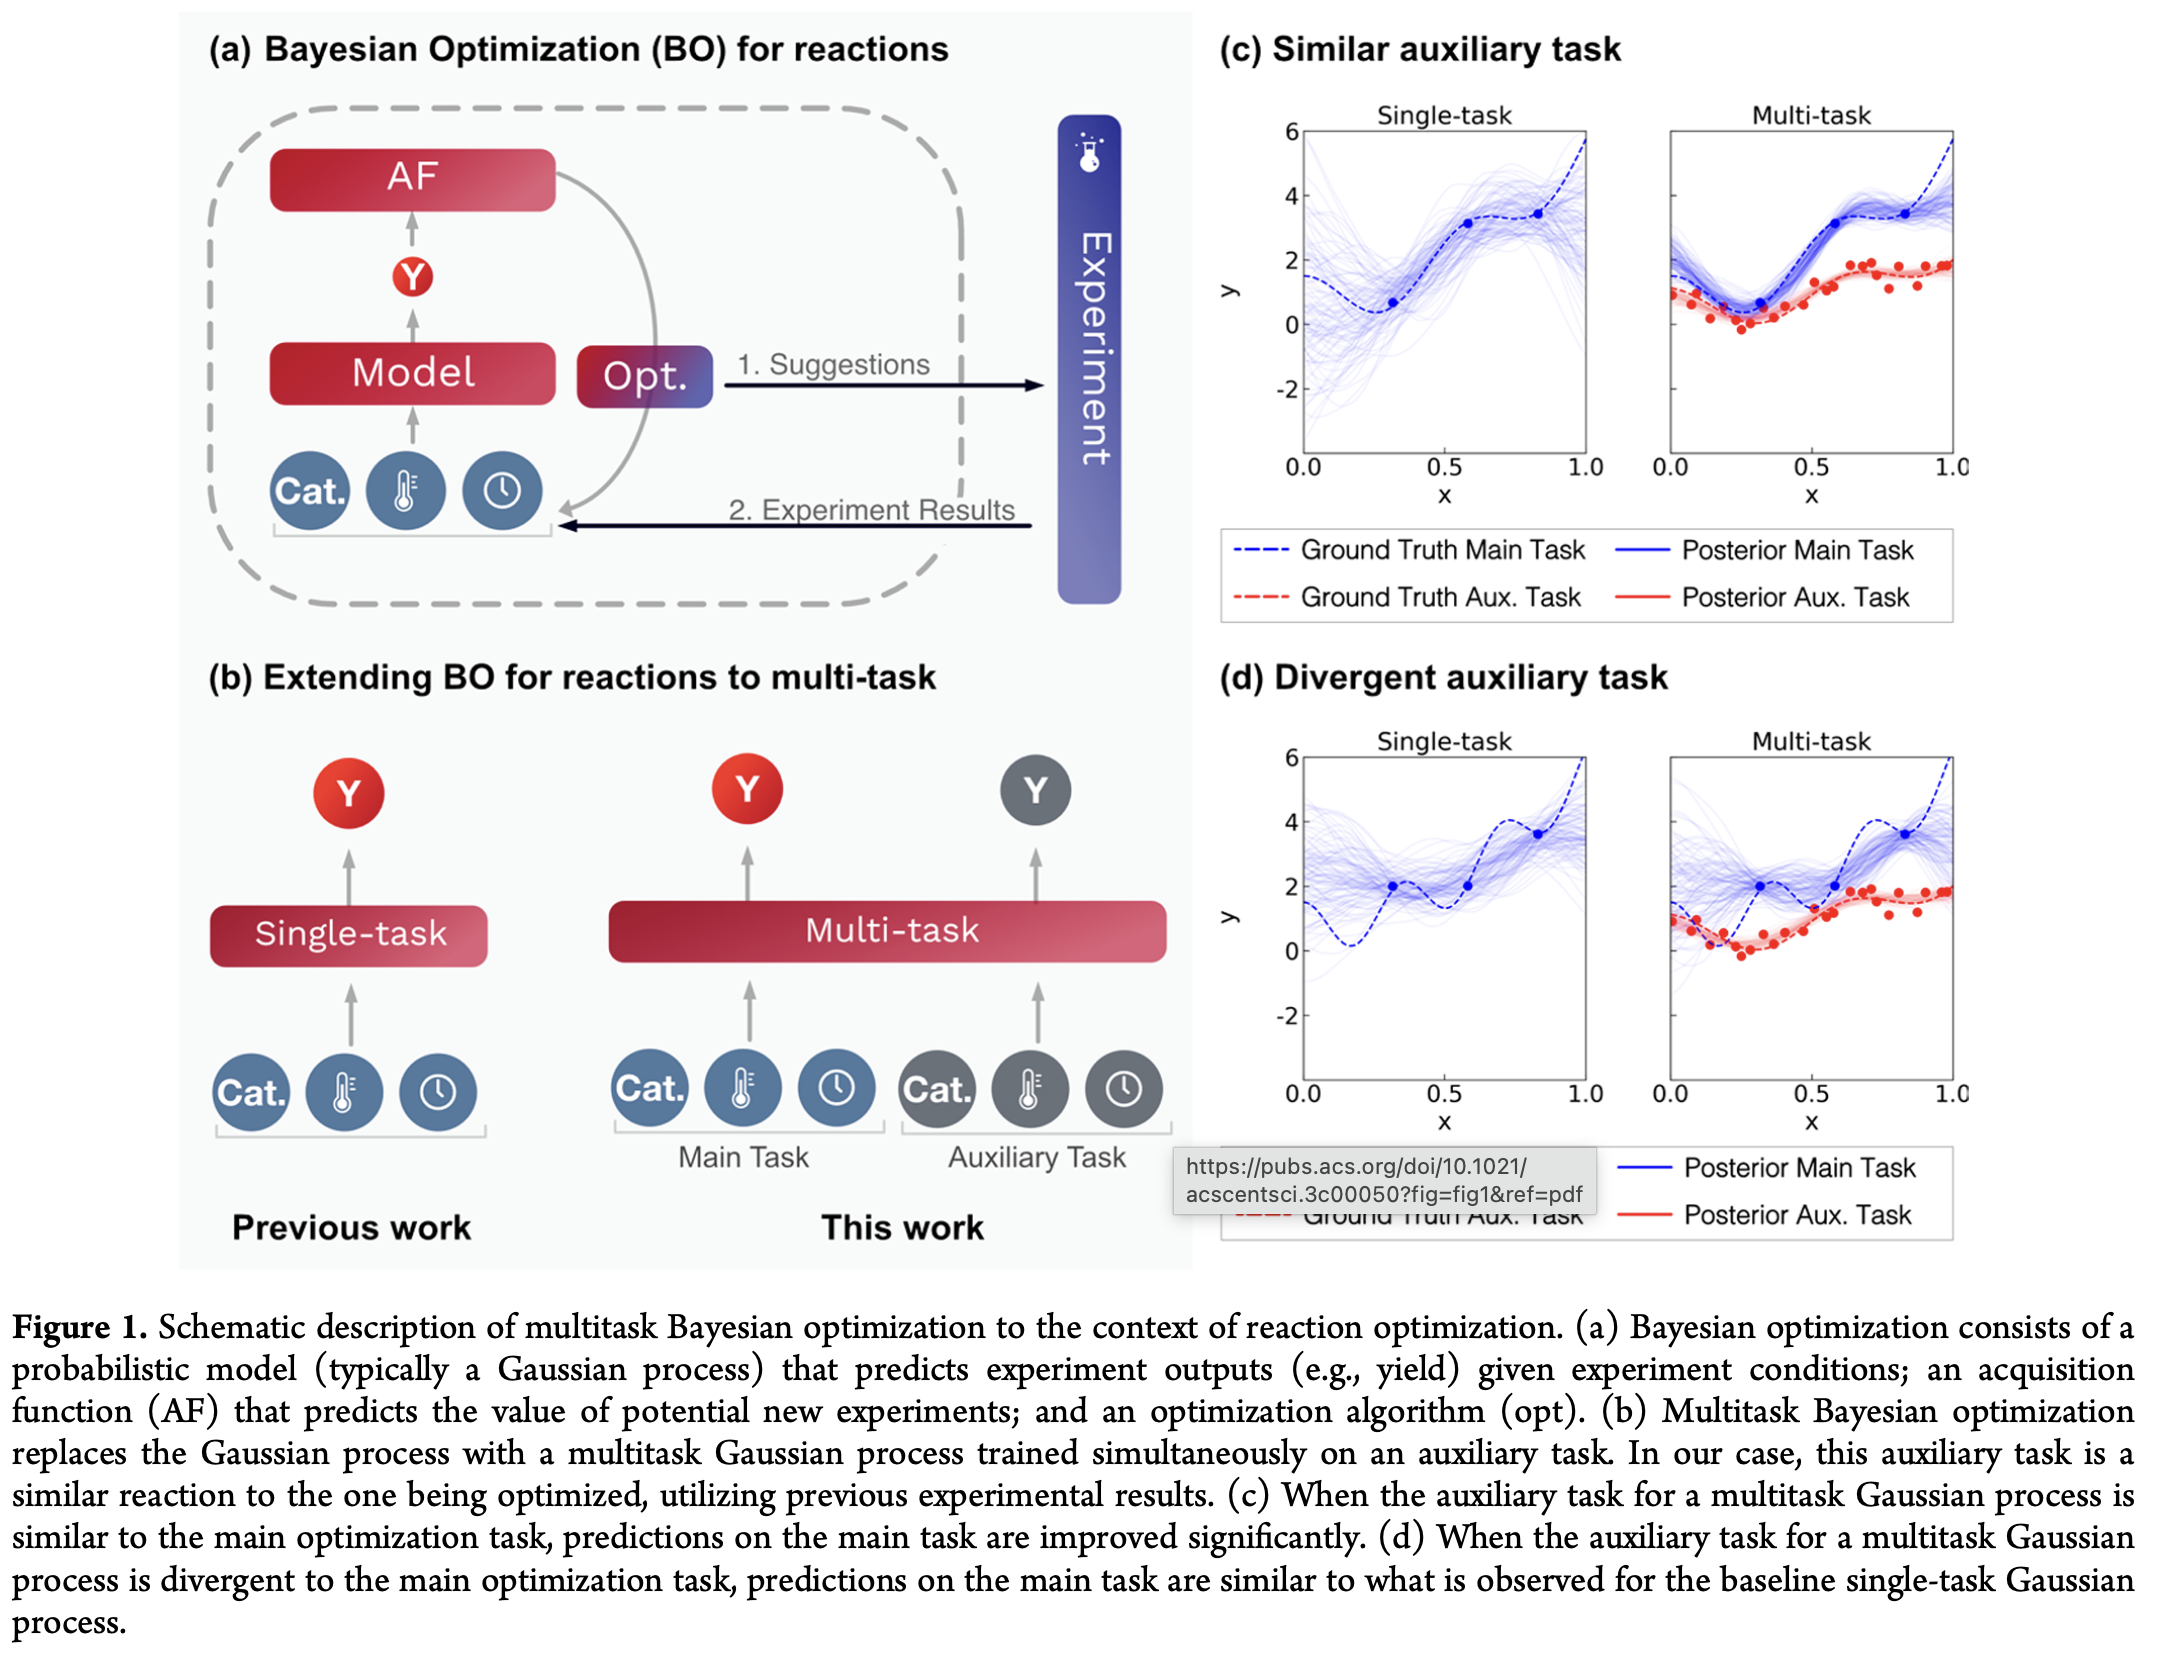
연구진은 먼저 스즈키-미야우라 결합(Suzuki–Miyaura coupling) 및 C–N 결합 반응 데이터를 활용해 컴퓨터 시뮬레이션 검증을 수행했습니다. 이어 자율 흐름 반응기(Autonomous flow reactor)를 구축하고, 기판 구조가 각기 다른 C–H 활성화 반응을 순차적으로 최적화했습니다. 첫 번째 반응은 단일 작업 BO로 최적화를 진행한 뒤, 후속 반응 최적화 시에는 이전 반응에서 확보한 데이터를 다중 작업 BO(MTBO)의 소스 작업으로 활용했습니다. 실제 실험 환경에는 연속형 변수와 범주형 변수가 복합적으로 포함되었습니다.
해당 연구는 학습 데이터에 존재하지 않았던 미지의 반응에서 최적 조건을 탐색하는 데 MTBO가 매우 유효함을 증명했으며, 산업 표준 공정 최적화 방식 대비 최대 98%의 비용 절감 가능성이 있음을 제시했습니다.
이 논문이 갖는 의미
이 연구는 단순히 "과거 작업들이 유사해 보인다"는 식의 소급적 벤치마크에 머물지 않았습니다. 실제 자율 흐름 반응기 장비와 신규 기판을 이용해 폐루프 최적화를 성공적으로 구현했다는 점에서, 반도체 공정 연구에 주는 시사점이 매우 큽니다.
화학 반응 연구와 반도체 공정 연구의 구성 요소를 대조하면 다음과 같습니다.
| 화학 반응 연구 | 반도체 공정 연구 |
|---|---|
| 서로 다른 기판의 반응 | 서로 다른 기판·전구체·막 조성 |
| 온도, 체류 시간, 시약 | 온도, 압력, 펄스, 퍼지, RF 파워 |
| 반응 수율 | 박막 두께, 균일도, 면저항, 결함 밀도, 잔류 응력 |
| 자율 흐름 반응기 | 자동화된 ALD·CVD·PVD 공정 장비 |
| 이전 반응 캠페인 | 이전 공정 개발 캠페인 |
비판적으로 볼 부분
"최대 98% 절감"이라는 수치는 대단히 인상적이지만, 이를 모든 공정에 일반화할 수 있는 보편적 수치로 해석해서는 안 됩니다. 특정 반응군, 특정 비용 계산 모델, 그리고 비교 기준에 따라 산출된 최선의 시나리오이기 때문입니다. 아울러 활용된 소스 데이터가 타깃 최적화에 긍정적인 영향만 미친 매우 우호적인 조건이었다는 점도 감안해야 합니다.
또한, 실험 캠페인이 순차적으로 진행된 특성상, 초기 소스와 후속 타깃 사이의 어떤 유사성 요인이 실질적인 성능 향상을 이끌어냈는지 명확히 분리해내기 어렵습니다. 즉, 기판 디스크립터를 통한 일반화 덕분인지, 작업 인덱스를 기반으로 한 상관관계 학습의 결과인지, 혹은 단순히 최적 탐색 영역이 서로 유사했던 것인지에 대해서는 추가적인 소거 실험(ablation)이 필요합니다.
그럼에도 불구하고 이 연구는 전이 BO가 단순한 'HPO 벤치마크용 알고리즘'에 그치지 않고, 실제 물리적 실험 자원을 획기적으로 절감할 수 있는 실용적 도구임을 입증했다는 점에서 큰 의의가 있습니다.
핵심 논문 3: Chen et al. - 단순한 과거 데이터 재사용이 의외로 강력할 수 있습니다
2026년 7월 공개된 Chen 등의 프리프린트 Robust Transfer Learning for Bayesian Optimization of Chemical Reactions는 화학 반응 최적화에서의 탐색 공간 확장 문제를 정면으로 다룹니다. 이 연구는 새로운 기판, 리간드, 촉매 혹은 목적함수가 추가되는 상황에서 과거 캠페인 데이터를 어떻게 재활용하는 것이 최적인지를 다각도로 비교했습니다. [9]
이 논문에서 강조하는 핵심 결과는 크게 세 가지입니다.
첫째, 단순히 전이 전략 자체만 비교해서는 안 됩니다. 가우시안 프로세스(GP)의 하이퍼프라이어(Hyperprior)가 하위 표현 공간의 차원에 맞게 올바르게 설정되어 있는지에 따라 성능이 크게 좌우됩니다. 특히 고차원 잠재 공간의 분자 표현(Molecular representation)을 기존의 표준 GP 사전 분포와 결합할 경우, 표현력 자체의 문제라기보다는 부적절한 길이 스케일 사전 분포로 인해 성능이 저하될 수 있습니다.
둘째, 소스와 타깃 작업 간의 유사도가 충분히 높은 벤치마크 환경에서는 과거의 관측 데이터를 직접 결합하여 재사용하는 단순한 접근법이 의외로 뛰어난 성능을 보였습니다. 즉, 모든 상황에서 반드시 복잡한 전이 모델이 필요한 것은 아니었습니다.
셋째, 소스와 타깃 간의 차이가 커지는 스트레스 테스트 환경에서는 동일한 단순 재사용 방식이 오히려 부정적 전이(Negative transfer)를 유발했습니다. 이를 완화하기 위해 연구진은 탐색 초기에는 과거 관측 데이터를 적극 활용하다가, 타깃 데이터가 축적됨에 따라 작업 인지형 전이 체계로 전환하는 '2단계 프로토콜'을 제안했습니다. 저자들 역시 단 하나의 방법론이 모든 환경에서 완벽할 수는 없음을 인정하며, 소스-타깃 간 유사도를 미리 알 수 없을 때 이 2단계 방식을 실용적인 기본값으로 제시합니다.
반도체 공정 연구에 주는 시사점
초기부터 복잡한 다중 작업 GP(MTGP)를 구축하기보다, 다음과 같은 단계적·실용적 접근이 충분히 유효함을 시사합니다.
- 초기 단계: 새로운 캠페인 시작 시 과거의 우수 레시피와 축적된 관측 데이터를 적극 활용하여 웜 스타트를 도모합니다.
- 검증 단계: 몇 개의 타깃 관측 데이터와 공통 앵커 레시피를 통해 소스-타깃 간의 실제 연관성을 검증합니다.
- 전환 단계: 연관성이 유효함이 확인되면 전이를 유지하고, 예상을 벗어나면 소스 데이터의 가중치를 낮추거나 타깃만 사용한 BO로 유연하게 전환합니다.
비판적으로 볼 부분
이 논문은 2026년 7월에 공개된 프리프린트 단계의 연구로, 아직 엄격한 동료평가를 거치지 않았습니다. 현재 제시된 성과는 대표적인 고속 스크리닝 반응 벤치마크와 인위적으로 설계된 스트레스 테스트 결과를 바탕으로 합니다. 따라서 실제 장비 드리프트, 측정 프로토콜의 변화, 데이터로 수집하지 않은 공정 실패 데이터, 그리고 안전 제약 조건까지 고려한 전향적 검증(Prospective validation) 과제가 남아있습니다.
또한 '초기'에서 '충분한 타깃 데이터 확보'로 넘어가는 전환 시점을 언제, 어떻게 자동화할 것인가도 중요한 당면 과제입니다. 단순히 고정된 반복 횟수를 기준으로 삼으면 작업의 특성에 따라 전환이 너무 빠르거나 늦어질 위험이 있습니다. 따라서 전환 기준은 타깃 예측 가능도, 순위 일치도, 사후 작업 유사도, 혹은 타깃만 적용한 모델 대비 후회도(Validation regret) 등 데이터에 기반한 엄밀한 지표로 설계되어야 합니다.
핵심 논문 4: Hvarfner et al. - MTGP는 단순한 문제에서도 실패할 수 있습니다
2026년 Hvarfner 등이 발표한 Pitfalls and Remedies for Multi-Task Bayesian Optimization은 전이 학습 기반 BO의 낙관론에 중요한 경종을 울리는 연구입니다. [10]
연구진은 소스와 타깃 작업이 아래와 같이 매우 단순한 아핀 관계(Affine relation)로 연결된 시나리오를 분석했습니다.
두 함수의 개형과 최적점의 순서가 사실상 동일하기 때문에, 상식적으로는 전이 학습이 무조건 성공해야 할 것처럼 보입니다. 그러나 교과서적인 기존 다중 작업 GP(MTGP)는 서로 다른 작업 간 상관관계를 제대로 추정하지 못했으며, 소스 작업이 여러 개일 때는 상관관계의 부호조차 잘못 판단하는 오류를 범했습니다. 그 결과 다수의 벤치마크에서 타깃만 사용한 GP보다도 성능이 떨어지는 심각한 부정적 전이가 관측되었습니다.
논문은 이러한 현상의 구조적 원인으로 다음 두 가지를 지적합니다.
- 작업별 표준화 오차: 수집된 데이터가 부족한 상태에서 각 작업의 평균과 표준편차를 추정할 때 발생하는 오차가 작업 간 상관관계 추정의 실패로 그대로 전파됩니다.
- 상관관계 식별 가능성 문제: 소스와 타깃 데이터가 서로 다른 입력 위치()에서 측정되었다면, 표본 수가 적은 초기 단계에서 두 함수 간의 실질적인 상관관계를 수학적으로 정확히 식별해내기 어렵습니다.
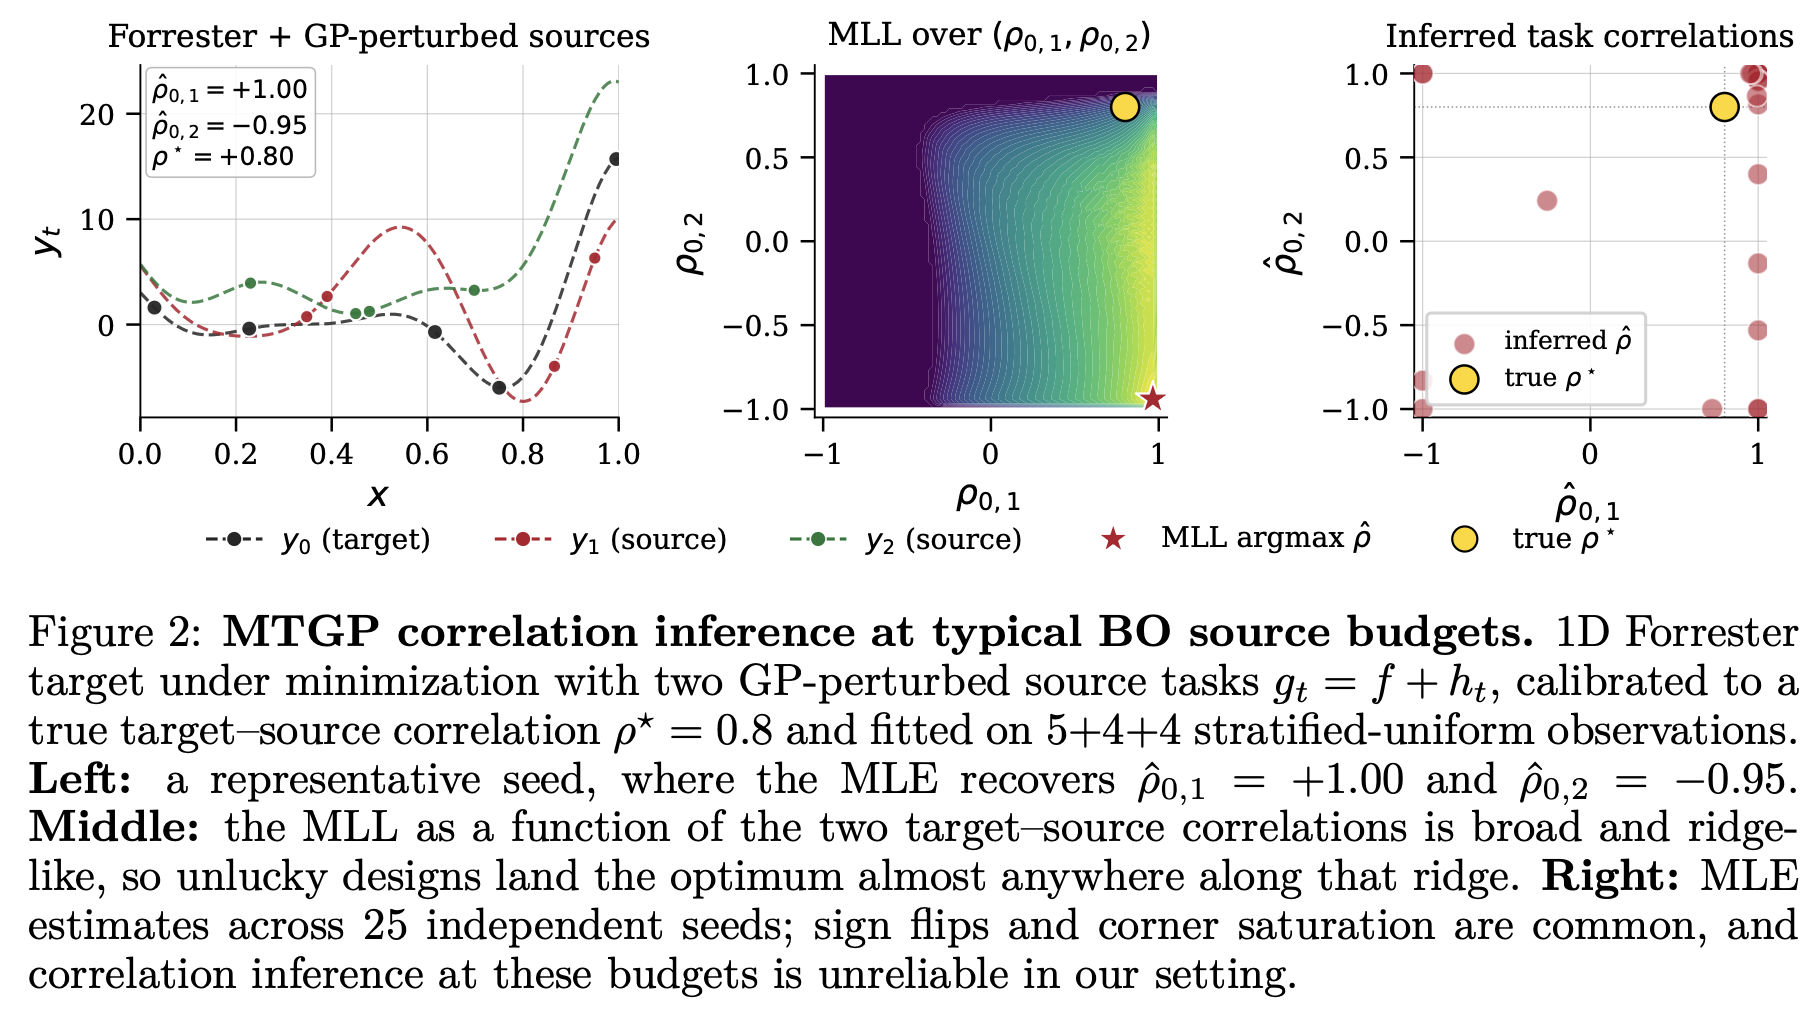
연구진은 이를 해결하기 위한 세 가지 보완책을 제안했습니다.
- 작업별 평균과 스케일을 전처리 단계의 고정 상수가 아닌, 모델 내부에서 함께 최적화할 파라미터로 학습합니다.
- 작업 간 상관관계가 음의 방향으로 잘못 학습되지 않도록 그 값이 음수가 아니어야 한다는 제약 조건을 부여합니다.
- 소스와 타깃 작업 모두에서 일부 동일한 입력 조건 를 공유하여 평가하는 '공동 배치 설계(Co-located design)'를 도입합니다.
특히 세 번째 제안인 공동 배치 설계는 반도체 공정 연구에 매우 중요한 시사점을 던집니다. 서로 다른 캠페인을 진행하더라도 기준이 되는 동일한 표준 레시피(reference recipe)를 반복 측정해두면, 모델이 두 캠페인의 유사성을 막연히 추측하는 대신 명확한 정량적 기준을 바탕으로 직접 비교할 수 있게 되기 때문입니다.
이 논문의 결론을 과장 해석해서는 안 됩니다
연구진이 제안한 세 가지 보완책이 모든 한계를 완벽히 해결하는 것은 아닙니다. 구조가 단순한 아핀 관계의 예제에서는 타깃 전용 모델 수준으로 성능을 회복했으나, 복잡하고 난해한 문제 구조에서는 여전히 실패 케이스가 관측되었습니다. 또한 실제 물리적 실험을 통한 검증이 다소 제한적이라는 아쉬움도 있습니다. 즉, 이 논문의 진정한 기여는 완전무결한 해결책을 제시했다는 점보다, 기존 MTGP가 안고 있던 고유의 구조적 결함을 명확히 분리하여 증명했다는 데 있습니다.
따라서 이를 "다중 작업 GP는 실효성이 없다"는 결론으로 확대해석해서는 곤란합니다. 우리가 얻어야 할 정확한 교훈은 다음과 같습니다.
"다중 작업 GP를 맹목적인 기본 모델로 채택하기에 앞서, 반드시 타깃만 사용하는 BO(Target-only BO)를 대조군으로 두어야 하며, 작업 간 상관관계를 엄밀히 식별할 수 있는 유기적인 실험 설계가 선행되어야 합니다."
네 논문을 함께 읽으면 보이는 것
| 연구 | 무엇을 전이했나 | 강점 | 주요 한계 | 반도체 공정에 주는 교훈 |
|---|---|---|---|---|
| Perrone et al. 2018 | 공유 신경망 표현 (Shared neural representation) | 방대한 과거 데이터에 대한 우수한 계산 확장성 | 비교 가능한 다수의 과거 작업이 필수적임 | 캠페인이 충분히 누적된 후 공통 공정 표현 학습에 활용 |
| Taylor et al. 2023 | 다중 작업 GP의 작업 간 상관관계 | 실제 자율 흐름 반응기 기반의 물리적 실험 검증 완료 | 긍정적인 사례 중심, 일반화 범위의 한계 | 실제 공정 장비에서의 전향적(Prospective) 검증 필요 |
| Chen et al. 2026 | 과거 관측 데이터, 표현 공간, 작업 인지형 전이 | 실용적인 2단계 전환 전략 제시 | 프리프린트 단계 연구, 정교한 자동 전환 기준 필요 | 초기 적극적 전이 후 실증 데이터 기반 감쇠 |
| Hvarfner et al. 2026 | 다중 작업 GP의 공분산 구조 | 구조적 실패 원인 규명 및 앵커 디자인 제시 | 제안된 보완책이 복잡한 문제를 완전히 해결하진 못함 | 공통 레퍼런스 레시피(Reference recipe) 확보가 필수적 |
이 네 편의 연구는 서로 모순된다기보다, 전이 베이지안 최적화(Transfer BO) 방법론이 학술적·실용적으로 성숙해가는 발전 패러다임을 보여줍니다.
- 과거 작업을 연계하여 함께 모델링하면 초기 탐색 단계(콜드 스타트)의 시행착오를 유의미하게 줄일 수 있습니다.
- 비교 대상이 되는 작업의 수가 많아질수록, 작업 간 상관관계 행렬을 직접 구하는 것보다 공유 표현을 학습하는 것이 계산 확장성 측면에서 유리합니다.
- 시뮬레이션에만 머물지 않고 실제 물리적 실험에 적용했을 때도 전이 학습은 획기적인 비용 절감으로 이어질 수 있습니다.
- 그러나 작업 간 유사도를 잘못 추정할 경우, 구조가 단순한 문제에서조차 타깃만으로 수행한 BO보다 성능이 저하되는 부작용이 발생합니다.
이를 통해 도출할 수 있는 가장 중요한 핵심 통찰(Lessons Learned) 다섯 가지를 다음과 같이 정리해 보았습니다.
1. 작업 간 유사도(Task similarity)는 가정이 아니라 정량적 추정 대상입니다
"같은 장비니까 비슷할 것이다", "동일한 전구체를 사용하니까 전이가 가능할 것이다"라는 도메인 직관에만 의존하는 설명은 위험합니다. 공통 앵커 레시피(Anchor recipe)에서의 반응성, 우수 레시피 상위 K개의 중복도, 순위 상관계수, 그리고 국소적 바이어스 등을 실증적 데이터로 직접 측정하고 검증해야 합니다.
2. 명확한 대조군으로서의 단순한 베이스라인이 반드시 필요합니다
복잡하고 정교한 전이 모델(Transfer model)을 도입할 때는 반드시 아래의 비교 대조군들과의 성능 평가가 선행되어야 합니다.
- 타깃만 사용한 GP: 전이 학습 없이 타깃 데이터만으로 학습한 기본 모델
- 무작위/균일 탐색(소볼 시퀀스 또는 무작위 탐색): 모델 기반 최적화 자체의 유효성을 검증할 기준점
- 사전 지식 기반 시작(웜 스타트): 과거의 우수 레시피 조건만을 초기 탐색점으로 활용하는 단순 방식
- 단순 데이터 결합(Naive pooling): 과거의 모든 관측 데이터를 구분 없이 하나로 합쳐 학습하는 방식
- 소스 모델 앙상블: 개별 소스 모델들의 예측을 가중 평균하는 방식
만약 단순 데이터 결합(Naive pooling)만으로도 충분한 성과가 나온다면, 복잡한 다중 작업 GP(MTGP)를 도입함에 따른 추가적인 계산 부하와 구현 복잡도는 정당화되기 어렵습니다. 반대로 단순 결합 방식이 실패(Negative transfer)하는 지점에서야 비로소 작업 인지형 모델(Task-aware model)의 진가와 필요성이 명확히 입증됩니다.
3. 단순한 예측 정확도보다 최적화 성능(Optimization outcome)을 정량화해야 합니다
모델의 예측 오차(RMSE)나 신뢰도(Calibration) 지표가 우수하다고 해서 최적화가 반드시 성공하는 것은 아닙니다. 전이 모델의 실질적인 가치를 판단하기 위해서는 최종 단순 후회도(Simple regret), 비용을 고려한 상시 후회도(Cost-normalized anytime regret), 상위 K개 후보 물질/레시피 발견율(Top-K discovery rate), 공정 제약 조건 위반 빈도(Constraint violation frequency), 그리고 부정적 전이 발생 빈도(Negative-transfer frequency) 등을 다각도로 평가해야 합니다.
예를 들어, 전이 학습을 통한 실질적인 이득인 전이 이득(Transfer gain)은 특정 실험 자원(Budget) 시점에서 다음과 같이 정의할 수 있습니다.
동일한 타깃 실험 자원 를 소모했을 때 이면 긍정적 전이(Positive transfer)가 일어난 것이고, 이면 부정적 전이(Negative transfer)가 발생한 것입니다. 연구 검증 시에는 단순히 평균 전이 이득(Mean gain)만을 제시하는 것에 그치지 않고, 실제 몇 퍼센트의 캠페인 평가 환경에서 부정적 전이가 발생했는지(Negative transfer risk)를 반드시 함께 보고하여 안정성을 검증해야 합니다.
4. 모델 아키텍처와 표현 공간의 효과를 분리하여 검증해야 합니다
고차원의 임베딩 표현 공간을 활용하면서 가우시안 프로세스의 길이 스케일 사전 분포를 기존 설정 그대로 유지하면, 모델과 표현 공간 간의 불일치로 인해 성능이 저하될 수 있습니다. 반대로 공유 신경망 기반 전이 모델의 성능이 우수하게 나타나더라도, 이것이 실제 '전이 학습의 효과' 때문인지 아니면 단순히 MLP 모델 자체가 갖는 표현의 유연성 때문인지 명확히 구분해야 합니다.
따라서 방법론의 유효성을 완벽히 입증하기 위해서는 최소한 아래와 같은 교차 비교 검증 프레임워크를 갖추어야 합니다.
| 구분 | 전이 학습 미적용 (Target-only) | 전이 학습 적용 (Transfer) |
|---|---|---|
| 가우시안 프로세스 계열 | 타깃만 사용한 GP | 전이 GP (Transfer GP / MTGP) |
| 신경망 계열 | 타깃만 사용한 신경망 대리 모델(Target-only Neural Surrogate) | 전이 신경망 대리 모델(Transfer Neural Surrogate) |
5. 실효성 있는 전이 성능은 정교한 데이터 거버넌스에서 시작됩니다
단순히 데이터에 캠페인 ID(또는 작업 인덱스) 레이블만 부여한다고 해서 자동으로 다중 작업 학습이 이루어지는 것은 아닙니다. 데이터 간의 실질적인 인과관계를 학습하기 위해서는 다음과 같은 메타데이터가 일관되고 표준화된 형태로 관리되어야 합니다.
- 장비 및 챔버 ID
- 기판 종류 및 하부막 정보
- 전구체 및 소스 물질의 랏 번호
- 공정 레시피 파라미터의 명확한 정의와 표준 단위
- 해당 캠페인에서 고정한 레시피 상수 목록
- 계측 방법론 및 계측 장비 정보
- 공정 진행 날짜, 랏 정보 및 장비 유지보수(PM) 상태
- 공정 실패, 중단 및 중간에 생략된 데이터
- 목적함수(Objective) 및 제약 조건(Constraint) 정의의 버전 번호
이러한 메타데이터 인프라가 뒷받침되지 않으면, 모델은 실제 공정의 물리·화학적 특성 변화와 단순한 측정 프로토콜의 차이(Systematic bias)를 구분하지 못해 전이 학습의 신뢰성이 무너지게 됩니다.
어떤 연구 설계를 추천할까
반도체 공정 전이 베이지안 최적화 연구를 시작할 때, 처음부터 가장 복잡한 메타 학습 모델을 채택하는 것은 바람직하지 않습니다. 그보다는 아래와 같이 단계적으로 비교 대조군을 확장해 나가는 연구 설계가 방법론의 해석 가능성을 높이고, 논문으로서의 논리적 설득력을 확보하는 데 훨씬 유리합니다.
1단계: 공통 탐색 공간과 캠페인 단위를 정의합니다
가장 먼저 최적화의 대상이 되는 개별 '작업'의 경계를 명확히 획득해야 합니다.
반도체 공정 특성을 고려할 때, 다음 중 하나를 캠페인 단위로 설정하는 것이 자연스럽습니다.
소재(material) × 전구체(precursor) × 기판(substrate)조합장비(tool) × 챔버(chamber) × 박막 구조(material stack)조합제품 세대(product generation) × 공정 모듈(process module)조합조각 샘플(coupon) / 파일럿(pilot) / 양산(production)스케일 다원화
이때 직접 최적화(튜닝)하지는 않지만 캠페인의 특성을 설명해 주는 변수들은 레시피 파라미터가 아니라 콘텍스트 변수 또는 레시피 상수(recipe constants)로 분리하여 저장해야 합니다. 만약 작업 특성에 해당하는 고정된 값(task descriptor)과 조절 가능한 파라미터를 입력단에서 구분 없이 섞어버리면, 획득 함수가 엔지니어가 실제로 변경할 수 없는 고정 변수를 추천하는 치명적인 오류가 발생합니다.
2단계: 앵커 레시피(anchor recipe)를 설계합니다
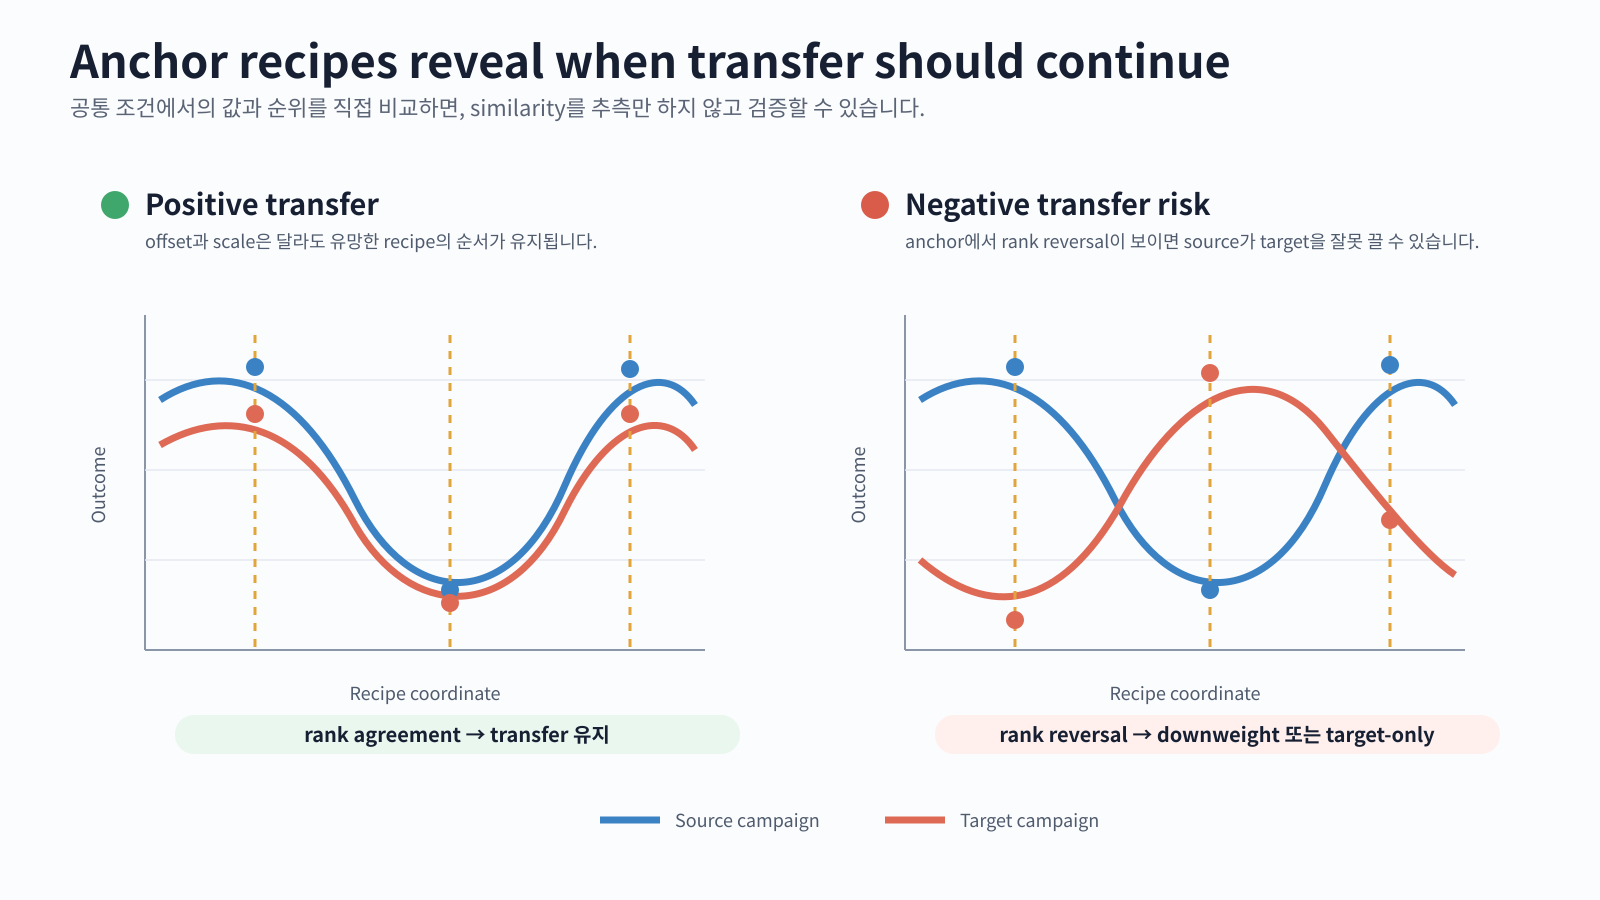
각 캠페인의 초기 실험 자원(budget) 중 일정 비율을 반드시 공통 레퍼런스 레시피인 '앵커 레시피' 측정에 배정합니다. 모든 소스-타깃 작업 쌍에서 완전히 동일한 레시피 적용이 불가능하다면, 공통 파라미터 하위 공간(subspace) 내에서 수학적으로 가장 가까운 조건을 선택합니다.
앵커 레시피의 목적은 최적의 조건을 발굴하는 것이 아니라, 다음 항목들을 사전에 정량적으로 식별하는 데 있습니다.
- 출력값의 오프셋 및 스케일 변화량
- 최적 경향성의 순위가 역전되는 현상 여부
- 공정 노이즈 및 재현성의 변화
- 챔버 간 편차(chamber bias) 또는 계측 장비 간 편차(metrology bias)
실험 설계 시 앵커 레시피의 배정 비율을 고정하기보다는, 배정 비율 변화에 따른 전이 효율의 민감도 분석을 함께 수행하는 것이 좋습니다.
3단계: 베이스라인 사다리(baseline ladder)를 구성합니다
방법론의 점진적인 우월성을 입증하기 위해 다음과 같이 체계적인 비교 대조군 체계를 구축합니다.
| 단계 | 적용 방법론 | 검증하고자 하는 핵심 질문 |
|---|---|---|
| B0 | 무작위/균일 탐색(Sobol/Random) | 모델 기반 최적화 알고리즘 도입 자체의 유효성 검증 |
| B1 | 타깃만 사용한 GP(Target-only GP) | 전이 학습이 전혀 없는 순수 BO 대비 기준 성능 확립 |
| B2 | 과거 우수 레시피 기반 웜 스타트 | 복잡하게 모델을 전이하지 않고 초기점만 이전해도 충분한가 |
| B3 | 단순 데이터 결합(Naive pooling) | 작업을 구분하지 않고 모든 데이터를 합쳐도 성능이 나오는가 |
| B4 | 다중 작업 GP (MTGP) | 작업 간 상관관계 학습이 모델에 실질적인 추가 가치를 주는가 |
| B5 | RGPE / 소스 앙상블 | 타깃 공정에 악영향을 주는 소스 데이터를 선택적으로 배제할 수 있는가 |
| B6 | 공유 표현 / FSBO | 캠페인 수가 대폭 늘어날 때 공통 표현 공간 학습이 유리한가 |
| B7 | 2단계 적응형 전이 | 소스-타깃 유사도가 불명확할 때 안전한 전환 프로토콜이 작동하는가 |
특히 MTGP(B4) 단계에서는 앞서 검토한 Hvarfner 논문의 보완책들을 반영한 변형 모델을 포함해야 합니다. 즉, 작업별 평균·스케일을 동적으로 학습하고, 양의 상관관계만으로 제약을 하면서 앵커 디자인의 유무에 따른 효과를 소거 실험(ablation study)으로 명확히 분리해야 합니다.
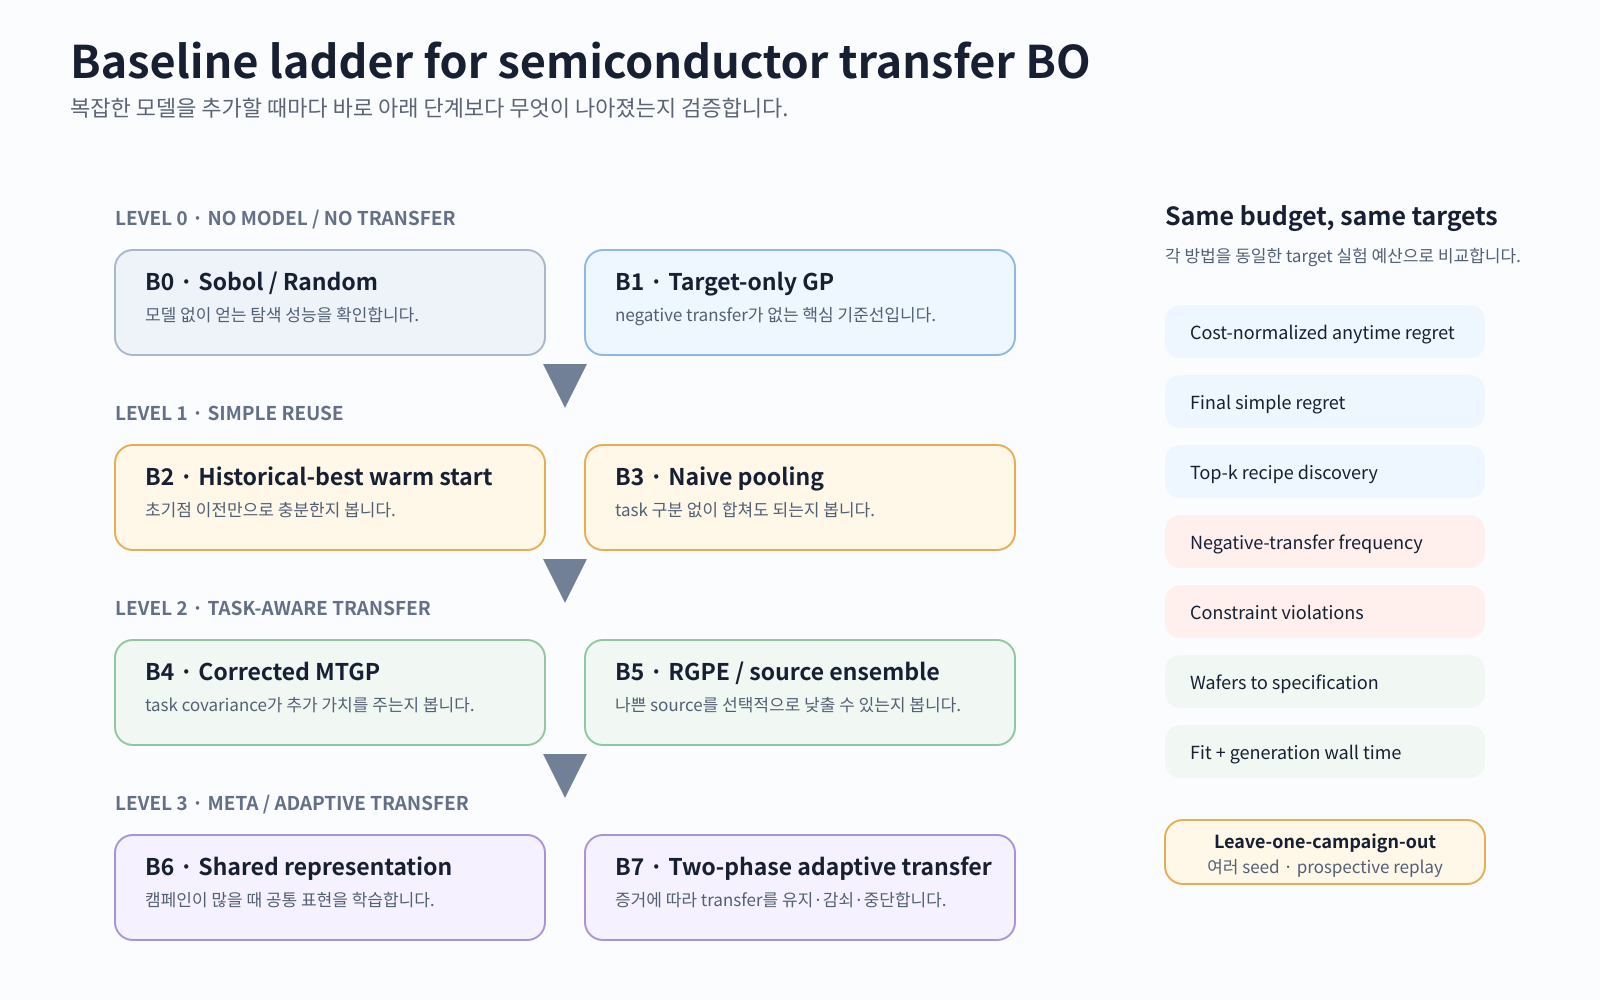
4단계: '하나의 캠페인을 제외시키는' 교차 검증(leave-one-campaign-out)으로 평가합니다
확보된 캠페인 중 하나를 타깃 작업으로 남겨두고, 나머지를 모두 과거 소스 데이터로 활용하는 교차 검증을 수행합니다. 이때 타깃 작업의 전체 데이터를 모델 선택이나 하이퍼파라미터 튜닝에 미리 개입시키면 데이터 누출이 발생하므로 주의해야 합니다. 철저히 실제 시간 흐름에 맞춰 BO 궤적을 순차적으로 재생하거나 전향적 실험 환경을 모사해야 합니다.
평가는 다양한 난수 시드와 서로 다른 타깃 캠페인 조합에 대해 반복 실행하며, 다음 지표들을 종합적으로 평가합니다.
- 비용 고려 상시 후회도 (cost-normalized anytime regret)
- 최종 단순 후회도 (final simple regret)
- 상위 K개 우수 레시피 발견율 (top-K recipe discovery rate)
- 목표 스펙 달성까지 소요된 총 웨이퍼 수
- 공정 제약 조건 위반 횟수
- 부정적 전이 발생률
- 모델 피팅 및 다음 후보 추천에 소요된 연산 시간
실제 반도체 현업에서는 단일 목적함수 최적화보다는 안전 마진 확보와 다중 스펙 충족이 최우선이므로, 제약 조건이 포함된 다목적 최적화 환경에서의 평가를 필수적으로 포함해야 합니다.
5단계: 전이 학습 거부 메커니즘(Transfer gating)을 장착합니다
가장 안전하고 강건한 전이 최적화 시스템은 '언제나 전이를 수행하는 시스템'이 아니라, '전이를 거부할 줄 아는 시스템'입니다. 소스 데이터의 증거가 부족하거나 소스-타깃 간의 경향성이 명백히 어긋날 경우, 시스템이 스스로 전이를 차단하고 타깃만 사용하는 BO(Target-only BO)로 안전하게 회귀할 수 있어야 합니다.
이를 제어하기 위해 활용 가능한 게이팅 신호는 다음과 같습니다.
- 앵커 레시피 상에서의 순위 일치도 (rank agreement)
- 타깃 검증 데이터에 대한 모델의 예측 가능도 (holdout predictive likelihood)
- 소스 모델이 예측한 타깃 데이터의 순위 손실 (target ranking loss)
- 사후 작업 상관관계(posterior task correlation) 추정치의 신뢰구간
- 타깃 전용 모델과 전이 모델 간의 획득 함수 불일치도 (acquisition disagreement)
결과적으로 최적화 초기에는 과거 소스 데이터의 가이드에 의존하되, 타깃 공정의 실증 데이터가 축적될수록 소스 데이터의 가중치를 엄밀하게 재평가하여 감쇠시키는 방식이 실무 및 양산 관점에서 가장 타당한 엔지니어링 접근법입니다.
상황별로 어떤 방법이 적절할까
| 상황 | 우선 검토할 방법 | 추천 이유 |
|---|---|---|
| 과거 캠페인이 1~3개로 적고 데이터도 부족함 | 타깃만 사용한 GP + 웜 스타트 + MTGP/RGPE | 고용량 신경망 표현을 학습할 데이터 근거가 부족함 |
| 과거 캠페인 수는 적으나 소스별 데이터가 풍부함 | RGPE 또는 계층적 GP | 소스를 독립적으로 유지하며 선택적 전이가 가능함 |
| 캠페인이 충분하고 파라미터 정의가 잘 정렬됨 | Perrone 방식 공유 표현, FSBO, 사전 학습 GP | 공통 구조를 메타 학습할 데이터 자산이 확보됨 |
| 소스-타깃 간 유사도가 매우 높다고 확신함 | 단순 데이터 결합 (Naive pooling) | 모델 복잡도를 과도하게 높이지 않고도 강력한 성능을 냄 |
| 작업 간 유사도를 미리 알 수 없음 | 앵커 디자인 + 2단계 적응형 전이 프로토콜 | 초기 탐색 이득과 부정적 전이 위험을 접목함 |
| 파라미터 세트가 캠페인마다 상이함 | 공통 하위 공간 검증 후 이종 공간 모델 적용 | 기존 MTGP의 동일 도메인 가정이 깨지는 환경임 |
| 공정 안전 제약 조건이 매우 중요함 | 타깃 전용 안전 모델 + 보수적 전이 | 목적함수 전이와 안전 제약 조건 전이를 엄격히 분리해야 함 |
반도체 공정 분야에서 전이 BO의 첫 번째 연구 주제로 추천하는 핵심 비교 조합은 다음과 같습니다.
"앵커 디자인을 포함한 타깃 전용 GP, 단순 데이터 결합, 보완된 MTGP, RGPE, 그리고 2단계 적응형 전이의 다각적 비교"
이 조합은 과거 누적 캠페인 수가 많지 않은 초기 단계에서도 즉시 적용 가능하며, 전이의 성공 및 실패 원인을 명확하게 해석할 수 있다는 장점이 있습니다. 공유 신경망 표현(shared neural representation) 방식은 향후 공정 캠페인과 데이터가 충분히 축적된 후속 연구 단계로 배치하는 것이 현실적입니다.
앞으로 해결해야 할 핵심 과제
1. 이종 탐색 공간(heterogeneous search space)
실제 현업의 공정 개발 캠페인은 파라미터 집합이 완벽히 일치하지 않습니다. 특정 캠페인에는 플라즈마 파워가 독립 변수로 존재하지만 다른 캠페인에는 없을 수 있으며, 파라미터의 범위와 변경 단위도 달라질 수 있습니다. 기존 전이 BO 연구의 상당수는 모든 작업이 동일한 도메인을 공유한다고 가정하는 한계가 있습니다.
최근 이종 탐색 공간을 위한 사전 학습 기반 계층적 GP 등의 연구가 등장하고 있지만, 실제 반도체 공정에서의 실증 검증은 여전히 미흡한 실정입니다. [11] 공통 파라미터, 작업 고유 파라미터, 조건부 파라미터를 유연하게 아우르는 종합 모델 아키텍처가 필요합니다.
2. 시간에 따른 장비 및 공정의 변화
동일한 챔버라 할지라도 유지보수(PM), 시즈닝(seasoning) 상태, 전구체 랏 교체, 센서 보정 등에 의해 공정 특성은 시간에 따라 계속 변화(drift)합니다. 작업을 고정된 ID로만 취급하면 이러한 시간 축의 변화를 놓치게 됩니다. 따라서 캠페인 간 전이 기법과 실시간 변화점 감지(online change-point detection) 알고리즘을 유기적으로 결합시켜야 합니다.
3. 목적함수 및 제약 조건의 동적 변화
공정 개발 초기 단계에서는 증착률이 최우선 목표였다가, 양산화 단계로 넘어가면 균일도와 결함 밀도가 더 핵심적인 지표가 되기도 합니다. 또한 과거 데이터에는 일부 결과 항목이 누락되어 있을 수 있습니다. 따라서 서로 다른 목적함수 세트와 누락된 평가 결과를 유연하게 처리할 수 있는 전이 다목적 BO(Transfer Multi-Objective BO) 프레임워크가 필요합니다.
4. 안전 제약 조건에서의 부정적 전이 위험성
과거 공정 캠페인에서 안전했던 영역이 새로운 화학 반응이나 신규 챔버 조건에서도 안전하다는 보장은 없습니다. 목적함수 대리 모델은 과거 데이터를 전이받더라도, 안전 제약 조건 모델은 타깃 공정의 실증 데이터가 충분히 확보될 때까지 매우 보수적이고 독립적으로 운영하는 안전 분리 설계가 필수적입니다.
5. 도메인 지식과 전이 학습의 결합
반도체 공정은 속을 전혀 알 수 없는 블랙박스가 아닙니다. ALD의 포화 특성, 아레니우스 반응속도론, 질량 보존 법칙, 플라즈마 밀도-파워 상관관계 등 확립된 물리·화학적 지식이 존재합니다. 이러한 지식을 평균 함수, 커널, 단조성 제약(monotonic constraint) 또는 엔지니어링된 특징(engineered feature) 형태로 모델에 주입할 수 있습니다.
이 경우 전이 모델은 단순히 "모든 작업이 동일한 함수를 따른다"는 전제보다, "공통의 물리 법칙 기반 위에 작업별 고유한 잔차(residual)가 존재한다"는 형태의 모델링이 훨씬 자연스럽고 정교합니다.
6. 최적화 실행 전 유사도 추정의 불확실성
현재 공개된 다수의 벤치마크 연구들은 최적화가 완료된 후 사후적으로 어떤 작업들이 유사했는지를 설명하는 구조를 취합니다. 그러나 실제 실시간 BO를 수행하는 시점에서는 이를 미리 알 수 없습니다. 극소량의 초기 타깃 데이터만으로 전이 가능성의 여부를 정확히 추정하고, 확신이 서지 않을 때는 전이를 거부(calibrated gating)할 수 있는 알고리즘이 핵심적인 연구 과제입니다.
7. 재현 가능한 반도체 공정 표준 벤치마크 구축
머신러닝 하이퍼파라미터 최적화(HPO) 분야에는 다양한 작업 간 성능을 비교할 수 있는 표준 벤치마크가 잘 갖추어져 있지만, 반도체 공정 분야는 보안상의 이유로 서로 다른 캠페인이 모여 있는 데이터셋이 거의 전무합니다. 표준화된 파라미터 스키마, 캠페인 메타데이터, 실패한 실험, 비용 데이터, 제약 조건까지 체계적으로 포함된 공용 벤치마크 구축이 시급합니다.
실제 양산 데이터의 공개가 어렵다면, 물리 기반 디지털 트윈과 보안 처리된 익명화 실측 데이터(experimental trace)를 결합한 준합성(semi-synthetic) 벤치마크 구축이 현실적인 대안이 될 것입니다.
결론: 전이 BO의 본질은 무조건적인 기억이 아니라 정교한 검증입니다
반도체 공정 개발에서 베이지안 최적화는 막대한 비용과 시간이 소요되는 실험을 획기적으로 줄여주는 유용한 도구입니다. 하지만 매 캠페인을 독립적인 문제로 취급한다면, 이전의 소중한 실험을 통해 축적된 지식과 통찰은 매번 손실되고 맙니다. 전이 학습은 이러한 단절을 메워주며, BO를 일회성 단발 최적화 도구에서 지속적으로 진화하고 학습하는 지능형 공정 개발 시스템으로 확장시킬 수 있는 핵심 열쇠입니다.
전이 BO 연구의 흐름을 되짚어보면 다음과 같습니다. 초기 연구는 다중 작업 GP(MTGP)를 통해 작업 간 상관관계를 학습하는 데서 출발했습니다. Perrone 등은 다수의 작업이 공유하는 표현 공간을 학습함으로써 계산 확장성을 대폭 끌어올렸습니다. Taylor 등은 실제 화학 반응 자율 최적화 장비에서 서로 다른 캠페인 간 전이의 뛰어난 실용성을 입증해 냈습니다. Chen 등은 단순한 과거 데이터 결합과 2단계 적응형 전이의 현실적인 유용성을 제시했으며, Hvarfner 등은 기존 MTGP가 단순한 조건에서도 상관관계를 오판하여 부정적 전이를 일으킬 수 있음을 경고했습니다.
이 모든 흐름을 관통하는 단 하나의 결론은 다음과 같습니다.
"과거 데이터를 얼마나 많이 집어넣느냐보다 중요한 것은, 그 데이터가 현재 진행 중인 타깃 캠페인에 실제로 도움이 되는지 실증적으로 검증하고, 위험할 때는 전이를 즉시 중단할 수 있는 통제력을 갖추는 것입니다."
따라서 반도체 공정 전이 BO 연구를 시작할 때, 가장 복잡한 신경망 대리 모델부터 구축할 필요는 전혀 없습니다. 공통 앵커 레시피를 정교하게 설계하고, 확실한 대조군으로서 타깃 전용 베이스라인을 유지하며, 단순 데이터 결합부터 보완된 MTGP, 그리고 적응형 전이 기법에 이르기까지 일관된 조건에서 단계적으로 검증해 나가는 것이 올바른 길입니다.
뛰어난 전이 BO 시스템은 모든 과거 데이터를 맹목적으로 기억하는 모델이 아닙니다. 어떤 과거 지식을 신뢰해야 하는지, 타깃 공정의 실증 데이터를 통해 스스로 검증해내는 모델입니다.
주요 참고문헌
신뢰성을 확보하기 위해 동료평가를 거친 저명 학회·저널 논문과 공식 원문을 우선적인 출처로 삼았습니다. 심사 완료 전의 자료는 최신 주요 이슈를 다룬 경우에만 예외적으로 포함 시켰으며, 이 경우 preprint 표시를 명확히 부착했습니다. 해당 데이터들은 확정된 결론이 아니라, 향후 추가 검증이 필요한 참고 근거로 해석하여 반영했습니다.
- Zhang et al., Bayesian Optimization for Controlled Chemical Vapor Deposition Growth of WS₂, ACS Applied Materials & Interfaces, 2024. 원문
- Shrivastava et al., Bayesian Optimization for Stable Properties amid Processing Fluctuations in Sputter Deposition, Journal of Vacuum Science & Technology A, 2024. 원문
- Bai et al., Transfer Learning for Bayesian Optimization: A Survey, arXiv preprint, 2023. 원문
- Swersky, Snoek, Adams, Multi-Task Bayesian Optimization, NeurIPS, 2013. 원문
- Tighineanu et al., Transfer Learning with Gaussian Processes for Bayesian Optimization, AISTATS, 2022. 원문
- Perrone et al., Scalable Hyperparameter Transfer Learning, NeurIPS, 2018. 원문
- Wistuba, Grabocka, Few-Shot Bayesian Optimization with Deep Kernel Surrogates, ICLR, 2021. 원문
- Taylor et al., Accelerated Chemical Reaction Optimization Using Multi-Task Learning, ACS Central Science, 2023. 원문
- Chen et al., Robust Transfer Learning for Bayesian Optimization of Chemical Reactions, ChemRxiv preprint, 2026. 원문
- Hvarfner et al., Pitfalls and Remedies for Multi-Task Bayesian Optimization, arXiv preprint, 2026. 원문
- Fan, Han, Wang, Transfer Learning for Bayesian Optimization on Heterogeneous Search Spaces, TMLR, 2024. 원문