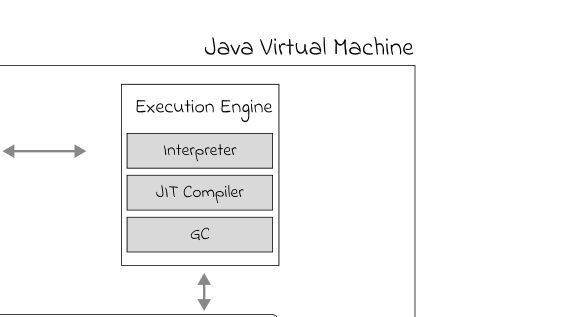
이전에 JVM의 구조에 대한 글을 작성하면서 이와 같이 작성했었다. 최적화 하는 다양한 방법은 존재하겠지만, 내가 그 다양한 방법은 알지 못하니 우선 JIT Compiler에 대해서 알아보고자 한다.
JIT Compiler
JIT는 Just In-Time 의 약자로, JIT Compiler는 코드 실행 시 Byte code를 기계어로 Compile 하고, 이를 Caching해 두는 JVM의 Execution Engine의 요소이다. JVM은 Interpreter를 사용하여 코드를 실행하는데, 매번 코드를 해석하여 실행하는 것은 성능 저하의 단점이 있기에 JDK 1.3에서 도입된 요소이다.
JVM의 Execution Engine에 대한 내용은 이전 글에서 작성해 두었다.
https://velog.io/@bkkmw/JVM-구조
간략하게 말하자면, Interpreter는 코드 실행 시 Byte code를 해석하며 수행하고, JIT Compiler는 자주 사용되는 method의 Byte Code를 Compile 해 Caching해 두어 성능 향상이 가능하게 하였다.
AOT Compiler
AOT(Ahead of Time) Compiler는 C/C++ 등 언어에서 사용하는 정적 컴파일러이며, JIT Compiler는 AOT Compiler와 달리 특정 상황에 맞게 Compile을 수행하는 동적 컴파일러이다.
JVM(Hotspot) JIT Compiler
JIT Compiler는 JVM만 사용하는 Compiler가 아닌, Python, JavaScript 등 Interpreter 언어에서 성능 향상을 위해 많이 사용하는 요소이다. 편의상 이 글에서는 JVM의 JIT Compiler에 대해서 작성할 예정이며, JVM의 JIT Compiler는 method 단위로 작업을 수행하고, Python 등은 반복문 등 code의 실행을 관점으로 작업을 수행하기에 method 중심으로 작성한 글에 오해가 없기를 바란다.
추가적으로, JVM 내에서도 각각 다른 방식을 채택하는 경우가 많다. 예를 들자면, Hotspot JVM은 counter를 활용한 Hotspot 탐지를, J9 JVM은 호출 스택을 활용한 탐지를 수행한다고 한다. 이 글의 내용은 Hotspot JVM을 기준으로 작성하였으니 이 부분 또한 오해가 없기를 바란다.
JVM JIT Compiler 동작
JIT Compiler는 모든 Method를 Compile하지 않는다. Hotspot이라고 불리는 빈번하게 실행되는 코드 부분을 Compile 하며, 이를 감지하기 위해 다음과 같은 카운터를 활용한다.
Method Entry Counter: Method 호출 시 증가Back-Edge Loop Counter: Loop 실행 된 만큼 증가
이러한 카운터 값을 기반으로 특정 Threshold를 넘긴 Hotspot code는 JIT Compiler의 작업 대상이 되어 Compile 작업 Queue에 들어간다.
Compile이 완료 된 코드는 Code Cache에 저장되며, 이후 동일한 Method 호출 시 Code Cache에 있는 기계어를 실행한다. 위 과정을 요약하면 아래와 같다.
- Interpreter를 통한 코드 실행
- Counter 증가
- Threshold 도달 - Hotspot 감지
- Compile Queue
- (Background Thread) Compile 및 Cache 저장
이것이 JIT Compiler의 대략적인 동작 과정이며, JIT Compiler의 구조와 함께 구체적인 과정을 살펴보겠다.
JIT Compiler 구조
Tiered Compilation
JDK8 이후 JVM의 JIT Compiler는 C1(Client Compiler)와 C2(Server Compiler)로 구성되어있다.
C1은 간략한 최적화를 수행하며, C2에 비해 Runtime 성능은 낮지만 빠른 compile을 수행하며, C2는 높은 수준의 최적화를 수행해 높은 Runtime 성능을 갖춘 반면 Compile 속도가 C1에 비해 느리다. 이전 버전의 JDK에서는 C1 또는 C2 중 하나만 선택해서 사용할 수 있었기에, Cient 측 작업에 좋은 C1 Compiler는 Client Compiler, C2는 Server Compiler라 불리기도 한다.
JVM은 코드의 사용 빈도에 따라 5개의 level로 나누며 상황에 따라 C1, C2 Compiler와 Interpreter 세 가지를 활용한다.
- Level 0 :
Interpreter가 코드를 실행하며, Hotspot 감지를 위한 카운터 수집 단계 - Level 1(No Profiling) :
C1 Compiler가 수행하며, 별도의 profiling은 하지 않는다. 실행 시간이 짧아 추가적인 최적화가 필요하지 않는 경우에 해당한다. - Level 2(Limited Profiling) :
C1 Compiler가 수행하며, 일부 기본적인 profiling만(method counter, back-edge) 수행한다.C2 Compiler가 가득 찼을 때 사용되며, 많은 작업이 전달되는 것을 방지한다. - Level 3(Full Profiling) :
C1 Compiler가 수행하며, 기본적인 profiling 외에도 분기 예측, 타입 프로파일링 등 최적화를 위한 데이터를 모두 수집한다. - Level 4 :
C2 Compiler가 수행한다.
위와 같이 여러 단계로 구성하는 이유는, C2 Compiler는 최적화를 위해 많은 리소스를 사용하기 때문에, 필수적인 상황에만 사용할 수 있도록 하여 부하를 줄이기 위함이며, 각 레벨이 사용되는 흐름은 아래 그림 정도로 표현할 수 있다.
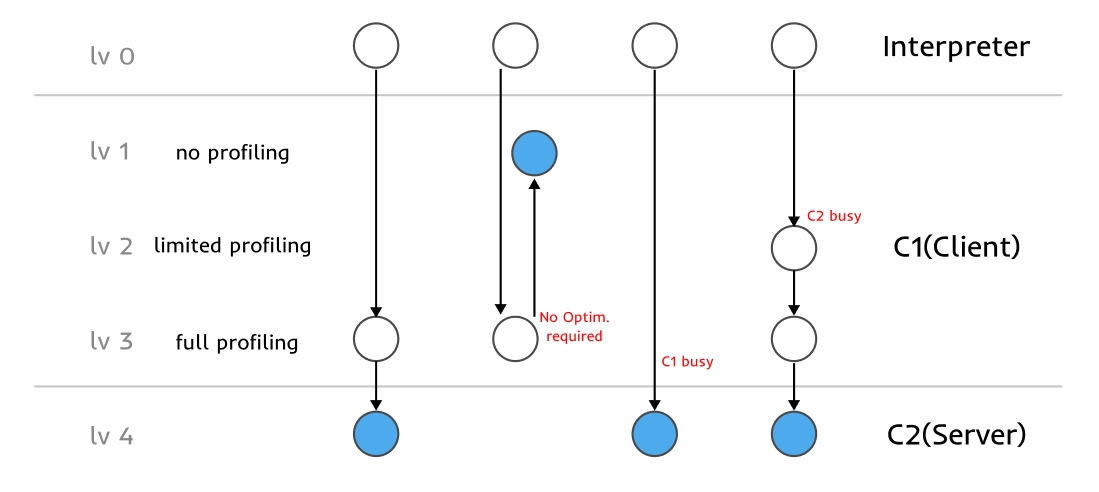
위 그림은 모든 상태를 나타내는 것은 아니며, C2 Compiler의 최적화 결과로 오류가 발생하는 경우 아래 단계로 강등 시키는 Deoptimization과 같은 상황 또한 존재한다.
Counter 및 Threshold
Hotspot 감지를 위해 사용하는 Counter는 Method Entry Counter와 Back-Edge Loop Counter이며, 각각의 구체적인 역할은 아래와 같다.
Method Entry Counter
Method가 호출(Invoation)되어 실행 될 때 값이 증가하는 Counter로, Application 내에서 자주 사용되는 method를 찾을 수 있다.
Back-Edge Loop Counter
반복문에서 처음으로 돌아가는 순간(Back-Edge)에 값이 증가하는 Counter로, method 호출이 적더라도 오랫동안 실행되는 반복문을 찾을 수 있다.
Counter의 Threshold는 크게 두 가지 기준으로 분류할 수 있다. Tier3/Tier4 와 Invocation Threshold/CompileThreshold 이다. 이는 각각 Interpreter에서 C1, C1에서 C1로 넘어가는 Threshold, 활용하는 Counter(Method Entry/Method Entry + Back-Edge Counter)를 구분하는 기준이다. 아래와 같은 Flag를 통해 설정할 수 있다.
-XX:TierXInvocationThreshold / -XX:TierXCompileThreshold
카운터가 증가하기만 한다면, 언젠가는 모든 method가 Compile 될 것이다. 이를 방지하기 위해 Counter Decay라는 방식을 사용하는데, 특정 시간마다 counter의 수를 반으로 감소 시키는 방법이다. 이를 통해 과거에 많이 사용되었더라도 현재는 사용되지 않는 Cold method가 불필요하게 Compile되는 것을 예방할 수 있다.
OSR
단 한번의 호출에 수 많은 반복 작업을 하는 반복문을 가정해보자. 일반적인 JIT Compiler의 방식으로는 해당 Method가 Interpreter 방식으로 모든 반복문을 느리게 수행하고, 다음 호출부터 기계어를 활용해 빠르게 수행할 수 있지만, 사용되지 않기에 반복문 실행 성능도 향상 못하며, Compile을 위한 리소스도 낭비하게 되는 문제가 있다.
JVM의 JIT Compiler는 Method를 단위로 한다고 하였으나, Loop에 대한 예외가 있다. OSR(On-Stack Replacement)는 Method 호출 횟수가 아닌 Loop의 실행 횟수를 기반으로 성능을 향상 시키는 방법이다.
Loop의 실행 횟수를 나타내는 Back-Edge Counter를 기반으로 동작하며, 일반적인 JIT Compile과의 가장 큰 차이점은, 이름과 같이 Stack의 정보를 런타임 중 교체하는 것이다. 동작 과정은 아래와 같다.
- 루프 반복 실행 및 Back-Edge Counter 증가
- Back-Edge Counter Threshold 도달
- (Background Thread) Hotspot Compile 수행
- Compile 완료 후 애플리케이션을 Safepoint에서 중단 후 메모리 스택의 내용을 기계어로 교체
- 실행
Back-Edge Counter를 활용하는 OSR을 위한 Threshold는 아래 플래그를 통해 설정할 수 있다.
-XX:BackEdgeThreshold
OSR에 사용되는 Back-Edge Counter의 경우 반복문의 실행 횟수를 기록하는데, Method의 호출 횟수를 기록하는 Method Entry Counter와 그 성격이 다르다. Method 호출은 특정 시간 내 얼마나 많이 호출 되었는지가 중요하지만, 반복문은 특정 시간 내 반복이 아닌 한번에 반복한 횟수가 중요하다.
따라서 Method Entry Counter가 decay를 통해 counter를 제어하는 것과 달리, Back-Edge Counter는 decay 없이 실행 후 counter를 조정하는 방식으로 제어한다.
JVM Warmup
지금까지 JVM이 Interpreter의 한계를 넘어 성능 향상을 위해 도입한 JIT Compiler에 대해 알아보았다. JIT Compiler를 통해 많이 사용되는 Method를 미리 기계어로 Compile하여 실행 속도를 향상 시킬 수 있어 웹 서버 애플리케이션에서 활용한다면, 자주 사용되는 기능의 응답 속도를 개선할 수 있을 것이다.
다만, 배포 주기가 짧아지고, Auto Scaling 등에 많은 Container를 활용하며 애플리케이션이 새로 구동 되는 상황이 잦아지는 환경을 가정해 보자. 최초 구동 시에는 JVM이 Hotspot을 감지하지 못해 많은 요청이 몰리는 method는 Interpreter를 통해 실행되며 응답 속도가 지연되는 문제가 발생한다.
이를 개선하기 위한 방법이 JVM Warmup으로, 애플리케이션이 배포되기 전에 많은 호출이 예상되는 method를 JIT Compiler가 미리 compile 하도록 하는 작업이다. 스크립트를 작성하거나, 애플리케이션 구동 시 실행되는 모듈을 활용하거나 또는 API 호출을 대량으로 반복하는 등의 방식으로 구현할 수 있으며, 서비스의 배포가 잦은 애플리케이션 또는 배포와 동시에 트래픽이 몰리는 애플리케이션 등에서 활용해보면 좋을 것 같다.
JIT Compiler를 공부하면서 JIT Compiler가 최적화에 대해 다루지 못했는데, 기회가 된다면 다음에는 JIT Compiler의 최적화에 대해서 작성해 보겠다.