흥미:5/5
https://openreview.net/pdf?id=3pLFgUQLzJ
기술적·구조적 기여 및 성과
- 통합 연산 그래프(wGraph) 도입:
- 기존의 정적 템플릿 검색 방식에서 벗어나, 원자적 연산(Atomic Operation)과 의존 관계를 DAG 형태의 단일 글로벌 그래프로 모델링하여 재사용성과 확장성을 극대화했습니다.
- GNN 기반 적응형 서브그래프 생성 (Task-Adaptive Generation):
- 사용자 쿼리를 가상 작업 노드()로 주입하고 2-layer GCN을 통해 연산 노드 간의 위상적 의존성을 파악하여 최적의 서브그래프를 동적으로 구성했습니다.
- 차분 기반 토폴로지 인식 KV 캐시 관리 (Topology-Aware State Management):
- 연산 노드의 KV 상태 중 70~75% 이상이 접두사(Prefix) 변경에 무관하게 유지(희소성)된다는 점을 발견하고,
기본 KV(Base)+희소 차분($\Delta$KV)구조를 설계해 정확도를 유지하면서 중복 저장을 제거했습니다.
태스크 의뢰인 (): "지금까지 본 적 없는 유형의 복잡한 추론 미션이다. 기존 템플릿 목록에는 내 조건에 맞는 고정 파이프라인이 없다."
적응형 설계자: "당황할 필요 없다. 우리에게는 원자 단위 작업들이 망라된 가 있다.
-
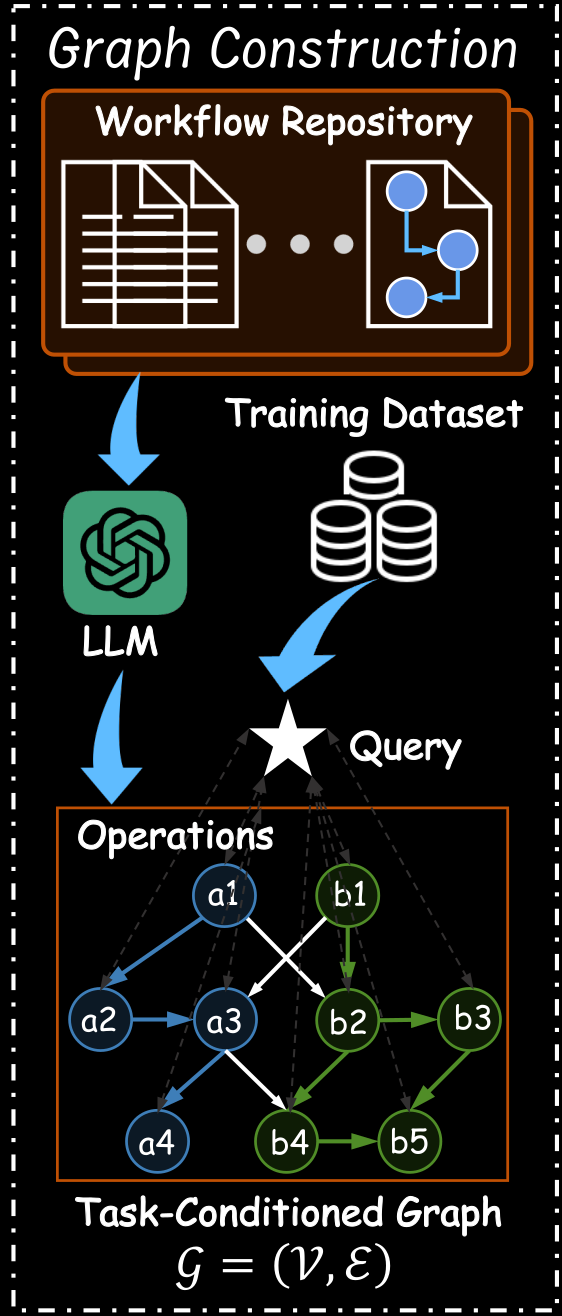
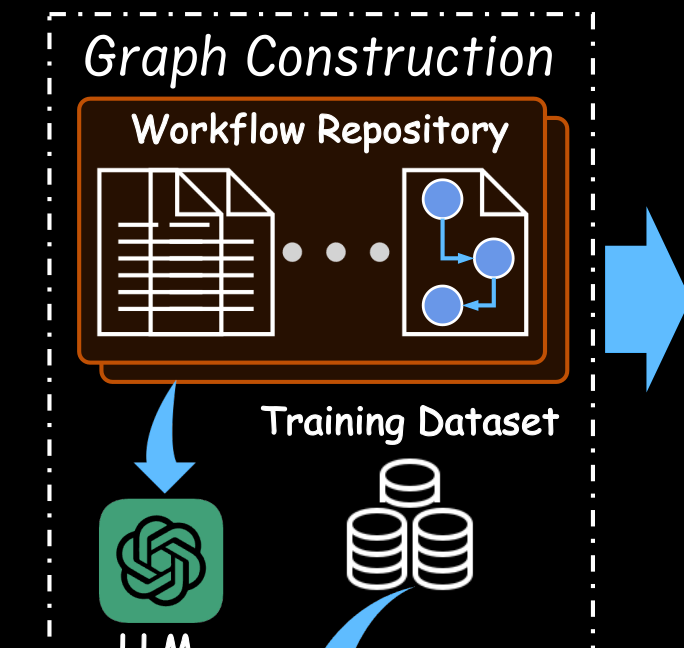
오프라인 준비 단계 (Offline Phase): 전체 wGraph를 구축하고, 노드 표현을 초기화하며, 워크플로우 생성 모델을 학습시킵니다. 이때 효율적인 추론을 위해 각 연산 노드와 연계된 컨텍스트 프리(Context-free) 베이스 KV 상태를 미리 생성해 둡니다.
-
모든 워크플로우의 원자적 연산들을 노드로, 연산 간의 유효한 전이 관계를 엣지로 통합한 글로벌 연산 그래프 를 구축
-
그래프 신경망(GNN, 구체적으로 2-layer GCN)을 통해 전체 노드 간 정보를 상호 전파(Message Passing)한다.
-
를 얻었다. 이제 연산 와 사이에 실행 흐름 화살표()를 연결할지 결정해야 한다.
단순히 두 연산의 임베딩 유사도()만 본다면 치명적인 왜곡이 발생한다: -
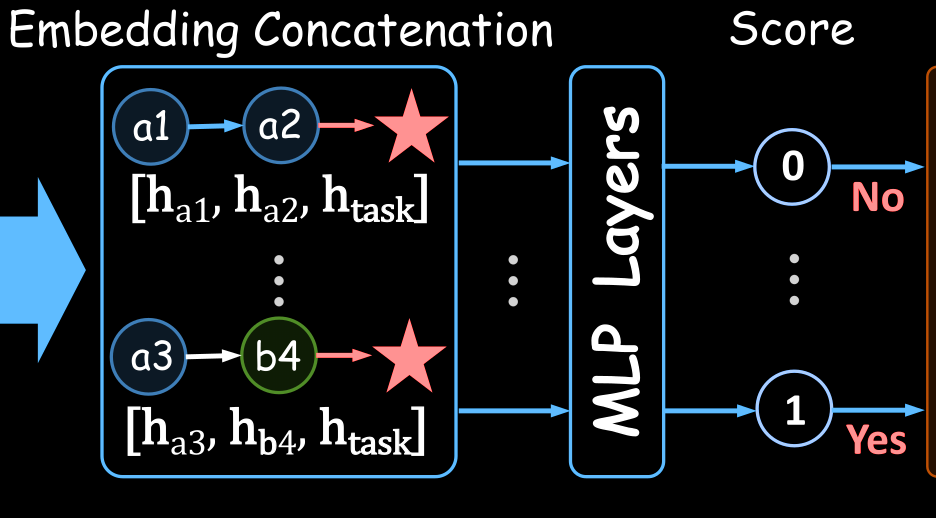
출발 노드(), 도착 노드(), 전체 태스크 맥락()을 단일 차원으로 나란히 이어 붙이는 Embedding Concatenation을 도입
- 임무 가 확정되는 순간, 해당 임무를 대변하는 가상 태스크 노드(Virtual Task Node) 를 동적으로 생성하여 그래프 중심에 배치
- 모든 연산 노드와 사이에 양방향 통신로를 연결해서 구현
- 하지만 GNN의 메시지 패싱은 정보를 '희석(Dilution)'시킨다
- GNN을 제거하자 심각한 딜레마가 발생했다: MATH 데이터셋 정확도가 52.6%에서 47.1%로 5.5%p나 폭락
- GraphFlow는 이 문제를 해결하기 위해 구조적 변환(GNN)과 잔차 앵커링(Concatenation)을 완전히 분리하여 순차적으로 결합
-
결합 벡터 는 다층 퍼셉트론(MLP)의 입력으로 들어가, "태스크 를 수행하는 과정에서 연산 다음 단계로 를 선택하는 것이 타당한가?"에 대한 적합도 확률 점수 를 산출
-
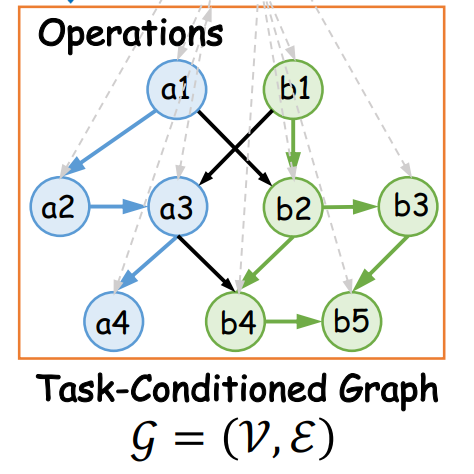
당신의 작업 의미론(Task Semantics)과 제약 조건을 분석하여, 지도 상의 필요한 노드들만 최적의 순서로 연결한 맞춤형 워크플로우 서브그래프를 즉석에서 인스턴스화하겠다."
- 입력 태스크 를 나타내는 가상 태스크 노드(Virtual Task Node) 를 추가하여 태스크 조건부 그래프 를 정의한다.
- 엣지(): 연산들 간의 유효한 구조적·기능적 의존성을 나타냅니다.
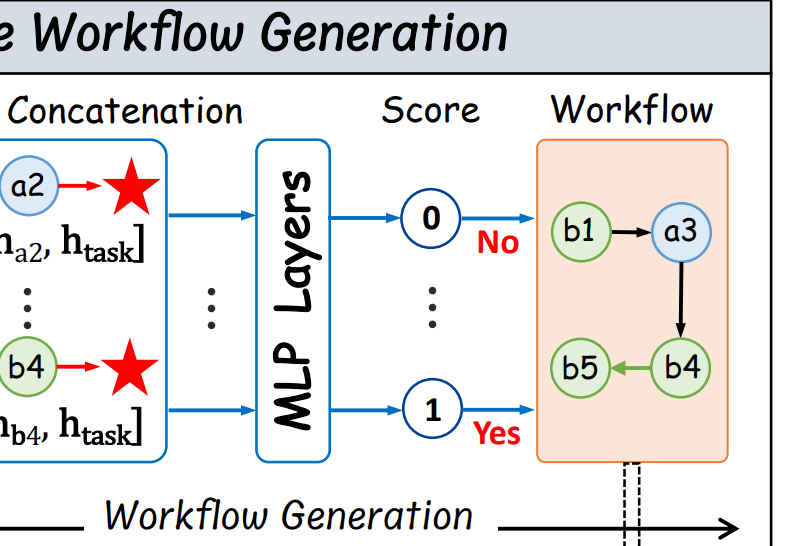
적응형 설계자: "작업 실행 단계로 진입한다. 매 스텝마다 에이전트 모델을 호출하여 새로운 컨텍스트를 생성하겠다."
캐시 관리관: "잠깐, 멈춰라. 새로 생성된 경로를 확인해 보니 노드 A와 B는 이전 작업들에서 이미 거쳐간 경로다. 이 노드들의 Key-Value 연산을 처음부터 다시 수행하면 GPU 메모리가 버티지 못한다."
태스크 의뢰인 (): "하지만 내 작업만의 고유한 문맥도 보존되어야 한다. 이전 기억을 덮어쓰면 추론이 왜곡될 수 있다."
캐시 관리관: "타협안을 제시하겠다. 의 위상 구조를 기준으로 분기점 이전의 공통 노드 캐시는 그대로 공유하고, 당신만의 고유한 분기 노드부터만 새로 연산하여 붙이겠다. 이렇게 하면 메모리 사용량을 4분의 1로 줄이면서도 연산의 정확성을 온전히 유지할 수 있다."
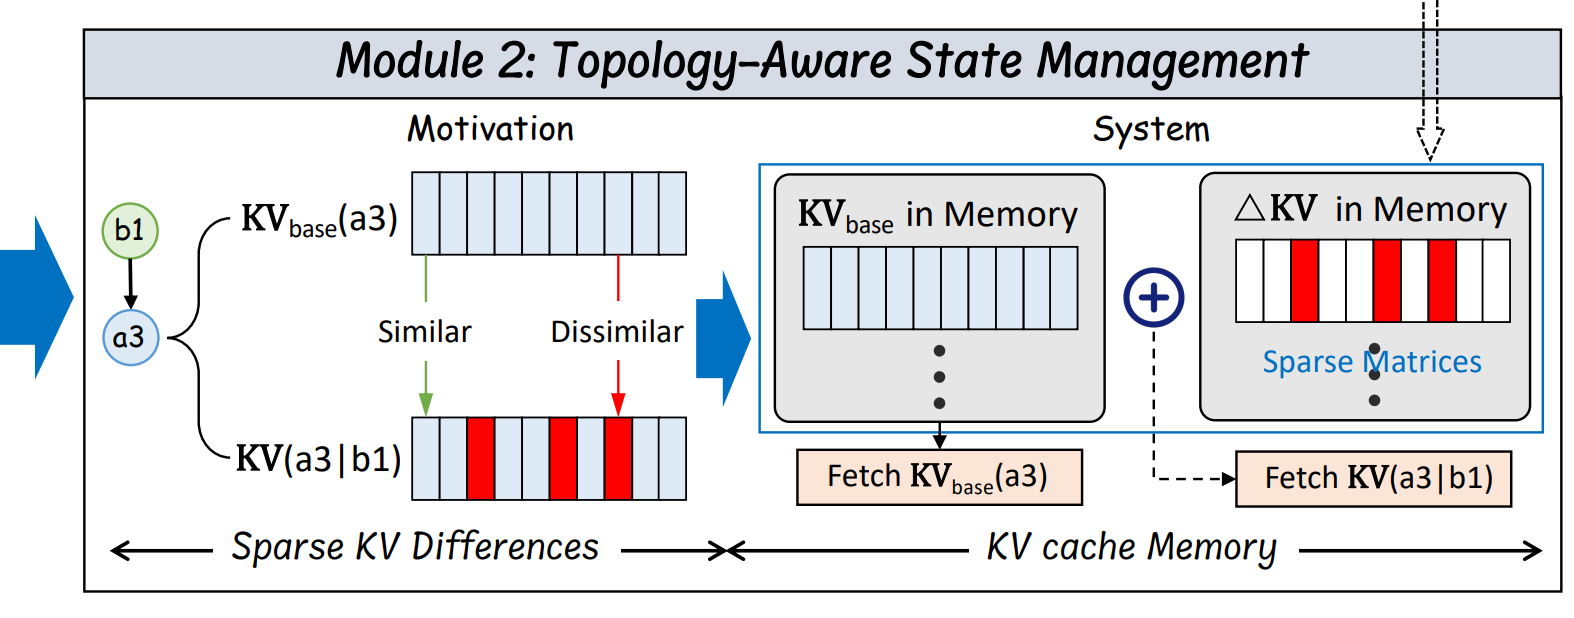
- 저자들의 분석에 따르면, 서로 다른 Prefix(선행 경로)가 주어지더라도 연산 노드 자체의 KV 텐서 변화량은 매우 적으며, Key의 75% 이상, Value의 약 70% 엔트리가 거의 0에 가까운 희소(Sparse)한 차이-Similar (유사 성분, )만을 보입니다
- 잔차의 크기가 임계치 이하이거나, 전체 잔차 에너지(프로베니우스 놈, Frobenius norm)의 하위 5% 이내에 위치하여 잘라내도(Pruning) 전체 의미 보존에 지장이 없는 영역
- 이에 따라 상태 텐서를 기본값과 잔차의 합으로 표현하는 구조적 가설을 설정
- 0이 아닌 값(Non-zero entries)의 인덱스와 값만 보관하는 희소 텐서(Sparse Tensor, 예: COO/CSR 포맷) 형태로 압축 저장됩니다.
- 온라인 서빙 시, VRAM에 올려둔 기본 캐시(Base KV)에 해당 서브그래프 경로에서 발생하는 차이분인 Sparse Topology-aware Residual()만을 가산하여 최종 KV 상태를 복원합니다.즉, 수식적으로는 다음과 같이 문맥화됩니다:
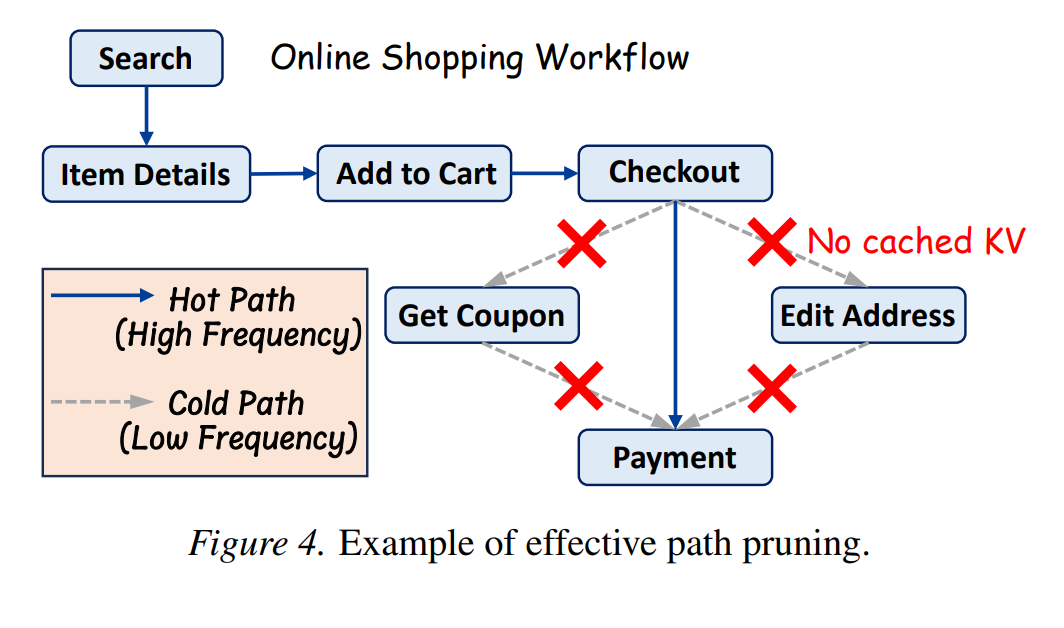
- 발생 가능한 모든 경로의 를 다 들고 있으면 링크 수가 폭발하므로, 호출 빈도가 높은 Hot Path 위주로 링크 상의 를 선별 캐싱하고 빈도가 낮은 Cold Path는 저장을 생략해 메모리 한도를 방어합니다.
논문 GraphFlow: A Graph-Based Workflow Management for Efficient LLM-Agent Serving에서 제시한 주요 성과와 정량적·기술적 결과는 다음과 같이 정리할 수 있습니다.
1. 주요 핵심 성과 (요약)
- 작업 수행 성능 향상: 5개 벤치마크 및 3종의 LLM 백본에 걸쳐 기존 최신 워크플로우/에이전트 베이스라인 대비 평균 약 4.95%p의 성능 향상을 달성했습니다.
- 메모리 사용량 대폭 절감: 제안한 차분 기반 KV 캐시 및 경로 가지치기(Path Pruning)를 통해 KV 캐시 메모리 공간(Memory Footprint)을 약 4배(4x) 절감했습니다.
- 추론 지연 시간(P90 Latency) 단축: 불필요한 연산을 줄인 효율적 서빙으로 엔드투엔드 90th percentile(P90) 추론 지연 시간을 전반적으로 단축했습니다. (다만 15% 내외)
③ KV 캐시 메모리 최적화 (Figure 5, 6, 7 기준)
- Stateful 캐시 대비 메모리 대폭 절감:
- GSM8K: 약 50GB → 약 11GB로 축소
- HotpotQA: 약 85GB → 약 25GB로 축소
- 동시 요청(Batch Size) 확장성:
- Stateful 방식은 배치 크기가 10에서 50으로 증가할 때 메모리가 0.8GB에서 2.4GB 이상으로 급증하는 반면, GraphFlow는 배치 50에서도 0.5GB 미만을 유지하며 완만한 증가세를 보였습니다.
- Path Pruning 효과:
- 비활성/비현실적인 전이 경로를 잘라냄으로써 GSM8K(15.0GB → 11.5GB), MATH(26.0GB → 20.7GB), HotpotQA(29.6GB → 25.4GB) 등 추가적인 메모리 절감을 입증했습니다.