2025년 4월 11일, Cloudflare는 자사 프록시 Pingora에 대한 제보를 받았습니다. 캐시에 응답이 이미 있을 때 프록시가 요청 본문을 끝까지 읽지 않고 넘어갔고, 읽지 않은 데이터가 재사용되는 연결에 남았습니다. 그 데이터가 다음 요청의 일부로 읽히면서 오리진으로 가는 헤더와 URL이 바뀔 수 있었습니다. Cloudflare는 22시간 안에 완화 조치를 넣고 4월 19일 패치를 배포했습니다(CVE-2025-4366). 악용 증거는 없었지만, 요청 밀반입 연구를 이끈 PortSwigger는 이 한 건이 2,400만 개가 넘는 웹사이트를 사이트 전체 탈취 위험에 노출했다고 백서에 적었습니다(PortSwigger의 주장이고, Cloudflare 포스트모템에는 이 수치가 없습니다). 프록시 코드 한 줄이 "요청이 어디서 끝나는가"를 서버마다 다르게 만들었습니다.
이 시리즈의 공격을 실제 쇼핑몰 코드에서 직접 재연하고 막아 보는 인프런 강의가 열렸습니다. 실제 해킹 사고로 배우는 Spring Boot·Express 시큐어 코딩 · 이 글과 이어지는 수업: 11-1, 11-2, 11-3, 11-5
이 글의 범위. 세 기법의 원리와 방어를 다룹니다. 공격 요청 원문, 밀반입 요청 예시, 우회용 URL 문자열, 재현 절차와 도구 사용법은 싣지 않습니다. 원리는 그림과 말로 설명하고, 코드와 설정은 모두 방어 쪽이며 호스트·주소·도메인은 가짜 값입니다. 사실관계는 각 연구 기관·벤더의 공개 자료(2026-11-01 기준)를 따르고, 원문을 직접 확인하지 못한 항목은 [추정]으로 표시합니다.
한눈에 보기
| 기법 | 한 줄 정의 | 대표 사례 | 막는 핵심 | 가장 가까운 OWASP 2025 |
|---|---|---|---|---|
| 파서 차이(URL·경로 해석 혼동) | 검사하는 코드와 사용하는 코드가 같은 입력을 다른 파서로 읽어, 검사한 대상과 실제 대상이 달라진다 | Apache HTTP Server Confusion Attacks(DEVCORE, 2024-08), URL 파서 16종 비교 연구(Claroty·Snyk, 2022-01) | 한 번 파싱한 결과 객체로 검사하고 같은 객체로 사용, 정규화 뒤 검사 | A01 접근 통제 실패, A05 인젝션 |
| HTTP 요청 밀반입(디싱크) | 앞단 프록시와 뒷단 서버가 요청의 끝을 다르게 판단해, 한 요청 안에 다른 요청이 숨어 들어간다 | PortSwigger "HTTP/1.1 must die"(2025-08), Akamai CVE-2025-32094, Cloudflare Pingora CVE-2025-4366 | 프록시→백엔드 구간 HTTP/2, 모호한 요청 거부 | A02 보안 설정 오류, A06 안전하지 않은 설계(느슨) |
| SMTP 밀반입 | 송신 메일 서버와 수신 메일 서버가 메일 본문의 끝을 다르게 해석해, 정상 서버를 거친 위조 메일이 SPF를 통과한다 | SEC Consult 공개(2023-12-18): Exchange Online, GMX·Ionos, Cisco, Postfix·Sendmail | 수신 쪽 bare LF 거부·정규화, MTA 패치, DMARC | A07 인증 실패(느슨) |
세 기법은 대상 프로토콜이 다를 뿐 구조가 같습니다. 같은 바이트를 두 프로그램이 읽고, 둘의 해석이 어긋나는 지점에서 생깁니다. 그래서 이 글에서는 셋을 한 편으로 묶었습니다. 다음 편에서 다룰 웹 캐시 속임도 캐시와 오리진 사이의 같은 문제입니다.
왜 "두 번 해석"이 위험한가
요즘 웹 요청 하나는 보통 여러 프로그램을 거칩니다. 브라우저에서 출발한 요청은 CDN, 로드밸런서, 리버스 프록시를 지나 Spring이나 Node 앱 서버에 닿습니다. 앱 안에서도 입력 검증 코드와 실제로 외부에 요청을 보내는 HTTP 클라이언트는 서로 다른 라이브러리일 때가 많습니다. 메일도 같습니다. 우리 서버가 보낸 메일은 송신 메일 서버(MTA)를 거쳐 상대 회사의 수신 MTA로 들어갑니다.
이 프로그램들은 각자 자기 파서를 갖고 있습니다. 파서는 바이트 덩어리를 "이건 호스트, 이건 경로", "요청은 여기까지", "메일은 여기서 끝" 같은 구조로 바꾸는 부분입니다. 표준 문서(RFC)가 규칙을 정해 두었지만, 실제 구현은 조금씩 다릅니다. 이유는 대개 선의에서 나옵니다.
- 관대함: 오래된 클라이언트나 잘못 만든 장비와도 통신하려고, 표준에 어긋난 입력도 "아마 이런 뜻이겠지" 하고 받아 줍니다.
- 표준의 여러 판: URL만 해도 RFC 3986과 브라우저 쪽 WHATWG URL 표준이 있고, 라이브러리마다 따르는 쪽이 다릅니다.
- 성능: 프록시는 연결을 재사용하고, 필요 없는 본문은 읽지 않고 건너뛰려 합니다.
한 프로그램만 놓고 보면 모두 합리적인 선택입니다. 문제는 두 프로그램이 같은 입력에 대해 다른 결론을 낼 때 생깁니다. 앞 프로그램이 검사하고 뒤 프로그램이 실행하는 구조라면, 공격자는 앞에서는 무해하게 보이고 뒤에서는 다른 뜻이 되는 입력을 만들 수 있습니다. 각 프로그램을 따로 테스트해서는 이 틈이 보이지 않습니다.
1. 파서 차이: 검사한 URL과 쓰는 URL이 다르다
원리
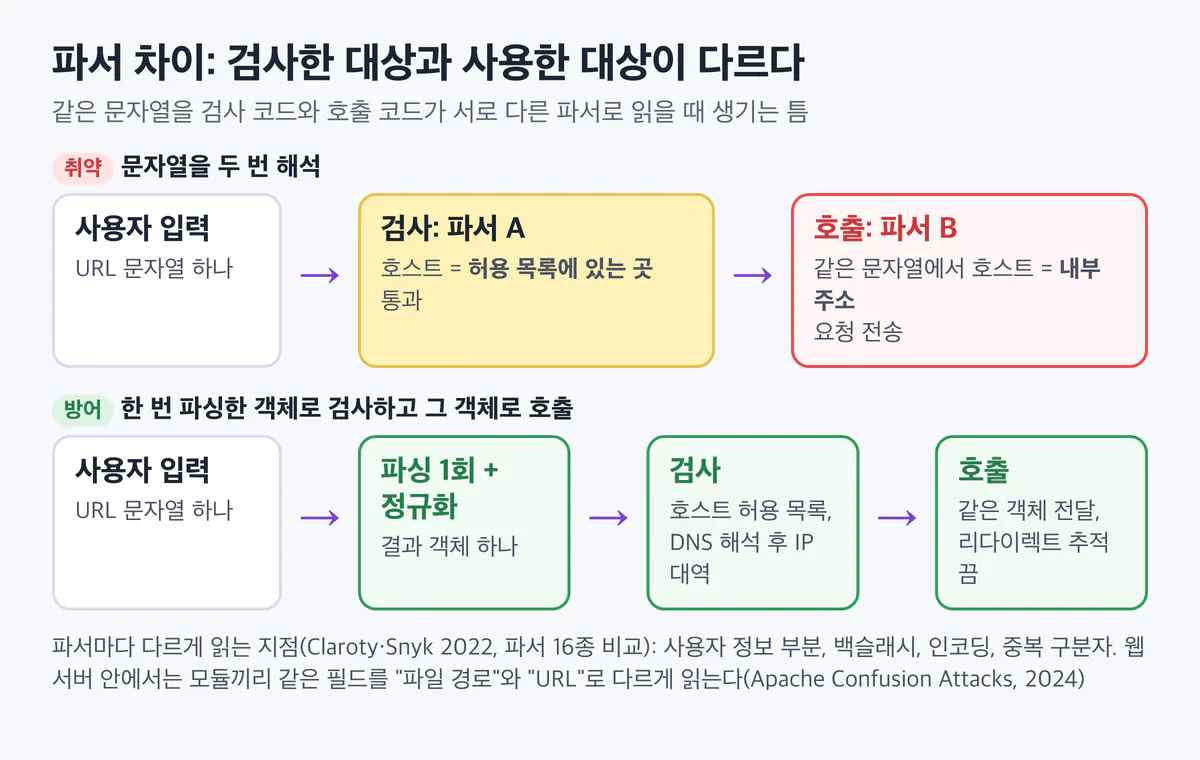
흔한 예부터 보겠습니다. 사용자가 이미지 주소를 입력하면 서버가 그 이미지를 내려받아 썸네일을 만드는 기능이 있다고 합시다. 서버가 아무 주소에나 요청을 보내면 내부망이나 클라우드 메타데이터 주소를 대신 조회해 주는 SSRF(서버 측 요청 위조)가 됩니다. 그래서 개발자는 검사 코드를 넣습니다. "URL을 파싱해서 호스트가 허용 목록에 있을 때만 요청한다."
여기서 틈이 생기는 방식은 이렇습니다.
- 검사 코드는 라이브러리 A로 URL 문자열을 파싱해 호스트를 꺼냅니다. 허용 목록에 있으니 통과합니다.
- 검사를 통과한 원래 문자열이 HTTP 클라이언트(라이브러리 B)로 넘어갑니다.
- 라이브러리 B는 같은 문자열을 자기 방식으로 다시 파싱합니다. 그리고 다른 호스트를 꺼내 그쪽으로 요청을 보냅니다.
두 라이브러리가 엇갈리는 지점은 URL 표준의 구석진 곳입니다. Claroty Team82와 Snyk이 2022년 1월에 Python urllib·urllib3, Java URL·URI, Node url·url-parse, Go net/url, PHP parse_url, curl 등 파서 16종을 비교했더니, 불일치는 다섯 유형으로 정리됐습니다. 이 글에서는 어떤 부분이 문제가 되는지만 짚겠습니다.
- 사용자 정보 부분: URL에는 호스트 앞에 사용자 이름과 비밀번호를 넣는 자리가 있습니다. 거의 쓰지 않는 자리라서, 어디까지가 사용자 정보이고 어디부터가 호스트인지 파서마다 판단이 다릅니다.
- 백슬래시: 표준상 URL 구분자는 슬래시입니다. 브라우저 쪽 표준은 일부 스킴에서 백슬래시도 슬래시처럼 취급합니다. 한 파서는 구분자로, 다른 파서는 일반 문자로 봅니다.
- 인코딩: 퍼센트 인코딩을 언제, 몇 번 푸는지가 다릅니다. 검사할 때는 인코딩된 채로 보고, 사용할 때는 풀린 값으로 보면 서로 다른 문자열을 본 셈입니다.
- 중복 구분자와 빈 구성 요소: 슬래시나 스킴 구분자가 겹치거나 빠졌을 때 어떻게 복구하는지가 다릅니다.
같은 문제가 웹 서버 내부에서도 일어납니다. 2024년 8월 9일 보안 회사 DEVCORE가 Black Hat USA 2024에서 공개한 Apache HTTP Server "Confusion Attacks"가 그 예입니다. Apache는 여러 모듈이 요청 정보를 담은 구조체 하나를 돌려 가며 고칩니다. 어떤 모듈은 한 필드를 "파일 시스템 경로"로 이해하고, 다른 모듈은 같은 필드를 "URL 경로"로 이해했습니다. DEVCORE는 이 혼동을 파일 이름 혼동, 문서 루트 혼동, 핸들러 혼동 세 계열로 정리했습니다. 한 모듈이 접근 통제를 위해 확인한 경로와 다른 모듈이 실제로 연 파일이 다를 수 있었다는 뜻입니다.
왜 OWASP Top 10에 이름이 없나
결과만 보면 OWASP Top 10:2025의 A01 접근 통제 실패(SSRF가 2025판에서 여기로 합쳐졌습니다)나 A05 인젝션에 해당합니다. 하지만 원인인 "파서 두 개가 같은 입력을 다르게 해석한다"는 어떤 항목의 이름에도 없습니다. Top 10은 앱 하나의 결함을 기준으로 위험을 분류하는데, 파서 차이는 두 구성 요소 사이에서만 생깁니다. 검사 코드만 떼어 놓고 보면 문제가 없고, HTTP 클라이언트만 떼어 놓고 봐도 문제가 없습니다. 이 글의 2장(요청 밀반입)과 3장(SMTP 밀반입), 다음 편의 캐시 속임도 모두 이 계열의 변형입니다.
실제 사례
- Apache HTTP Server Confusion Attacks (2024-08-09 공개). DEVCORE가 Black Hat USA 2024에서 발표했습니다. CVE 9건(CVE-2024-38472~38477, CVE-2024-39573 등)이 나왔고, 2024년 7월 1일 나온 2.4.60에서 수정됐습니다. 일부 수정은 하위 호환을 깨서, 업그레이드 뒤 기존 설정이 동작하지 않는 경우가 있었습니다.
- CVE-2024-38475(mod_rewrite)는 실제 악용이 확인됐습니다. 미국 CISA의 "악용이 확인된 취약점(KEV)" 목록에 2025년 5월 1일 등재됐습니다(등재일은 여러 2차 출처가 일치하지만 CISA 원문 페이지는 직접 확인하지 못했습니다 [추정]). 발표부터 등재까지 약 아홉 달이 걸렸습니다. 공개된 웹 서버 취약점은 시간이 지나 실제 공격에 쓰인다는 점을 보여 줍니다.
- URL 파싱 혼동 연구 (2022-01). Claroty Team82와 Snyk이 파서 16종을 비교하고 불일치 다섯 유형을 정리했으며, 그 과정에서 여러 라이브러리에 CVE가 나왔습니다. "검증 함수와 요청 함수가 다른 라이브러리"인 코드가 실제로 흔하다는 점을 확인한 연구입니다.
서버에서 막기
① 코드: 한 번 파싱하고, 그 결과 객체로 검사하고, 같은 객체로 호출한다
방어의 첫 원칙은 간단합니다. 문자열을 두 번 파싱하지 않습니다. 파싱해서 얻은 객체를 검사에도 쓰고 호출에도 씁니다. 검사를 통과한 원래 문자열을 다시 넘기는 순간, 다음 라이브러리가 다르게 읽을 기회가 생깁니다.
// 방어 예시: 파싱 한 번, 같은 객체로 검사와 요청 (호스트는 가짜 값)
static final Set<String> ALLOWED_HOSTS = Set.of("img.partner.example.com");

URI uri = URI.create(userInput).normalize();
if (!"https".equals(uri.getScheme()) || uri.getUserInfo() != null
        || !ALLOWED_HOSTS.contains(uri.getHost())) {
    throw new ForbiddenException();
}
InetAddress addr = InetAddress.getByName(uri.getHost());
if (addr.isSiteLocalAddress() || addr.isLoopbackAddress() || addr.isLinkLocalAddress()) {
    throw new ForbiddenException();
}
HttpClient client = HttpClient.newBuilder()
        .followRedirects(HttpClient.Redirect.NEVER)   // 리다이렉트로 다른 곳에 가지 않게
        .build();
HttpRequest req = HttpRequest.newBuilder(uri).GET().build(); // 문자열 재조립 없이 같은 URI 사용
Python이라면 urlsplit 결과로 검사하고, 요청할 때는 검사한 구성 요소로 다시 조립한 URL을 씁니다. 사용자 정보 부분이 있으면 아예 거부합니다. 이 자리를 정상적으로 쓰는 경우는 드물고, 파서 차이가 가장 자주 생기는 곳이기 때문입니다.
# 방어 예시: urlsplit 결과로 검사하고, 검사한 구성 요소로 다시 조립해 요청 (호스트는 가짜 값)
import ipaddress, socket
from urllib.parse import urlsplit, urlunsplit
import httpx

ALLOWED_HOSTS = {"img.partner.example.com"}

def fetch_image(url_text: str) -> bytes:
    p = urlsplit(url_text)
    if p.scheme != "https" or p.username is not None or p.password is not None:
        raise PermissionError("scheme_or_userinfo")
    host = (p.hostname or "").rstrip(".").lower()
    if host not in ALLOWED_HOSTS:
        raise PermissionError("host_not_allowed")
    port = p.port or 443
    for *_, sockaddr in socket.getaddrinfo(host, port, proto=socket.IPPROTO_TCP):
        ip = ipaddress.ip_address(sockaddr[0])
        if ip.is_private or ip.is_loopback or ip.is_link_local or ip.is_reserved:
            raise PermissionError("internal_ip")
    safe_url = urlunsplit(("https", f"{host}:{port}", p.path or "/", p.query, ""))
    r = httpx.get(safe_url, follow_redirects=False, timeout=5.0)
    r.raise_for_status()
    return r.content
두 예시 모두 DNS 해석 뒤의 실제 IP도 확인합니다. 호스트 이름이 허용 목록에 있어도, 그 이름이 가리키는 IP가 사설 대역이면 막아야 하기 때문입니다. 다만 이 코드에도 틈이 하나 남습니다. 검사할 때 해석한 IP와 HTTP 클라이언트가 접속할 때 다시 해석한 IP가 다를 수 있습니다(검사 시점과 사용 시점의 차이, TOCTOU). 이 틈은 아래 ④의 이그레스 프록시가 막습니다. DNS 쪽 문제는 04편 DNS 리바인딩에서 자세히 다룹니다.
② 코드: 경로는 정규화한 뒤에 검사한다
파일 경로도 같습니다. 순서는 "디코딩 → 정규화(.. 제거, 절대 경로로 변환) → 허용 범위 검사 → 사용"입니다. 검사를 먼저 하고 정규화를 나중에 하면, 검사한 경로와 연 경로가 달라집니다.
# 방어 예시: 정규화한 실제 경로가 허용 디렉터리 안에 있는지 확인한 뒤에 연다
from pathlib import Path
from urllib.parse import unquote

BASE = Path("/srv/app/user-files").resolve()

def open_user_file(rel: str):
    decoded = unquote(rel)                  # 디코딩은 한 번만
    if "%" in decoded or "\\" in decoded:   # 남은 인코딩·백슬래시는 해석 차이를 낳으므로 거부
        raise PermissionError("ambiguous_path")
    target = (BASE / decoded).resolve()     # 심볼릭 링크와 ..까지 풀어 실제 경로를 얻는다
    if not target.is_relative_to(BASE):
        raise PermissionError("outside_base")
    return target.open("rb")                # 검사한 그 Path 객체로 연다
③ 설정: 웹 서버와 프레임워크의 정규화 기본값을 지킨다
- Apache는 2.4.60 이상으로 올립니다.
RewriteRule의 치환 대상에 사용자 입력(요청 경로나 쿼리 일부)이 들어가는 규칙은 하나씩 다시 검토합니다. 2.4.60의 일부 수정은 하위 호환을 깨므로, 업그레이드 전에 스테이징에서 재작성 규칙을 시험합니다. - 경로 정규화 옵션을 앞뒤로 통일합니다. nginx의
merge_slashes(연속 슬래시 합치기)처럼 앞단이 정규화한 경로와 뒷단이 받는 경로가 같은지 확인합니다. 앞단은 합치고 뒷단은 합치지 않으면, 앞단의 경로 기반 접근 통제와 뒷단의 라우팅이 서로 다른 경로를 보게 됩니다. - Spring Security의
StrictHttpFirewall은 기본값을 유지합니다. 인코딩된 슬래시, 세미콜론, 백슬래시 같은 모호한 경로 요소가 든 요청을 기본으로 거부합니다. 레거시 클라이언트 때문에 이 방화벽을 느슨하게 바꾼 코드가 있다면 그 이유가 아직 유효한지 확인합니다.
④ 아키텍처: 아웃바운드는 이그레스 프록시를 거치게 한다
앱 코드의 파서가 아무리 조심해도 마지막 관문은 네트워크에 둡니다. 서버가 밖으로 보내는 요청은 모두 전용 이그레스(나가는 트래픽) 프록시를 거치게 하고, 거기서 IP 수준 허용 목록을 적용합니다. 이그레스 프록시는 앱이 어떤 라이브러리로 URL을 해석했는지와 상관없이 실제로 접속하려는 IP를 봅니다. 앱 서버 자체는 인터넷과 내부망에 직접 나가지 못하게 보안 그룹이나 네트워크 정책으로 막아 둡니다.
탐지 신호
- 아웃바운드 요청 로그에 목적지 IP가 사설 대역이나 클라우드 메타데이터 주소(169.254.169.254)로 찍힌다.
- 접근 로그에 인코딩된 구분자나 비정상 경로가 포함된 요청이 200으로 처리됐다. 정상 사용자는 이런 경로를 거의 만들지 않습니다.
- 이그레스 프록시의 거부 로그에 앱 서버발 요청이 나타난다. 앱 쪽 검사를 통과했는데 네트워크 쪽에서 막혔다면, 앱 검사와 실제 호출 사이에 해석 차이가 있다는 신호입니다.
2. HTTP 요청 밀반입: 요청의 끝을 두 서버가 다르게 본다
원리
HTTP 요청 밀반입(HTTP Request Smuggling)은 디싱크(desync, 동기화 어긋남)라고도 부릅니다. 이해하려면 두 가지 사실을 알아야 합니다.
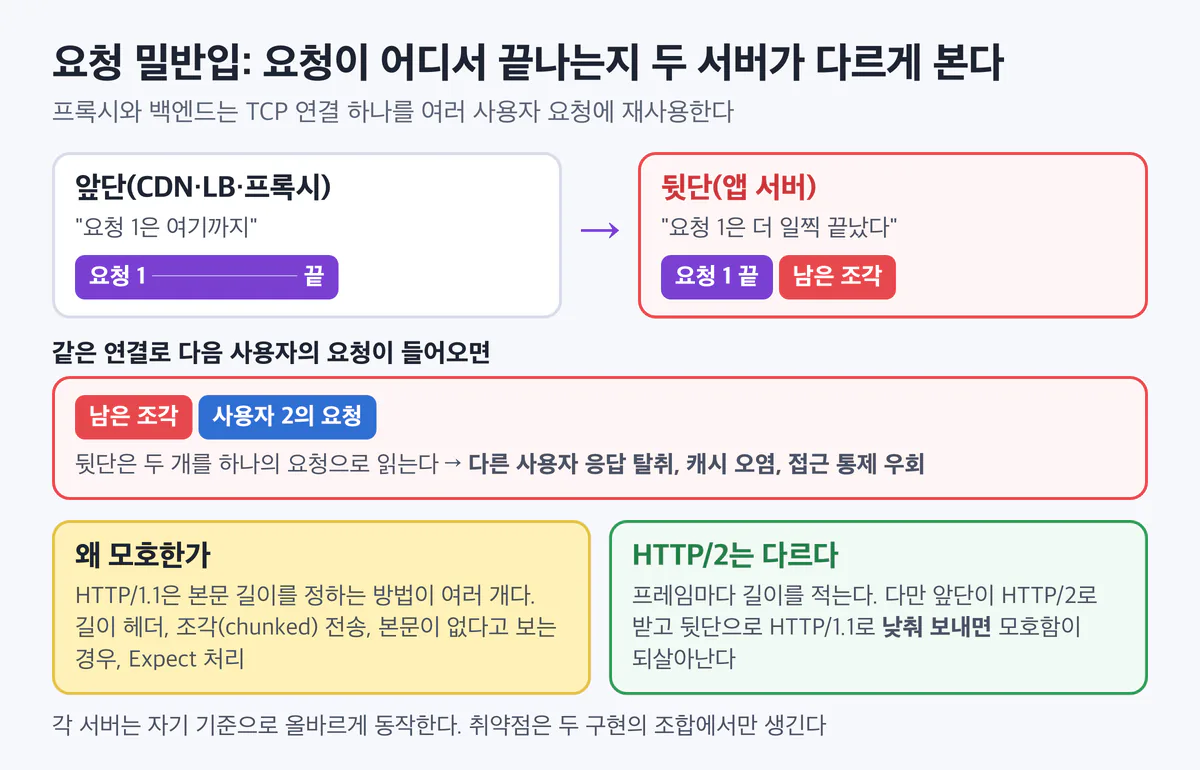
첫째, 프록시와 백엔드는 연결을 재사용합니다. 사용자마다 백엔드로 새 TCP 연결을 여는 것은 비쌉니다. 그래서 CDN이나 로드밸런서는 백엔드와 연결 몇 개를 열어 두고, 여러 사용자의 요청을 한 연결에 차례로 실어 보냅니다. 한 연결 위에 사용자 1의 요청, 사용자 2의 요청, 사용자 3의 요청이 줄지어 흐릅니다. 백엔드는 이 바이트 흐름을 잘라 "여기까지가 요청 하나"라고 판단해야 합니다.
둘째, HTTP/1.1은 요청의 끝을 정하는 방법이 여러 개입니다. 요청 헤더는 빈 줄로 끝나므로 분명합니다. 모호한 쪽은 본문입니다. 본문 길이를 숫자로 적는 Content-Length 헤더가 있고, 본문을 조각으로 나눠 보내며 조각마다 길이를 적는 Transfer-Encoding: chunked 방식이 있습니다. 본문이 없다고 간주하는 경우가 있고, 클라이언트가 본문을 보내기 전에 서버 허락을 기다리는 Expect 처리도 있습니다. 표준(RFC 9112)은 길이 헤더와 조각 전송이 함께 오면 어떻게 처리할지 정해 두었지만, 모든 구현이 표준을 똑같이 따르지는 않습니다.
두 사실을 합치면 문제가 보입니다. 앞단은 "사용자 1의 요청은 여기까지"라고 판단해 전체를 한 요청으로 백엔드에 넘깁니다. 그런데 백엔드는 다른 규칙으로 읽어서 요청이 더 일찍 끝났다고 판단합니다. 그러면 사용자 1(공격자)이 보낸 바이트 중 일부가 처리되지 않고 연결에 남습니다. 백엔드는 그 남은 조각을 다음 요청의 시작으로 봅니다. 곧이어 같은 연결로 사용자 2의 정상 요청이 들어오면, 백엔드는 "공격자가 남긴 조각 + 사용자 2의 요청"을 하나의 요청으로 처리합니다.
결과는 이렇습니다.
- 다른 사용자 응답 탈취: 응답 순서가 어긋나 사용자 2의 응답(쿠키나 개인 정보가 든)이 엉뚱한 사람에게 갑니다.
- 캐시 오염: 어긋난 응답이 앞단 캐시에 저장되면 많은 사용자에게 퍼집니다. 03편의 주제와 이어집니다.
- 접근 통제 우회: 앞단이 막는 경로(관리자 페이지 등)도 밀반입된 조각 안에 들어 있으면 앞단 검사를 거치지 않고 백엔드에 닿습니다.
HTTP/2는 이 모호함이 없습니다. HTTP/2는 데이터를 프레임 단위로 보내고 프레임마다 길이를 적습니다. 요청의 끝도 프레임 플래그로 분명히 표시합니다. 다만 앞단이 브라우저와는 HTTP/2로 통신하고, 백엔드로는 HTTP/1.1로 바꿔서(다운그레이드해서) 보내면 모호함이 되살아납니다. 앞단이 HTTP/2 요청을 HTTP/1.1 바이트로 다시 쓰는 과정에서 길이 정보가 엇갈릴 수 있기 때문입니다.
왜 OWASP Top 10에 이름이 없나
가장 가깝게는 A02 보안 설정 오류나 A06 안전하지 않은 설계입니다. 하지만 각 서버는 "자기 기준으로는" 올바르게 동작합니다. 앞단 프록시만 테스트해도, 백엔드만 테스트해도 결함이 나오지 않습니다. 취약점은 특정 앞단과 특정 백엔드의 조합에서만 생깁니다. 앱 코드의 결함을 중심으로 분류하는 Top 10에는 이런 조합의 문제가 들어갈 자리가 없습니다. PortSwigger는 2025년 연구에서 한 걸음 더 나가, 밀반입의 원인을 개별 구현의 버그보다 HTTP/1.1이라는 프로토콜 자체의 결함으로 봤습니다.
실제 사례
- PortSwigger "HTTP/1.1 must die: the desync endgame" (2025-08-06, Black Hat USA·DEF CON 33). 연구 기간에 받은 버그바운티가 약 35만 달러를 넘었습니다. 주장은 분명합니다. 밀반입은 HTTP/1.1의 프로토콜 결함이고, 앞단에서 백엔드로 가는 구간(업스트림)을 HTTP/2로 바꾸는 것이 유일한 장기 해법이라는 것입니다.
- Akamai CVE-2025-32094 (2025-03 제보, 2025-08-06 권고).
Expect헤더 처리와 본문이 있는 OPTIONS 요청을 전달하는 방식 때문에, 요청 경로에 있던 Akamai 서버 두 대가 같은 요청을 서로 다르게 파싱했습니다. 같은 회사의 서버끼리도 해석이 어긋날 수 있다는 사례입니다. Akamai는 플랫폼 전체에 수정을 배포했고 악용 증거는 없다고 밝혔습니다. 연구 원문에 따르면 Akamai 고객사들이 이 문제로 74건, 총 22.1만 달러의 바운티를 지급했습니다. - Cloudflare Pingora CVE-2025-4366 (2025-04-11 제보, 22시간 안에 완화, 2025-04-19 패치). 글머리의 사례입니다. 캐시 적중 시 읽지 않은 요청 본문을 처리하지 않아 재사용 연결에 데이터가 남았고, 오리진으로 가는 헤더와 URL이 변조될 수 있었습니다. 악용 증거는 없었습니다. "2,400만 개 이상 웹사이트" 수치는 PortSwigger 백서의 주장입니다.
- 후속: Pingora 오픈소스 (2026-03-09). Cloudflare는 Pingora 오픈소스를 인그레스 프록시로 쓰는 배포에서 HTTP/1.x 밀반입 취약점을 추가로 수정(0.8.0)했다고 공개했습니다. Cloudflare CDN 자체는 영향이 없었습니다. 오픈소스 프록시를 가져다 쓰는 팀이라면 이런 공지를 따로 챙겨야 한다는 뜻입니다.
서버에서 막기
① 아키텍처: 프록시→백엔드 구간을 HTTP/2로
가장 근본적인 방어입니다. 앞단에서 백엔드로 가는 구간을 HTTP/2(가능하면 TLS 위의 h2)로 바꾸면 요청 경계가 프레임 길이로 정해지므로 모호함이 사라집니다. PortSwigger가 2025년 8월 기준으로 정리한 업스트림 HTTP/2 지원 현황은 다음과 같습니다.
| 지원 | 제품 |
|---|---|
| 업스트림 HTTP/2 지원 | HAProxy, F5 BIG-IP, Google Cloud Load Balancer, Imperva, Apache(실험적) |
| 당시 미지원 | nginx(proxy_pass), Akamai, CloudFront, Fastly |
| 내부 HTTP/1 사용 | Cloudflare |
# 방어 예시(가짜 값): HAProxy에서 백엔드로 HTTP/2 over TLS
backend app
    server app1 10.0.0.5:8443 ssl verify required ca-file /etc/haproxy/ca.pem alpn h2
여기서 국내 개발자가 자주 놓치는 지점이 있습니다. "우리 사이트는 HTTP/2를 쓴다"는 말은 대개 브라우저와 CDN 사이 이야기입니다. CDN에서 로드밸런서로, 로드밸런서에서 Spring이나 Node 서버로 가는 구간이 HTTP/1.1이라면 그 구간이 공격면입니다. 우리 서비스의 각 홉이 어떤 프로토콜로 통신하는지 그림으로 그려 보는 것부터 시작합니다.
또 하나는 홉 수와 구현 종류를 줄이는 것입니다. CDN, WAF, 로드밸런서, 사이드카 프록시, 앱 서버가 모두 다른 회사의 HTTP 구현이라면, 인접한 두 홉마다 해석이 어긋날 기회가 생깁니다. 파서의 다양성이 곧 공격면입니다. 꼭 필요하지 않은 프록시 단계는 없애고, 가능하면 같은 계열의 구현을 씁니다.
② 설정: 모호한 요청은 고치지 말고 거부한다
앞단과 뒷단 모두 "모호한 요청은 거부" 모드로 둡니다. 관대하게 고쳐서 넘기는 동작이 바로 해석 차이를 만들기 때문입니다. AWS ALB를 쓴다면 PortSwigger가 명시적으로 권고한 두 설정이 있습니다.
# 방어 예시(가짜 값): AWS ALB에서 모호한 요청과 잘못된 헤더를 거부
resource "aws_lb" "app" {
  name                       = "app-alb-example"
  load_balancer_type         = "application"
  subnets                    = ["subnet-0fake0001", "subnet-0fake0002"]
  desync_mitigation_mode     = "strictest"   # 표준에 어긋나는 요청은 모두 거부
  drop_invalid_header_fields = true          # 형식이 잘못된 헤더 필드는 버림
}- 본문이 필요 없는 GET·HEAD·OPTIONS 요청에 본문이 따라오면 거부합니다. Akamai 사례도 본문이 있는 OPTIONS 요청에서 시작했습니다.
- 위 설정으로도 부족하다고 판단되면, 최후 수단으로 업스트림 연결 재사용을 끕니다. 요청마다 연결이 따로 있으면 남은 조각이 다른 사용자 요청에 붙을 수 없습니다. 연결 수립 비용이 늘어 성능이 떨어지므로, 다른 방법이 없을 때만 씁니다.
앱 서버에서도 마지막 줄을 하나 더 둘 수 있습니다. 아래 미들웨어는 본문이 없어야 하는 메서드에 본문 관련 헤더가 있으면 400으로 거부합니다. 앞단 설정을 대신하지는 못하지만, 앞단 설정이 바뀌거나 빠졌을 때 알아챌 수 있는 장치입니다.
# 방어 예시: 본문이 없어야 하는 메서드에 본문 헤더가 오면 거부하는 ASGI 미들웨어
SAFE_METHODS = {"GET", "HEAD", "OPTIONS"}

class RejectBodyOnSafeMethods:
    def __init__(self, app, logger):
        self.app, self.log = app, logger

    async def __call__(self, scope, receive, send):
        if scope["type"] == "http" and scope["method"] in SAFE_METHODS:
            names = [k.lower() for k, _ in scope["headers"]]
            values = {k.lower(): v for k, v in scope["headers"]}
            has_te = b"transfer-encoding" in names
            has_body_len = values.get(b"content-length", b"0") not in (b"", b"0")
            if has_te or has_body_len or names.count(b"content-length") > 1:
                self.log.warning("body_on_safe_method", extra={"path": scope["path"]})
                await send({"type": "http.response.start", "status": 400,
                            "headers": [(b"connection", b"close")]})
                await send({"type": "http.response.body", "body": b""})
                return
        await self.app(scope, receive, send)
거부할 때 Connection: close를 붙여 그 연결을 닫는 것도 중요합니다. 해석이 의심스러운 요청을 받은 연결은 다음 요청에 재사용하지 않는 편이 안전합니다.
③ 코드: HTTP 파서와 프록시를 직접 만들지 않는다
사내 API 게이트웨이나 프록시를 직접 만드는 팀이 있습니다. 소켓에서 바이트를 읽어 헤더를 직접 나누는 코드라면 거의 확실하게 해석 차이가 생깁니다. 검증된 라이브러리(서버 프레임워크나 프록시 엔진) 위에 올리고, RFC 9112의 "길이 헤더와 조각 전송 헤더가 함께 오면 거부하거나 한쪽으로 정규화한다" 규칙이 지켜지는지 회귀 테스트로 고정합니다. 라이브러리를 업그레이드할 때마다 이 테스트가 돌게 하면, 동작이 바뀌었을 때 바로 알 수 있습니다.
④ 패치와 공지 구독
Akamai, Cloudflare 사례처럼 밀반입은 CDN·프록시 제품 쪽에서 고쳐야 하는 경우가 많습니다. 우리가 쓰는 프록시, 로드밸런서, 오픈소스 게이트웨이의 보안 공지를 구독하고, 공지가 나오면 버전을 확인하는 절차를 둡니다.
탐지 신호
- "다른 사람 정보가 보인다"는 고객 문의. 응답이 엉뚱한 사용자에게 간 가장 직접적인 신호입니다. 개인 정보 노출 문의는 보안 사고 후보로 분류해 로그를 함께 봅니다.
- 백엔드 로그의 400 급증. 특히 요청 라인이 깨진(메서드나 경로 자리에 이상한 바이트가 있는) 400입니다. 남은 조각이 다음 요청 앞에 붙으면 이런 모양이 됩니다.
- 프록시 로그와 백엔드 로그의 요청 수 불일치. 같은 시간대에 프록시가 넘긴 요청 수와 백엔드가 처리한 요청 수가 다르면, 어딘가에서 요청 경계가 어긋났다는 뜻입니다.
- 같은 업스트림 연결에서 응답 순서가 어긋나는 타임아웃.
# 탐지 예시: 분 단위로 프록시와 백엔드의 요청 수를 비교 (로그 형식은 가짜 예시)
from collections import Counter

def per_minute(lines, ts_index):
    return Counter(line.split()[ts_index][:16] for line in lines)   # "2026-11-01T10:15"

def compare(proxy_lines, backend_lines, tolerance=0.02):
    p, b = per_minute(proxy_lines, 0), per_minute(backend_lines, 0)
    for minute in sorted(set(p) | set(b)):
        diff = abs(p[minute] - b[minute])
        if p[minute] and diff / p[minute] > tolerance:
            print(f"[mismatch] {minute} proxy={p[minute]} backend={b[minute]}")
헬스 체크나 앞단에서 바로 응답한 요청(캐시 적중, 차단)은 백엔드에 가지 않으므로, 비교하기 전에 두 로그에서 같은 범위의 요청만 남겨야 합니다.
3. SMTP 밀반입: 메일의 끝을 두 서버가 다르게 본다
원리
메일 서버끼리는 SMTP라는 텍스트 프로토콜로 대화합니다. 송신 서버가 "보내는 사람은 누구", "받는 사람은 누구"를 알린 뒤 데이터 전송을 시작하면, 본문을 줄 단위로 보내고 약속된 줄바꿈 시퀀스로 "본문 끝"을 표시합니다. 본문 끝 표시 뒤에는 다음 SMTP 명령이 올 수 있습니다. 같은 연결로 메일 여러 통을 이어서 보낼 수 있기 때문입니다.
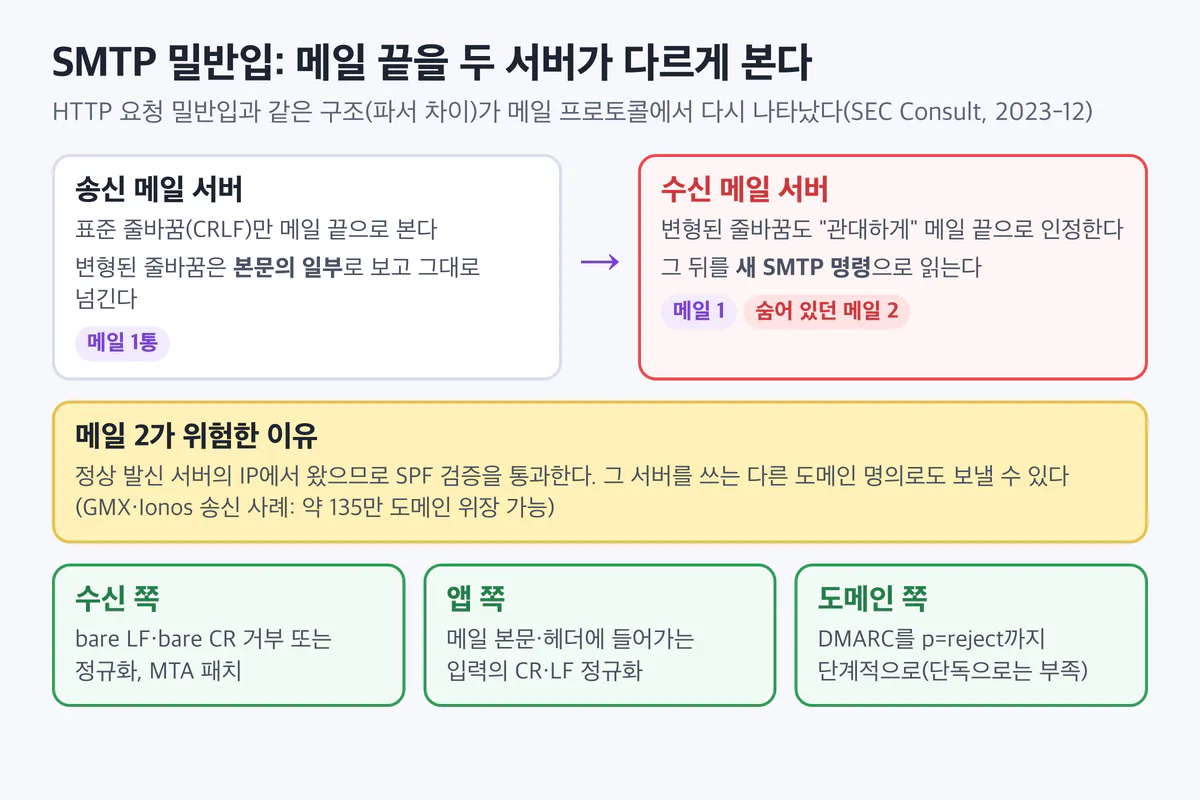
RFC 5321은 이 줄바꿈으로 표준 CRLF(캐리지 리턴 + 라인 피드)만 허용하라고 정합니다. 그런데 일부 서버는 오래된 클라이언트를 배려해 "관대하게" 변형된 줄바꿈(LF만 있거나 CR만 있는 것, bare LF·bare CR)도 줄의 끝으로 인정합니다.
여기서 HTTP 밀반입과 똑같은 구조가 나옵니다.
- 공격자는 정상 메일 서비스(예: 대형 메일 제공자)에 계정을 만들고 메일을 보냅니다. 본문에 변형된 줄바꿈으로 만든 "가짜 본문 끝"과 그 뒤에 이어지는 SMTP 명령을 넣습니다.
- 송신 서버는 표준 CRLF만 본문 끝으로 보므로, 가짜 본문 끝을 본문의 일부로 여기고 그대로 수신 서버에 넘깁니다.
- 수신 서버는 변형된 줄바꿈도 끝으로 인정하므로, 가짜 본문 끝에서 첫 메일을 끝냅니다. 그리고 뒤에 이어진 데이터를 새 SMTP 명령으로 읽어 두 번째 메일을 받습니다.
두 번째 메일이 위험한 이유는 SPF 때문입니다. SPF는 "이 도메인의 메일은 이 IP들에서만 나간다"를 DNS에 적어 두고, 수신 서버가 보낸 IP를 대조하는 장치입니다. 두 번째 메일은 정상 송신 서버의 IP에서 왔으므로, 그 송신 서비스를 쓰는 다른 도메인 명의로 위조해도 SPF를 통과합니다. 수신자 입장에서는 정상 검증을 거친 메일로 보입니다.
왜 OWASP Top 10에 이름이 없나
결과는 발신자 위장이므로 A07 인증 실패에 느슨하게 닿습니다. 하지만 웹 앱 바깥, 메일 서버(MTA)끼리 프로토콜을 해석하는 문제라서 웹 앱 위험 목록인 Top 10의 범위 밖입니다. 그런데 백엔드 개발자와 무관한 이야기는 아닙니다. 회원가입 인증 메일, 비밀번호 재설정 메일, 주문 알림을 보내는 서비스라면 우리 도메인이 위조 대상이 될 수 있고, 사내에 오래된 메일 릴레이를 운영한다면 그 서버가 위조 메일의 경유지가 될 수 있습니다.
실제 사례
- SEC Consult 공개 (2023-12-18). 보안 회사 SEC Consult가 여러 메일 서비스와 소프트웨어를 조사해 공개했습니다.
- Exchange Online(송신 쪽): 2023년 10월 중순 수정.
- GMX·Ionos(송신 쪽): 2023년 8월 10일 수정. 수정 전에는 Ionos가 호스팅하는 약 135만 개 도메인 명의로 위장할 수 있었습니다.
- Cisco Secure Email Gateway(수신 쪽): 기본 설정("Clean")에서 영향이 있었습니다. Cisco는 이 동작을 기능이라고 보고 기본값을 유지했습니다. 운영자가 직접 설정을 바꿔야 한다는 뜻입니다.
- Postfix·Sendmail(수신 쪽): 기본 설정에서 영향이 있었습니다.
- Postfix 대응. Postfix는 대응 문서를 내고 bare LF를 거부하거나 정규화하는
smtpd_forbid_bare_newline옵션을 추가했습니다. 3.9에서 기본 활성화됐고, 이전 지원 브랜치에는 패치 릴리스로 옵션이 들어갔습니다(정확한 버전 번호는 원문 미확인 [추정]). - 관련 CVE. Postfix CVE-2023-51764, Sendmail CVE-2023-51765, Exim CVE-2023-51766이 이 문제와 연결돼 있습니다([추정]: NVD에서 개별 확인하지 못했고, SEC Consult 글에는 CVE 번호가 없습니다).
서버에서 막기
① 설정: 수신 MTA는 bare LF·bare CR을 거부하거나 정규화한다
자체 Postfix를 운영한다면 버전을 확인하고 옵션을 켭니다.
# 방어 예시: Postfix 버전과 bare newline 처리 설정 확인
postconf mail_version
postconf smtpd_forbid_bare_newline
# /etc/postfix/main.cf (방어 예시)
# 표준이 아닌 줄바꿈을 정규화한다. 옵션이 없는 버전이면 먼저 패치 릴리스로 올린다
smtpd_forbid_bare_newline = normalizeCisco 이메일 보안 장비를 쓴다면 CR·LF 처리 옵션이 기본값("Clean")으로 남아 있는지 확인하고 재검토합니다. 벤더가 기본값을 바꾸지 않았으므로, 운영자가 확인하지 않으면 그대로 남습니다.
② 코드: 앱이 보내는 메일의 본문·헤더에서 CR·LF를 정규화한다
앱이 메일을 보낼 때(Spring JavaMailSender, Python smtplib 등) 사용자 입력이 제목이나 본문에 들어간다면, 줄바꿈 문자를 정리합니다. 헤더 값에는 줄바꿈이 아예 없어야 하고, 본문 줄바꿈은 한 형식으로 통일한 뒤 라이브러리가 표준 형식으로 바꾸게 둡니다. 이 처리는 별개 문제인 "메일 헤더 인젝션"(제목 칸에 줄바꿈을 넣어 수신자나 헤더를 추가하는 공격)도 함께 막습니다.
# 방어 예시: 헤더 값의 줄바꿈은 거부하고, 본문 줄바꿈은 한 형식으로 통일한다 (주소는 가짜 값)
import os, smtplib
from email import policy
from email.message import EmailMessage

def header_value(v: str) -> str:
    if "\r" in v or "\n" in v:
        raise ValueError("newline_in_header")
    return v

def body_text(v: str) -> str:
    return v.replace("\r\n", "\n").replace("\r", "\n")   # 섞인 줄바꿈을 LF 하나로

def send_notice(to_addr: str, subject: str, body: str):
    msg = EmailMessage(policy=policy.SMTP)              # 보낼 때 표준 CRLF로 직렬화
    msg["From"] = "no-reply@mail.example.com"
    msg["To"] = header_value(to_addr)
    msg["Subject"] = header_value(subject)
    msg.set_content(body_text(body))
    with smtplib.SMTP("smtp.mail-provider.example", 587, timeout=10) as s:
        s.starttls()
        s.login("app@mail.example.com", os.environ["SMTP_PASSWORD"])
        s.send_message(msg)
SMTP 비밀번호 같은 시크릿(코드와 로그 밖에 숨겨야 하는 값)은 위처럼 환경 변수나 시크릿 관리 서비스에서 읽고, 코드에 적지 않습니다.
③ 아키텍처: 자체 MTA보다 패치가 확인된 발송 서비스, 그리고 DMARC
- 메일 서버 운영이 본업이 아니라면 자체 MTA를 두지 말고, 이 문제에 대한 패치가 확인된 메일 발송 서비스를 씁니다. 사내 Postfix 릴레이를 몇 년째 그대로 두고 있다면, 그 서버가 우리 도메인 사칭 메일의 "정상 경유지"가 될 수 있습니다.
- 도메인에는 DMARC를 설정하고 정책을
p=none(관찰) →p=quarantine(격리) →p=reject(거부) 순서로 단계적으로 올립니다. DMARC는 SPF·DKIM 결과와 보이는 발신 도메인이 일치하는지 확인하게 하는 장치입니다. 다만 SEC Consult는 DMARC만으로는 막히지 않는 경우가 있다고 분명히 적었습니다. 수신 쪽 정규화와 함께 써야 합니다.
; 방어 예시(가짜 도메인): 관찰 단계로 시작하고, 보고서를 확인하며 reject까지 올린다
_dmarc.example.com.  3600  IN  TXT  "v=DMARC1; p=quarantine; rua=mailto:dmarc-reports@example.com"
탐지 신호
- DMARC 집계 보고서에 "SPF는 통과했는데 우리가 보낸 적 없는 메일"이 있다. 우리가 쓰는 발송 서비스의 IP에서 나간 메일인데 발송 기록에 없다면 위조를 의심합니다.
- 메일 서버 로그에서 한 세션의 메시지 수가 기대보다 많다. 앱은 한 연결에 한 통을 보내는데 수신 로그에 두 통이 찍히면 본문 끝 해석이 어긋났다는 신호입니다.
- 고객이 "회사 이름으로 온 이상한 메일"을 신고한다. 신고 메일의 헤더(수신 경로, SPF·DKIM·DMARC 결과)를 보관해 분석합니다.
세 기법을 한 장으로
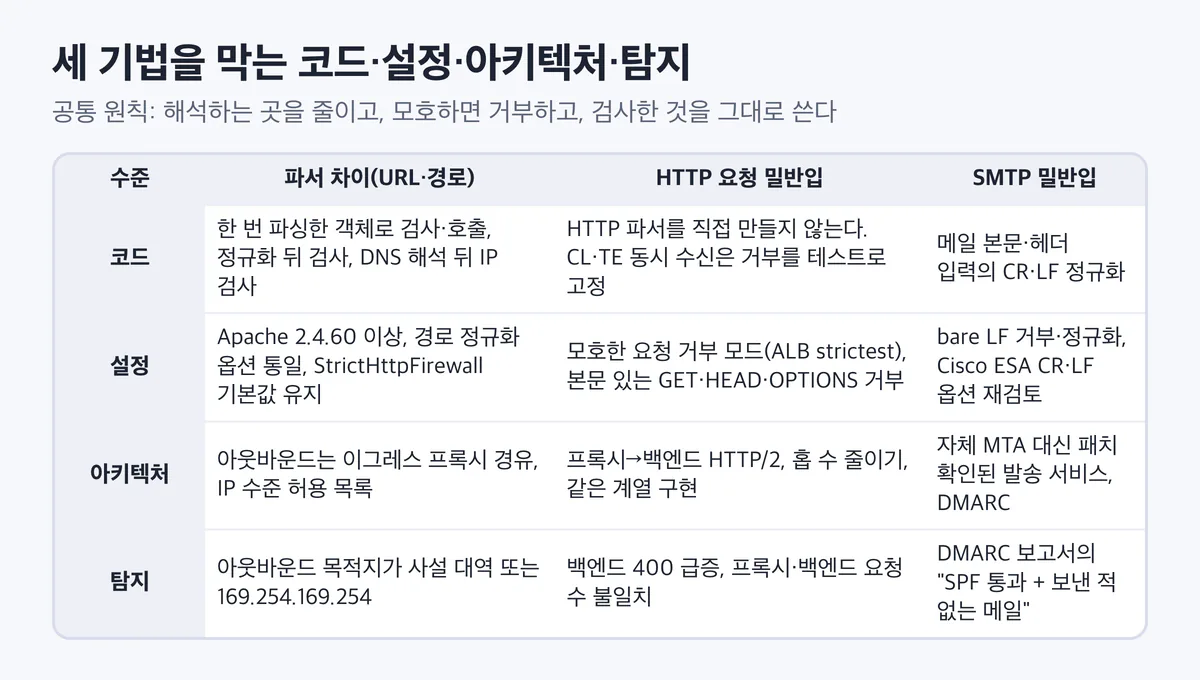
세 기법을 나란히 놓으면 방어도 같은 모양입니다. 코드에서는 한 번 해석한 결과를 끝까지 쓰고, 설정에서는 모호한 입력을 고쳐 주는 대신 거부하고, 아키텍처에서는 해석하는 곳의 수를 줄이거나 해석 방식이 분명한 프로토콜로 바꿉니다. 탐지는 "두 지점의 숫자가 맞는가"를 보는 일입니다. 앱이 검사한 목적지와 이그레스 프록시가 본 목적지, 프록시가 넘긴 요청 수와 백엔드가 처리한 요청 수, 우리가 보낸 메일과 DMARC 보고서에 찍힌 메일을 비교합니다.
설계 원칙으로 정리
- 한 번 해석하고, 그 결과를 끝까지 쓴다. 문자열을 다음 단계로 넘길 때마다 다시 해석될 기회가 생깁니다. 검사한 객체를 그대로 사용하는 코드 구조를 만듭니다.
- 모호하면 거부한다. 관대한 파서가 "아마 이런 뜻"으로 고쳐 주는 순간, 다른 파서와 해석이 갈라집니다. 표준에 어긋난 입력은 400으로 돌려보내고 연결을 닫습니다.
- 해석하는 곳의 수를 줄인다. 프록시 홉, 파싱 라이브러리, 메일 릴레이가 하나 늘 때마다 해석 차이가 생길 조합도 늘어납니다. 필요 없는 단계를 없애고 같은 계열의 구현을 씁니다.
- 경계가 분명한 프로토콜을 쓴다. 프록시→백엔드 HTTP/2처럼 길이가 프레임에 적힌 방식은 모호함 자체를 없앱니다.
- 마지막 관문은 해석과 무관한 곳에 둔다. 이그레스 프록시의 IP 허용 목록처럼, 앞 단계의 파서가 무엇을 믿었든 실제로 일어나는 동작을 보고 막는 장치를 둡니다.
점검 체크리스트
- URL을 받는 기능(웹훅 등록, 이미지 가져오기, 링크 미리보기)에서 검사와 호출이 같은 파싱 결과 객체를 쓴다
- URL의 사용자 정보 부분이 있으면 거부하고, 리다이렉트 추적을 끈다
- 호스트 이름 검사 뒤에 DNS 해석 결과 IP도 사설·루프백·링크 로컬 대역인지 확인한다
- 서버의 아웃바운드 요청은 이그레스 프록시를 거치고, 거기서 IP 수준 허용 목록을 적용한다
- 파일 경로는 디코딩·정규화 뒤에 허용 디렉터리 안인지 검사하고, 검사한 경로 객체로 연다
- Apache는 2.4.60 이상이고, 사용자 입력이 들어가는
RewriteRule을 검토했다 - 우리 서비스의 각 홉(CDN·LB·프록시·앱)이 어떤 HTTP 버전으로 통신하는지 그림으로 정리했다
- 프록시→백엔드 구간을 HTTP/2로 바꿨거나, 바꿀 수 없다면 그 이유와 대체 조치를 기록했다
- 앞단·뒷단이 모호한 요청을 거부하는 모드다(ALB라면
strictest, 잘못된 헤더 버림) - 본문이 있는 GET·HEAD·OPTIONS 요청을 거부한다
- 자체 MTA는 bare LF·bare CR을 거부하거나 정규화하고, 앱이 보내는 메일의 헤더 값에서 줄바꿈을 거부한다
- 도메인 DMARC 정책을 단계적으로 올리고 있고, 집계 보고서에서 "SPF 통과 + 보낸 적 없는 메일"을 확인한다
정리
- 파서 차이, HTTP 요청 밀반입, SMTP 밀반입은 모두 같은 바이트를 두 프로그램이 다르게 읽는 문제입니다. 각 프로그램은 자기 기준으로 올바르게 동작하므로, 한쪽만 테스트해서는 보이지 않습니다.
- 방어에서 물어야 할 것은 "검증 코드를 짰는가"가 아니라 "검증 코드와 실제 호출 코드가 같은 해석을 쓰는가"입니다.
- 요청 밀반입의 장기 해법은 프록시→백엔드 HTTP/2이고, 당장은 모호한 요청 거부 설정과 홉 줄이기로 위험을 줄입니다.
- 메일도 같은 구조입니다. 수신 쪽 정규화, 패치된 발송 서비스, DMARC를 함께 씁니다.
더 깊게
- 인프런 「백엔드 개발자를 위한 서버 보안 실무」 수업
- 1-7 웹 서버 지키기: nginx 설정과 숨김·백업 파일 차단
- 2-2 입력 검증의 원칙: 허용 목록과 스키마 검증
- 2-6 SSRF: 내부망과 클라우드 메타데이터 지키기
- 5-5 정보유출을 막는 네 가지: 이그레스 통제와 DLP
- 6-2 탐지하고 자동으로 막기: 서버와 애플리케이션 이상 징후
- 7-2 악용 중인 취약점 공지를 받고 72시간 안에 반영하는 워크플로
- 관련 글: 서버에게 심부름을 시키면 생기는 일: SSRF 입문, 입력은 언제나 거짓말을 한다: 입력 검증과 인젝션 입문
보안을 더 알고 싶다면
오늘 본 사고의 원인은 대부분 서버와 코드의 기본기에서 막을 수 있는 것들이었습니다. 직접 손으로 막아 보고 싶다면 이런 강의가 있습니다.
실제 해킹 사고로 배우는 Spring Boot·Express 시큐어 코딩
- AI로 자동화된 해킹 시대, 오픈소스 쇼핑몰 코드에서 실제 사고 22건을 재연하고 직접 취약점을 찾아 한 건씩 막습니다.
- OWASP Top 10:2025 전체와 목록 밖 위험 20가지를 102개 수업으로 다루고, 취약점 37개를 모두 막은 최종 소스를 가져갑니다. Spring Boot와 Express 모두 다룹니다.
- 이 글과 이어지는 수업: 11-1, 11-2, 11-3, 11-5
서버 보안 기초부터 차근차근 시작하고 싶다면 이 강의도 있습니다.
백엔드 개발자를 위한 서버 보안 실무: 해킹 방어부터 정보유출 방지까지
- 서버를 공격하는 흐름을 로그로 보고, 내 서버와 Spring·Express 코드에서 직접 막아 봅니다.
- SSH 하드닝, 인젝션, 인증·인가, 시크릿과 개인정보 보호, 침해사고 첫 한 시간까지 8개 섹션 54개 수업입니다.
- 이 글과 이어지는 수업: 1-7, 2-6, 5-5, 7-2
출처와 확인 날짜
수치와 사실은 2026년 11월 1일 기준 공개 자료입니다. 원문을 직접 확인하지 못한 항목(CVE-2024-38475의 KEV 등재일, SMTP 밀반입 관련 CVE 번호와 Postfix 옵션 도입 버전)은 본문에 [추정]으로 표시했습니다. "2,400만 개 이상 웹사이트" 수치는 PortSwigger 백서의 주장이며 Cloudflare 포스트모템에는 없습니다.
- DEVCORE 연구 블로그 — Confusion Attacks: Exploiting Hidden Semantic Ambiguity in Apache HTTP Server: https://blog.orange.tw/posts/2024-08-confusion-attacks-en/
- CISA — Known Exploited Vulnerabilities Catalog: https://www.cisa.gov/known-exploited-vulnerabilities-catalog
- Claroty Team82 — Exploiting URL Parsing Confusion: https://claroty.com/team82/research/exploiting-url-parsing-confusion
- PortSwigger Research — HTTP/1.1 must die: the desync endgame: https://portswigger.net/research/http1-must-die
- Akamai — CVE-2025-32094 HTTP Request Smuggling 보안 권고: https://www.akamai.com/newsroom/security-advisories/cve-2025-32094-http-request-smuggling
- Cloudflare — Resolving a request smuggling vulnerability in Pingora: https://blog.cloudflare.com/resolving-a-request-smuggling-vulnerability-in-pingora/
- Cloudflare — Pingora OSS smuggling vulnerabilities: https://blog.cloudflare.com/pingora-oss-smuggling-vulnerabilities
- SEC Consult — SMTP Smuggling: Spoofing E-Mails Worldwide: https://sec-consult.com/blog/detail/smtp-smuggling-spoofing-e-mails-worldwide/
- Postfix — SMTP Smuggling 대응 문서: https://www.postfix.org/smtp-smuggling.html
이전 글 바이낸스 64억 달러 탈취 해부: EIP-7702 위임과 서명 시스템 장악, 세탁 경로, 그리고 서버·클라이언트 방어법
다음 글 남의 계정 페이지가 캐시에 남는다: 캐시 속임과 캐시 오염 막기
시리즈 전체 목록 해킹 방식 VS 방어 방법 전체 목록
