가입 폭주가 난 날 아침, 의심스러운 IP 하나를 골라 평판 서비스 네 곳에 물었습니다. 첫 번째는 "안전", 두 번째는 "의심 25점", 세 번째는 "위험 100점", 네 번째는 "엔진 2개 탐지"라고 답했습니다. 막아야 할까요, 놔둬야 할까요? 이 시리즈는 그 숫자 하나가 어디서 왔고, 어떻게 섞였고, 무엇을 모르는지 설명할 수 있게 되는 것을 목표로 합니다.
IP 평판이란
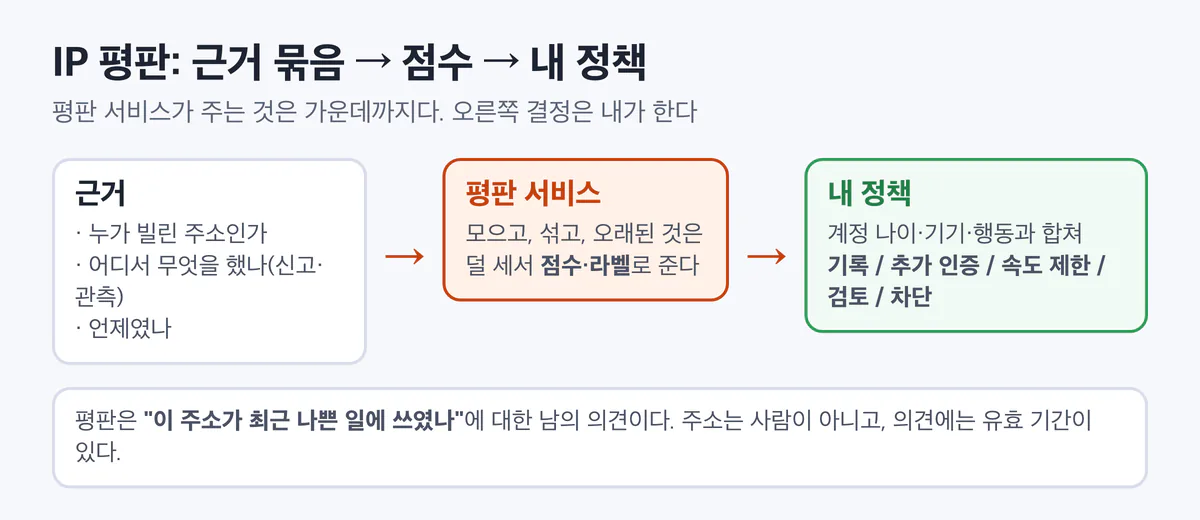
왼쪽에서 오른쪽으로 읽습니다. 왼쪽 "근거"를 모아 가운데 "평판 서비스"가 점수나 라벨로 바꿉니다. 오른쪽 "내 정책"은 평판 서비스가 정해 주지 않습니다. 이 시리즈의 결론이 이 그림 한 장에 있습니다.
IP 평판(IP reputation)은 "이 IP 주소가 최근 나쁜 일에 쓰였나, 또는 사람 집이 아닌 곳에서 왔나"를 점수나 라벨로 나타낸 것입니다. 이 정보를 모아 나눠 주는 일 전체를 흔히 위협 인텔리전스(TI, Threat Intelligence)라고 부릅니다.
평판 점수에는 성질이 세 가지 있습니다.
- 주소에 대한 의견입니다. 사람에 대한 판정이 아닙니다. 한 주소 뒤에 수천 명이 있을 수 있고(통신사 공유 IP), 한 사람이 수천 개 주소를 쓸 수도 있습니다(IPv6, 프록시).
- 남의 의견입니다. 평판 서비스가 본 것, 신고자들이 올린 것, 다른 회사 엔진이 판정한 것입니다. 내 서비스에서 일어난 일이 아닙니다.
- 유효 기간이 있습니다. 어제 공격에 쓰인 클라우드 IP는 오늘 다른 고객의 서버일 수 있습니다. 오래된 근거는 덜 세야 합니다(03편).
그래서 평판 점수는 "막는다/통과시킨다"를 정해 주는 판정이 아니라, 내 판단에 넣는 재료입니다. 이 문장은 앞 시리즈 「해킹 시도를 몇 초 안에 잡는 서버」의 방어선 2-②: IP 평판·위협 인텔리전스의 쓸모와 한계에서 짧게 낸 결론입니다. 그 편에서는 실험실 정상 사용자 50명이 통신사 공유 IP 두 개 뒤에 있어서, IP 기준 규칙을 조금만 낮춰도 한 덩어리로 걸릴 뻔했습니다. 이 시리즈는 그 재료가 어떻게 만들어지는지를 끝까지 파고듭니다.
같은 IP에 왜 다른 대답이 나오나
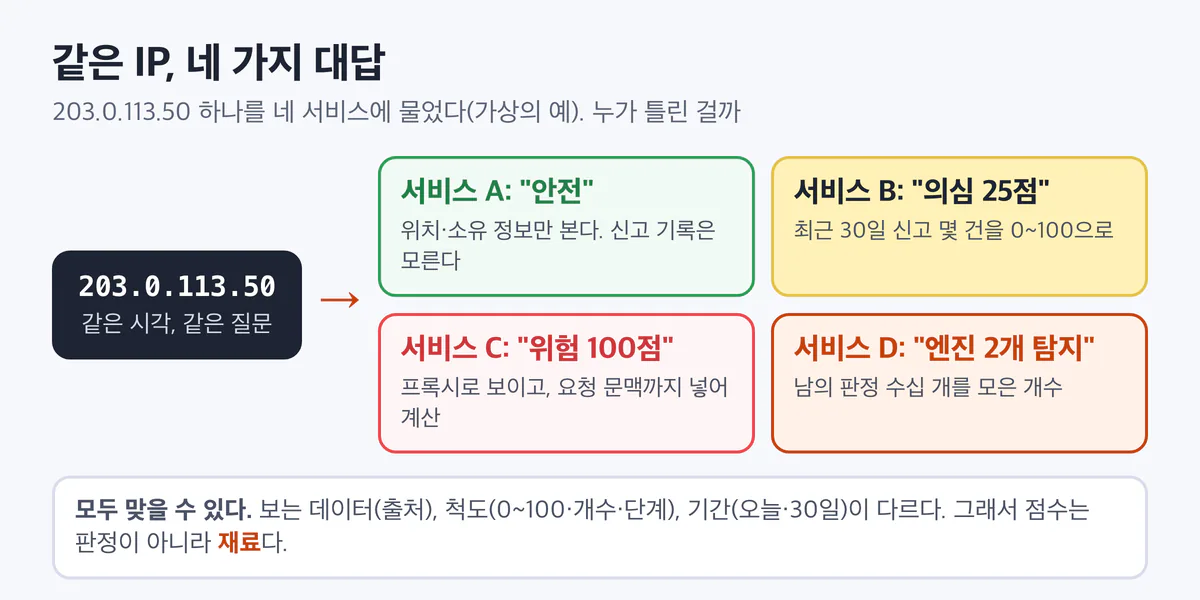
장면을 그림으로 옮겼습니다. 서비스 A~D는 가상의 예이고, 실제 회사 결과가 아닙니다. 왼쪽 검은 상자가 질문, 오른쪽 네 칸이 대답입니다. 각 칸 아래 줄이 "왜 그렇게 답했나"입니다.
네 대답이 모두 맞을 수 있습니다. 다른 점은 네 가지입니다.
| 다른 점 | 예 |
|---|---|
| 데이터 출처 | A는 등록 정보와 위치만 본다. B는 신고만 센다. D는 남의 판정을 모은다 |
| 척도 | 0~100 점수, -10~+10 점수, 다섯 단계 라벨, "엔진 몇 개" 개수 |
| 기간 | 오늘 하루, 최근 30일, 최근 1년 |
| 요청 문맥 | IP만 보는 곳도 있고, 브라우저 정보(user agent)까지 받아 점수를 바꾸는 곳도 있다 |
척도가 다르면 숫자를 바로 비교할 수 없습니다. "25점"과 "엔진 2개"는 단위가 다릅니다. 여러 소스를 합쳐 하나의 판단으로 만드는 일은 13편에서 직접 해 봅니다. 결과를 숫자 하나가 아니라 근거 묶음({"level":"review","reasons":["hosting_provider","abuse_reports_30d=12"]} 같은 형태)으로 남기는 것이 핵심입니다.
그래서 이 시리즈가 보는 세 가지 축
- 데이터가 어디서 오는가. 솔루션마다 데이터를 모으는 자리가 다릅니다. 등록 정보, 자기 장비의 관측, 고객 신고, 미끼 서버, 능동 스캔, 남의 엔진 결과. 이것이 정확도와 맹점을 거의 다 정합니다(02편).
- 점수는 판정이 아니다. 통신사 공유 IP(CGNAT)·주거 프록시·클라우드 IP 재사용 때문에 "나쁜 IP"는 사람이 아니라 어느 시각, 어느 자리에서 일어난 사건입니다(03편).
- 연동은 설계 문제다. 로컬 DB냐 API냐, 캐시는 얼마나, 외부 장애 때는 어떻게, 사용자 IP를 밖으로 보내도 되나. 도구 선택보다 이 결정이 더 오래 갑니다(12~14편).
웹 IP 평판과 이메일 발송 IP 평판
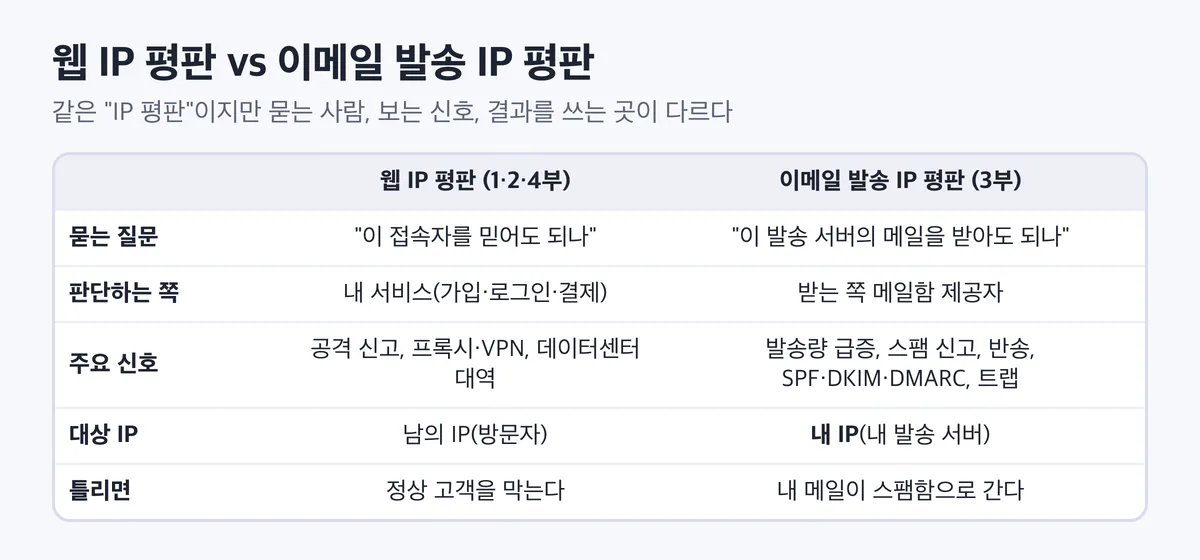
표의 세로줄 둘을 비교합니다. 이름은 같은 "IP 평판"이지만, 넷째 줄 "대상 IP"가 정반대입니다.
웹 IP 평판은 내 서비스가 방문자에 대해 묻는 것입니다. "이 로그인 시도를 믿어도 되나", "이 가입이 봇인가". 판단은 내가 하고, 보는 IP는 남의 것입니다. 틀리면 정상 고객을 막습니다.
이메일 발송 IP 평판은 받는 쪽(Gmail·Outlook 같은 메일함 제공자)이 내 발송 서버에 대해 묻는 것입니다. 판단은 남이 하고, 평가받는 IP는 내 것입니다. 발송량이 갑자기 늘거나, 스팸 신고가 많거나, SPF·DKIM·DMARC 인증이 맞지 않으면 평판이 떨어지고 내 메일이 스팸함으로 갑니다. 공유 발송 IP를 쓰면 같은 IP를 쓰는 다른 발송자의 평판을 물려받습니다.
두 세계는 도구도 다릅니다. 웹 쪽은 평판 API·DB 파일·차단 목록을, 이메일 쪽은 DNSBL(DNS로 묻는 차단 목록), 메일함 제공자가 주는 발송자 대시보드, DMARC 집계 보고서를 씁니다. 이메일 평판은 3부(10~11편)에서 따로 다룹니다.
시리즈 지도: 데이터를 어디서 모으나
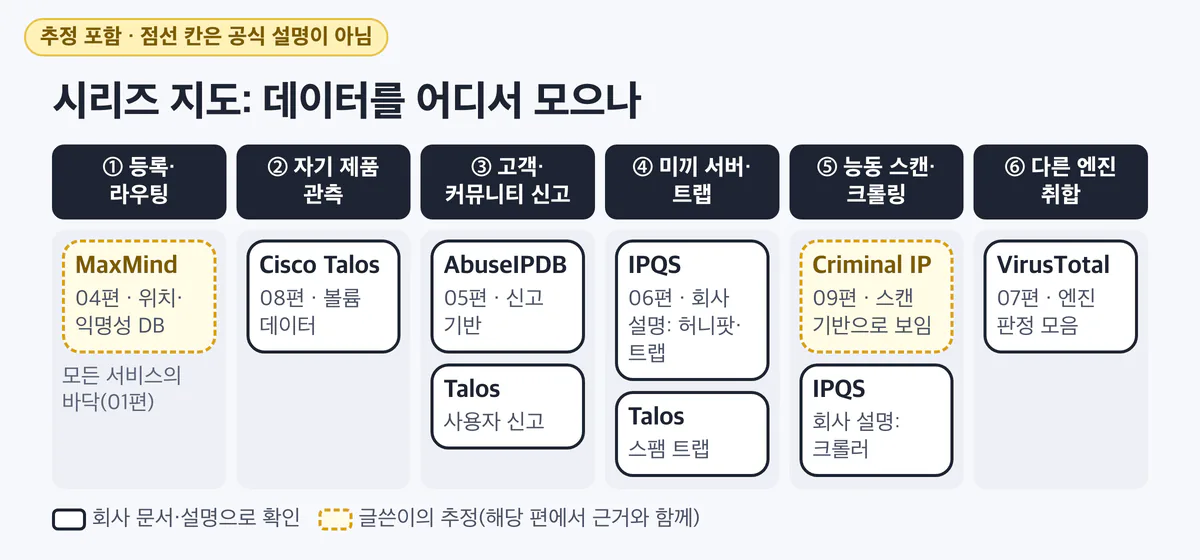
가로로 놓인 여섯 칸이 데이터를 모으는 자리입니다(02편에서 하나씩 그립니다). 각 칸 아래 상자가 그 자리를 주로 쓰는 솔루션입니다. 흰 상자·검은 실선은 회사 문서나 회사 설명으로 확인한 배치, 노란 점선 상자는 글쓴이의 추정입니다. 한 솔루션이 여러 칸에 나올 수 있습니다.
2부에서 해부할 여섯 솔루션은 성격이 다 다릅니다.
| 편 | 솔루션 | 성격 | 지도에서 |
|---|---|---|---|
| 04 | MaxMind | 위치·익명성 DB, 거래 위험 점수(minFraud) | ① 등록·라우팅 쪽(데이터 출처는 추정) |
| 05 | AbuseIPDB | 커뮤니티 신고 기반 평판 | ③ 신고 |
| 06 | IPQualityScore(IPQS) | 사기 점수, 프록시·봇 판별 | ④ 미끼·트랩, ⑤ 크롤러(회사 설명) |
| 07 | VirusTotal | 여러 엔진의 판정 취합 | ⑥ 취합 |
| 08 | Cisco Talos | 자기 장비 관측으로 만든 메일·웹 평판 | ② 자기 제품, ③ 신고, ④ 트랩 |
| 09 | Criminal IP | 국산 CTI, 공격 표면 관리(ASM) | ⑤ 스캔(추정) |
몇 가지는 문서로 확인됩니다. AbuseIPDB는 점수를 "신고한 사용자들을 바탕으로 계산한 평가"라고 설명합니다. VirusTotal의 IP 객체는 엔진별 판정(last_analysis_results)을 나란히 보여 줍니다. Cisco 기술 문서는 SenderBase(Talos의 메일 평판) 점수에 스팸 트랩, 공개 차단 목록, 사용자 신고, 볼륨 데이터 같은 변수가 들어간다고 적습니다. IPQS는 자체 허니팟·트랩·크롤러로 모은다고 회사가 설명합니다. 회사 설명은 회사의 주장으로만 인용합니다.
MaxMind와 Criminal IP가 데이터를 어떻게 모으는지는 이 글을 쓰는 시점에 공식 설명을 다 확인하지 못했습니다. 그래서 노란 점선으로 두었고, 해당 편에서 단서와 함께 다시 봅니다.
이 시리즈의 표시 약속: 확인한 것과 추정한 것
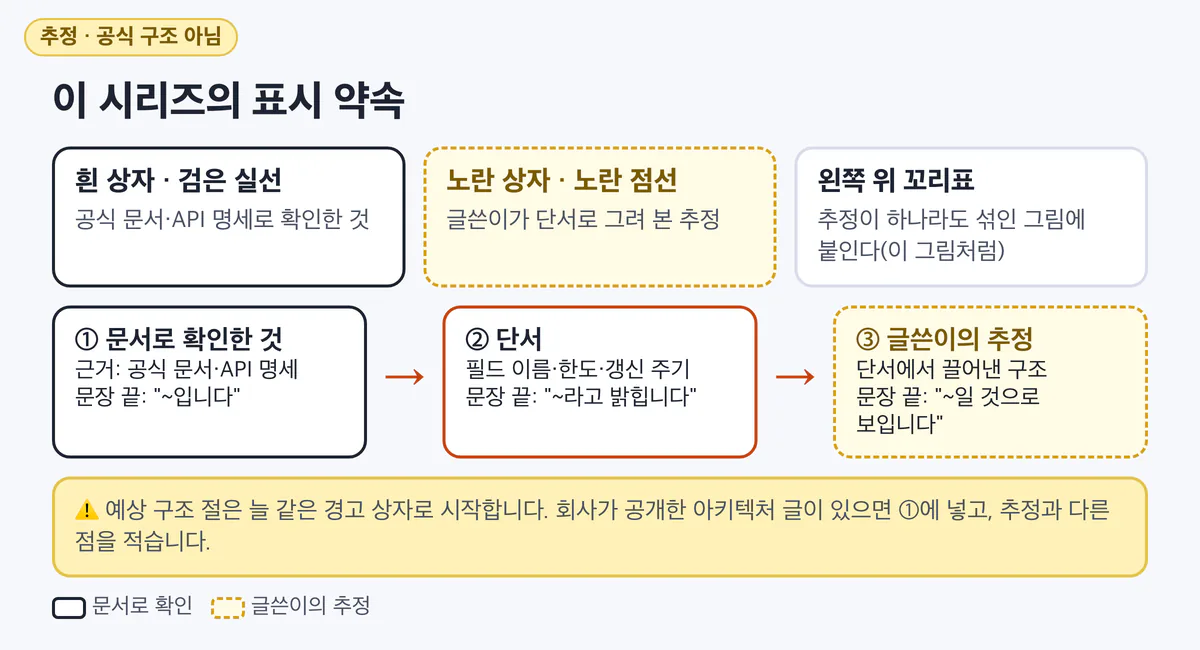
윗줄은 그림의 색 약속, 아랫줄은 글의 세 칸 약속입니다. 이 그림 왼쪽 위에도 꼬리표가 붙어 있습니다. 노란 점선 상자가 하나라도 들어간 그림에는 늘 이 꼬리표를 붙입니다.
2부의 각 솔루션 편에는 "예상 구조" 절이 있습니다. 회사는 내부 구조를 공개하지 않는 경우가 많습니다. 그래도 공개 문서, API 응답 필드 이름, 요금제 한도, 갱신 주기에는 단서가 남습니다. 그 단서로 "이렇게 만들었을 것"이라고 그려 보면, 점수의 성질(얼마나 신선한지, 왜 틀리는지)이 훨씬 잘 보입니다.
대신 추정을 사실처럼 쓰지 않기 위해 세 가지를 약속합니다.
① 예상 구조 절은 늘 같은 상자로 시작합니다.
⚠️ 글쓴이의 추정입니다. 아래 구조도와 흐름은 이 회사의 공식 아키텍처가 아닙니다. 공개 문서, API 응답 필드, 제품 설명에서 보이는 단서로 글쓴이가 "이렇게 만들었을 것"이라고 그려 본 그림입니다. 실제 구현은 다를 수 있습니다.
② 사실과 추정을 세 칸으로 나눕니다.
| 칸 | 근거 | 문장 끝 |
|---|---|---|
| 문서로 확인한 것 | 공식 문서·API 명세(링크·확인 날짜) | "~입니다" |
| 단서 | 응답 필드 이름, 요금제 한도, 갱신 주기, 회사가 밝힌 수집 방식 | "~라고 밝힙니다" |
| 글쓴이의 추정 | 위 단서에서 끌어낸 구조 | "~일 것으로 보입니다", "~라고 추정합니다" |
추정 칸에는 "왜 그렇게 보는지"를 단서와 짝지어 씁니다. 예를 들면 이렇습니다.
| 단서 | 그래서 이렇게 보인다(추정) |
|---|---|
조회 때 maxAgeInDays로 기간을 고를 수 있다 | 점수를 미리 굳혀 두지 않고 조회 시점에 기간 안의 신고로 계산할 것으로 보입니다 |
| 무료 요금제의 차단 목록 조회가 하루 5번이다 | 목록을 미리 만들어 두고 나눠 주는 배치 구조일 것으로 보입니다 |
응답에 usageType 같은 회선 성격 필드가 있다 | 등록 정보(RIR·ASN)를 따로 붙이는 단계가 있을 것으로 보입니다 |
③ 그림에도 표시합니다. 추정이 들어간 그림은 노란 점선 상자와 왼쪽 위 꼬리표를 쓰고, 그림 설명(alt)에 "글쓴이가 추정한"을 넣습니다. 회사가 아키텍처 글을 공개했다면 그것을 "문서로 확인한 것"에 넣고 추정과 비교합니다.
하지 않는 것도 정해 둡니다. 내부 구조를 알아내려고 서비스를 대량으로 찔러 보지 않습니다. 유출 자료나 전직자 이야기를 쓰지 않습니다. "가장 정확한" 같은 마케팅 문구는 "회사는 ~라고 설명합니다"로만 옮깁니다.
03편의 점수 계산식처럼 설명용 모형도 나옵니다. 그런 그림에는 회색 꼬리표 "설명용 모형 · 어느 회사의 공식도 아님"을 붙입니다. 추정과는 다른 뜻입니다. 추정은 "그 회사가 이렇게 했을 것", 설명용 모형은 "원리를 보려고 글쓴이가 만든 장난감"입니다.
이 시리즈에서 만드는 것
읽고 끝나는 글이 아니라, 끝나면 손에 남는 것이 있게 했습니다.
| 결과물 | 무엇 | 편 |
|---|---|---|
| 데이터 출처·판정 방식·제공 형태 비교표 | 여섯 솔루션을 같은 칸으로 나란히 | 15 |
| 솔루션별 예상 시스템 구조도 | 02편의 공통 구조를 회사별 단서로 채운 그림(추정 표시) | 04~09 |
| 평판 모으기 서비스 | 여러 소스를 받아 하나의 위험 등급과 이유 목록으로 돌려주는 로컬 서비스. 캐시, 장애 때 정책, 사용자 IP를 밖으로 보내지 않는 모드 포함 | 13 |
| 정책표 | 가입·로그인·결제·이벤트 화면마다 점수를 어떤 대응(기록·추가 인증·속도 제한·검토·차단)으로 바꿀지 | 14 |
| 이메일 발송 IP 점검 목록 | SPF·DKIM·DMARC, PTR, 차단 목록, DMARC 집계 보고서 읽기 | 10~11 |
| 도입 체크리스트 | 고를 때 물어야 할 여덟 가지(갱신과 감쇠, 오탐과 이의 제기, 제공 형태, 개인정보, 요금·약관, 장애, 설명 가능성, 검증) | 12 |
1부(00~03)는 이 결과물을 읽기 위한 공통 언어입니다. 01편의 공개 정보, 02편의 수집 자리와 공통 구조, 03편의 감쇠·가중치·공유 IP를 알고 나면, 2부의 솔루션 문서를 읽을 때 "이 필드는 어느 칸에서 왔나"가 보입니다.
실습과 실측의 약속
글에 붙인 출력은 모두 실제로 돌린 결과이고, 원문을 lab/results/에 둡니다. 다만 이 시리즈는 유료이거나 키가 필요한 외부 API를 글쓴이 환경에서 호출하지 않았습니다. 그런 곳에서는 호출 명령의 모양과 공식 문서의 응답 형식만 보여 줍니다. 실습에 쓰는 IP는 문서용 주소(192.0.2.0/24, 198.51.100.0/24, 203.0.113.0/24, 2001:db8::/32)와 공개 리졸버(8.8.8.8, 1.1.1.1), 공개 시험 데이터(MaxMind 테스트 DB)에 들어 있는 주소뿐입니다.
평판을 방어에 쓰는 법만 다룹니다. 탐지를 피하는 법, 점수를 올리는 요령, 차단 목록을 피하는 법, 스팸 필터를 피하는 발송 기법은 다루지 않습니다.
어떻게 읽나
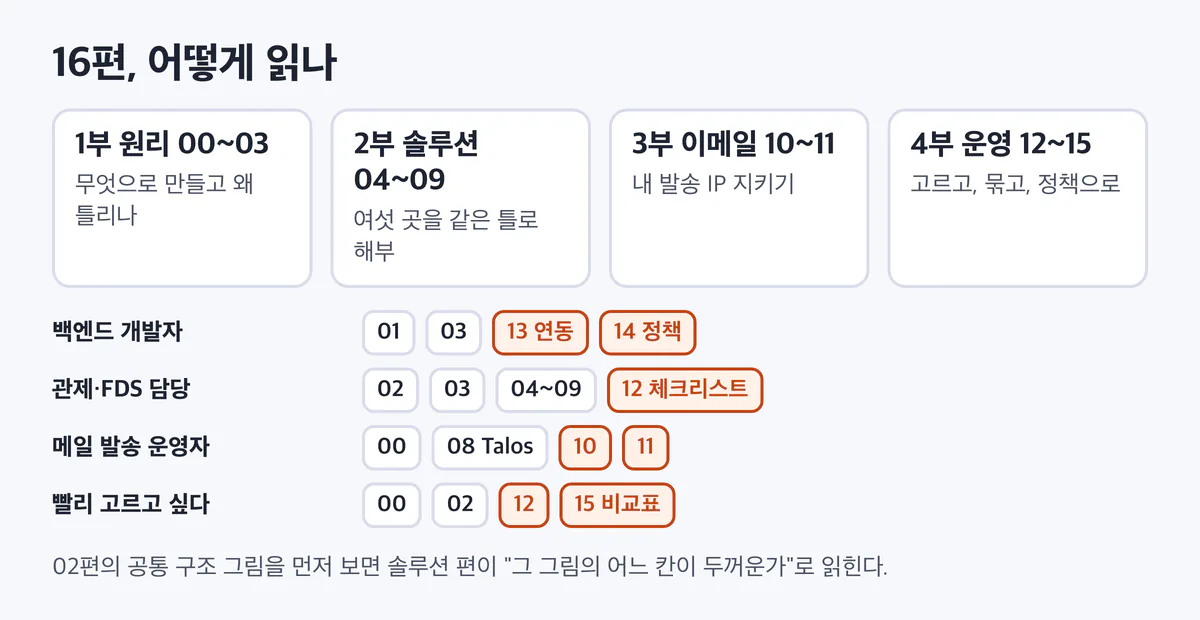
윗줄이 시리즈의 네 부, 아래 네 줄이 역할별 추천 경로입니다. 주황 칩이 그 역할에서 가장 먼저 쓸모가 있는 편입니다.
| 부 | 편 | 질문 |
|---|---|---|
| 1부 원리 | 00~03 | IP 평판은 무엇으로 만들고, 왜 틀리나 |
| 2부 솔루션 해부 | 04~09 | 여섯 솔루션은 각자 무엇을 보고, 어떻게 만들었을까 |
| 3부 이메일 평판 | 10~11 | 메일함 제공자는 발송 IP를 어떻게 판단하나 |
| 4부 도입과 운영 | 12~15 | 어떻게 고르고, 묶고, 판정에 쓰나 |
- 백엔드 개발자라면 01(IP 기초) → 03(왜 틀리나) → 13(여러 소스 묶기) → 14(정책)로 바로 가도 됩니다.
- 관제·FDS 담당이라면 02의 공통 구조를 먼저 보고 2부를 읽은 뒤 12편 체크리스트로 갑니다.
- 메일 발송 운영자라면 이 편의 웹·이메일 비교를 보고 08(Talos) → 10 → 11로 갑니다.
- 빨리 고르고 싶다면 02 → 12 → 15편 비교표로 갑니다.
어느 경로든 02편의 공통 구조 그림을 한 번 보고 가면 좋습니다. 2부의 솔루션 편은 모두 "그 그림의 어느 칸이 두꺼운가"로 설명합니다.
오탐과 한계
이 시리즈 자체의 한계를 먼저 적어 둡니다.
- 예상 구조는 틀릴 수 있습니다. 표시 약속은 틀림을 없애 주지 않고, 독자가 어디까지 믿을지 고를 수 있게 할 뿐입니다.
- 문서는 바뀝니다. 요금제 한도, 필드, 점수 단계는 회사가 언제든 바꿉니다. 모든 숫자에 확인 날짜를 붙였지만, 도입 전에는 원문을 다시 보세요.
- 글쓴이는 유료 API를 호출하지 않았습니다. 그래서 "실제 응답이 문서와 다른지"는 확인하지 못했습니다.
- 평판 점수의 정확도를 비교하지 않습니다. 어느 서비스가 "더 정확한지"는 내 트래픽으로 재야 알 수 있습니다(12편 ⑧ 섀도 모드).
실무 체크
- 평판 점수를 받으면 "이 숫자의 출처·척도·기간"을 한 줄로 적어 둡니다. 셋 중 하나라도 모르면 그 숫자로 차단하지 않습니다.
- 웹 평판(남의 IP)과 이메일 평판(내 IP)을 담당·도구·지표로 나눠 관리합니다.
- 평판 결과를 로그에 점수 하나가 아니라 이유 목록과 함께 남깁니다. 고객 문의에 답할 때 필요합니다.
정리
- IP 평판은 "이 주소가 최근 나쁜 일에 쓰였나"에 대한 남의 의견입니다. 판정이 아니라 재료입니다.
- 같은 IP에 다른 대답이 나오는 이유는 데이터 출처, 척도, 기간, 요청 문맥이 다르기 때문입니다.
- 웹 평판은 내가 남의 IP를, 이메일 평판은 남이 내 IP를 판단합니다.
- 여섯 솔루션은 데이터를 모으는 자리가 다릅니다. 그 자리가 강점과 맹점을 정합니다.
- 회사 구조에 대한 추정은 ⚠️ 상자, 노란 점선, 꼬리표로 늘 표시합니다.
출처와 확인 날짜
모든 링크는 2026-10-31에 확인했습니다.
- AbuseIPDB API 문서(점수 설명,
maxAgeInDays, 요금제별 한도): https://docs.abuseipdb.com/ - VirusTotal IP 주소 객체(
last_analysis_results,reputation): https://docs.virustotal.com/reference/ip-object - Cisco Talos 평판 센터 개요(이메일·웹 평판 기준): https://support.talosintelligence.com/docs/rep-overview/
- Cisco 기술 문서(SenderBase 입력과 점수 범위): https://www.cisco.com/c/en/us/support/docs/security/email-security-appliance/117919-technote-cdc-00.html
- IPQualityScore 프록시 탐지 API 개요(회사가 밝힌 수집 방식): https://www.ipqualityscore.com/documentation/proxy-detection-api/overview
- DMARCeye 용어집, IP 평판(이메일 발송 IP 평판 요소): https://dmarceye.com/ko/glossary/ip-reputation
- 앞 시리즈, 방어선 2-② IP 평판·위협 인텔리전스의 쓸모와 한계: https://velog.io/@bumicklee/realtime-detect-08-ip-reputation
다음 글 IP 하나에서 알 수 있는 것: RIR·WHOIS·ASN·역방향 DNS·위치
시리즈 전체 목록 IP 평판은 어떻게 만들어지고, 어떻게 써야 하나 전체 목록
