신고가 한 건도 없는 IP에 어느 서비스는 "위험"을 붙였고, 신고가 열 건 넘는 IP에 다른 서비스는 아무 말도 하지 않았습니다. 이상하지 않습니다. 앞 서비스는 그 IP를 미끼 서버에서 봤고, 뒤 서비스는 신고만 셉니다. 평판 점수를 읽으려면 먼저 "이 서비스는 데이터를 어디서 모으나"를 알아야 합니다. 이번 편은 그 자리 여섯 가지와, 모은 데이터가 점수가 되어 나에게 오기까지의 공통 흐름을 그립니다. 2부의 솔루션 편은 모두 이 편의 그림을 기준으로 설명합니다.
여섯 가지 수집 자리 한눈에
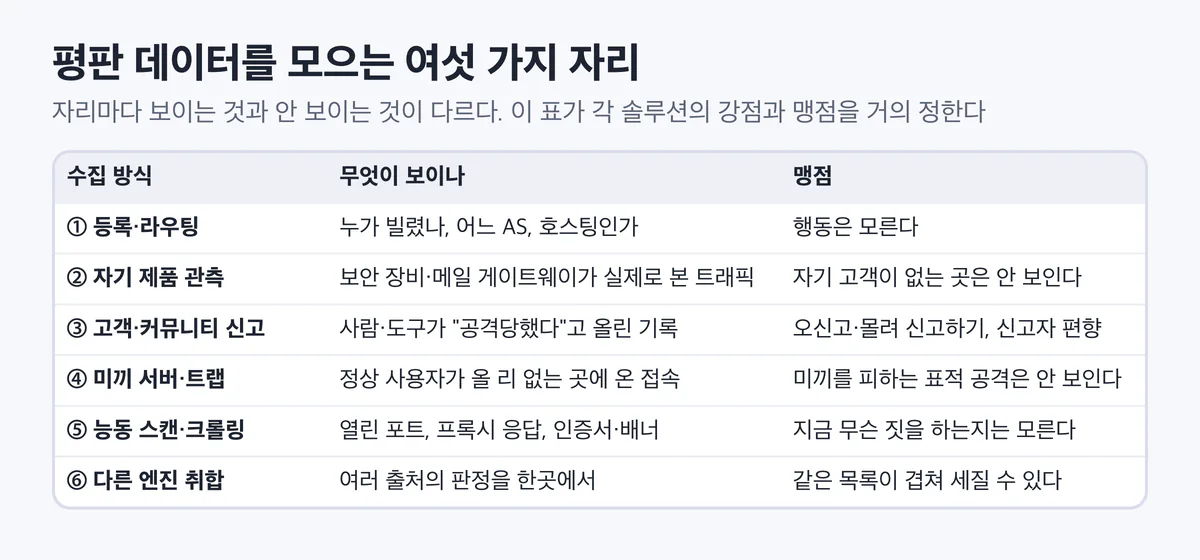
한 줄이 수집 방식 하나입니다. 가운데 칸은 그 자리에서 보이는 것, 오른쪽 칸은 그 자리에서 안 보이는 것입니다. 오른쪽 칸을 기억해 두면 각 솔루션의 맹점을 거의 예측할 수 있습니다.
여섯 가지를 두 무리로 나누면 이해가 쉽습니다.
- 성격을 알려 주는 자리: ① 등록·라우팅, ⑤ 능동 스캔. "이 주소는 데이터센터다", "이 주소에 열린 프록시가 있다"처럼 가능성을 말합니다. 실제로 나쁜 짓을 했는지는 모릅니다.
- 행동을 알려 주는 자리: ② 자기 제품 관측, ③ 신고, ④ 미끼·트랩. "이 주소가 어제 우리 장비를 공격했다"처럼 사건을 말합니다. 대신 본 사람이 있는 곳에서만 보입니다.
- ⑥ 취합은 둘을 섞어 모읍니다.
평판 서비스는 대개 여러 자리를 함께 씁니다. 다만 어느 자리가 두꺼운지가 서비스마다 다르고, 그것이 성격을 정합니다.
① 등록·라우팅과 ② 자기 제품 관측
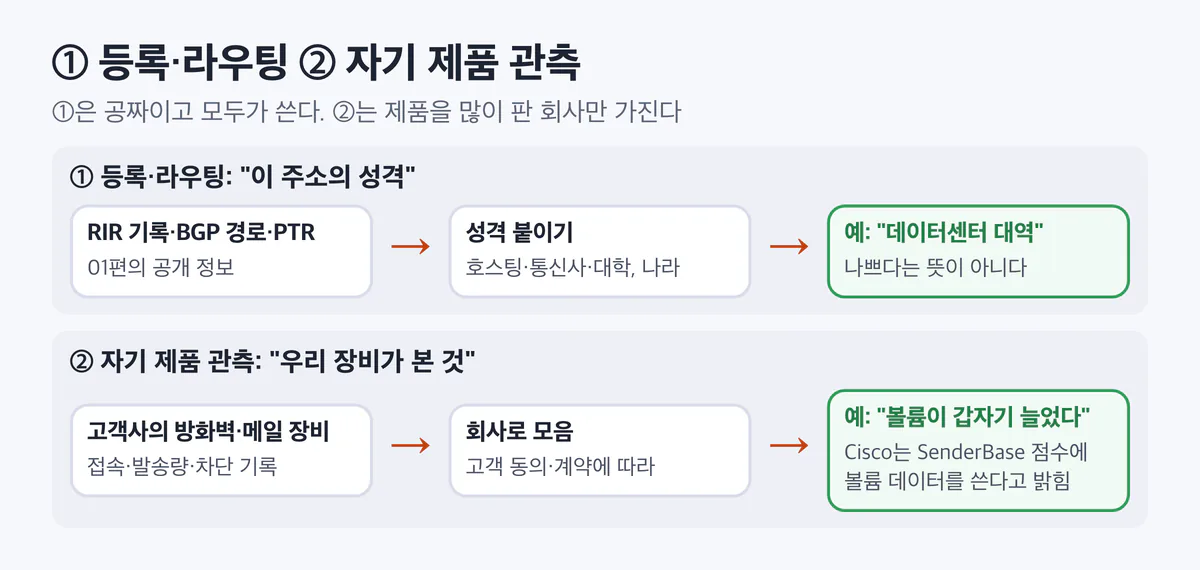
두 줄 모두 왼쪽에서 오른쪽으로 데이터가 흐릅니다. 맨 오른쪽 그린 상자가 그 자리에서 나오는 대표 신호입니다. 위 줄의 신호는 "나쁘다"가 아니라 "이런 성격이다"입니다.
① 등록·라우팅: 모두가 깔고 시작하는 바닥
01편에서 직접 조회한 RDAP 기록, ASN, BGP 경로, PTR, 클라우드 공개 대역이 여기에 들어갑니다. 공짜이고 누구나 받을 수 있어서 거의 모든 평판 서비스가 이것부터 붙입니다.
이 자리에서 나오는 값은 주로 회선 성격입니다. "통신사 가정용", "모바일", "호스팅·데이터센터", "대학", "기업". 예를 들어 AbuseIPDB의 CHECK 응답에는 usageType이라는 칸이 있고, 문서는 이것을 "이 주소의 일반적인 쓰임을 설명하는 문자열"이라고 하며 Fixed Line ISP, Data Center/Web Hosting/Transit 같은 값을 예로 듭니다. 신고와는 별개로, 주소의 성격을 붙이는 단계가 있다는 단서입니다.
- 강점: 신고가 하나도 없는 새 IP에도 값이 있습니다.
- 맹점: 행동은 모릅니다. 데이터센터 IP의 대부분은 정상 서버입니다.
② 자기 제품 관측: 많이 판 회사만 가진 눈
방화벽, 메일 게이트웨이, 엔드포인트 보안 제품을 판 회사는 고객 장비가 본 트래픽 정보를 (계약과 설정에 따라) 모을 수 있습니다. "이 IP에서 오늘 메일이 평소의 50배 왔다", "이 IP가 여러 고객사에서 동시에 차단됐다" 같은 신호는 이 자리에서만 나옵니다.
Cisco 기술 문서는 SenderBase(Talos의 메일 평판) 점수에 들어가는 변수로 스팸 트랩, 공개 차단 목록, 사용자 신고와 함께 볼륨 데이터를 듭니다. Talos 지원 문서는 이메일 평판이 메일 서버의 IP를, 웹 평판이 도메인과 그에 딸린 IP 전체를 기준으로 한다고 적습니다(08편).
- 강점: 실제 공격·스팸을 넓게, 빨리 봅니다. 볼륨 급변 같은 신호는 신고보다 먼저 옵니다.
- 맹점: 그 회사 제품을 쓰는 고객이 없는 지역·업종은 안 보입니다. 고객 데이터를 어떻게 모으는지는 대개 자세히 공개하지 않습니다.
③ 신고와 ④ 미끼 서버·트랩
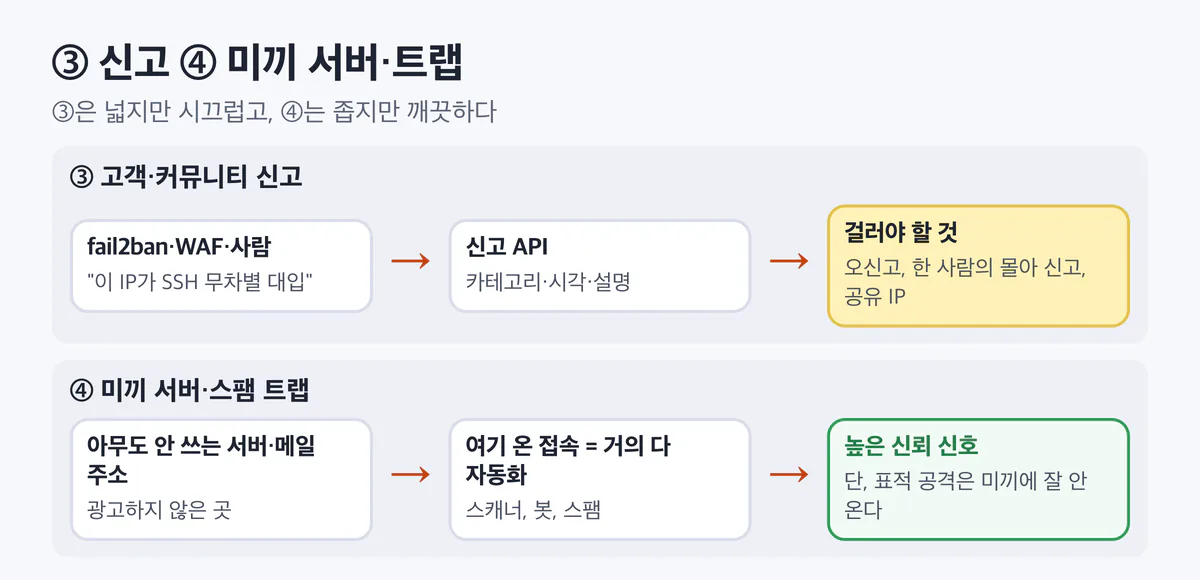
위 줄 맨 오른쪽이 노란 상자인 이유는 신고가 그대로 점수가 되면 안 되고 걸러야 할 것이 많기 때문입니다. 아래 줄은 반대로 걸러진 상태로 들어오는 깨끗한 신호입니다. 다만 볼 수 있는 범위가 좁습니다.
③ 고객·커뮤니티 신고: 넓지만 시끄럽다
서버 운영자가 "이 IP가 내 SSH에 무차별 대입을 했다"고 올리면 쌓이는 구조입니다. 사람이 손으로 올리기도 하지만, 대부분은 fail2ban 같은 차단 도구나 WAF가 자동으로 올립니다(05편).
AbuseIPDB 문서를 보면 이 자리의 모양이 보입니다.
- 신고(REPORT)에는 카테고리(어떤 종류의 남용인가)가 필수이고, 설명 칸에 개인정보를 넣지 말라고 적혀 있습니다.
- 조회(CHECK)할 때
maxAgeInDays(1~365, 기본 30)로 며칠 치 신고를 볼지 고릅니다. - 점수(
abuseConfidenceScore)는 "신고한 사용자들을 바탕으로 계산한, 이 IP가 얼마나 남용에 쓰였나에 대한 평가"라고만 설명하고, 공식은 공개하지 않습니다.
신고 자리에서 거를 것은 세 가지입니다.
-
오신고. 설정 실수로 정상 크롤러나 내 사무실 IP를 신고합니다.
-
몰아 신고. 한 사람(또는 계정 여러 개)이 같은 IP를 수십 번 신고합니다. 신고자별 중복 제거와 신고자 신뢰도가 필요합니다(03편에서 숫자로 봅니다).
-
공유 IP. CGNAT 뒤 한 명의 잘못이 그 IP 뒤 모든 사람의 신고 기록이 됩니다.
-
강점: 수많은 서버가 보는 만큼 넓습니다. 누구나 기여할 수 있어서 빨리 쌓입니다.
-
맹점: 신고하는 사람이 많은 곳(SSH, 웹 서버)의 공격만 두껍게 보입니다. 신고자의 실수와 편향이 그대로 들어옵니다.
④ 미끼 서버·스팸 트랩: 좁지만 깨끗하다
허니팟(honeypot)은 아무 서비스도 하지 않는 서버를 인터넷에 열어 두고, 거기 들어오는 접속을 기록하는 장치입니다. 정상 사용자가 그 주소를 알 리 없으니, 거기 온 접속은 거의 다 스캐너나 봇입니다. 스팸 트랩은 같은 생각을 메일에 적용합니다. 어디에도 공개하지 않은(또는 오래전에 버려진) 메일 주소로 메일이 오면, 보낸 쪽은 주소 목록을 사거나 긁어 왔을 가능성이 높습니다.
IPQS는 자체 허니팟·트랩·크롤러로 데이터를 모은다고 설명합니다(회사 설명, 06편). Cisco 기술 문서도 SenderBase 변수로 스팸 트랩을 듭니다.
- 강점: 오신고가 거의 없습니다. 사람의 판단이 끼지 않습니다.
- 맹점: 인터넷 전체를 훑는 자동화 공격만 걸립니다. 특정 회사만 노리는 표적 공격은 미끼에 잘 오지 않습니다. 미끼 서버의 위치와 수가 적으면 보는 범위도 좁습니다.
⑤ 능동 스캔·크롤링과 ⑥ 다른 엔진 취합
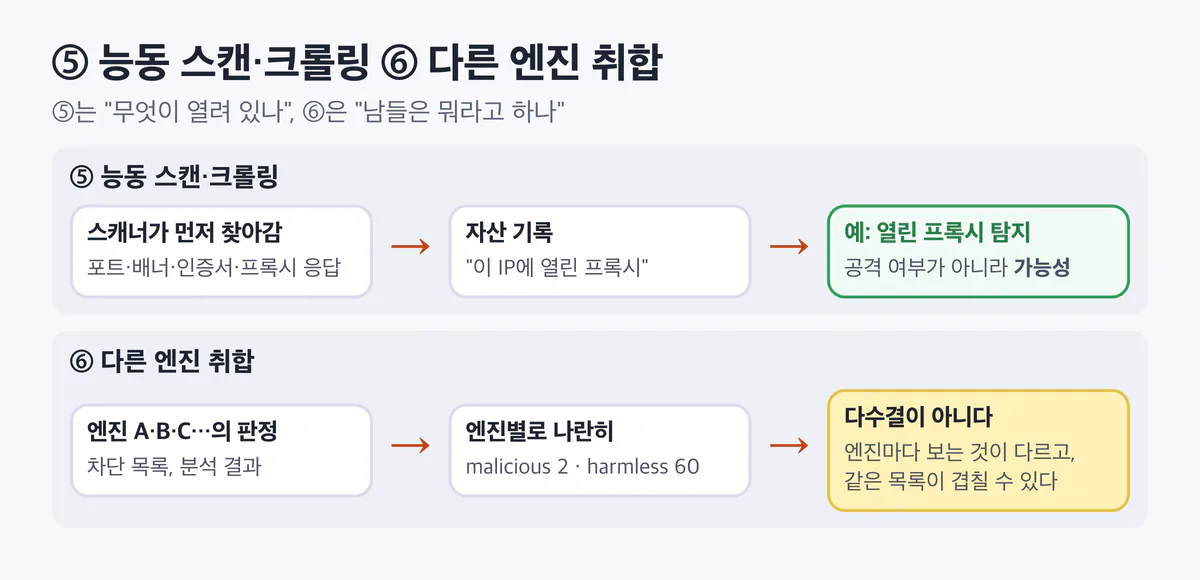
위 줄은 서비스가 먼저 찾아가서 보는 자리, 아래 줄은 남이 본 것을 받아서 모으는 자리입니다. 두 줄 모두 맨 오른쪽 상자가 결과를 읽을 때 주의할 점입니다.
⑤ 능동 스캔·크롤링: 무엇이 열려 있나
스캐너가 인터넷의 주소들에 먼저 접속해 봅니다. 어떤 포트가 열려 있나, 그 포트가 어떤 소프트웨어 배너를 보여 주나, 어떤 인증서를 내나, 프록시처럼 남의 요청을 대신 전달해 주나. 크롤러는 웹 페이지를 돌며 악성 링크나 피싱 페이지를 찾습니다.
이 자리에서 나오는 것은 가능성입니다. "이 IP에 열린 프록시가 있다"는 누군가 그 프록시로 나쁜 짓을 할 수 있다는 뜻이지, 했다는 뜻이 아닙니다. 같은 스캔 데이터를 "우리 회사 자산" 기준으로 다시 보면 공격 표면 관리(ASM, Attack Surface Management)가 됩니다. 내 회사 IP에 의도하지 않은 포트가 열려 있는지 보는 일입니다(09편).
- 강점: 공격이 일어나기 전에 위험한 자산을 찾습니다. 프록시·VPN 출구 판별에 강합니다.
- 맹점: 행동은 모릅니다. 스캔 사이에 바뀐 것은 다음 스캔까지 모릅니다.
이 시리즈는 남의 자산을 스캔하는 법을 다루지 않습니다. 이 자리를 이해하는 목적은 결과를 읽는 것입니다.
⑥ 다른 엔진 취합: 남들은 뭐라고 하나
여러 보안 회사와 차단 목록의 판정을 한곳에 나란히 모읍니다. VirusTotal의 IP 객체가 대표입니다. last_analysis_stats에 harmless·malicious·suspicious·undetected·timeout 개수가, last_analysis_results에 엔진별 category·method·result가 들어 있습니다(07편).
취합 결과를 읽을 때 흔한 오해가 "엔진 70개 중 2개만 악성이니 안전하다" 또는 "2개나 악성이니 위험하다"입니다. 둘 다 다수결로 읽은 것입니다. 실제로는 엔진마다 보는 자리가 다르고(어떤 엔진은 신고만, 어떤 엔진은 자기 제품 관측만), 같은 공개 차단 목록을 여러 엔진이 가져다 쓰면 한 출처가 여러 번 세질 수 있습니다.
- 강점: 한 번에 여러 시각을 봅니다. 침해 분석에서 IP → 도메인 → 파일로 넘어가기 좋습니다.
- 맹점: 개수는 독립된 표가 아닙니다. 각 엔진의 판정 기준과 갱신 시각이 다릅니다.
공통 구조: 수집에서 이의 제기까지
여섯 자리에서 모은 데이터는 어떻게 점수가 되어 나에게 올까요? 회사마다 내부 구조를 공개하지 않지만, 공개 문서에 보이는 겉모습(수집 방식, 배포 형태, 이의 제기 창구)과 응답 필드의 모양에서 공통된 흐름을 끌어낼 수 있습니다.
⚠️ 글쓴이의 추정입니다. 아래 구조도와 흐름은 어느 회사의 공식 아키텍처도 아닙니다. 여러 회사의 공개 문서, API 응답 필드, 제품 설명에서 보이는 단서로 글쓴이가 "IP 평판 서비스는 대체로 이렇게 생겼을 것"이라고 일반화해 그려 본 그림입니다. 실제 구현은 회사마다 다르고, 이 그림과 다를 수 있습니다.
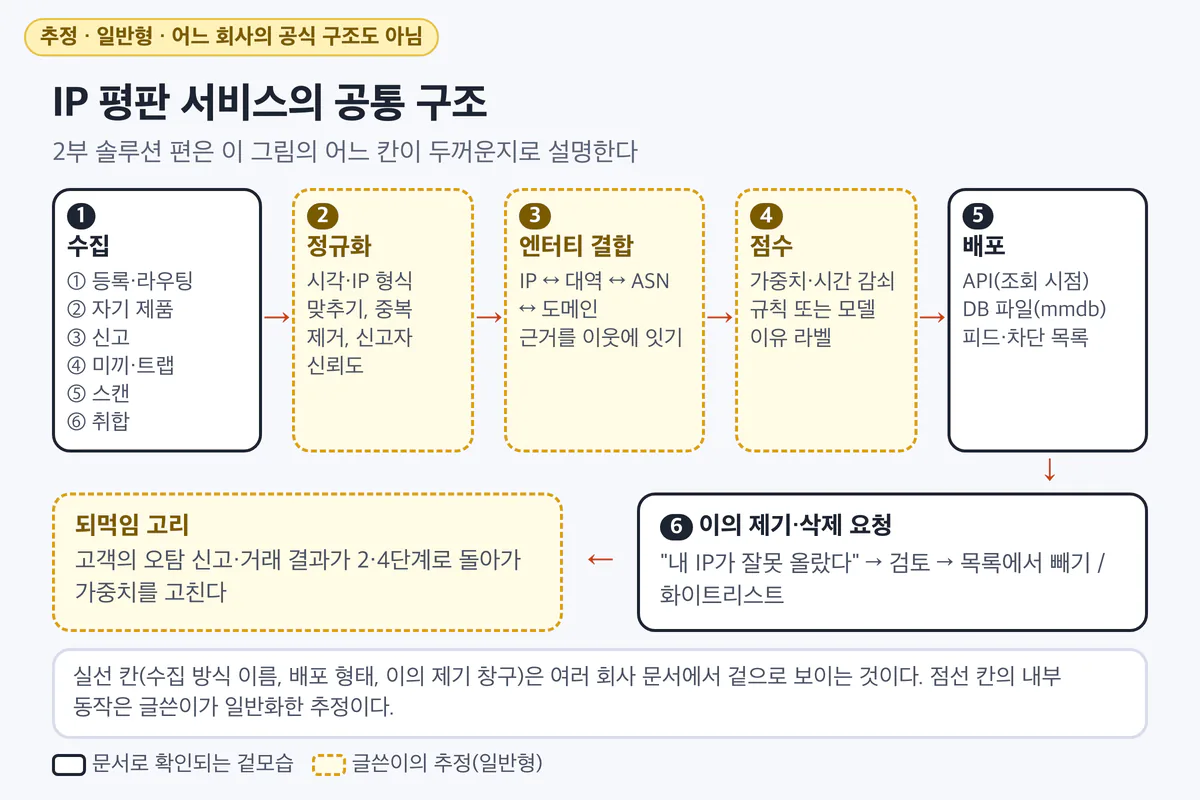
윗줄을 왼쪽에서 오른쪽으로 읽고, 5 배포에서 아래로 내려와 6 이의 제기를 거쳐 왼쪽 되먹임 고리로 돌아갑니다. 흰 실선 칸(1 수집, 5 배포, 6 이의 제기)은 여러 회사 문서에서 겉으로 확인되는 것이고, 노란 점선 칸(2 정규화, 3 엔터티 결합, 4 점수, 되먹임 고리)은 내부 동작이라 글쓴이의 추정입니다. 2부 솔루션 편은 이 그림을 다시 쓰면서 "이 회사는 어느 칸이 두껍다"로 설명합니다.
각 칸을 단서와 함께 풀어 봅니다.
| 칸 | 하는 일(일반형) | 겉으로 보이는 단서 | 확인/추정 |
|---|---|---|---|
| 1 수집 | 여섯 자리에서 원재료를 받는다 | 회사들이 밝히는 수집 방식(신고 API, 트랩, 엔진 목록) | 문서로 확인되는 겉모습 |
| 2 정규화 | 시각·주소 형식을 맞추고, 같은 사건을 하나로 묶고, 출처별 신뢰도를 붙인다 | 신고에 카테고리·시각이 필수다. 같은 IP에 대한 신고 수(totalReports)와 점수가 따로 나온다 | 추정 |
| 3 엔터티 결합 | IP를 대역·ASN·도메인·파일과 잇는다 | 응답에 asn·network·usageType 같은 칸이 함께 나온다. 관계(resolutions, communicating_files)를 주는 곳이 있다 | 추정 |
| 4 점수 | 가중치·시간 감쇠·규칙이나 모델로 점수와 이유 라벨을 만든다 | 조회 때 기간(maxAgeInDays)이나 엄격도를 고를 수 있다. 점수와 함께 플래그(proxy, vpn 등)가 나온다 | 추정 |
| 5 배포 | API, DB 파일, 피드·차단 목록으로 나눠 준다 | 요금제 표에 API 조회 한도와 목록 조회 한도가 따로 있다. mmdb 파일을 내려받게 한다 | 문서로 확인되는 겉모습 |
| 6 이의 제기 | 잘못 오른 주소를 검토해 빼거나 예외로 둔다 | Talos 지원 문서는 내가 가진 IP·도메인의 판정이 틀렸다고 생각하면 티켓을 내라고 안내한다 | 문서로 확인되는 겉모습 |
| 되먹임 | 오탐 신고·거래 결과를 다시 가중치에 반영한다 | 거래 결과를 알려 주는 API를 두는 곳이 있다(04편에서 확인) | 추정 |
이 구조에서 읽어 낼 수 있는 점수의 성질이 셋 있습니다.
- 점수는 2·4단계의 선택에 크게 좌우됩니다. 같은 신고 기록도 중복 제거와 감쇠를 어떻게 하느냐에 따라 6점이 되기도, 93점이 되기도 합니다(03편의 장난감 모형).
- 5단계의 배포 형태가 신선도를 정합니다. 조회 시점에 계산하는 API와, 주기적으로 빌드하는 DB 파일은 같은 회사라도 신선도가 다릅니다.
- 6단계가 없으면 오탐이 영원합니다. 공유 IP와 재사용 IP 때문에 오탐은 반드시 생깁니다. 빼는 길이 있는지가 서비스를 고를 때 중요한 질문입니다(12편).
3 엔터티 결합: 근거가 이웃으로 번지는 길
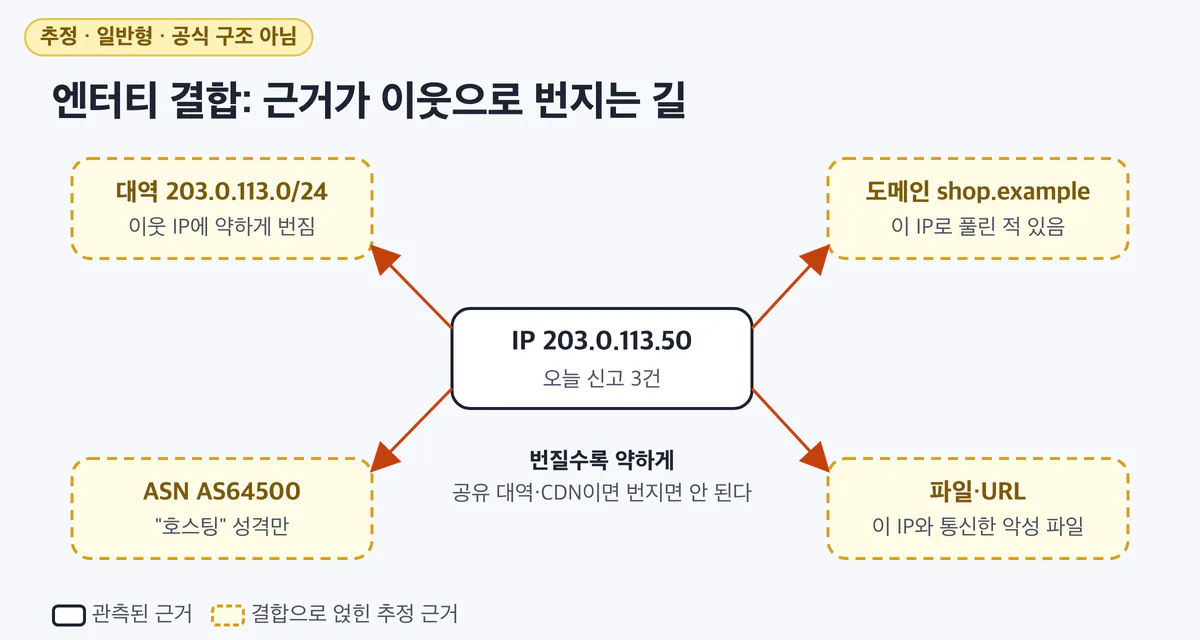
가운데 흰 상자가 실제로 관측된 근거(오늘 신고 3건)입니다. 화살표는 그 근거가 옮겨 가는 방향이고, 바깥 노란 점선 상자는 직접 관측된 적은 없지만 결합으로 의심을 물려받는 대상입니다. 화살표 가운데 글처럼 멀리 갈수록 약하게 번져야 합니다.
엔터티 결합은 평판 서비스를 쓸모 있게 만드는 단계이자, 오탐을 퍼뜨리는 단계이기도 합니다.
- 쓸모: 처음 보는 IP라도 "같은 /24에 최근 신고가 많다", "이 IP로 풀린 적 있는 도메인이 피싱으로 판정됐다"를 근거로 점수를 줄 수 있습니다. 공격자는 주소를 바꾸지만 대역과 인프라는 자주 재사용합니다.
- 위험: 같은 /24라도 클라우드 공용 대역이나 CDN이면 이웃끼리 아무 관계가 없습니다. 통신사 가정용 대역도 마찬가지입니다. 그런 곳에서 근거를 번지게 하면 아무 잘못 없는 이웃이 점수를 받습니다(03편 대역 번짐).
5 배포: 무엇을 받고 무엇을 내주나
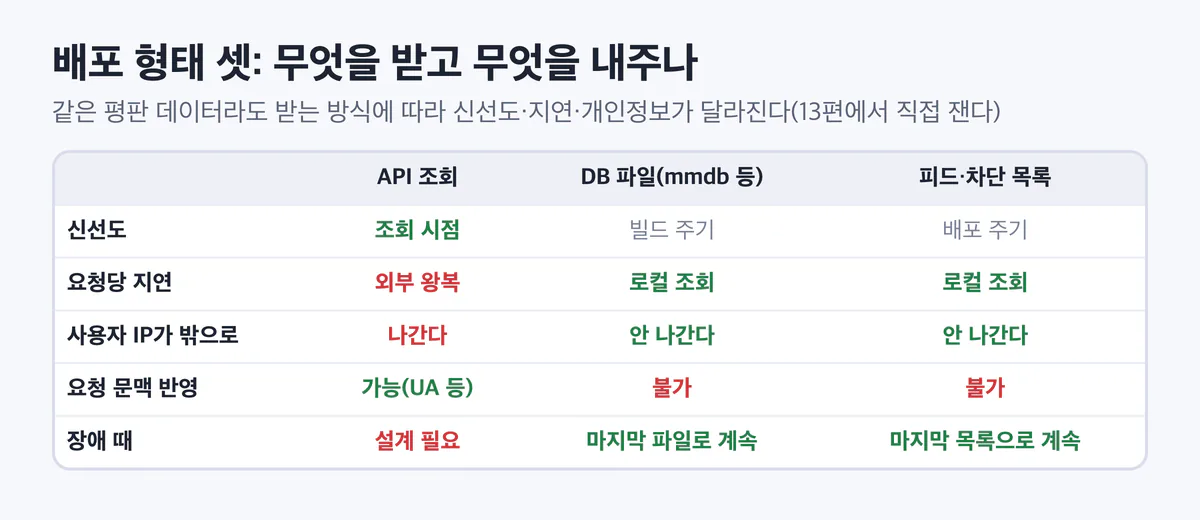
세로줄 셋이 배포 형태, 가로줄이 비교 기준입니다. 그린은 유리, 레드는 불리, 회색은 "주기에 따라 다름"입니다. 13편에서 이 차이를 직접 잽니다.
같은 평판 데이터라도 어떻게 받느냐에 따라 내 서비스에 주는 영향이 다릅니다.
- API 조회는 가장 신선하고, 브라우저 정보 같은 요청 문맥을 함께 보내 점수를 바꿀 수 있습니다. 대신 요청마다 외부 왕복이 생기고, 사용자 IP가 밖으로 나갑니다. 한도와 장애도 설계해야 합니다.
- DB 파일(MaxMind의 mmdb 같은 것)은 내 서버 안에서 조회하므로 지연이 거의 없고 사용자 IP가 나가지 않습니다. 대신 빌드 주기만큼 늦습니다.
- 피드·차단 목록은 "나쁜 IP 목록"을 주기적으로 받습니다. 로컬에서 집합 조회만 하면 됩니다. AbuseIPDB처럼 목록 조회 한도가 API 조회 한도와 따로 있는 곳이 많습니다.
실무에서는 섞어 씁니다. 로컬 DB와 목록으로 대부분을 거르고, 애매한 일부만 API로 묻고, API 결과는 캐시합니다(13편).
솔루션 편은 이 그림을 이렇게 쓴다
2부의 각 편에는 "데이터 출처 지도"와 "예상 시스템 구조도"가 있습니다. 둘 다 이 편의 그림을 다시 쓴 것입니다.
- 데이터 출처 지도는 위의 여섯 자리 중 어디가 두꺼운지를 막대로 보여 줍니다. 회사가 밝힌 것은 실선, 추정은 점선입니다.
- 예상 시스템 구조도는 공통 구조의 1~6칸을 그 회사의 단서로 채운 것입니다. 늘 ⚠️ 상자와
추정꼬리표가 붙습니다.
미리 보면 이런 식입니다. 아래 칸의 "두꺼운 곳"은 이 시점의 대략적인 예고이고, 해당 편에서 근거와 함께 다시 정리합니다.
| 편 | 두꺼울 것으로 보는 칸 | 이유(해당 편에서 확인) |
|---|---|---|
| 04 MaxMind | 1 수집의 ①, 5 배포의 DB 파일 | mmdb 파일을 내려받아 로컬에서 조회 |
| 05 AbuseIPDB | 1 수집의 ③, 4 점수의 기간 선택 | 신고 API, maxAgeInDays |
| 06 IPQS | 1 수집의 ④⑤, 4 점수의 요청 문맥 | 회사 설명(허니팟·크롤러), strictness·user agent |
| 07 VirusTotal | 1 수집의 ⑥, 3 엔터티 결합 | 엔진별 결과, 관계 필드 |
| 08 Talos | 1 수집의 ②, 6 이의 제기 | 볼륨 데이터, 티켓 |
| 09 Criminal IP | 1 수집의 ⑤ | 스캔 성격의 데이터(확인 필요) |
오탐과 한계
각 수집 자리는 저마다의 방식으로 틀립니다.
| 자리 | 대표적인 오탐 | 대표적인 놓침 |
|---|---|---|
| ① 등록·라우팅 | 데이터센터 = 나쁨으로 읽어 웹훅·제휴사를 막음 | 가정용 대역에서 오는 주거 프록시 |
| ② 자기 제품 관측 | 고객사 한 곳의 잘못된 설정이 크게 반영됨 | 그 회사 고객이 없는 곳 |
| ③ 신고 | 오신고, 몰아 신고, CGNAT 뒤 무고한 사람들 | 신고자가 없는 서비스(앱 API 등)에 대한 공격 |
| ④ 미끼·트랩 | 연구용 스캐너까지 "공격"으로 셈 | 표적 공격 |
| ⑤ 스캔 | 열린 포트 = 공격자로 읽음 | 스캔 사이의 변화 |
| ⑥ 취합 | 같은 목록이 여러 번 세짐 | 아무 엔진도 안 본 것 |
그리고 이 편의 공통 구조 그림은 일반화한 추정입니다. 어떤 회사는 2와 4를 하나의 모델로 처리할 수 있고, 어떤 회사는 6단계가 사람 손으로만 돌아갈 수 있습니다. 그림은 "어떤 질문을 던질지"를 정리하는 도구로 쓰고, 특정 회사가 이렇게 만들었다는 근거로 쓰지 않습니다.
실무 체크
- 쓰고 있는(또는 고르는) 평판 서비스마다 "여섯 자리 중 어디가 두껍나"를 한 줄로 적습니다. 회사 문서에서 확인한 것과 내 추정을 나눠 적습니다.
- 점수를 받을 때 기간(며칠 치인가), 배포 형태(조회 시점인가, 빌드 시점인가)를 함께 기록합니다.
- 서비스를 고를 때 "잘못 오른 내 IP를 빼는 창구가 있나"를 반드시 확인합니다.
정리
- 평판 데이터를 모으는 자리는 여섯 가지입니다: 등록·라우팅, 자기 제품 관측, 신고, 미끼·트랩, 능동 스캔, 엔진 취합.
- ①⑤는 "이런 성격이다(가능성)", ②③④는 "이런 일이 있었다(사건)"를 말합니다. ⑥은 남의 판정을 모읍니다.
- 공통 구조(글쓴이의 추정)는 수집 → 정규화 → 엔터티 결합 → 점수 → 배포 → 이의 제기이고, 되먹임 고리가 있습니다.
- 점수의 성질은 정규화와 점수 단계의 선택, 배포 형태, 이의 제기 창구가 정합니다.
- 2부의 솔루션 편은 이 그림의 어느 칸이 두꺼운지로 설명합니다.
출처와 확인 날짜
모든 링크는 2026-10-31에 확인했습니다.
- AbuseIPDB API 문서(
abuseConfidenceScore설명,maxAgeInDays1~365·기본 30,usageType, REPORT 카테고리·개인정보 금지): https://docs.abuseipdb.com/ - Cisco 기술 문서, SenderBase 점수 변수(스팸 트랩·공개 차단 목록·사용자 신고·볼륨 데이터)와 범위 +10~-10: https://www.cisco.com/c/en/us/support/docs/security/email-security-appliance/117919-technote-cdc-00.html
- Cisco Talos 평판 센터 개요(이메일·웹 평판 기준, 3시간 갱신, 티켓으로 이의 제기): https://support.talosintelligence.com/docs/rep-overview/
- IPQualityScore 프록시 탐지 API 개요(회사가 밝힌 수집 방식): https://www.ipqualityscore.com/documentation/proxy-detection-api/overview
- VirusTotal IP 주소 객체(
last_analysis_stats,last_analysis_results, 관계): https://docs.virustotal.com/reference/ip-object - 01편 실행 결과(등록·라우팅 정보 조회):
lab/results/01-rdap.txt,01-cloud-classify.txt
이전 글 IP 하나에서 알 수 있는 것: RIR·WHOIS·ASN·역방향 DNS·위치
다음 글 점수는 어떻게 만들어지고, 왜 틀리나
시리즈 전체 목록 IP 평판은 어떻게 만들어지고, 어떻게 써야 하나 전체 목록
