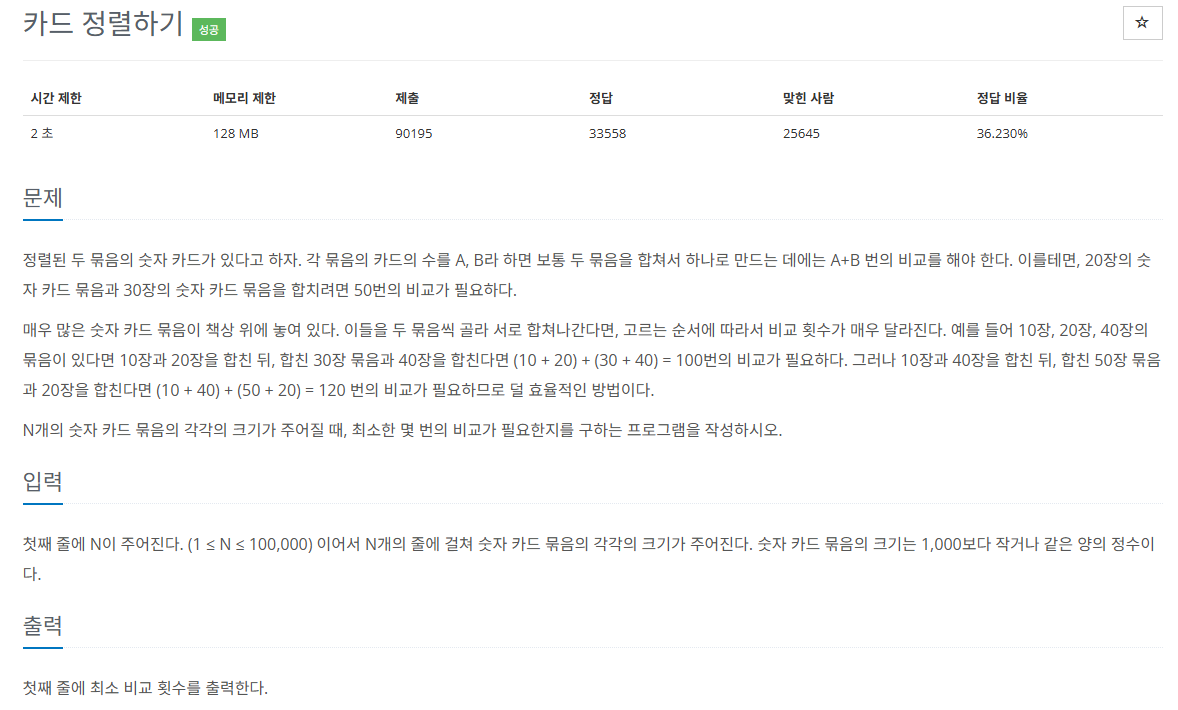
설명
풀이 흐름 설명
처음에는 단순히 Arrays.sort()를 이용해 오름차순 정렬한 뒤
앞에서부터 두 개씩 더해 나가는 방식으로 구현하였다.하지만 이 방법은 매번 두 묶음을 합칠 때마다
다시 정렬이 필요하였고 그 과정에서 시간 복잡도가 크게 증가하였다.
결과적으로 정렬을 반복 수행하면서 시간 초과가 발생하였다.문제를 다시 분석해보니 핵심은 다음과 같았다.
항상 가장 작은 두 묶음을 선택하여 합치는 것이 전체 비교 횟수를 최소로 만든다.
이는 전형적인 허프만(Huffman) 알고리즘) 구조와 동일하였다.정렬을 반복하는 것이 아니라
가장 작은 두 값을 꺼내고 더한 값을 다시 넣고
이를 하나만 남을 때까지 반복하는 구조였다.
이 과정을 효율적으로 처리하기 위해
최소 힙 기반의 PriorityQueue를 사용하였다.고민과 해결
- 왜 정렬 방식이 비효율적인가?
정렬을 매번 수행하면
시간 복잡도는 O(N log N)이 반복되어
전체가 O(N^2 log N) 수준까지 증가한다.
N이 최대 100,000이기 때문에
이 방식은 시간 제한을 만족할 수 없었다.반면 PriorityQueue를 사용하면:
poll → O(log N)
offer → O(log N)
이 과정을 N번 반복하므로
전체 시간 복잡도는 O(N log N)이 되어 충분히 통과 가능하였다.
- 왜 가장 작은 두 묶음을 먼저 합쳐야 하는가?
큰 값들을 먼저 합치면
그 큰 값이 이후 단계에서 계속 더해지면서
총 비교 횟수가 급격히 증가한다.반면 작은 값들부터 합치면
작은 비용을 먼저 처리하고
큰 값은 가능한 한 나중에 한 번만 더해지도록 만들 수 있다.이 원리는 허프만 트리의 최소 비용 구조와 동일하며
교환 논증(Exchange Argument)으로 최적성이 증명된다.허프만 알고리즘이란?
허프만 알고리즘은
전체 비용을 최소로 만드는 그리디 알고리즘이다.원래는 데이터 압축을 위해 고안된 알고리즘이다.
문자 등장 빈도를 기반으로 트리를 만들어 전체 비트 길이를 최소화하는 방식이다.
시간복잡도:O(NlogN), 공간복잡도:O(N)
회독
- [ x ] 1회
- 2회
- 3회
코드
import java.io.*;
import java.util.*;

public class Main {
    public static void main(String[] args) throws IOException {
        BufferedReader br = new BufferedReader(new InputStreamReader(System.in));

        int n = Integer.parseInt(br.readLine());

        if(n==1){ // 1개면 0번 비교
            System.out.println(0);
            return;
        }

        PriorityQueue<Integer> pq = new PriorityQueue<>();

        for(int i=0;i<n;i++){
           pq.offer(Integer.parseInt(br.readLine()));
        }

        int sum = 0;

        while(pq.size()>=2){
            int a = pq.poll();
            int b = pq.poll();

            sum += a+b;
            pq.offer(a+b);
        }

        System.out.println(sum);
    }
}