Redis 개념, Replications vs Sentinel vs Cluster
오늘은 채팅 기능구현이후 디벨롭 방향을 잡는데 있어서 Redis라는 개념이 필요해서 초벌구이 느낌으로다가(?) 정리를 해보았다.
Redis란?
- Redis는 엄청 빠른 저장소.
- 컴퓨터의 메모리(RAM)에 데이터를 저장하기 때문에 속도가 미쳤다.
- 보통 DB는 디스크(SSD/HDD)에 저장하는데, Redis는 메모리(RAM)에 저장. 그래서 검색, 저장, 삭제가 매우 빠름.
즉, 메모리에 데이터를 저장해서 엄청나게 빠른 속도를 제공하는 데이터 저장소(DB)이다.
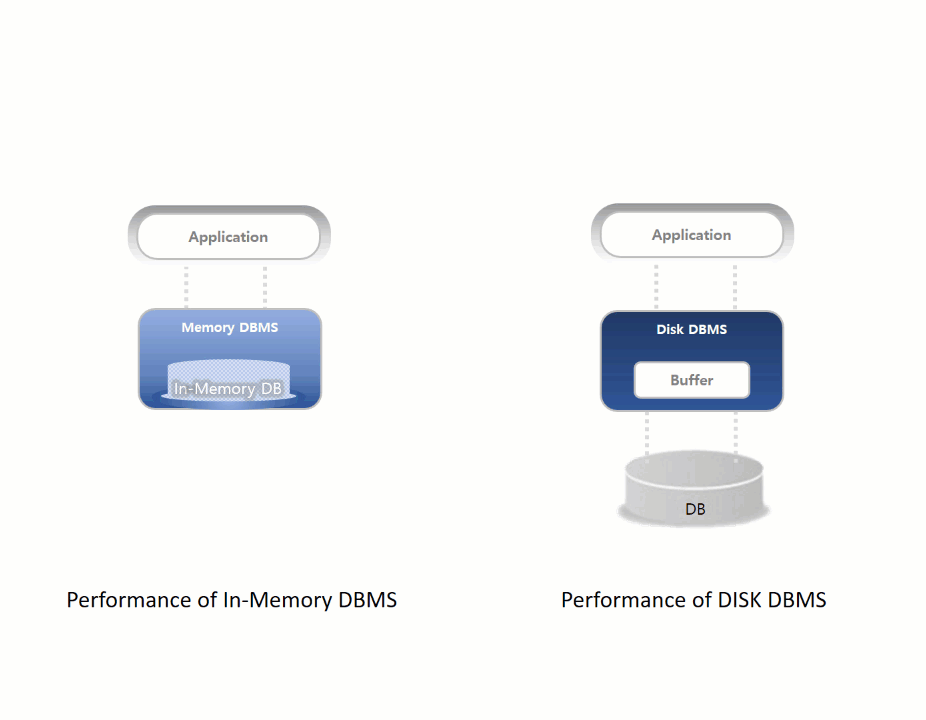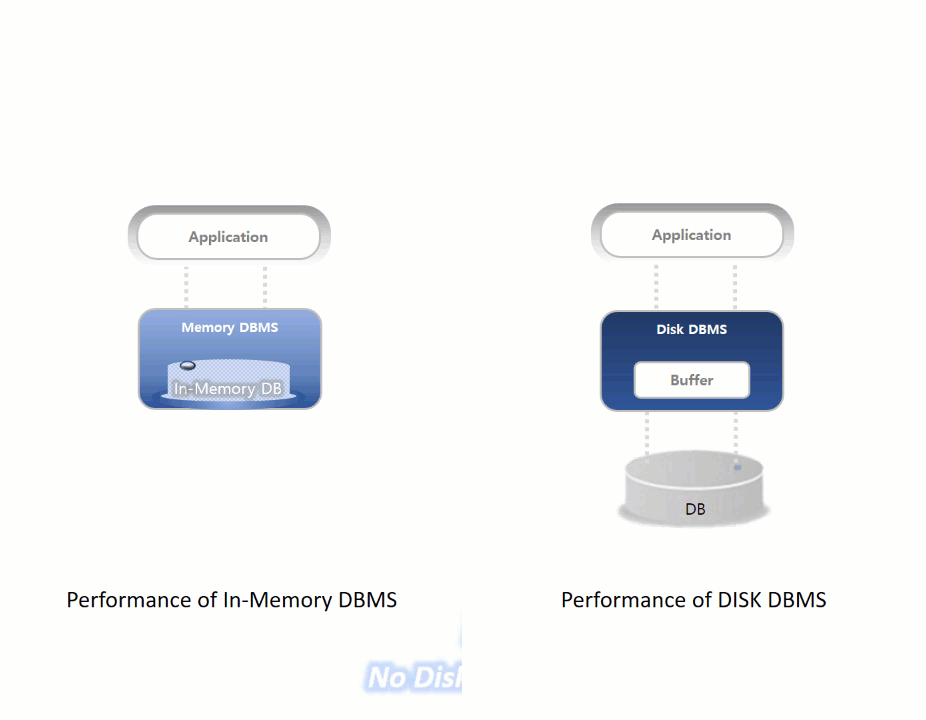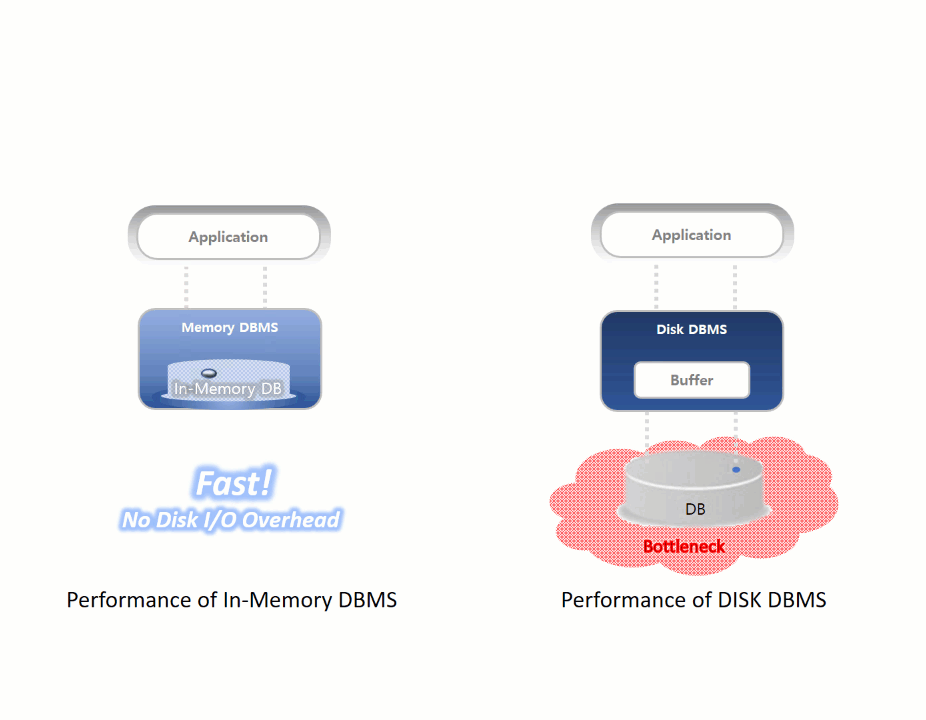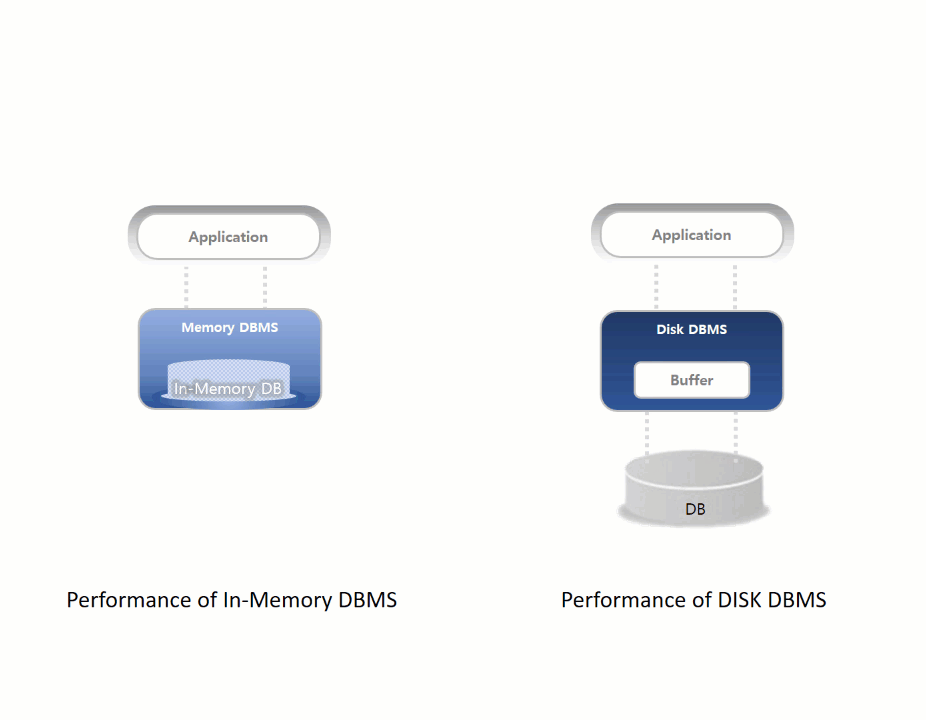
보통 DB가 디스크에 저장하는 반면, Redis는 RAM에 저장해서 I/O 과정이 없기 때문에 정말 빠르다.
 출처 :
Redis 특징
- 문자열, 리스트, 집합(Set), 정렬된 집합(Sorted Set), 해시(Hash)등 어떠한 형태의 데이터도 저장이 가능하다.
- 그래서 단순 DB가 아니라 캐시 / 메시지 브로커 / 세션 저장소 등 여러 용도로 활용된다.
장점
1) 속도가 매우 빠르다 → 메모리에 저장되기 때문
2) 여러 형태의 데이터 저장 가능 → 문자열, 리스트, 해시 등
3) 데이터를 디스크에도 저장할 수 있음(백업 기능) → 메모리는 꺼지면 날라가는데, Redis는 저장해두는 옵션도 있음 → 서버가 꺼져도 데이터 복구 가능
4) 캐시(Cache)로 매우 많이 쓰임 → 자주 사용하는 정보 저장해서 서버 속도 증가
사용 예시
✔ 로그인 세션/토큰 저장
- 로그인할 때 Redis에 세션 저장하면 빠르게 인증 가능
✔ 채팅 시스템
- 메시지 임시 저장
- 유저 접속 상태 저장(online/offline)
- 실시간 처리에 강함
✔ 캐시(Cache)
- DB에 한 번 갔다온 정보를 Redis에 저장 → 다음엔 훨씬 빠르게 조회
Redis 데이터 저장구조 : Collection Type
‘키-값(Key-Value)’ 형태로 데이터를 저장하는 Redis 내에서는 ‘키(key)’는 문자열 형태로 고정되어 있지만, ‘값(Value)’는 Strings, Bitmaps, Bit field, Hashes, Lists, Sets, Sorted Sets, Geospatial Indexes, Hyperloglogs, Streams 형태로 다양한 데이터 저장이 가능하다.
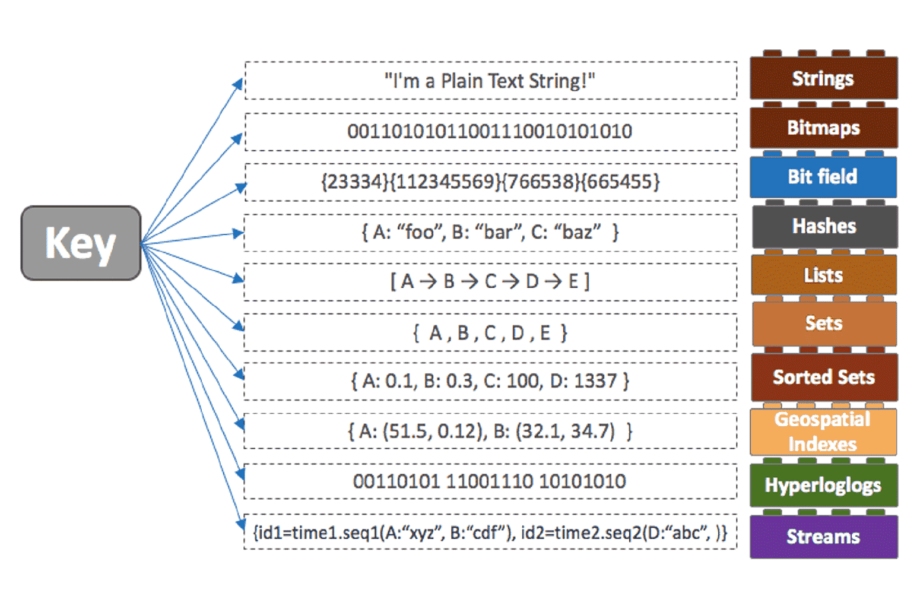
인 메모리 데이터 구조(In-Memory Data Storage)
-
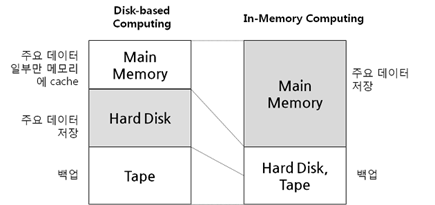
‘컴퓨터 메모리’ 내에서 데이터를 저장하고 조작하는 방식이다. 이는 디스크에 데이터를 저장하고 검색하는 대신 ‘RAM과 같은 메모리에 데이터를 저장’하여 훨씬 빠른 속도로 데이터에 접근할 수 있게 해 준다.
-
이러한 구조는 특히 대량의 데이터를 빠르게 처리해야 하는 애플리케이션에서 유용하다. 단, 데이터가 메모리에 저장되므로 컴퓨터가 꺼지거나 재시작되면 데이터가 사라질 수 있다. 따라서, 인-메모리 데이터 구조를 사용할 때는 이러한 특성을 고려하여 데이터 유실을 방지하는 방안을 마련해야 한다.
구분 RDBMS In-Memory DB 데이터 저장 위치 디스크(SSD/HDD) 메모리(RAM) 속도 상대적으로 느림 (디스크 I/O 발생) 매우 빠름 (메모리 직접 접근) 데이터 유실 가능성 거의 없음 (트랜잭션 완료 데이터는 안전) 전원 OFF/장애 시 데이터 유실 가능 사용 용도 대용량 데이터의 안정적 저장·관리 빠른 응답이 필요한 캐싱, 세션, 실시간 처리 데이터 복구 디스크 기반으로 복구가 용이 별도 설정(스냅샷, AOF, 복제 등) 없으면 복구 어려움 하드웨어 비용 메모리 대비 저렴 많은 메모리가 필요해 비용 증가
RDB(Redis Database)
-
설정한 시간 간격에 따라 데이터의 스냅샷을 일정한 시점에 디스크에 저장한다. 이렇게 하면 빠른 백업이 가능하며 크기가 작아 백업 파일을 다른 서버로 이동하는 것이 용이하다.
-
그러나 스냅샷을 수행한 이후에 발생한 데이터 손실이 발생할 수 있기 때문에, 데이터의 일관성이 중요한 애플리케이션에는 적합하지 않을 수 있다.
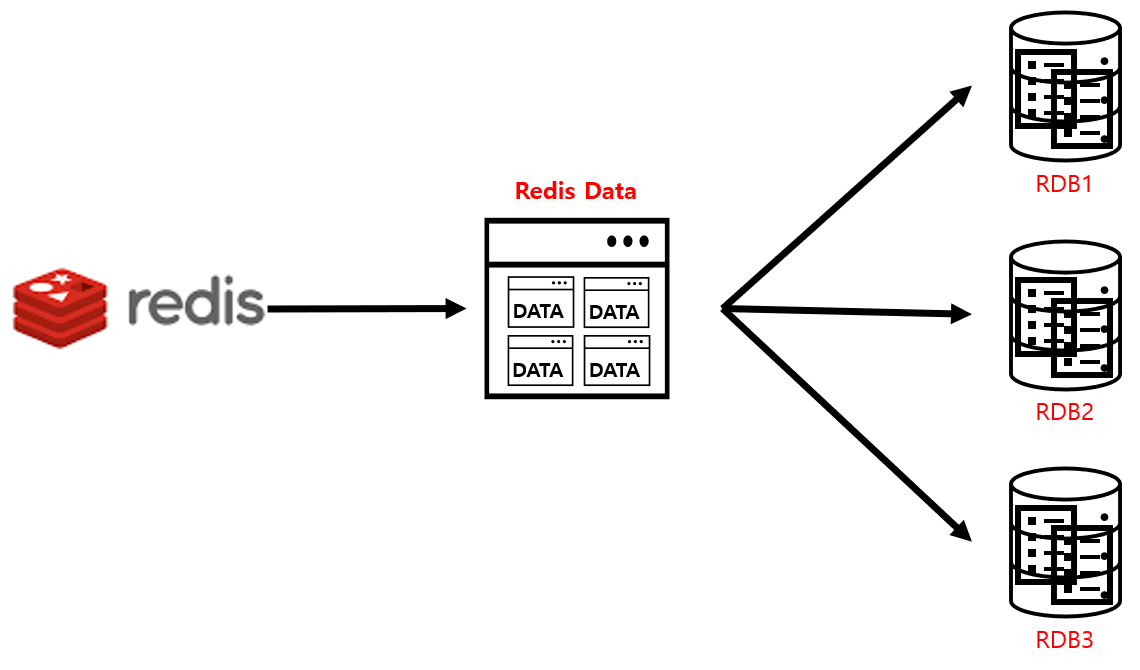
출처 : https://adjh54.tistory.com/447
Redis 저장 구조
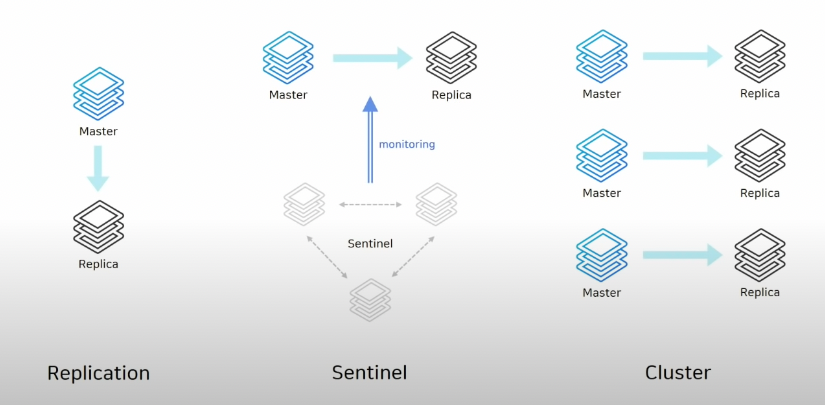
📌 1. Redis Replication
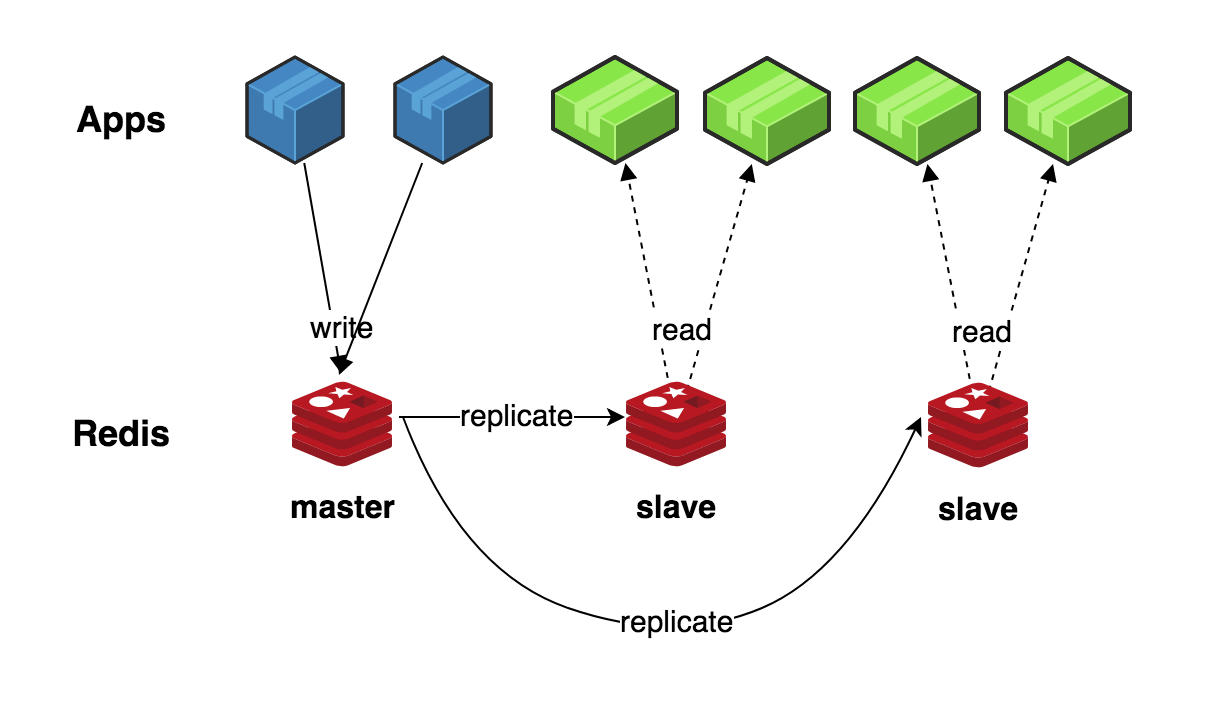
출처 : https://russellluo.com/2018/07/redis-replication-demystified.html
Redis의 Replication(복제) 는 하나의 Redis 인스턴스(Master)의 데이터를 다른 인스턴스들(Slave)에 복사하여 데이터 일관성, 읽기 성능, 가용성을 높이는 구조를 제공한다. Master–Slave 아키텍처 기반으로 동작하며, Redis의 고성능을 유지하면서도 확장성을 확보할 수 있는 핵심 기능이다.
Redis Replication은 Master 노드의 데이터를 Slave 노드로 복제하는 메커니즘이다. 이를 통해 다음과 같은 효과를 얻을 수 있다.
-
데이터 내구성 강화
Master 노드 장애 시 Slave 노드를 Master로 승격하여 서비스 중단을 최소화할 수 있다. -
읽기 성능 향상
Slave 노드가 읽기(Read) 요청을 분산 처리하므로 전체 시스템의 성능이 올라간다. -
고가용성 확보
여러 Slave 노드를 두면 하나의 노드 장애로 서비스가 중단되지 않는다.
복제(Replication) 동작 방법
Redis의 복제 과정은 다음 단계로 구성된다.
1) 초기 연결 및 전체 데이터 복제
Slave 노드는 Master 노드에 연결한 후 데이터 전체 복제(full sync) 를 요청한다.
Master는 자신의 전체 데이터 세트를 생성 후 Slave에 전송한다.
2) 실시간 명령 동기화
초기 복제가 완료되면,
- Master가 명령을 실행할 때마다
- 데이터 변경 명령(write) 역시 Slave 노드로 전달된다.
이를 통해 Slave 노드는 Master의 최신 상태를 실시간으로 유지하게 된다.
Master–Slave 아키텍처
🔹 쓰기(Write)는 Master로만 수행
- 모든 Write 요청은 Master Node로 전달된다.
- 쓰기 충돌 및 데이터 불일치를 방지하기 위한 구조이다.
🔹 읽기(Read)는 Slave에서 분산 처리
- 여러 Slave 노드가 Read 요청을 나눠 처리하므로 전체적인 읽기 성능이 향상된다.
- 트래픽이 많은 시스템에서 효과적이다.
Replication의 장점 정리
| 항목 | 설명 |
|---|---|
| 읽기 성능 향상 | Slave가 읽기를 담당해 부하 분산 |
| 고가용성(HA) | Master 장애 시 Slave 승격 가능 |
| 확장성(Scalability) | Slave 노드를 쉽게 추가하여 처리량 확대 |
| 데이터 보호 | 복제본이 있어 데이터 소실 위험 감소 |
Redis의 Replication은 단순한 구조지만 매우 강력한 고가용성 아키텍처를 제공한다.
Master–Slave 구조를 이용해 읽기 성능을 높이고 장애 대응력을 강화할 수 있어 대규모 트래픽 환경에서 필수적인 기술이다.
📌 2. Redis Sentinel
Redis Sentinel은 Redis의 고가용성(High Availability) 을 보장하기 위한 감시·자동 복구 시스템이다.
Master 노드를 자동으로 감지하고, 문제가 생기면 Slave를 Master로 자동 승격(failover) 해준다.
Sentinel은 다음 기능을 제공한다.
- Master 장애 감지(Monitoring)
- Redis 서버를 지속적으로 감시해 장애 여부를 판단한다.
- 자동 Failover
- Master가 다운되면 Slave 중 하나를 자동으로 새로운 Master로 승격한다.
- Master 위치 자동 안내
- Client는 Sentinel에게 질의하여 현재 Master가 누구인지 자동으로 알 수 있다.
Sentinel 동작 방법
1) Redis 서버 모니터링
- Sentinel 프로세스들이 Master/Slave를 지속적으로 “ping” 하며 상태를 체크한다.
2) 장애 감지
- Master 응답 없음 → Sentinel 다수결(quorum)로 "Master 장애" 판단.
3) 자동 Failover
- Slave 하나를 선택해 Master로 승격하고,
나머지 Slave들은 새 Master를 기준으로 다시 복제 설정된다.
4) 클라이언트 재연결
- Sentinel이 새 Master 정보를 알려주기 때문에 서비스 중단을 최소화한다.
Sentinel의 장점
- 자동 장애 복구
- Master 장애 시 자동 승격
- 고가용성 제공
- 실서비스 무중단 운영 가능
- Master 위치 자동 안내
- 클라이언트가 매번 Master를 직접 알 필요 없음
- 간단한 구성
- Cluster보다 구조가 단순함

📌 3.Redis Cluster
Redis Cluster는 샤딩(Sharding) 기반으로 데이터를 여러 노드에 분산 저장하여 수평 확장(Scaling Out) 과 고가용성을 동시에 제공하는 Redis 구조이다.
여러 Redis 노드를 묶어 하나의 거대한 Redis처럼 동작하게 만든 구조로,
- 데이터 분산 저장(Sharding)
- 노드 장애 자동 처리
- 수평 확장성(Scalability)
을 동시에 제공한다.
Cluster 동작 방법
1) 슬롯(Hash Slot) 기반 샤딩
- Redis Cluster는 전체 데이터를 16384개 슬롯으로 나누고,
각 슬롯을 노드들이 나눠 맡아 저장한다.
2) 자동 라우팅
- Client는 어떤 키가 어느 노드에 저장돼야 하는지 자동으로 판단한다.
3) 노드 장애 시 자동 복구
- 노드가 죽으면 해당 노드의 Slave가 자동으로 Master로 승격한다.
4) 확장성 제공
- 노드를 추가하면 바로 슬롯을 재배치해 데이터가 분산된다.
Cluster의 장점
- 샤딩 지원
- 대용량 데이터 저장 가능
- 수평 확장
- 노드를 추가하는 것만으로 확장
- 고가용성 제공
- Master–Slave 구조로 장애 자동 처리
- 분산 저장
- 부하가 자연스럽게 여러 노드로 분산

총 정리 이미지
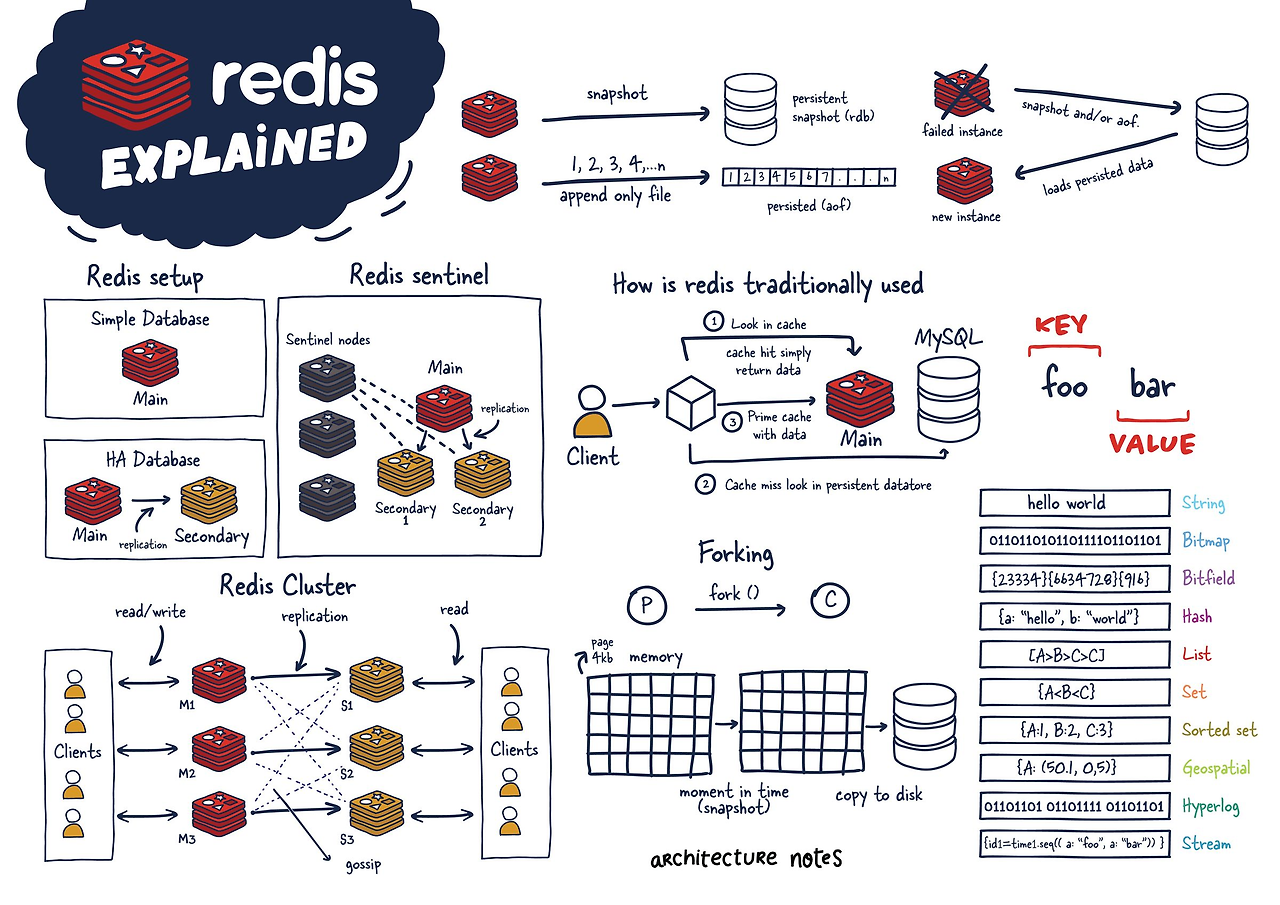
아주 큰 도움을 받은 출처 : https://adjh54.tistory.com/447
🔹오늘의 나는 무엇을 잘했는지 (성취)
Redis를 완전히 처음 접했는데, 기본 개념(키-값 구조, 메모리 기반 저장 방식)을 이해했다.
🔹어떤 문제를 겪었고, 어떻게 해결할지 (개선)
TTL, In-memory 구조 같은 개념들이 처음엔 헷갈렸다. 다음엔 개념을 간단하게 도식화해서 흐름도를 먼저 정리해보고 학습해보면 좋을 것 같다.
🔹오늘 배운 것 (학습)
Redis는 디스크가 아니라 메모리 기반이라 속도가 매우 빠르다는 점을 알게 됐다. 그리고 Key-Value 형태로 데이터를 저장하는 구조라 단순 조회나 캐싱에 유용하다는 것도 배웠다.
🔹나만의 팁 or 복습 방법
헷갈렸던 개념은 간단한 메모나 그림으로 정리해 두니 기억하기 좋았다.