이 글은 개인 블로그에 먼저 올렸습니다. 글 속 그림은 원래 움직이는 애니메이션이라, 블로그에서 보면 과정을 단계별로 따라가며 볼 수 있습니다.
들어가며
지난 글에서는 Armeria에 처음 기여한 이야기를 썼다. 그때는 내가 회사에서 겪은 문제를 들고 가서 이런 기능이 필요하지 않겠냐고 제안했다.
첫 기여를 마치고 나니 Armeria 내부를 더 공부해보고 싶어졌다. 이번에는 기능을 제안하는 대신, 내부 구조를 깊게 들여다볼 수 있는 이슈를 찾아보기로 했다. 지난 글에서 대부분의 오픈소스 기여는 메인테이너가 등록해둔 이슈에 손을 드는 것에서 시작한다고 썼는데, 이번에는 나도 그 방식으로 해보고 싶었다.
그렇게 고른 게 gRPC 서버에서 요청과 응답의 직렬화를 어느 스레드에서 실행할지에 관한 이슈였다. 그리고 이번에 PR이 머지되었다.
이미 해결 방향까지 나와 있는 이슈라 시작하기는 수월했다. 다만 어디까지 구현해서 어떤 순서로 PR을 올릴지는 내가 직접 설계해야 했기 때문에 생각보다 쉽지 않았다.
첫 PR: CallExecutor부터 만들기
맡은 이슈는 #6241이다.
Armeria gRPC 서버에는 useBlockingTaskExecutor(true)라는 옵션이 있다. 서비스 로직을 이벤트 루프 대신 별도 스레드 풀에서 실행하게 하는 옵션이다.
그런데 이 옵션을 켜도 요청 역직렬화와 응답 직렬화는 여전히 이벤트 루프에서 실행되고 있었다. 메시지가 크거나 gzip 압축까지 사용하면, 그 작업이 끝날 때까지 이벤트 루프가 다른 일을 처리하지 못한다.
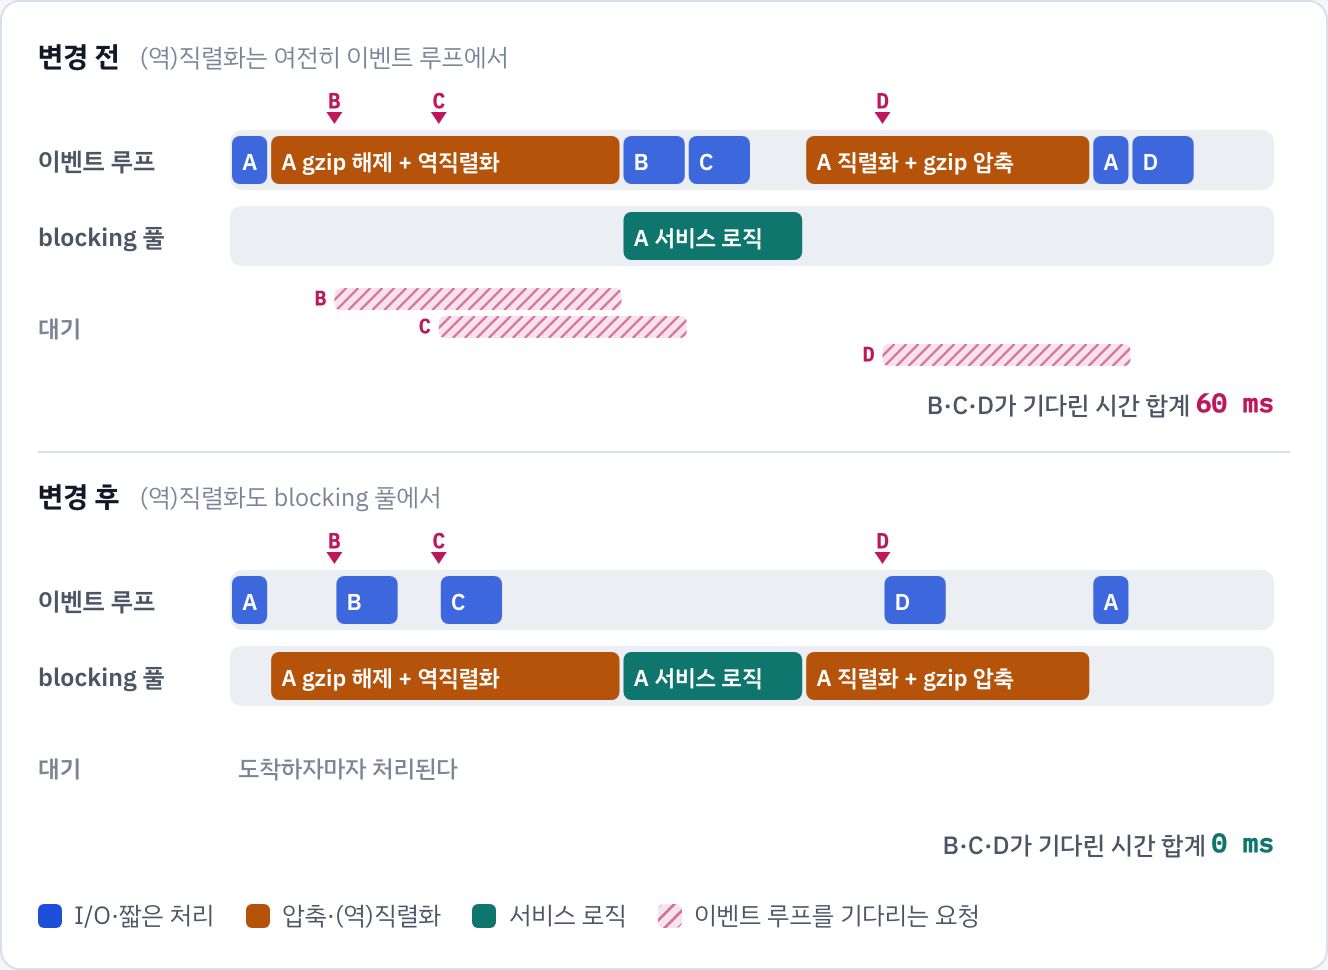
큰 gzip 요청 A 하나가 들어온 동안의 타임라인. 시간은 개념적인 예시다.
이슈에서 제안한 동작은 다음과 같았다.
- 요청 역직렬화와 압축 해제는
ServerCall.Listener콜백을 호출하는 스레드에서 한다. - 응답 직렬화와 압축은 사용자가
sendMessage()를 호출한 스레드에서 한다.
접근 방법도 두 가지가 나와 있었다. ikhoon님은 직렬화와 역직렬화 호출 위치를 옮기는 방법을 제안했다. jrhee17님은 조금 더 넓은 범위의 개선안을 제안했다. 작업을 순서대로 실행하고 재진입도 처리하는 Executor를 만들어, 여기저기 흩어진 blockingTaskExecutor 분기까지 정리하자는 것이었다.
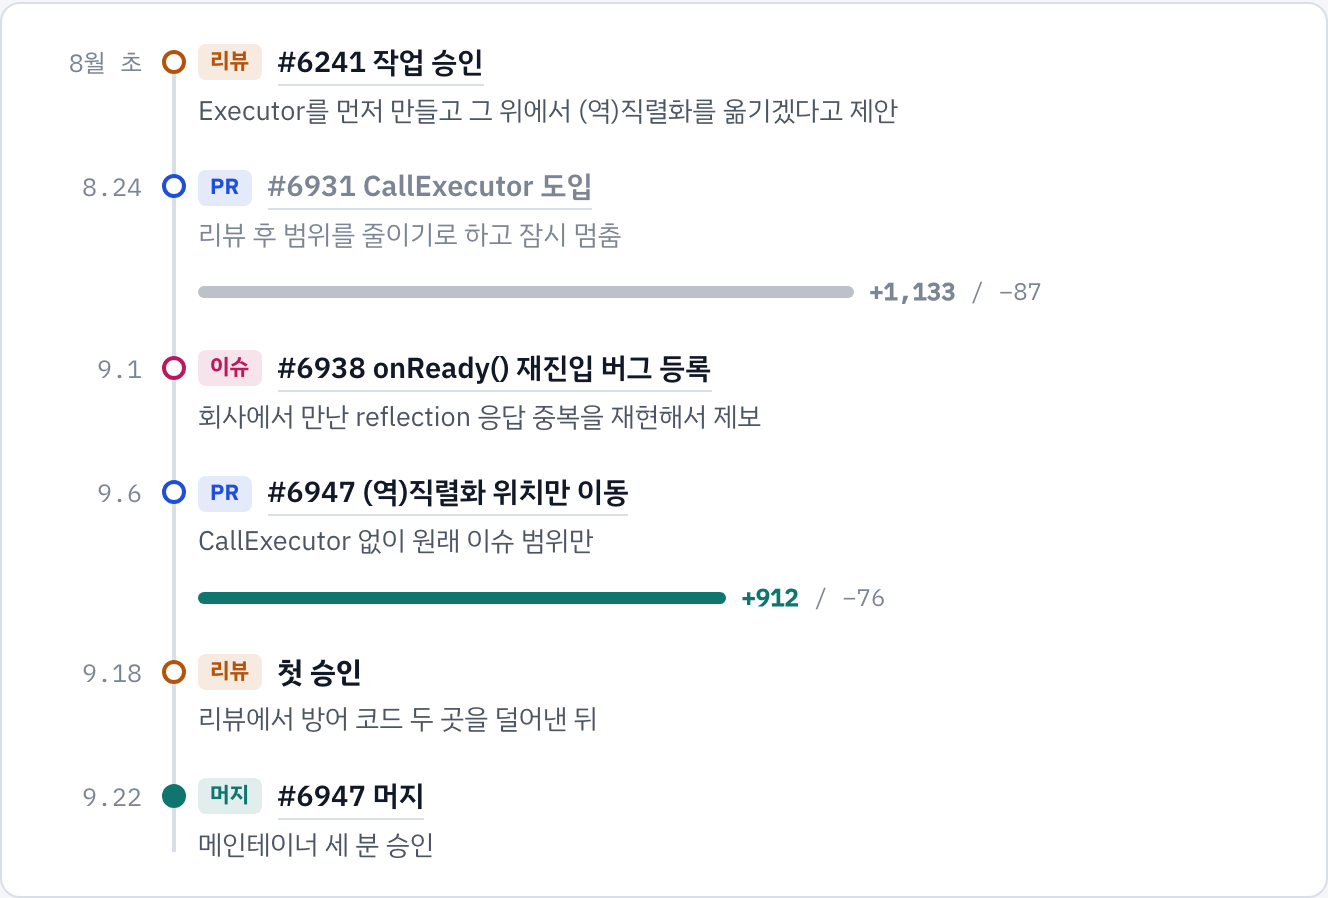
나는 Executor를 먼저 만들고 그 위에서 직렬화와 역직렬화를 옮기겠다고 했다. 8월 초에 ikhoon님의 승인을 받고 작업을 시작했다.
어차피 둘 다 할 거라면 기반부터 정리하는 게 좋겠다고 생각했다. 큰 쪽이 더 재밌어 보이기도 했다.
8월 말에 첫 PR인 #6931을 올렸다. CallExecutor라는 추상화를 만들고, 이벤트 루프용과 blocking executor용 구현을 각각 붙였다. 서버 호출 경로에서 실행을 넘기던 여섯 곳도 이쪽으로 옮겼다.
11개 파일에 +1,133 / -87. 생각보다 커졌다.
PR을 올린 뒤에도 고칠 게 있었다. 커밋 직전에 Javadoc을 손보다가 {@link}를 지웠는데, 거기서 쓰던 import가 미사용 상태가 되면서 lint가 깨졌다. 로컬에서 확인한 뒤에 조금만 고쳤다고 생각했는데 그 조금이 문제였다.
그다음에는 BlockHound가 걸렸다. 테스트에서 이벤트 루프 스레드로 CountDownLatch.await()을 호출하고 있었다.
그렇게 CI를 고치며 기다리다가, 일주일쯤 지나 jrhee17님의 리뷰를 받았다.
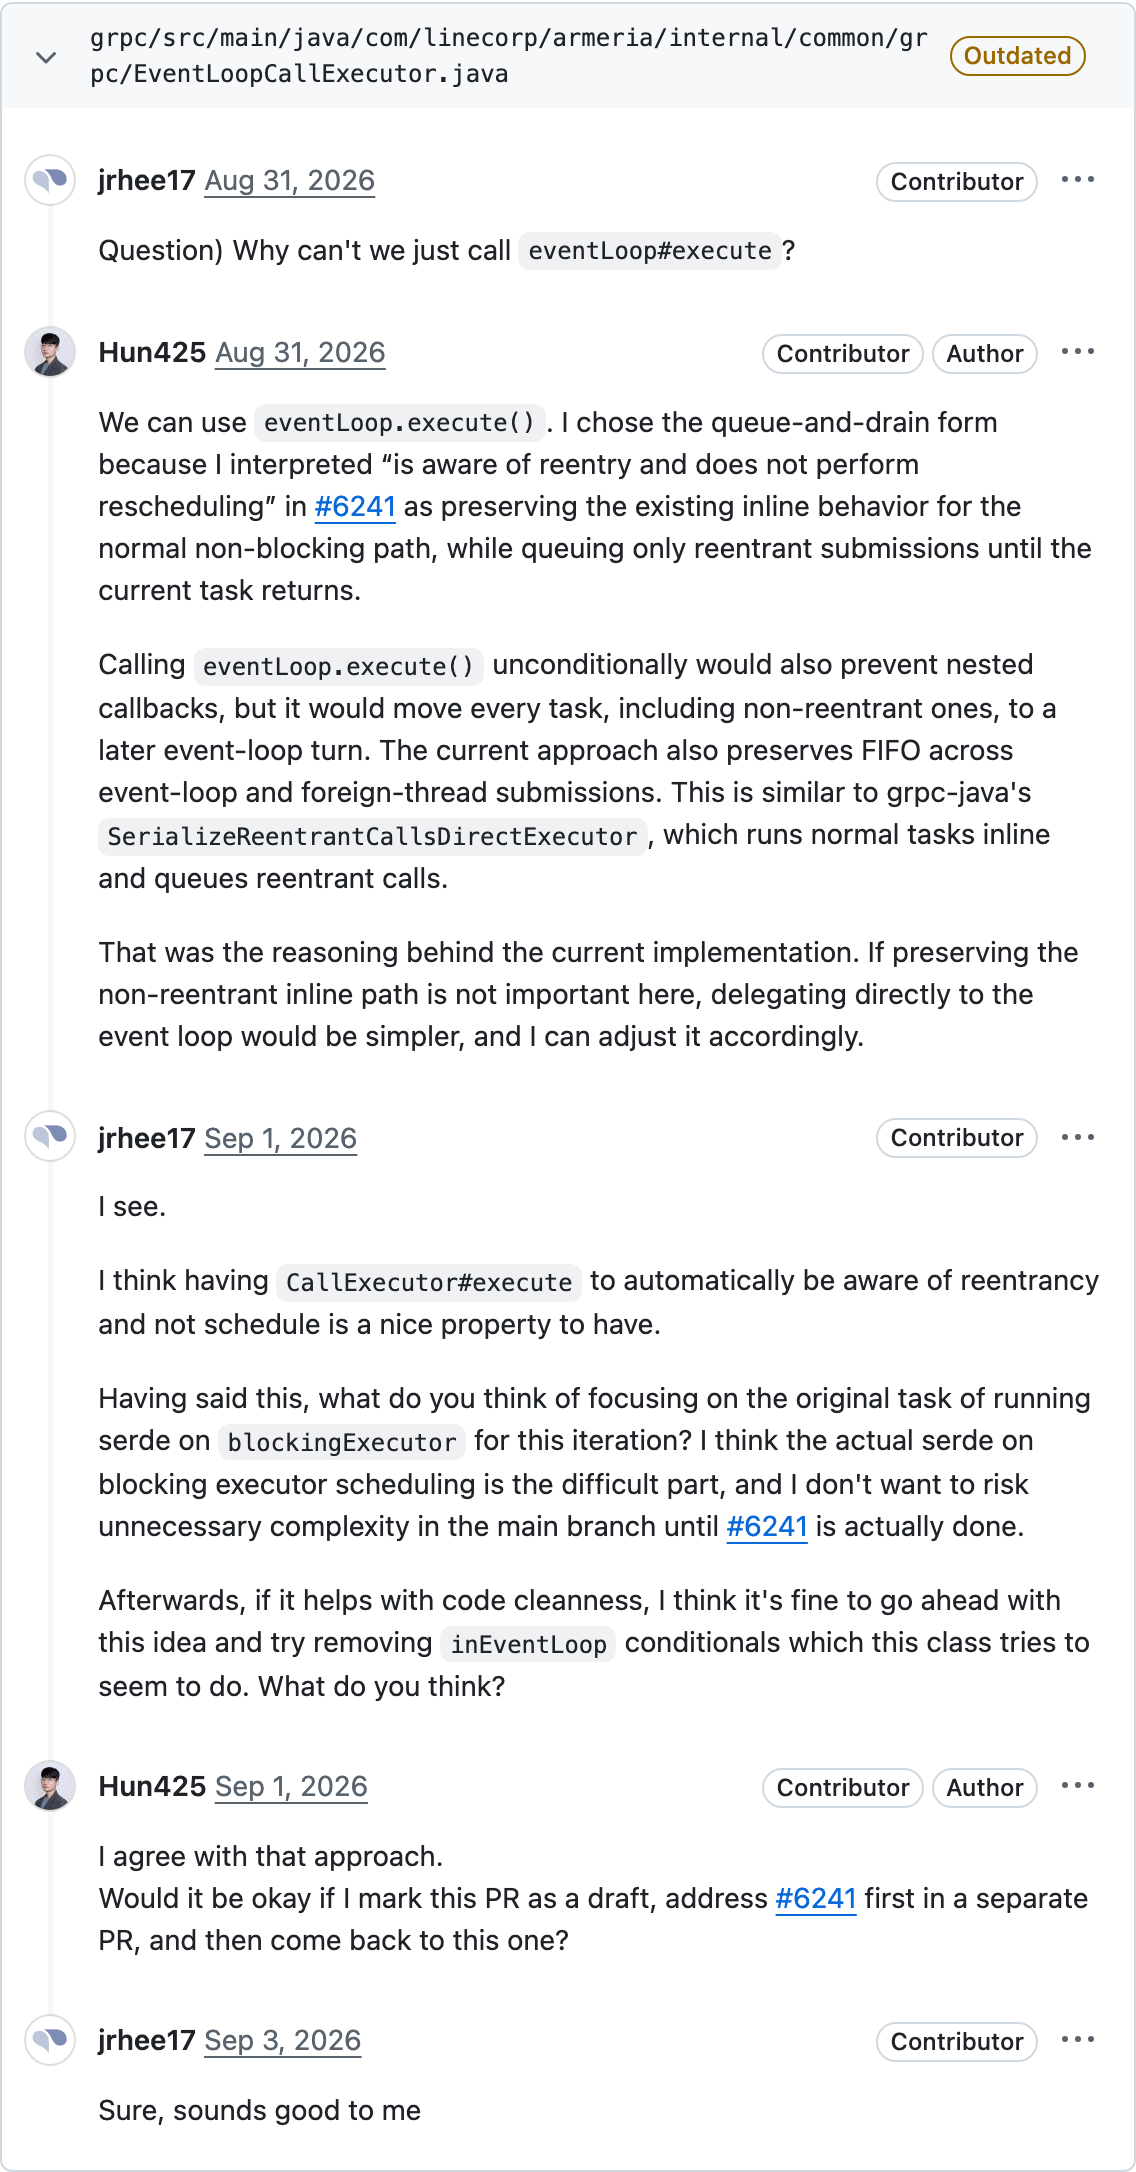
CallExecutor는 직렬 실행만 맡으면 된다는 리뷰 · GitHub에서 보기
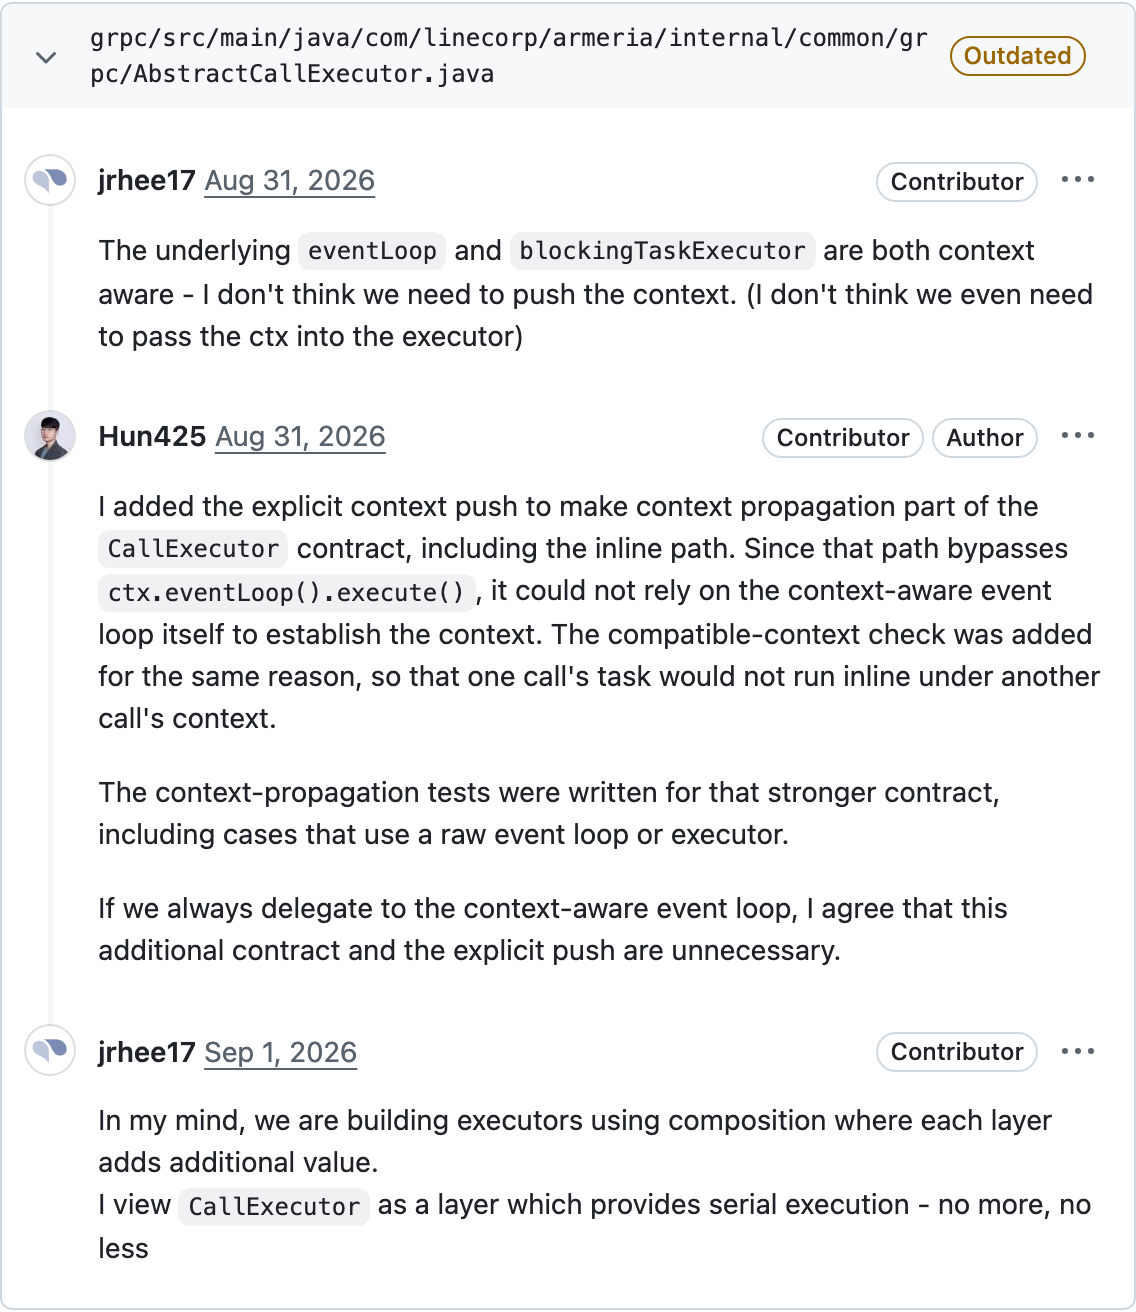
원래 이슈부터 끝내자는 리뷰와 PR을 draft로 돌리기로 한 대화 · GitHub에서 보기
요약하자면, CallExecutor는 작업을 직렬로 실행하는 역할만 맡으면 되고, 재진입 처리보다 원래 이슈의 직렬화·역직렬화 이동부터 끝내자는 리뷰였다.
나는 기반을 먼저 만들었다고 생각했는데, 리뷰를 받고 보니 원래 이슈를 해결하기도 전에 검토할 코드가 잔뜩 생긴 셈이었다. CallExecutor 자체의 역할도 내가 잡은 것보다 작았다.
우선 직렬화와 역직렬화만 옮기는 PR을 따로 만들기로 하고, #6931은 draft로 돌렸다.
회사에서 만난 재진입 버그
첫 PR의 리뷰를 기다리던 중에 회사에서 이상한 문제가 생겼다.
gRPC reflection 응답이 한 요청에 300~800번씩 중복으로 전송되고 있었다. Armeria 1.40에 grpc-java의 ProtoReflectionServiceV1을 붙인 구성이었다.
처음에는 우리 인터셉터를 의심했다. 그런데 코드를 따라가다 보니 마침 내가 작업하던 재진입 문제와 연결됐다.
문제의 코드는 StreamingServerCall에 있었다.
res.whenConsumed().thenRun(() -> {
    if (!isCloseCalled() && pendingMessagesUpdater.decrementAndGet(this) == 0) {
        final Executor blockingExecutor = blockingExecutor();
        if (blockingExecutor != null) {
            blockingExecutor.execute(this::invokeOnReady);
        } else {
            invokeOnReady();
        }
    }
});
blocking executor를 사용하지 않는 경로에서는 invokeOnReady()를 바로 호출한다. 응답이 즉시 소비되면 whenConsumed()의 콜백도 같은 호출 스택에서 실행될 수 있다.
그런데 reflection 서비스는 응답을 쓴 다음에 처리한 요청 필드를 null로 비운다. 응답을 쓰는 도중 onReady()가 다시 호출되면, 아직 요청 필드가 남아 있으니 같은 요청을 또 처리하게 된다.
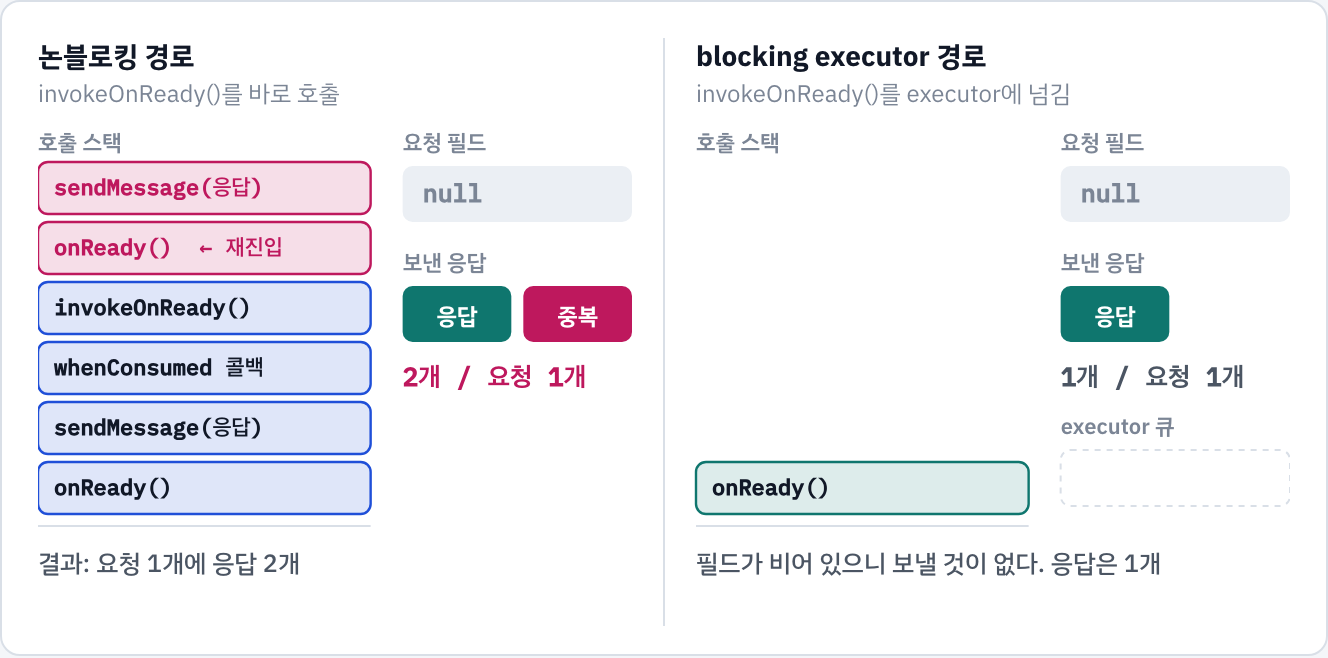
요청 하나를 받은 reflection 서비스의 호출 스택. 단계별로 넘겨 보려면 블로그에서.
인터셉터를 전부 빼고 순정 Armeria로도 재현해봤다. 한 스트림에서 요청 여섯 건을 이어 보내는 테스트였다.
| 구성 | 응답 수 |
|---|---|
| 논블로킹 경로 | 11 |
| 기대값 | 6 |
useBlockingTaskExecutor(true) | 6 |
프로덕션에서 본 수백 번의 중복까지 그대로 재현한 것은 아니었지만, 응답이 중복되는 현상은 확인할 수 있었다. blocking executor를 사용하면 정상적으로 여섯 건이 돌아왔다.
grpc-java 쪽 구현도 찾아봤다. 리스너 콜백을 SerializingExecutor로 직렬화하고 있었고, 경쟁 상태를 피하려면 콜백을 직렬로 실행해야 한다는 주석도 있었다. Armeria의 gRPC 클라이언트도 executor가 지정되면 newSequentialExecutor로 감싸고 있었다.
확인한 내용을 모아 #6938로 등록했다.
이후 다른 분이 댓글로 재현을 확인하고, onReady() 호출을 이벤트 루프로 미루는 수정을 제안했다. 내가 발견한 버그여서 내가 고치고 싶었는데 채가려고(?) 해서 좀 화났었다.
jrhee17님은 gRPC 호출 경로의 스레딩 모델과 동시성 처리가 함께 바뀌는 만큼, #6931 방향으로 해결하는 게 좋겠다고 답했다.
덕분에 이후 작업 순서도 정해졌다. 먼저 원래 이슈의 직렬화·역직렬화 이동을 끝내고, CallExecutor를 줄여서 다시 작업한 다음, 재진입 버그까지 해결하기로 했다.
draft로 돌려놓은 PR을 다시 이어갈 이유가 생겼다.
두 번째 PR: 직렬화 위치 옮기기
9월 첫째 주에 두 번째 PR 작업을 시작했다. 이번에는 CallExecutor를 건드리지 않고 직렬화와 역직렬화만 옮겼다.
핵심 변경은 두 가지였다.
- 요청 역직렬화와 압축 해제를 blocking executor 태스크 안으로 옮긴다.
- 응답 직렬화와 프레이밍, 압축을
sendMessage()호출자 스레드로 옮긴다.
여기까지는 금방 했다. 시간이 걸린 건 옮긴 뒤에 달라지는 동작을 확인하는 일이었다.
버퍼 해제 문제
응답을 호출자 스레드에서 미리 직렬화하면, 만들어진 버퍼를 이벤트 루프로 넘겨야 한다.
그사이에 호출이 취소될 수도 있고, 이벤트 루프에서 상태를 확인한 뒤 응답을 버릴 수도 있다. 유너리 호출에서는 만들어둔 응답을 쓰지 못한 채 호출이 끝날 수도 있다. 어느 경로로 빠지든 버퍼는 해제해야 했다.
특히 유너리 호출의 취소 경로에는 서브클래스가 버퍼를 정리할 지점이 없었다. 그래서 closeListener()가 처음 실행될 때 한 번 호출되는 훅을 추가했다.
코드의 실행 위치를 옮기는 작업이었지만, 버퍼를 누가 가지고 있다가 어디서 해제하는지도 다시 따라가야 했다.
압축 방식 결정 문제
기존에는 sendHeaders()가 이벤트 루프에 제출한 태스크 안에서 응답 압축 방식을 정했다. 서버에 gzip을 설정해도 클라이언트가 gzip을 받을 수 없다고 알려오면 압축하지 않는 식이다. 생성된 스텁은 sendHeaders() 직후에 sendMessage()를 호출한다.
응답 직렬화를 호출자 스레드로 옮기고 나면, 이벤트 루프가 헤더를 처리하기 전에 본문부터 직렬화할 수 있다. 사용자는 gzip을 설정했지만 클라이언트가 gzip을 지원하지 않는 경우, 헤더에는 identity가 들어가고 본문은 gzip으로 압축되는 식이다.
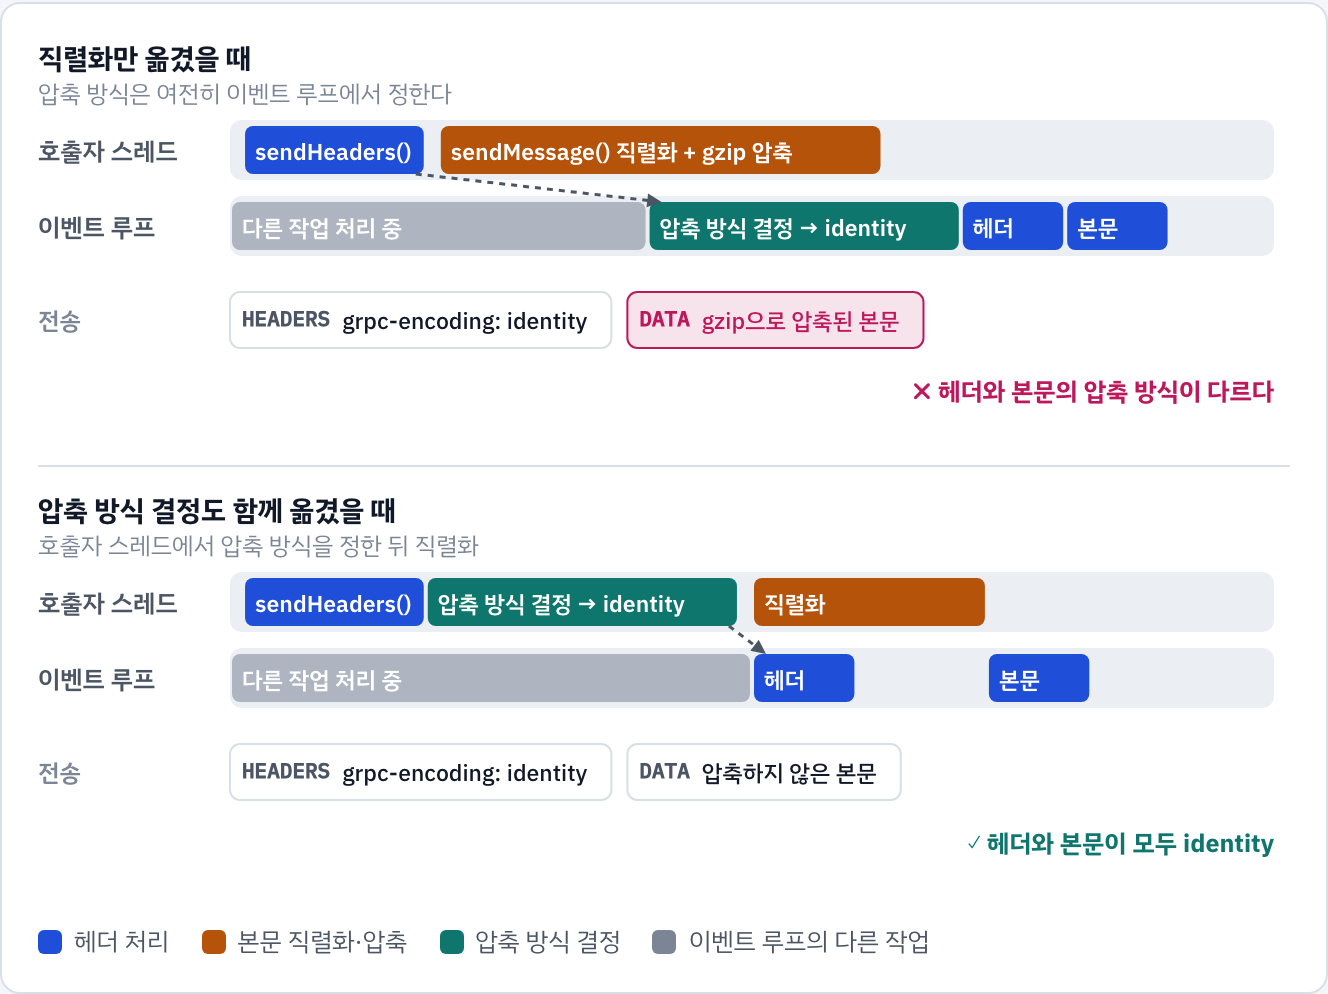
서버는 gzip을 설정했지만 클라이언트는 gzip을 지원하지 않는 경우.
설계할 때는 이 순서를 놓쳤다. 압축 방식을 정하는 일도 호출자 스레드로 함께 옮겨야 했다.
테스트에서는 이벤트 루프를 latch로 잠시 멈춰둔 상태에서 onNext()를 호출했다. 압축 방식을 기존 위치에서 정하면 "compression not configured" 오류로 실패해서, 순서가 바뀐 영향을 확인할 수 있었다.
역직렬화 실패 후 콜백 실행 문제
blocking executor에서 역직렬화가 실패하면 close()를 호출하는데, 실제 종료 처리는 다시 이벤트 루프로 넘어간다. 그 처리가 끝나기 전에 blocking executor의 큐에 있던 onHalfClose()가 실행될 수 있었다.
기존에는 역직렬화 실패와 리스너 종료가 같은 스레드에서 처리돼서 생기지 않던 순서였다.
실패 여부를 다른 스레드에서도 볼 수 있도록 volatile 플래그를 두고, 요청 콜백을 전달하기 전에 확인하도록 정리했다.
테스트도 결과값만 확인해서는 부족했다. 마샬러를 감싸서 parse()와 stream()이 실제 어느 스레드에서 실행되는지 기록했다. 버퍼 누수는 할당한 버퍼를 모두 추적하는 unpooled 할당자를 사용해, 연결이 끝난 뒤 참조 카운트가 전부 0인지 확인했다.
최종 리뷰 받기
작업하다 보니 커밋이 여덟 개까지 늘어났다.
PR을 올리기 전에 grpc-java 1.83 구현과 다시 비교했다. 내가 추가한 도중 취소 재검사와 지연 압축 해제까지 필요한지 확인하고 싶었다. 비교한 구현에서는 시작 전 취소 확인과 producer 정리를 하고 있었고, 내가 넣은 방어 중 일부는 이번 변경에서 꼭 가져갈 필요가 없겠다고 판단했다.
그 부분을 덜어내고 커밋 다섯 개로 정리해서 #6947을 올렸다. 7개 파일에 +912 / -76이었다. 범위를 줄였는데도 여전히 작지는 않았다.
리뷰에서는 두 가지를 더 빼자는 이야기가 나왔다.
하나는 executor가 태스크 제출을 거절했을 때 payload를 해제하는 try/catch였다.
jrhee17님은 이벤트 루프나 blocking executor가 태스크를 거절할 정도면 더 큰 문제가 있는 상황인데, 이 방어가 필요한지 물었다. 나는 이미 할당해둔 버퍼가 누수될 수 있다고 답했다.
minwoox님은 그 상황이 더 심각한 문제를 뜻한다는 데 동의하면서, 코드베이스의 다른 곳에서도 이 방어를 일관되게 하고 있지는 않으니 단순하게 유지하자고 정리해줬다.
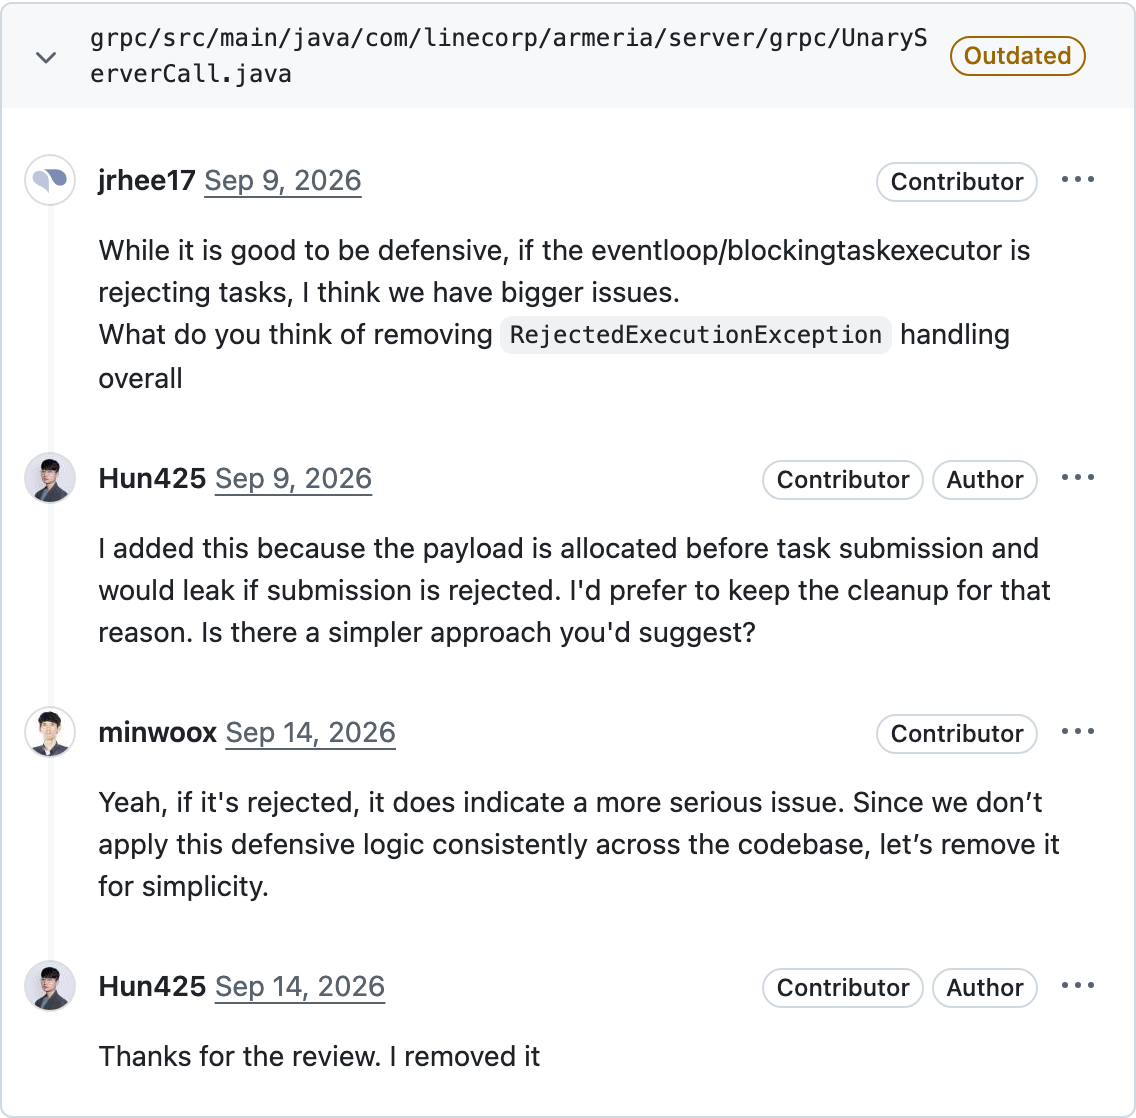
태스크 제출 거절 시 payload 해제 코드를 두고 나눈 대화 · GitHub에서 보기
다른 하나는 유너리 응답의 직렬화가 실패했을 때, 종료 처리를 doClose()까지 미루는 코드였다.
비동기 예외 핸들러가 결과를 내기 전에 사용자가 close(OK)를 호출하면, 실패를 처리하려던 결과가 정상 종료에 밀릴 수 있었다. 그 순서를 막고 기존 동작을 유지하려고 넣은 장치였다. 리뷰에서도 그렇게 설명했다.
jrhee17님은 이 경우를 위해 복잡도를 더할 필요는 없겠다고 답했다. 타임아웃도 비동기 예외 핸들러를 거치면 비슷한 상황이 생길 수 있다는 설명이었다.
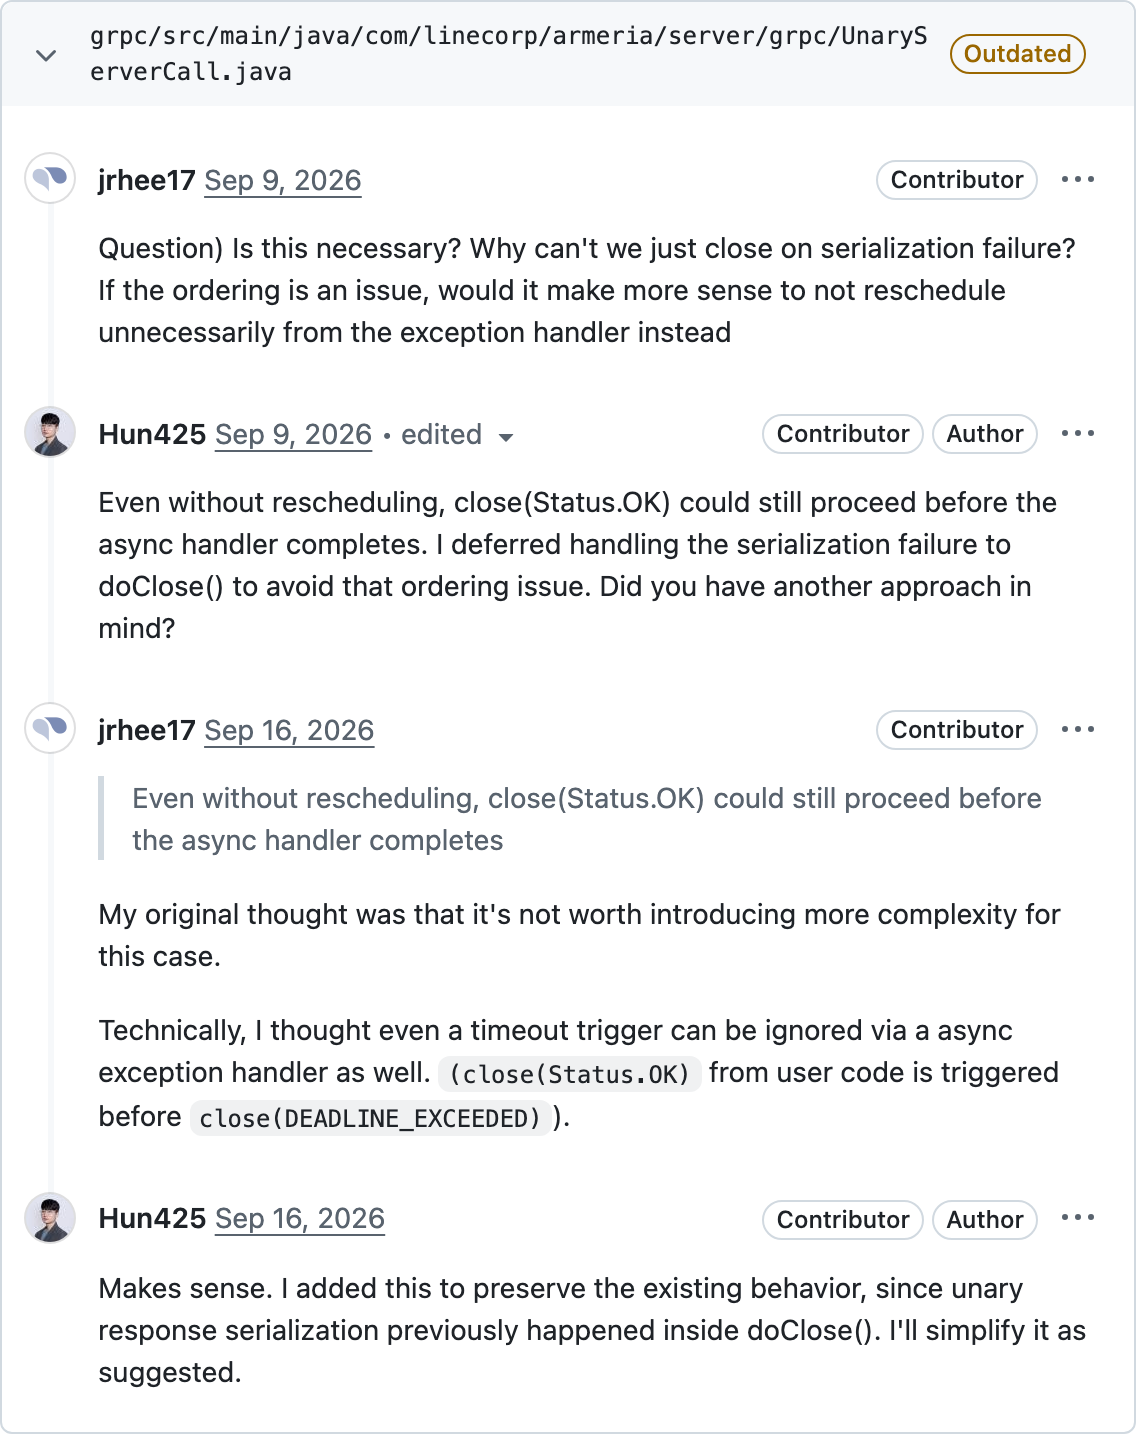
직렬화 실패 처리를 doClose()까지 미루는 코드를 두고 나눈 대화 · GitHub에서 보기
결국 두 부분 다 제거했다.
처음에는 필요한 이유가 있어서 넣은 코드라 설명부터 하게 됐다. 버퍼가 누수될 수 있고, 종료 순서가 달라질 수 있다는 것도 사실이었다. 다만 리뷰어들은 그 상황을 이 PR에서 어디까지 다룰지, 기존 코드와 비교했을 때 얼마나 복잡해지는지를 함께 보고 있었다.
내가 걱정한 경우를 설명한 뒤에도 코드를 빼기로 합의할 수 있다는 게 이번에는 조금 낯설었다. 지난 기여에서는 필요성을 설명하고 구현을 보완하는 쪽에 익숙해져 있었던 것 같다.
9월 18일에 jrhee17님의 승인을 받았다.
이후 ikhoon님과 minwoox님도 승인했고, 9월 22일에 머지됐다.
마무리
메인테이너가 해결 방향까지 적어둔 이슈라 구현에 집중하면 될 줄 알았다. 그런데 돌아보니 구현 범위를 정하고, PR을 나누고, 넣었던 코드를 빼는 데도 꽤 많은 시간을 썼다.
특히 CallExecutor부터 만들겠다고 한 선택은 다음에도 떠오를 것 같다. 내 입장에서는 뒤에 할 작업까지 생각해서 순서를 정한 건데, 첫 PR만 보는 사람에게는 왜 지금 이만큼 바꿔야 하는지부터 설명해야 했다. 처음부터 직렬화와 역직렬화를 옮기는 작업을 먼저 냈다면 어땠을까 싶다.
개인적으로 가장 뿌듯했던 건 회사에서 겪은 버그를 재현해서 이슈로 올린 일이었다. 기여하면서 읽어둔 코드 덕분에 실제 문제의 원인까지 따라갈 수 있었다. 이번에는 컨트리뷰터 뱃지만큼이나 내가 올린 이슈에 붙은 defect 라벨이 반가웠다.
다시 #6931로
지금은 draft로 돌려둔 #6931로 다시 돌아와서 작업 중이다.
첫 기여와 이번 두 번째 기여(#6947)는 눈앞의 문제를 해결하는 작업이었다. #6947이 머지된 뒤 이어서 잡은 세 번째 작업은 draft로 돌려뒀던 #6931을 다시 설계하는 일이고, 이번에는 조금 다르게 접근하고 있다. executor가 어떤 속성을 가져야 하는지, 작업을 직렬로 실행한다는 게 정확히 무엇을 보장해야 하는지부터 이해하고, 그 위에서 필요한 부분만 직접 설계해보고 있다.
리뷰에서 들은 "executor는 조합으로 쌓고, 각 층은 한 가지 가치만 더한다"는 이야기가 출발점이 됐다. 그래서 Armeria가 어떤 원칙으로 코드를 쌓아왔는지도 함께 찾아보는 중이다. CallExecutor를 직렬 실행이라는 역할 하나만 남도록 다시 설계하고 나면, reflection에서 발견한 재진입 문제도 그 위에서 해결할 수 있을 것이다.
다음 글에서는 그 과정에서 정리한 내용을 가져올 예정이다!!
관심 있는 오픈소스로 공부하는 건 언제나 재밌는 것 같다.
그리고 메인테이너와 소통을 잘 하려면 번역기 안 쓰게 영어 공부도 좀 해야겠다고 느꼈다...