다채로운 웹 서버
웹 서버는 HTTP 요청 처리, 응답 제공
웹 서버 구현
- HTTP 및 TCP 처리
(TCP 커넥션 관리에 대한 책임을 운영체제와 나눠 갖음) - 웹 리소스 관리
- 웹 서버 관리 기능 제공
다목적 소프트웨어 웹 서버
- 다목적 소프트웨어 웹 서버는 네트워크에 연결된 표준 컴퓨터 시스템에서 동작
- 아파치, 직소 등
오픈 소스 소프트웨어or 마이크로소프트나 아이플래닛의 웹 서버 같은상용 소프트웨어사용 가능 - 모든 인터넷 웹 사이트의 37%가 마이크로소프트 웹 서버 통해 서비스
임베디드 웹 서버
- 일반 소비자용 제품(프린터, 가전제품 등)에 내장될 목적으로 만들어진 작은 웹 서버
- 기기를 간편한 웹 브라우저 인터페이스로 관리할 수 있게 해줌
진짜 웹 서버가 하는 일
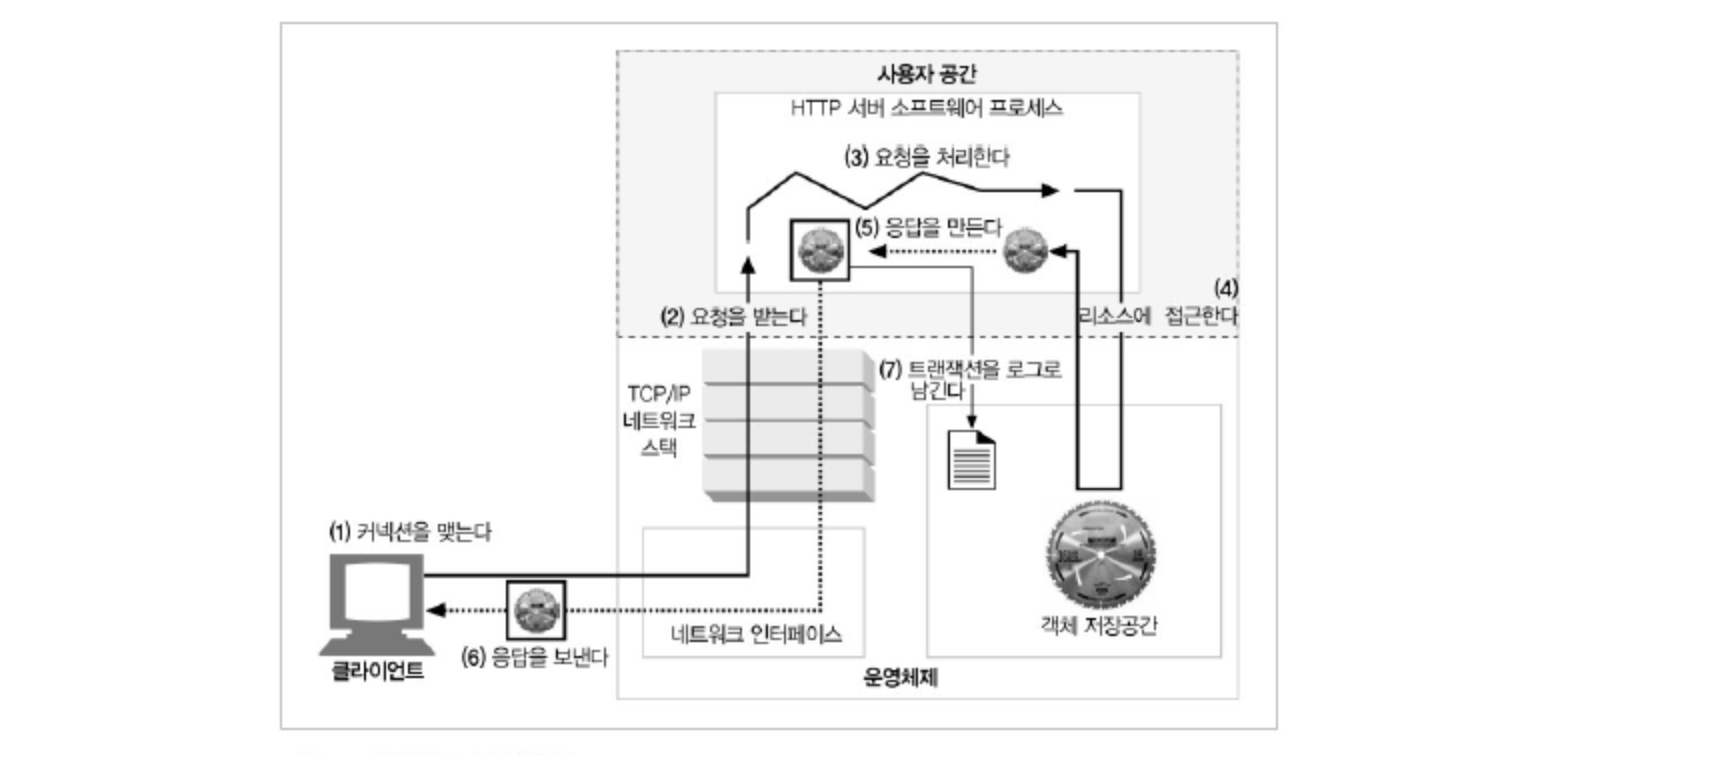
- 커넥션을 맺음 (클라이언트의 접속을 받아들이거나, 원치 않느 클라이언트라면 닫음)
- 요청 받음 (HTTP 요청 메시지를 네트워크로부터 읽어들임)
- 요청 처리 (요청 메시지 해석하고 행동)
- 리소스 접근 (메시지에서 지정한 리소스에 접근)
- 응답을 만듦 (올바른 헤더를 포함한 HTTP 응답 메시지 생성)
- 응답 보냄 (응답을 클라이언트에 돌려줌)
- 트랜잭션을 로그로 남김 (로그파일에 트랜잭션 완료에 대한 기록 남김)
단계 1: 클라이언트 커넥션 수락
새 커넥션 다루기
- 클라이언트가 웹 서버에 TCP 커넥션 요청 시, 웹 서버는 커넥션을 맺고 TCP 커넥션에서 IP 주소를 추출하여 커넥션 맞은 편에 어떤 클라이언트가 있는지 확인
- 새 커넥션이 맺어지고 받아들여지면 서버는 새 커넥션을 커넥션 목록에 추가하고 커넥션에서 오가는 데이터를 지켜보기 위한 준비
- 웹 서버는 어떤 커넥션이든 마음대로 거절 or 닫을 수 있음
클라이언트 호스트 명 식별
- 대부분의 웹 서버는
역방향 DNS를 사용해 클라이언트의 IP 주소를 클라이언트의 호스트 명으로 변환하도록 설정되어 있음 - 웹 서버는 클라이언트 호스트 명을 구체적인 접근 제어와 로깅을 위해 사용할 수 있음
- But,
호스트명 룩업은 시간이 많이 걸려 웹 트랜잭션을 느려지게 할 수 있어 많은 대용량 웹 서버는 호스트 명 분석을 꺼두거나 특정 콘텐츠에 대해서만 켜놓음
ident를 통해 클라이언트 사용자 알아내기
ident 프로토콜: 서버에게 어떤 사용자 이름이 HTTP 커넥션을 초기화했는지 찾아낼 수 있게 해줌
찾아낸 정보는 웹 서버 로깅에서 유용하기 때문에, 일반 로그 포맷의 두 번째 필드는 각 HTTP 요청의 ident 사용자 이름을 담고 있음
클라이언트가 ident 프로토콜 지원한다면 클라이언트는 ident 결과를 위해 TCP 포트 113번 listen
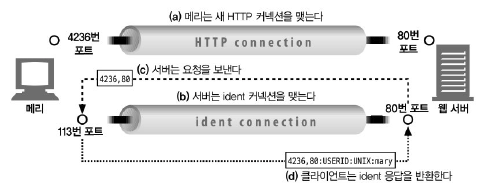
ident는 조직 내부에서는 잘 사용할 수 있지만, 공공 인터넷에서는 여러 이유로 동작하지 않음
- 많은 클라이언트 PC는 identd 신원확인 데몬 SW 실행 안함
- ident 프로토콜은 HTTP 트랜잭션을 유의미하게 지연시킴
- 방화벽이 ident 트래픽이 들어오는 것을 막는 경우 많음
- ident 프로토콜은 안전하지 않고 조작하기 쉬움
- ident 프로토콜은 가상 IP 주소를 잘 지원하지 않음
- 클라이언트 사용자 이름의 노출로 인한 프라이버시 침해 우려
아파치의 경우 IdentityCheck를 통해 ident 룩업을 사용할 수 있음
단계 2: 요청 메시지 수신
커넥션에 데이터가 도착하면 웹 서버는 네트워크 커넥션에서 그 데이터를 읽어 들이고 파싱하여 요청 메시지 구성
요청 메시지를 파싱할 때
- 요청줄을 파싱하여
요청 메서드,URI,버전 번호찾음 - 메시지 헤더들을 읽음
- 헤더의 끝을 의미하는 CRLF로 끝나는 빈 줄 찾음
- 요청 본문이 있다면 읽음
웹 서버는 입력 데이터를 네트워크로부터 불규칙적으로 받기에
파싱해서 이해할 수 있는 수준의 분량을 확보할 때까지 메모리에 임시 저장해 둘 필요가 있음
커넥션 입력/출력 처리 아키텍처
고성능 웹 서버는 수천 개의 커넥션을 동시에 열 수 있도록 지원
항상 언제 들어올지 모르는 새 요청을 주시하고 있음
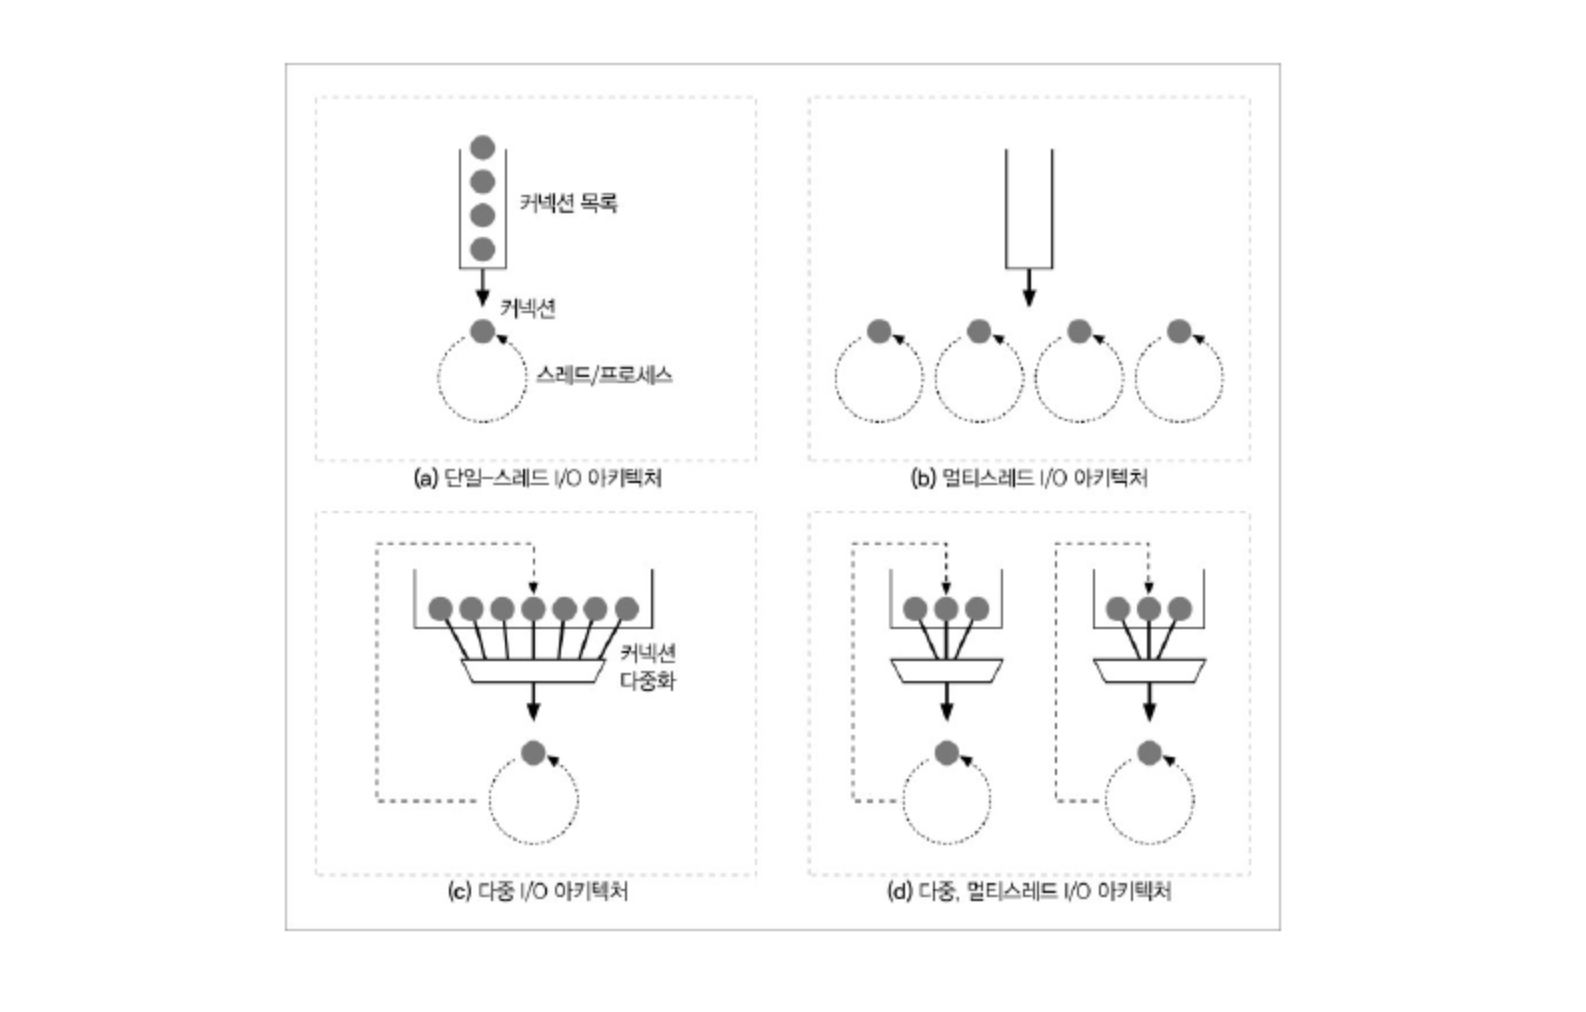
단일 스레드 웹 서버
- 한 번에 하나의 요청 처리 (트랜잭션 완료 시, 다음 커넥션 처리)
- 구현 간단하지만 처리 도중 다른 커넥션 무시 => 심각한 성능 문제
멀티프로세스와 멀티스레드 웹 서버
여러 요청을 동시에 처리하기 위해 여러 개의 프로세스 혹은 고효율 스레드를 할당
- 스레드/프로세스는 필요할 때마다 만들어질 수도 있고 미리 만들어질 수도 있음
- 서버가 동시에 여러 커넥션 처리 시 그로 인해 만들어지는 수많은 프로세스나 스레드는 너무 많은 메모리나 시스템 리소스 소비하기에 많은 멀티스레드 웹 서비스가 스레드/프로세스의 최대 개수 제한
다중 I/O 서버
대량의 커넥션을 지원하기 위해 많은 웹 서버는 다중 아키텍처 채택
다중 아키텍처는
- 모든 커넥션은 동시에 그 활동 감시 당함
- 커넥션의 상태가 바뀌면 그 커넥션에 대해 작은 양의 처리가 수행
- 처리가 완료되면 커넥션은 다음 상태 변경을 위해 열린 커넥션 목록으로 돌아감
(= 어떤 커넥션에 대해 작업을 수행하는 것은 그 커넥션에 실제로 해야 할 일이 있을 때 뿐으로 프로세스와 스레드가 유휴 상태의 커넥션에 매여 리소스를 낭비하지 않음)
다중 멀티스레드 웹 서버
- 몇몇 서버는 자신의 컴퓨터 플랫폼에 올라와 있는 CPU 여러 개의 이점을 살리기 위해, 멀티스레딩과 멀티플렉싱 결합
- 여러 개의 스레드는 각각 열려있는 커넥션을 감시하고 각 커넥션에 대해 조금씩 작업 수행
단계 6: 요청 처리
웹 서버가 요청 받으면, 서버는 요청으로부터 메서드, 리소스, 헤더, 본문을 얻어내어 처리
POST를 비로산 몇몇 메서드는 본문 요구GET은 본문 금지OPTIONS와 같은 메서드는 본문을 허용하되 요구하지는 않음
단계 4: 리소스의 매핑과 접근
웹 서버는
- 리소스 서버
- 미리 HTML이나 JPEG와 같은 콘텐츠를 만들어두고 제공
- 서버 위에서 동작하는 리소스 생성 애플리케이션을 통해 만들어진 동적 콘텐츠도 제공
- 요청의 URI에 대응하는 컨텐츠나 컨텐츠 생성기를 찾아서 그 컨텐츠의 원천을 식별해야 함
Docroot
웹 서버는 여러 종류의 리소스 매핑 지원
리소스 매핑의 가장 단순한 형태는 요청 URI를 웹 서버의 파일 시스템 안에 있는 파일 이름으로 사용하는 것
- 웹 서버의 파일 시스템의 특별한 폴더인
docroot라는 폴더를 웹 컨텐츠를 위해 예약해 사용 - 요청 메세지에서 URI를 해당 문서 루트 뒤에 붙이면 웹 콘텐츠 제공할 수 있음
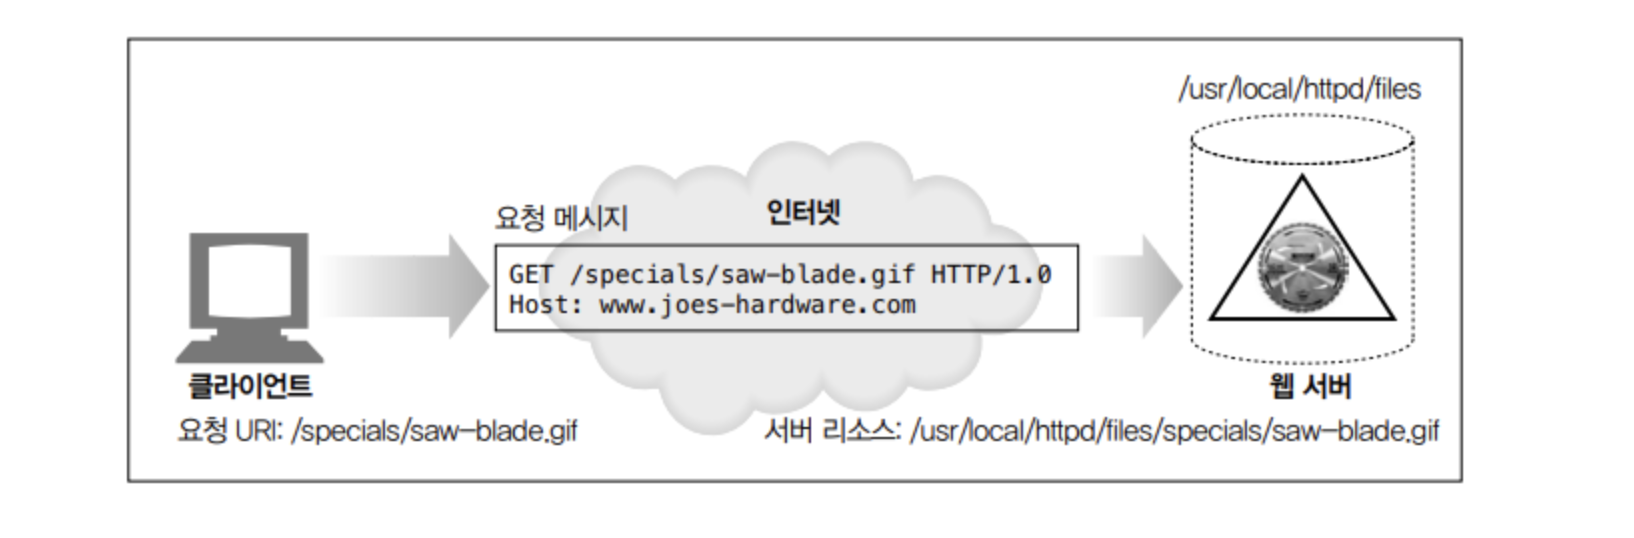
/specials/saw-blade.gif에 대한 요청 도착- 웹 서버는 문서 루트
/usr/local/httpd/files갖고 있음 - 웹 서버는 루트+URI인
/user/local/httpd/files/specials/saw-blade.gif파일 반환
아파치의 경우 httpd.conf 설정 파일에 DocumentRoot 추가해 설정 가능
DocumentRoot /usr/local/httpd/files서버는 상대적인 url이 docroot를 벗어나 파일 시스템의 docroot 이외 부분이 노출되는 일이 생기지 않도록 주의해야 함
가상 호스팅된 docroot
가상 호스팅 웹 서버는
- 각 사이트에 그들만의 분리된 문서 루트를 주는 방법으로
한 웹 서버에 여러 개의 웹 사이트를 호스팅 - URI나 Host 헤더에서 얻은 IP 주소나 호스트 명을 이용해 올바른 문서 루트 식별
(=> 하나의 웹 서버 위에서 두 개의 사이트가 완전히 분리된 콘텐츠를 가지고 호스팅이 되도록 할 수 있음)
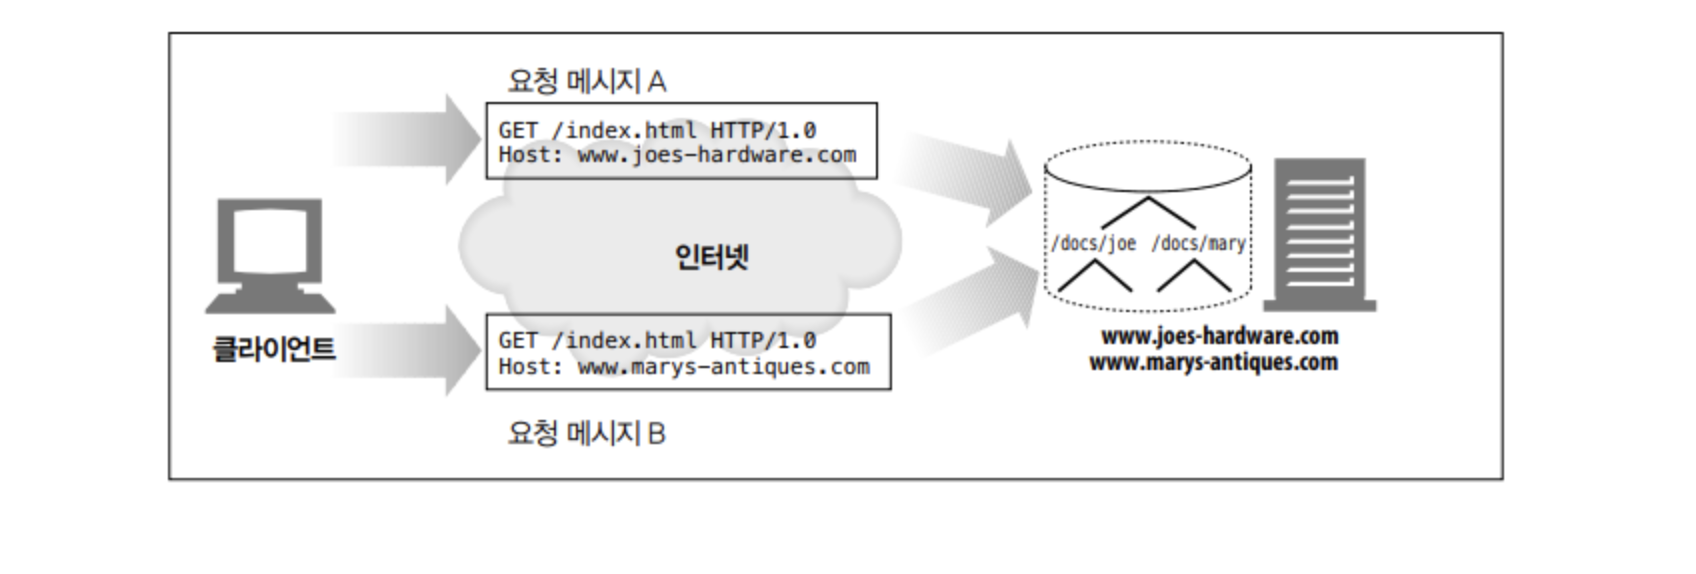
- 요청 A 도착 시, 서버는 /docs/joe/index.html 파일 가져옴
- 요청 B 도착 시, 서버는 /docs/mary/index.html 파일 가져옴
가상으로 호스팅 되는 docroot 설정은 대부분의 웹 서버에서 간단
아파치 웹 서버에서는 각 가상의 웹 사이트의 VirtualHost 블록이 가상 서버에 대한 DocumentRoot 지시자를 포함하도록 설정해야 함

사용자 홈 디렉터리 docroots
docroot의 또 다른 대표적인 활동은 사용자들이 한 대의 웹 서버에서 각자의 개인 웹 사이트를 만들수 잇도록 해주는 것
/와~다음에 사용자 이름이 오는 것으로시작하는 URI는 그 사용자의 개인 문서 루트를 가리킴- 개인 docroot는 주로 사용자 홈 디렉터리 안에 있는 public_html로 불리는 디렉터리지만 설정에 따라 다름
디렉터리 목록
웹 서버에 디렉터리 URL에 대한 요청을 했을 시 웹 서버가 할 수 있는 응답
- 에러 반환
- 디렉터리 대신 특별한 색인 파일 파일 반환
- 디렉터리 탐색 후 디렉터리 구조를 담고 있는 HTML 페이지 반환
대부분의 웹 서버는 요청한 URL에 대응되는 디렉터리 안에서 index.html or index.htm으로 이름 붙은 파일을 찾음
만약 사용자가 어떤 디렉터리에 대한 URL을 요청했는데, 그 디렉터리가 index.html or index.htm이란 이름의 파일을 가지고 있다면 그 파일의 콘텐츠를 반환할 것
아파치 웹 서버에서 DirectoryIndex 설정 지시자를 사용해 기본 디렉터리 파일로 사용될 파일 이름의 집합을 설정할 수 있음
DirectoryIndex 지시자는 디렉터리 색인 파일로 사용될 모든 파일의 이름을 우선순위로 나열
사용자가 디렉터리 URI를 요청했을 때 기본 색인 파일이 없고 디렉터리 색인 기능이 꺼져 있지 않다면, 웹 서버는 자동으로 그 디렉터리의 파일들을 크기, 변경일 및 그 파일에 대한 링크와 함께 열거한 HTML 파일 반환
파일 열거는 편리하지만, 일반적으로 발견할 수 없는 파일도 드러나게 된다는 단점 있음
동적 콘텐츠 리소스 매핑
웹 서버는 URI를 동적 리소스에 매핑할 수도 있음
(= 요청에 맞게 콘텐츠를 생성하는 프로그램에 URI를 매핑하는 것)
웹 서버들 중 애플리케이션 서버라고 불리는 것은 웹 서버를 복잡한 백엔드 애플리케이션과 연결하는 일을 함
- 어떤 리소스가 동적 리소스라면, 애플리케이션 서버는 그에 대한 동적 콘텐츠 생성 프로그램이 어디에 있는지, 어떻게 그 프로그램을 실행하는지 알려줄 수 있어야 함
- 대부분의 웹 서버는 동적 리소스를 식별하고 매핑할 수 있는 기본적인 매커니즘을 가지고 있음
아파치는 URI의 경로명이 실행 가능한 프로그램이 위치한 디렉터리로 매핑되도록 설정하는 기능 제공
서버가 실행 가능한 경로명을 포함한 URI로 요청 받으면, 그 경로에 대응하는 디렉터리에서 프로그램을 찾아 실행하려고 시도
# 해당 아파치 설정 지시자는
# URI 경로가 /cgi-bin/로 시작한다면
# /usr/local/etc/httpd/cgi-programs/에서 프로그램을 찾아 실행하라는 의미

ScriptAlias /cgi-bin/ /usr/local/etc/httpd/cgi-programs/
아파치에서는 특정 확장자의 파일만 실행하도록 설정할 수도 있음
# 해당 아파치 설정 지시자는
# .cgi로 끝나는 모든 웹 리소스는 실행되어야 함을 명시

AddHandler cgi-script .cgi
서버사이드 인클루드(Server-Side Includes, SSI)
어떤 리소스가 서버사이드 인클루드를 포함하고 있는 것으로 설정되어 있다면,
서버는 그 리소스의 콘텐츠를 클라이언트에게 보내기 전에 처리
서버는 콘텐츠에 변수 이름이나 내장된 스크립트가 될 수 있는 어떤 특별한 패턴이 있는지 검사 받음
특별한 패턴은 변수 값이나 실행 가능한 스크립트의 출력 값으로 치환 => 동적 콘텐츠를 만드는 쉬운 방법
접근 제어
웹 서버는 각각의 리소스에 접근 제어 할당할 수 있음
접근 제어되는 리소스에 대한 요청이 도착했을 때, 웹 서버는 클라이언트의 IP 주소에 근거해 접근을 제어할 수 있고, 리소스에 접근하기 위한 비밀번호를 물어볼 수 있음
단계 5: 응답 만들기
한 번 서버가 리소스를 식별하면
서버는 요청 메서드로 서술되는 동작을 수행한 뒤, 응답 메시지 반환
응답 메시지는 응답 상태 코드, 응답 헤더, 응답 본문(생성 시)을 포함
응답 엔터티
트랜잭션이 응답 본문을 생성한다면 그 내용을 응답 메시지와 함께 돌려 보냄
만약 본문이 있다면 응답 메시지는 다음을 포함
- 응답 본문의 MIME 타입을 서술하는
Content-Type 헤더 - 응답 본문의 길이를 서술하는
Content-Length 헤더 - 실제 응답 본문의 내용
MIME 타입 결정하기
웹 서버에게는 응답 본문의 MIME 타입을 결정해야 하는 책임 있음
MIME 타입과 리소스를 연결하는 여러가지 방법
mime.types
웹 서버는 MIME 타입을 나타내기 위해 파일 이름의 확장자를 사용할 수 있음
웹 서버는 각 리소스의 MIME 타입을 계산하기 위해 확장자별 MIME 타입이 담겨 있는 파일을 탐색
확장자 기반 타입 연계가 가장 흔한 방법
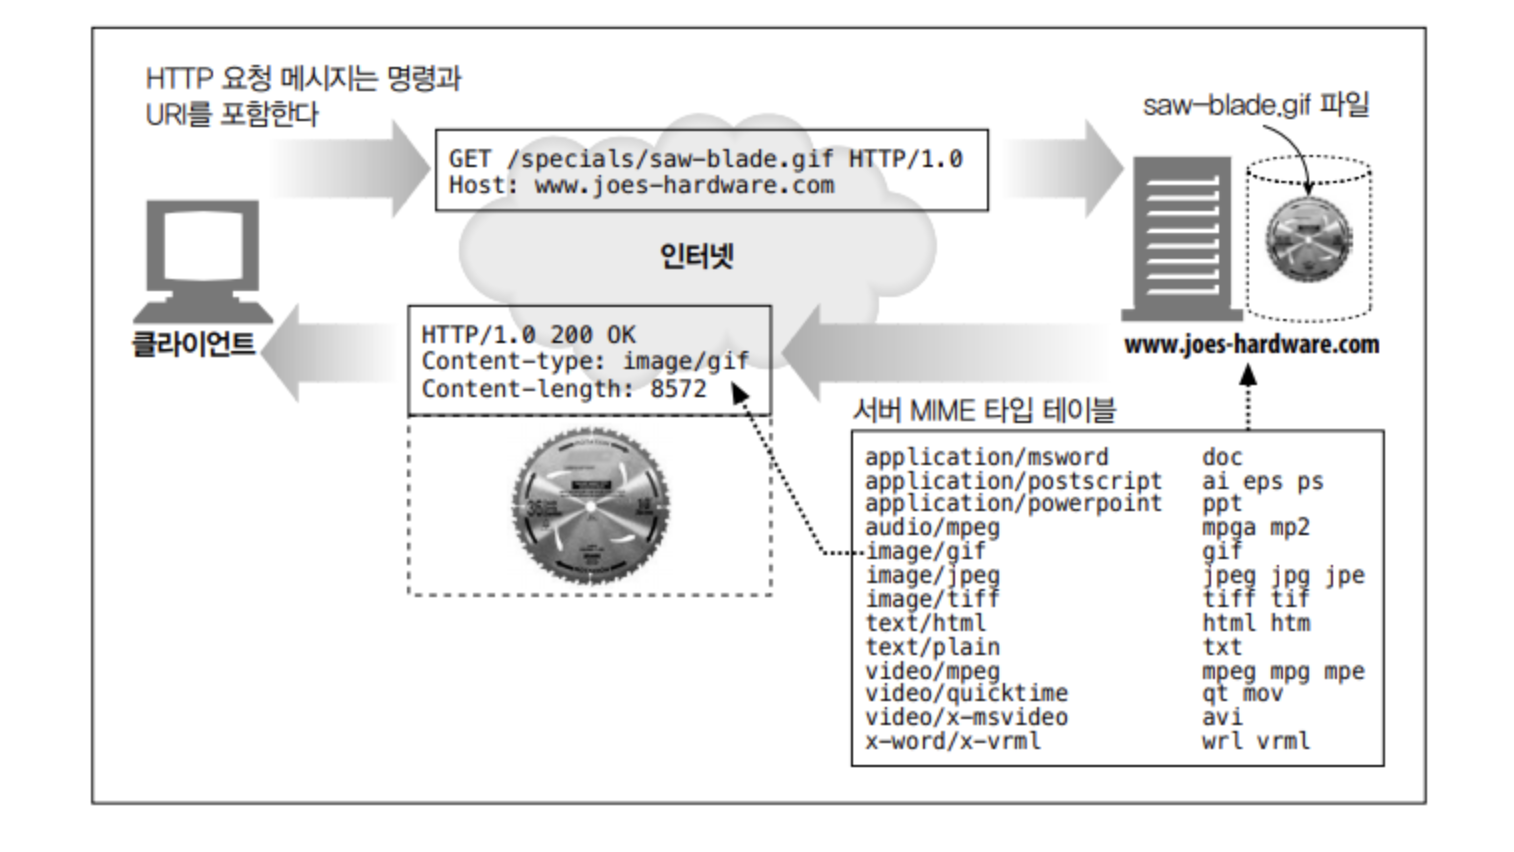
Magic typing
아파치 웹 서버는 각 파일의 MIME 타입을 알아내기 위해 파일의 내용을 검사해서 알려진 패턴에 대한 테이블(매직 파일)에 해당하는 패턴이 있는지 찾아볼 수 있음
느리긴 하지만 파일이 표준 확장자 없이 이름 지어진 경우 편리유형 명시(Explicit typing)
특정 파일이나 디렉터리 안의 파일들이 파일 확장자나 내용에 상관없이 어떤 MIME 타입을 갖도록 웹 서버 설정 가능유형 협상(Type negotiation)
웹 서버는 한 리소스가 여러 종류의 문서 형식에 속하도록 설정할 수 있음
사용자와의 협상 과정을 통해 사용하기 가장 좋은 형식을 판별할 것인지의 여부도 설정할 수 있음
특정 파일이 특정 MIME 타입을 갖게끔 설정할 수 있음
리다이렉션
- 웹 서버는 종종 성공 메시지 대신 리다이렉션 응답 반환
- 웹 서버는 요청을 수행하기 위해 브라우저가 다른 곳으로 가도록 리다이렉트 할 수 있음
- 리다이렉션 응답은 3XX 상태 코드로 지칭
- Location 응답 헤더는 콘텐츠의 새로운 혹은 선호하는 위치에 대한 URI 포함
리다이렉션은 다음의 경우에 유용