책) 혼자 공부하는 머신러닝+딥러닝
책 혼자 공부하는 머신러닝+딥러닝 정리
머신러닝
데이터에서 규칙을 학습하는 알고리즘을 연구
0) 데이터 전처리
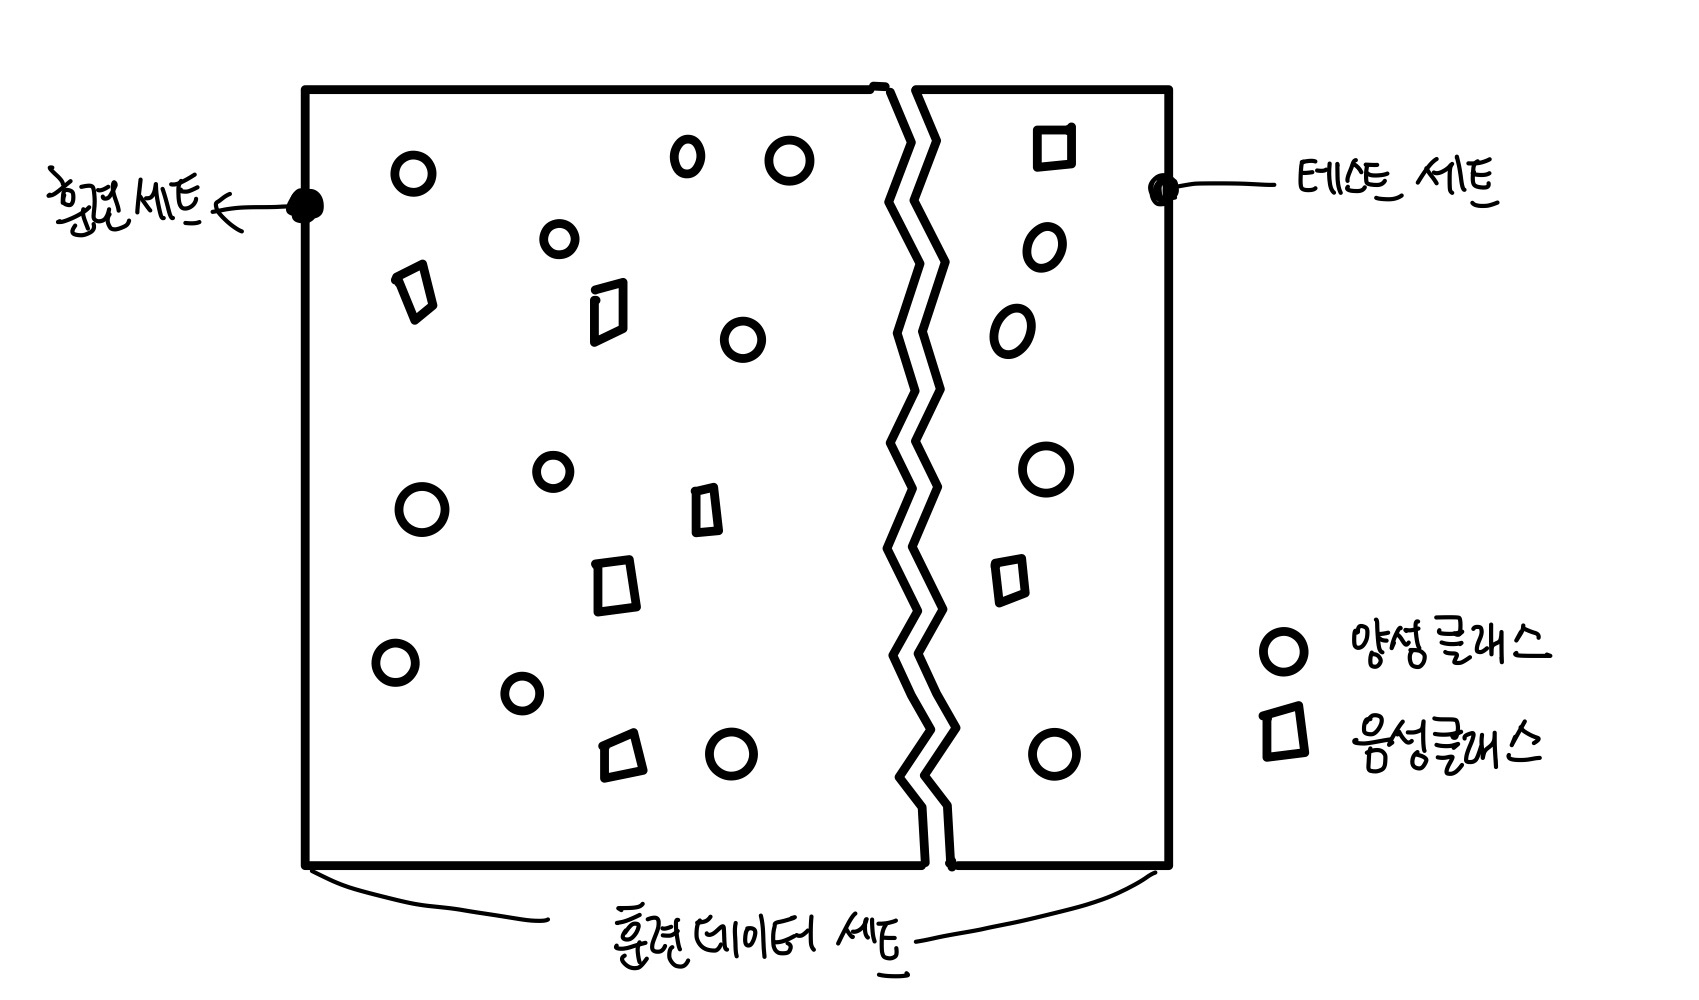
훈련 세트와 테스트 세트
- 머신러닝 모델 성능을 제대로 평가하려면 훈련 데이터와 평가 데이터가 각각 달라야 함
from sklearn.model_selection import train_test_split

train_input, test_input, train_target, test_target = train_test_split(
    fish_data, fish_target, random_state=42)
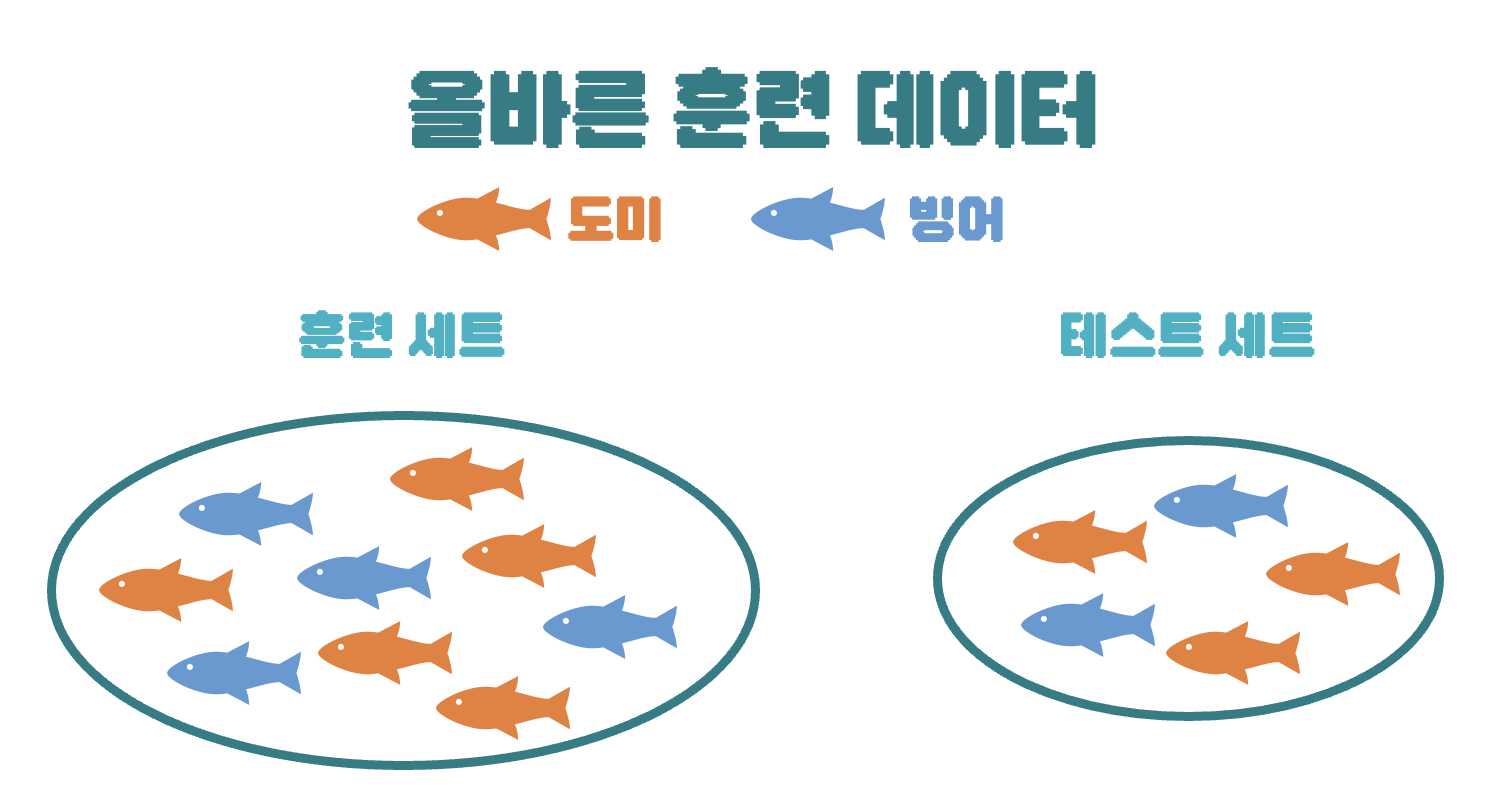
샘플링 편향
- 훈련 데이터와 평가 데이터는 샘플이 골고루 섞여있어야함
from sklearn.model_selection import train_test_split

train_input, test_input, train_target, test_target = train_test_split(
    fish_data, fish_target, stratify=fish_target, random_state=42) # stratify 매개변수는 데이터 클래스 비율에 맞게 데이터를 나눠줌
스케일링
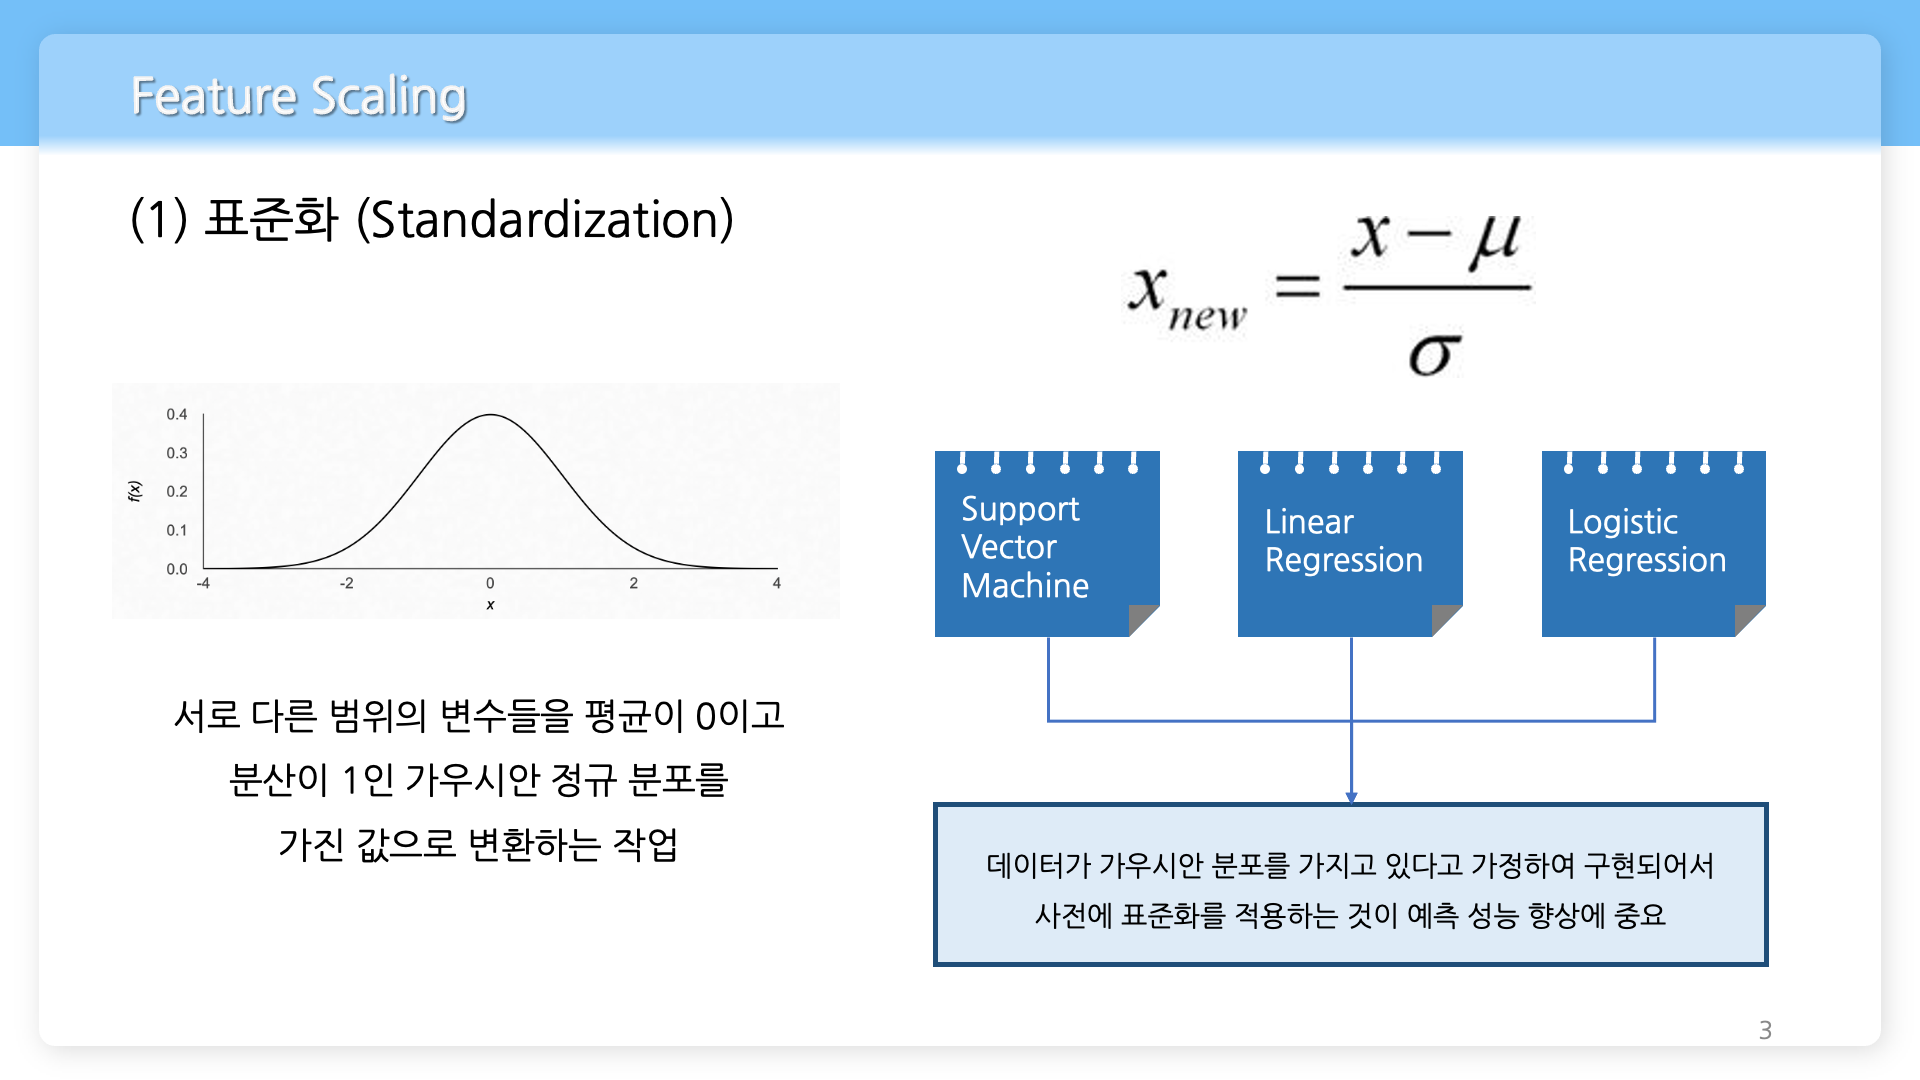
- 각 특성값들을 일정한 기준으로 맞춰주어야 모델이 올바르게 예측 가능
from sklearn.preprocessing import StandardScaler

""" 특성의 스케일 정규화 """
ss = StandardScaler()
ss.fit(train_poly)

train_scaled = ss.transform(train_poly)
test_scaled = ss.transform(test_poly)
1) 지도학습 1 - 회귀 알고리즘
회귀: 두 변수 사이의 상관관계를 분석하는 방법
KNeighborsRegressor (K-최근접 회귀)
생선의 특성값을 사용해서 어떤 생선인지 예측하고 싶어요.
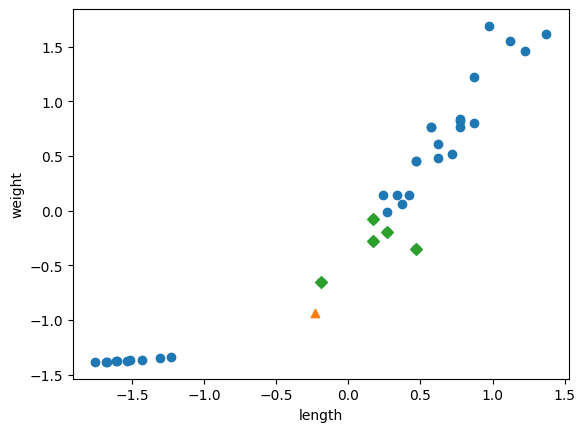
- 이웃 샘플의 타깃값의 평균을 예측함 (default n_neighbors=5)
- 테스트 샘플이 훈련 세트의 범위를 벗어나면 정확한 값 예측이 불가능함
from sklearn.neighbors import KNeighborsRegressor

""" k-최근접 이웃 회귀 모델 훈련 """
knr = KNeighborsRegressor()
knr.fit(train_input, train_target)

knr.score(test_input, test_target) # 0.992809406101064
과대적합과 과소적합
- 과대적합
- 훈련 데이터 세트의 학습 점수 >>> 테스트 데이터 세트의 학습 점수
- 훈련 데이터에만 예측을 잘하는 모델
- 과소적합
- 훈련 데이터 세트의 학습 점수 <<< 테스트 데이터 세트의 학습 점수
- 훈련이 잘 되지 못한 모델
LinearRegression (선형 회귀)
생선의 특성값을 사용하여 무게를 예측하고 싶어요.
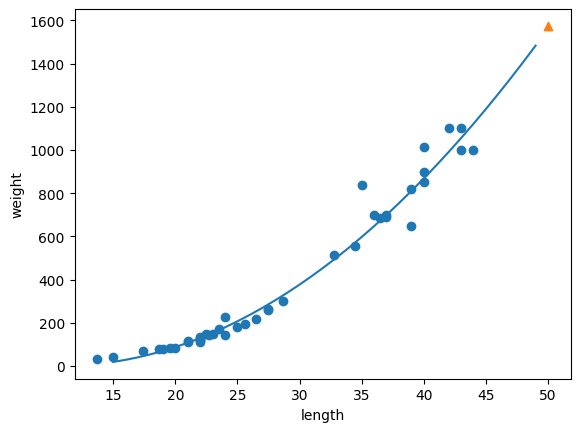
- 훈련 데이터 세트에 잘 맞는 직선의 방정식을 찾음 (기울기와 절편)
- 다항 회귀를 통해 더욱 알맞는 고차항 방정식을 찾을 수 있음
- 모델 성능을 높이기 위해 더욱 복잡한 모델이 필요
from sklearn.linear_model import LinearRegression

""" 다항회귀 """
lr = LinearRegression()

train_poly = np.column_stack((train_input ** 2, train_input))
test_poly = np.column_stack((test_input ** 2, test_input))

lr.fit(train_poly, train_target)

print(lr.predict([[50**2, 50]]))
특성 공학과 규제
- 특성 공학(Feature Engineering)은 기존 특성을 이용해 새로운 특성을 만드는 작업
- 그러나 특성이 늘어나면 훈련 데이터 세트에 과대적합됨
- 규제는 모델의 과대적합을 억제하는 작업 (릿지, 라쏘 회귀)
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures

""" 변환기를 통한 특성 공학 """
poly = PolynomialFeatures(degree=5, include_bias=False) # 5제곱까지 특성을 만듬

poly.fit(train_input)
train_poly = poly.transform(train_input)

""" 다중 회귀 모델 학습 """
lr = LinearRegression()
lr.fit(train_poly, train_target)

print(lr.score(train_poly, train_target)) # 0.9999999999996433
print(lr.score(train_poly, train_target)) # -144.40579436844948, 과대적합
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import Ridge, Lasso
from sklearn.linear_model import Ridge
""" 특성의 스케일 정규화 """
ss = StandardScaler()
ss.fit(train_poly)
train_scaled = ss.transform(train_poly)
test_scaled = ss.transform(test_poly)
""" 릿지 회귀 """
ridge = Ridge()
ridge.fit(train_scaled, train_target)
print(ridge.score(train_scaled, train_target)) # 0.9896101671037343
print(ridge.score(test_scaled, test_target)) # 0.9790693977615387
""" 라쏘 회귀 """
lasso = Lasso()
lasso.fit(train_scaled, train_target)
print(lasso.score(train_scaled, train_target)) # 0.989789897208096
print(lasso.score(test_scaled, test_target)) # 0.98005936984218832) 지도학습 2 - 분류 알고리즘
LogisticRegression
럭키백에 담긴 생선이 어떤 생선인지 확률을 예측해주세요.
- 선형 회귀와 동일하게 선형 방정식을 학습
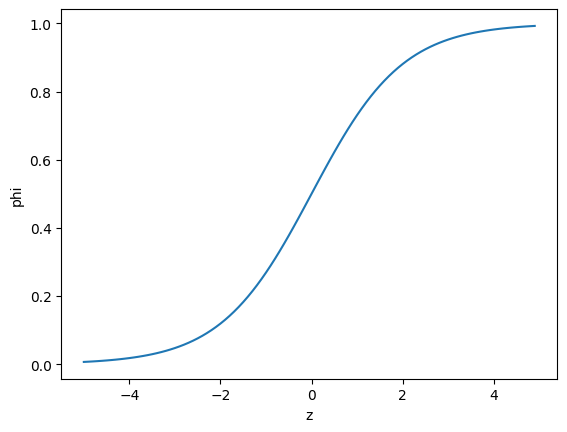
- 선형 방정식을 시그모이드 함수에 통과시켜 0~1 값의 예측 값을 리턴하여 확률 확인
from sklearn.linear_model import LogisticRegression

lr = LogisticRegression(C=20, max_iter=1000)
lr.fit(train_scaled, train_target)

print(lr.score(train_scaled, train_target))
print(lr.score(test_scaled, test_target))

print(lr.predict(test_scaled[:5]))

proba = lr.predict_proba(test_scaled[:5])
print(np.round(proba, decimals=3))
확률적 경사 하강법 (SDGClassifier)
실시간으로 수집되는 생선 데이터를 학습하고 싶어요.
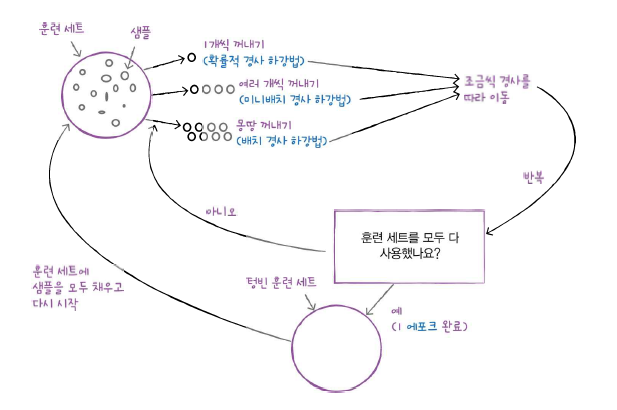
- 새로운 데이터에 대해 조금씩 더 훈련하는 점진적 학습 알고리즘
- 전체 훈련 데이터 세트에서 랜덤하게 샘플을 하나 꺼네어 학습시킴
- 샘플을 하나 사용하는 과정을 에포크(epoch)라고 표현
from sklearn.linear_model import SGDClassifier

sc = SGDClassifier(loss='log_loss', max_iter=10, random_state=42)
sc.fit(train_scaled, train_target)

print(sc.score(train_scaled, train_target))
print(sc.score(test_scaled, test_target))

sc.partial_fit(train_scaled, train_target) # epoch 한번 더 수행

print(sc.score(train_scaled, train_target))
print(sc.score(test_scaled, test_target))
3) 지도학습 3 - 트리 알고리즘
DecisionTreeClassifier
이해하기 쉬운 높은 결정 트리를 사용해 레드, 화이트 와인을 분류
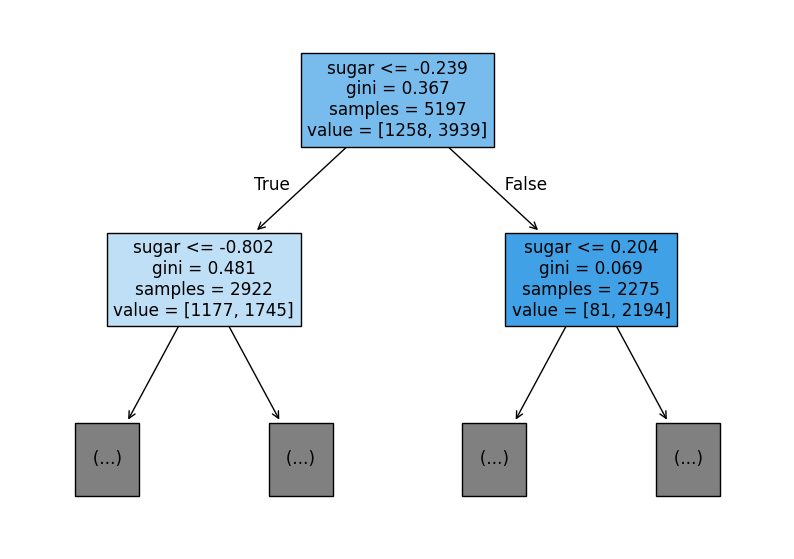
from sklearn.tree import DecisionTreeClassifier

dt = DecisionTreeClassifier(random_state=42)
dt.fit(train_scaled, train_target)

print(dt.score(train_scaled, train_target))
print(dt.score(test_scaled, test_target))
교차 검증과 그리드 서치
- 교차 검증은 검증 세트를 떼어 내어 평가하는 과정을 여러번 반복
- 그리드 서치는 하이퍼파라미터 최적의 값을 찾는 방법
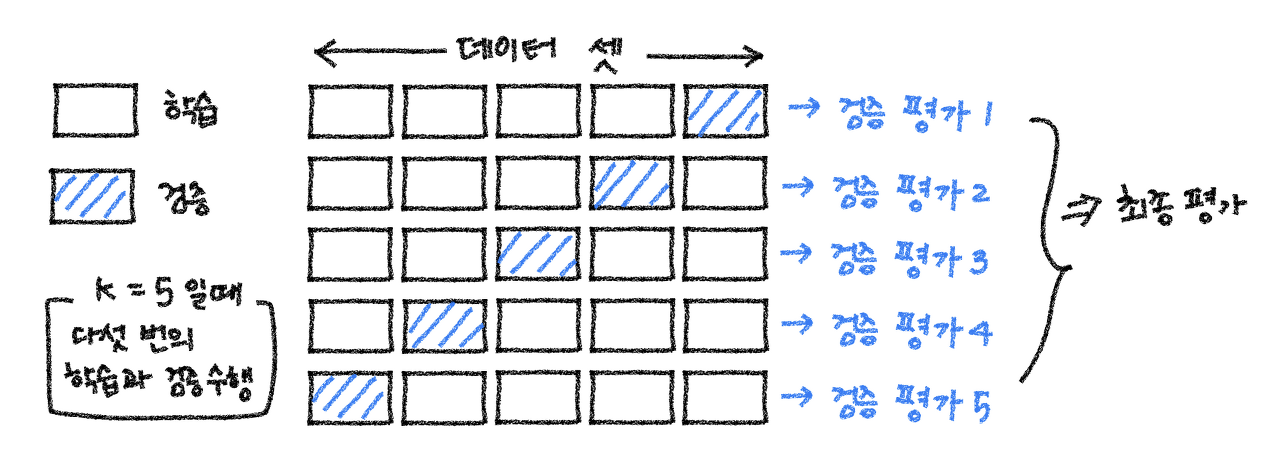
from sklearn.model_selection import cross_validate

splitter = StratifiedKFold(n_splits=10, shuffle=True, random_state=42) # 훈련 세트를 섞는 분할기 지정
scores = cross_validate(dt, train_input, train_target, cv=splitter)
print(np.mean(scores['test_score']))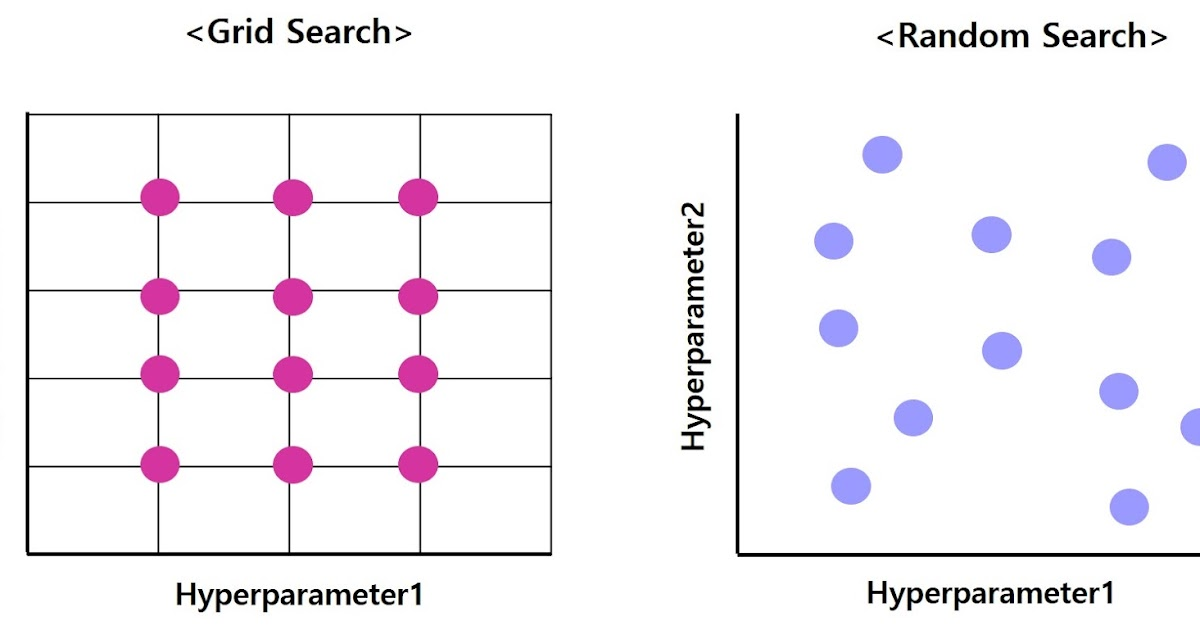
params = {'min_impurity_decrease': np.arange(0.0001, 0.001, 0.0001),
          'max_depth': range(5, 20, 1),
          'min_samples_split': range(2, 100, 10)
          }

          gs = GridSearchCV(DecisionTreeClassifier(random_state=42), params, n_jobs=-1)
gs.fit(train_input, train_target)

print(gs.best_params_)
4) 지도학습 4 - 앙상블 알고리즘
일반적으로 성능이 높은 모델을 사용하고 싶어요.
- 정형 데이터를 다루는 데 가장 뛰어난 성과를 내는 알고리즘
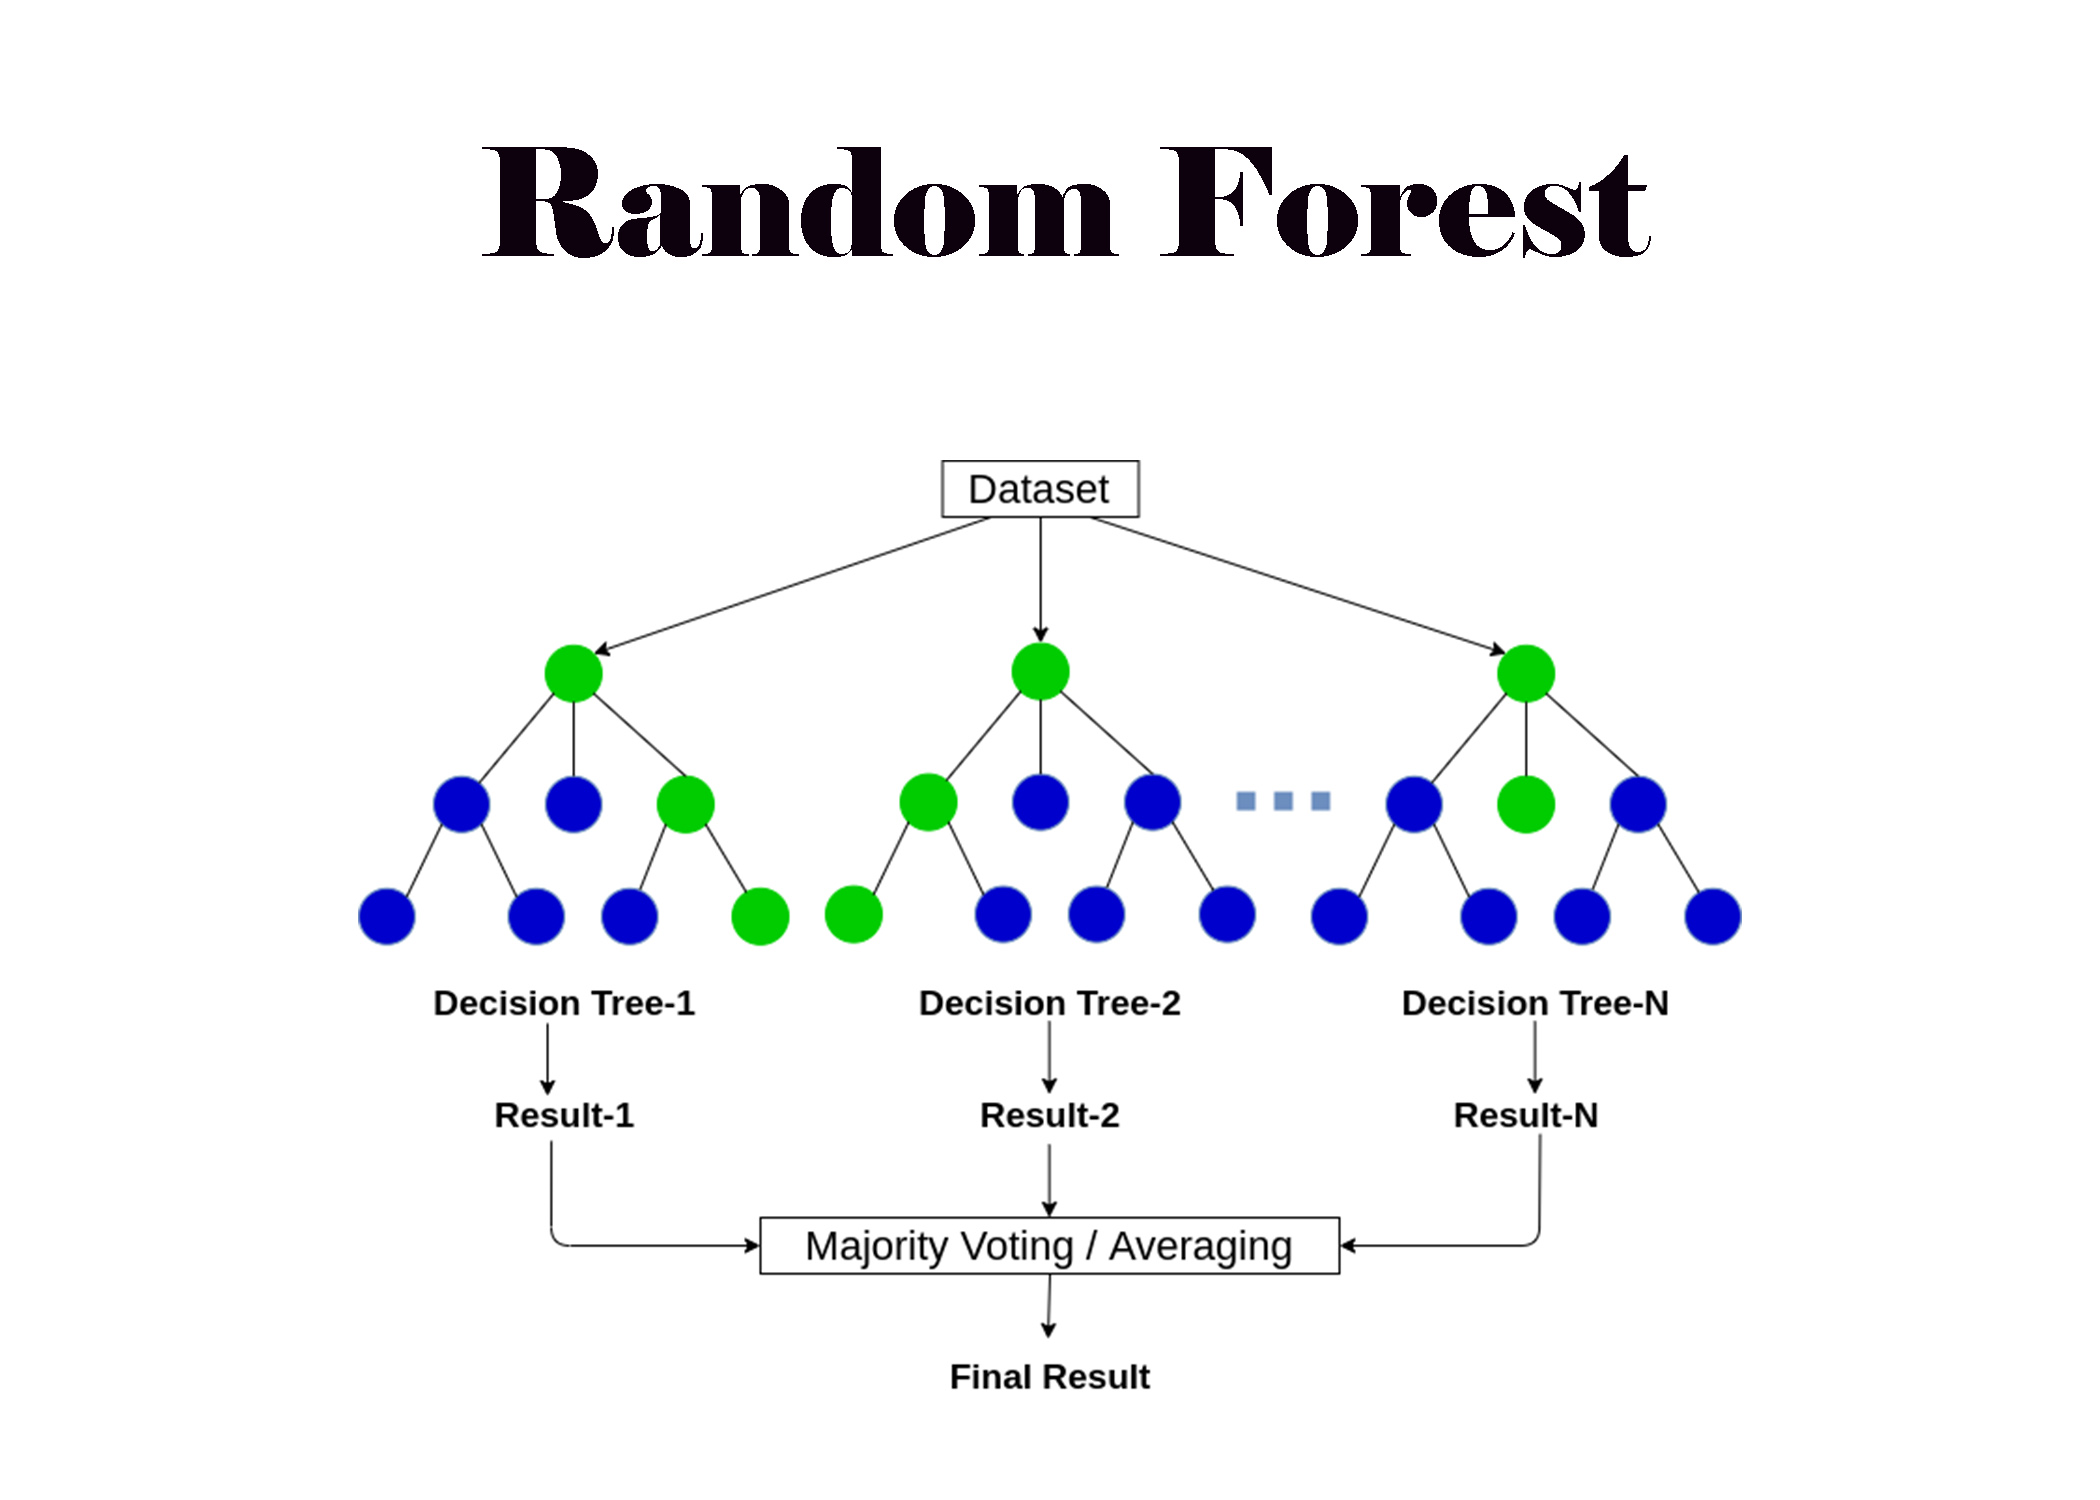
- 랜덤 포레스트는 결정 트리를 랜덤하게 만들어 각 결정 트리를 종합
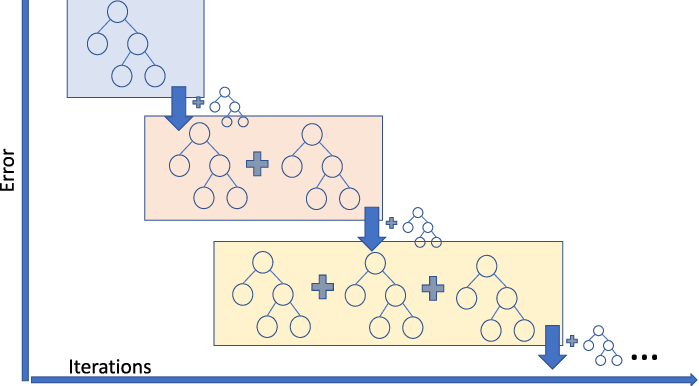
- 그레디언트부스팅은 깊이가 얕은 결정 트리를 사용하여 이전 트리의 오차를 보완
- 히스토그램 기반 그레이디언트 부스팅
5) 비지도학습
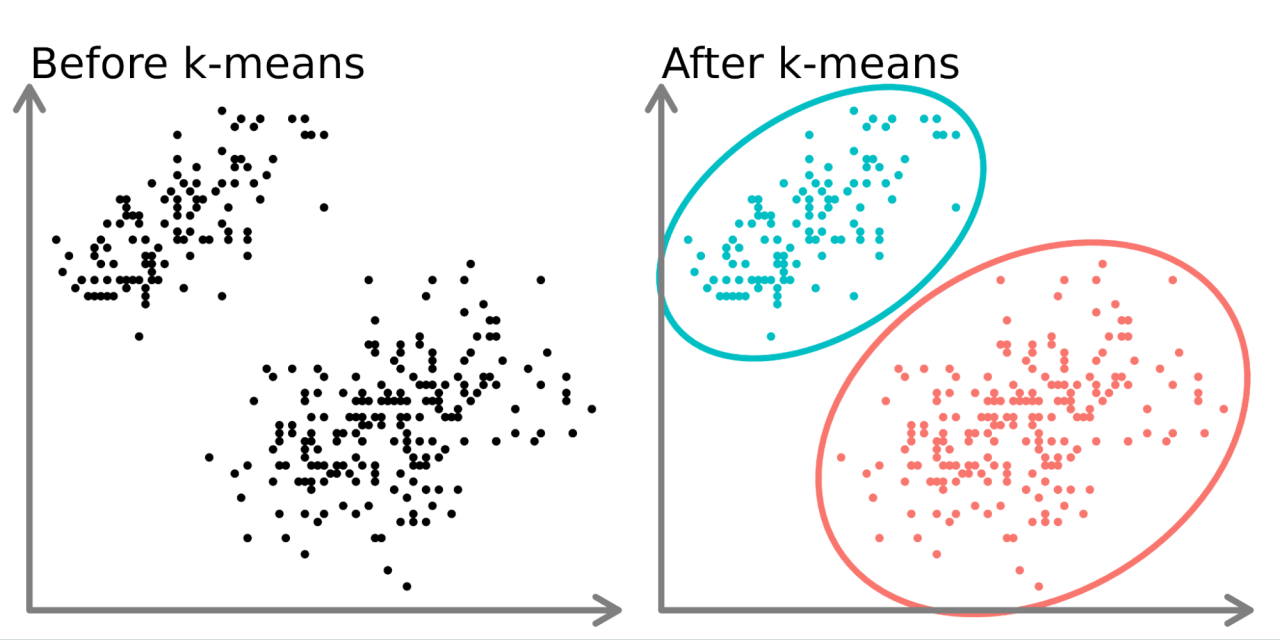
타겟값이 없는 데이터 학습
KMeans
PCA
딥러닝
T.B.D
Hello