입사 첫날부터 갑자기 모 기업에서 진행하는 협력사 대상 교육에 다녀오라 해서... 어리둥절하게 다녀왔다.
RAG와 LLM을 활용하는 교육이었고, 해당 기업의 솔루션 노하우에 대해 일부 들을 수 있어 어리둥절하긴 했어도 좋은 시간이었다.
고객사에 RAG 시스템을 구축할 때 가장 어려운 점들 중 하나는 문서들을 파싱(Parsing)하는 것이라고 한다.
졸업논문 쓸 당시에 RAG를 사용하긴 했었지만, 대부분 크롤링된 텍스트 데이터를 사용하였기에 파싱에 대해서는 깊게 생각해본 적이 없었다. 필요하더라도, 요즘 OCR 잘 되어있으니 괜찮지 않나? 라고 막연하게 생각했었다.
그러나 중요한 정보는 파싱과 임베딩이 어렵다는 맹점이 있었다.
무슨 말이냐 하면, 보통 중요하게 여겨지는 정보들은 표, 차트 등으로 시각화가 되어 있으며, 이를 사람은 잘 알아보더라도 AI는 잘 못 알아본다는 것이다.
예전에 뭣도 모르고 업스테이지 웨비나? 이런 걸 갔던 적이 있는데, 설명해주시는 분이 계약서나, 특정 산업에서 쓰이는 문서(B/L 같은거..) 등의 문자를 추출하는 모델에 대해 열심히 설명해주셨던 기억이 새록새록 났다.
그리고 모 기업 강사님이 어디어디 모델을 써봤다고 말하면서 업스테이지 것도 써봤다 이런 말씀을 하셨던 것으로 보아, 그만큼 성능 면에서 유명한 것 같다.
그래서 Upstage Document Parse 모델을 직접 사용해 보았다.
Document Parse 모델에 대한 자세한 설명은 업스테이지 강의를 통해 볼 수 있다.
업스테이지 강의-(NGO/NPO Use Case) 아동 상담 기록 유형 분석 및 메일 자동화
해당 강의에서는 업스테이지 API에 대한 설명부터, Document 관련 제품 및 업스테이지의 LLM 모델인 Solar Chat을 활용하여 "아동 상담 기록 유형 분석 및 메일 자동화 시스템"을 어떻게 구축할 것인지에 대한 파이프라인 설명이 모두 포함되어 있다.
본 글에서는 PDF 형식만 사용해 보았지만, JPEG, PNG, BMP, TIFF, HEIC, DOCX, PPTX, XLSX와 같이 많은 형식에서도 사용이 가능하다.
위에서 언급한 바와 같이, 업스테이지 강의에서도 Document Data 처리의 어려움에 대해 설명하고 있다.
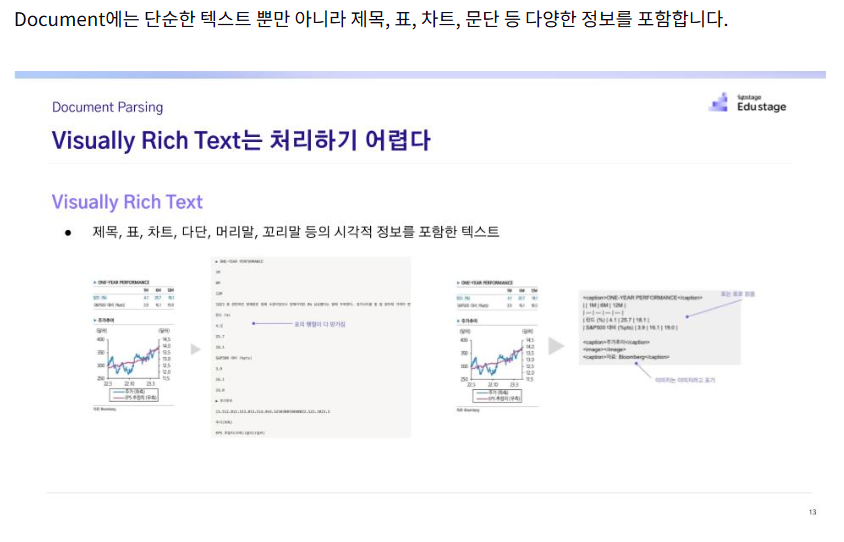
단순 Document OCR로 읽는다면 표의 형식, 이미지 내용을 가지고 올 수 없지만, Document Parse 모델은 HTML 태그와 함께 output으로 가지고 오기 때문에 테이블 형식은 테이블 그대로, 이미지는 이미지로 인식하여 추출할 수 있다고 한다.
그래서... 개인적으로 악랄하다고 생각되는 Input을 선정하여 실험해 보았다.
사용(희생)된 문서는 정보통신산업진흥원의 "2025년도 공공AX 프로젝트 사업 신규과제 모집 공고"로, 정말 각양각색의 Visualization을 볼 수 있었다. 그 중, 알록달록한 표와 운영시스템 Flow 그림이 동시에 들어간 한 페이지를 실험해 보았다.
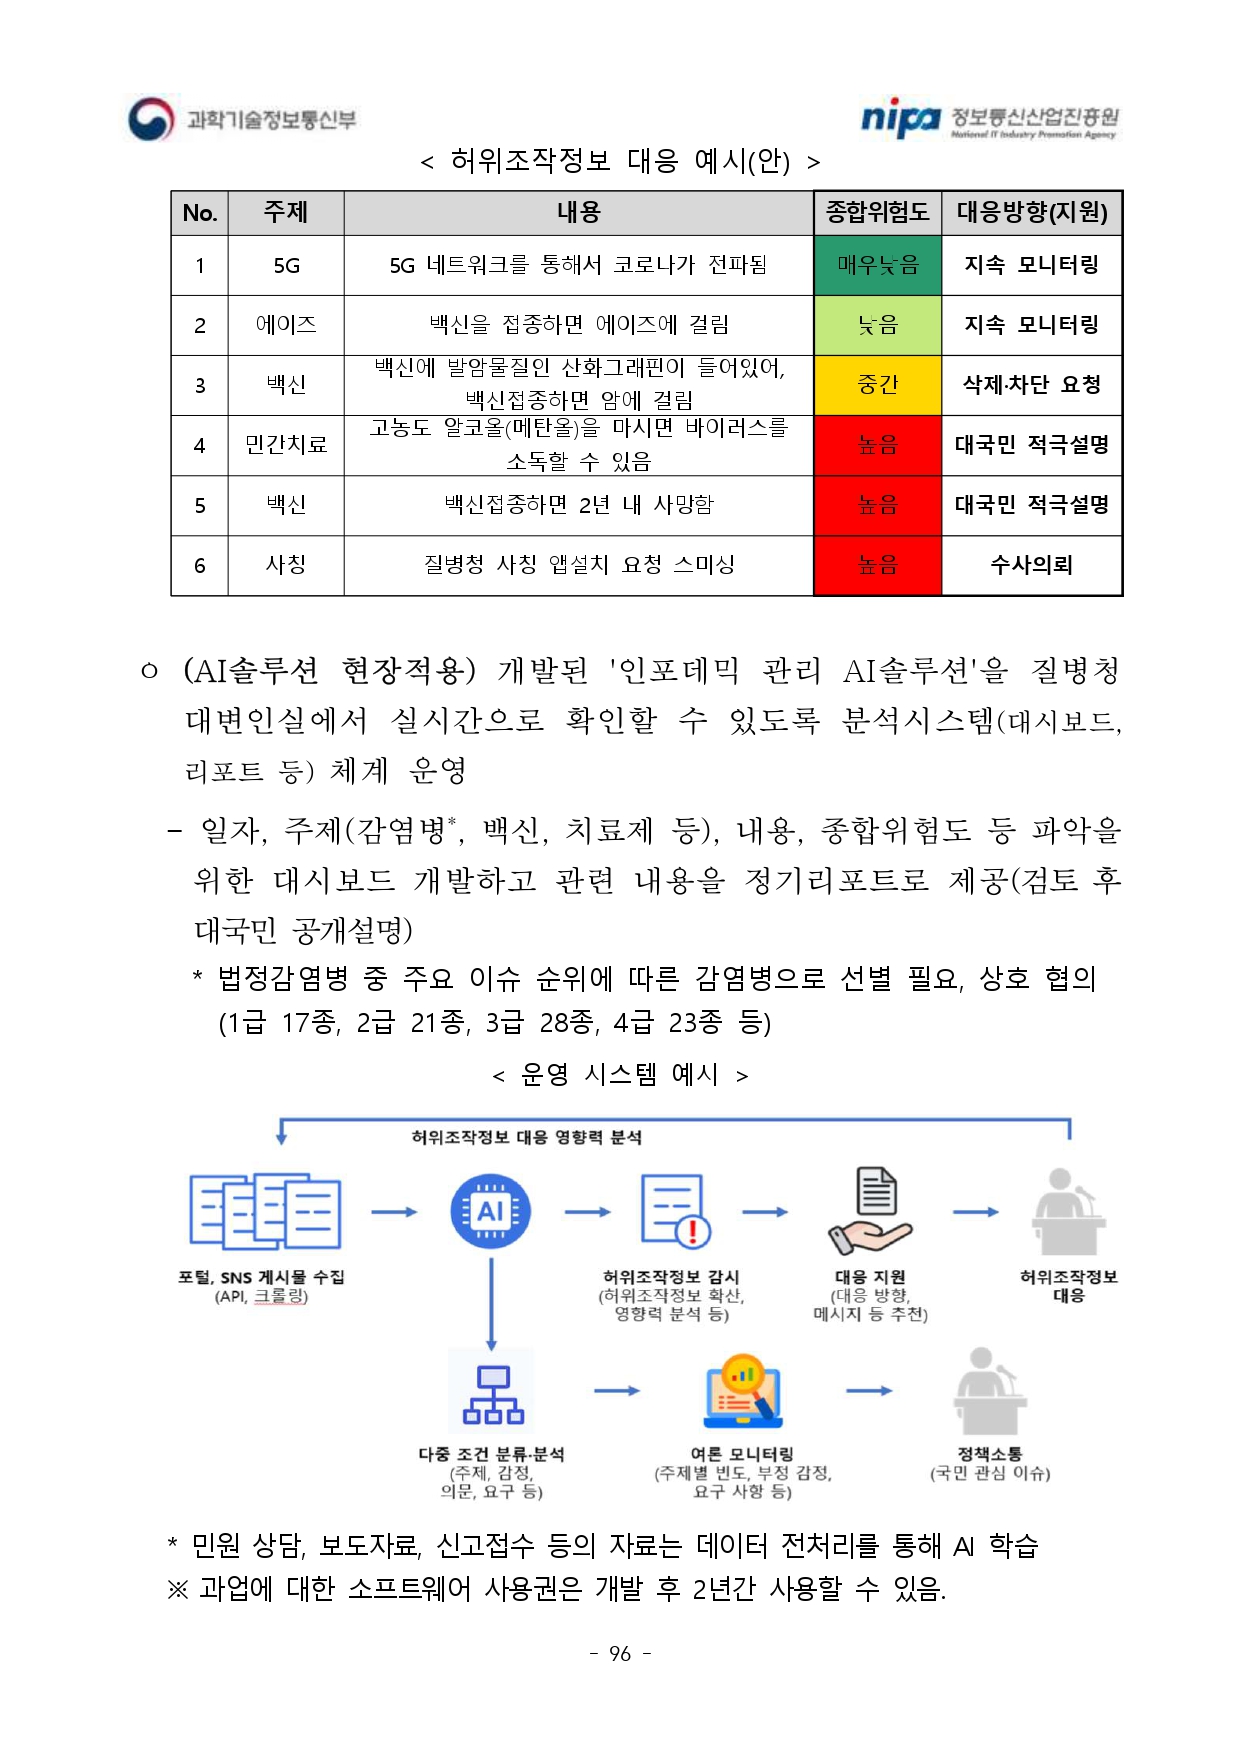
해당 문서에 대해 업스테이지 Document Parse로 파싱을 진행한 output은 아래와 같다. (HTML 잘 모름 주의)
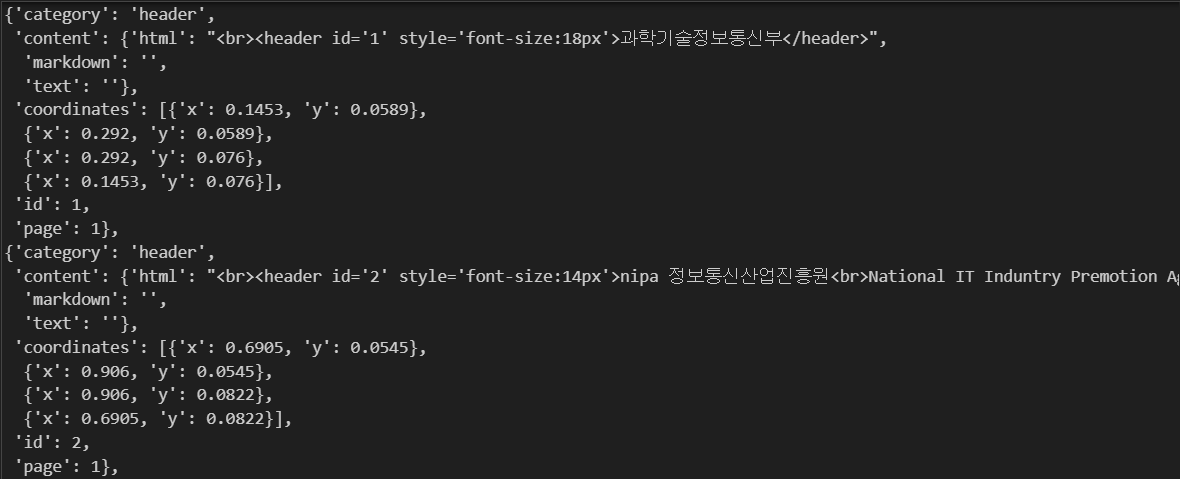 일단 머릿말 부분의, 과학기술정보통신부와 정보통신산업진흥원 로고(심지어 완전 작은 영어도)가 header1과 header2로 잘 추출된 것을 볼 수 있다.
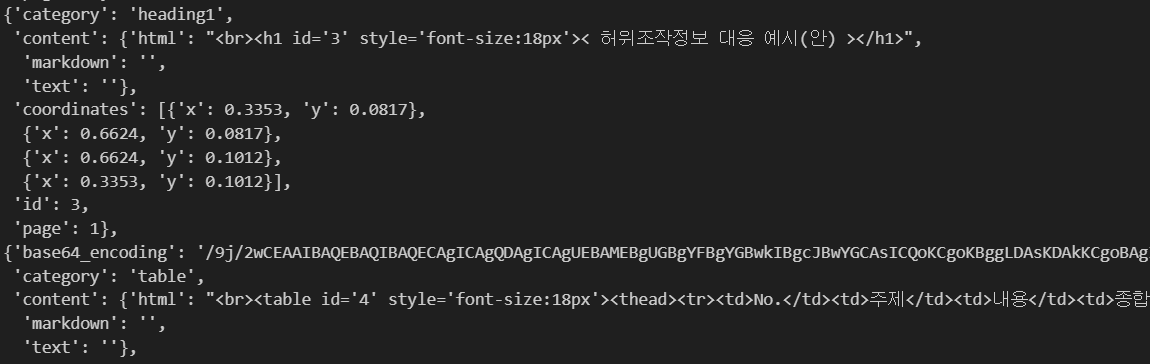 Table(표)도 제목과 함께 잘 추출되었고..
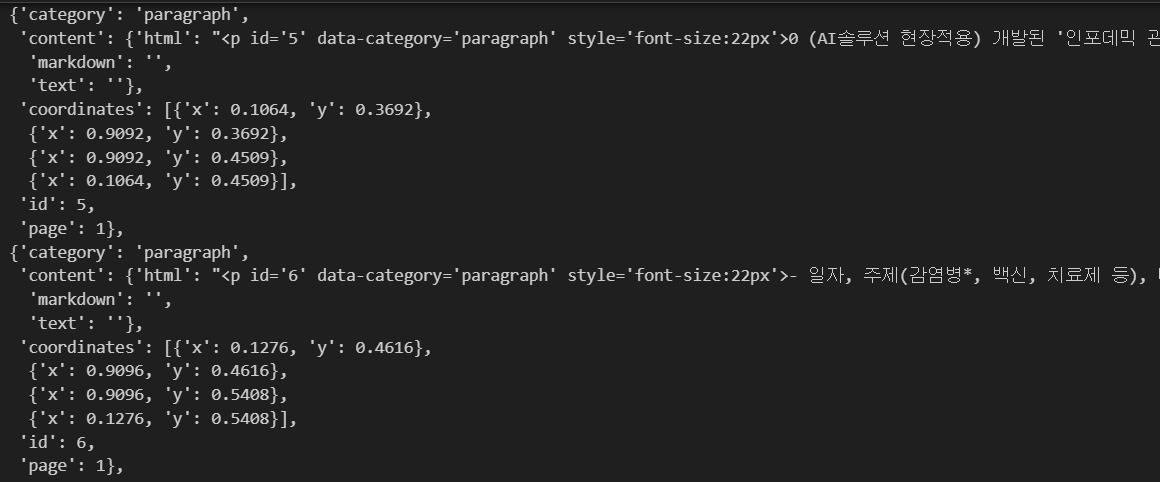 그 아래에 있는 Paragraph도 잘 추출된 것을 볼 수 있다.
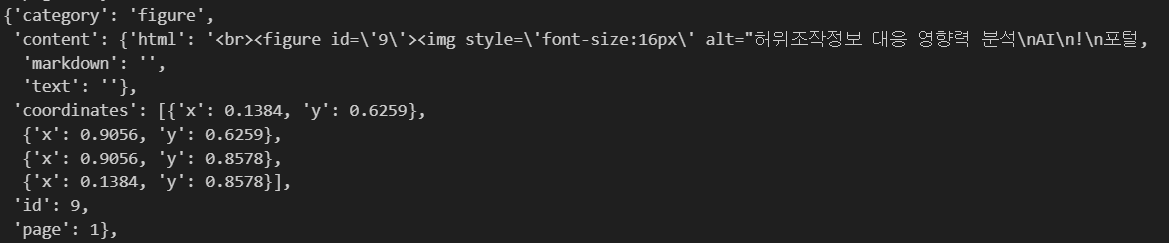 그 아래의 그림도 figure로 카테고리가 잘 추출되었다.
다만 아쉬운 점이라고 한다면, flow(화살표)에 따른 텍스트에 대해서는 해당 순서에 따른 정확한 추출이 아직은 어려워 보인다는 것이다.
아래의 그림과 추출된 텍스트를 비교해 보면 알 수 있다.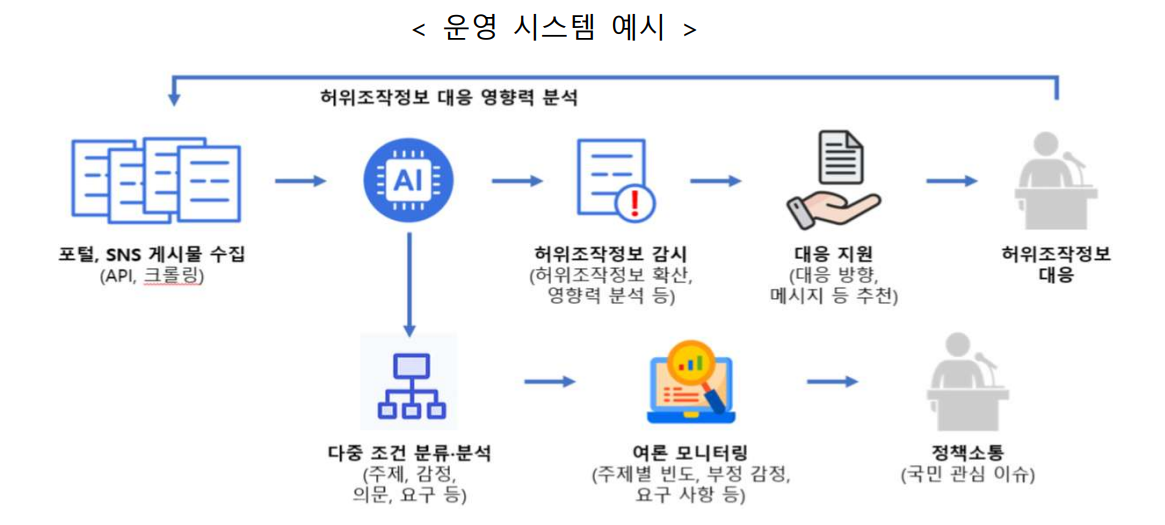
alt="허위조작정보 대응 영향력 분석\nAI\n!\n포털, SNS 게시물 수집 허위조작정보 감시 대응 지원 허위조작정보\n(API, 크롤링) (허위조작정보 확산, (대응 방향, 대응\n영향력 분석 등) 메시지 등 추천)\n다중 조건 분류·분석 여론 모니터링 정책소통\n(주제, 감정, (주제별 빈도, 부정 감정, (국민 관심 이슈)\n의문, 요구 등) 요구 사항 등)자세히 보면 추출된 텍스트는 flow 순서에 따라 추출된 것이 아닌, 단순 왼쪽에서 오른쪽 순서로 추출되었다는 것을 볼 수 있다.
다만 이를 figure로 규명 가능하다면, figure에 대해서만 전처리를 더 신경쓰면 되는 사항이니 HTML로 구분 가능한 것만으로도 대단하다고 볼 수 있다.
다음의 악랄한 Input은 바로 이것이다.
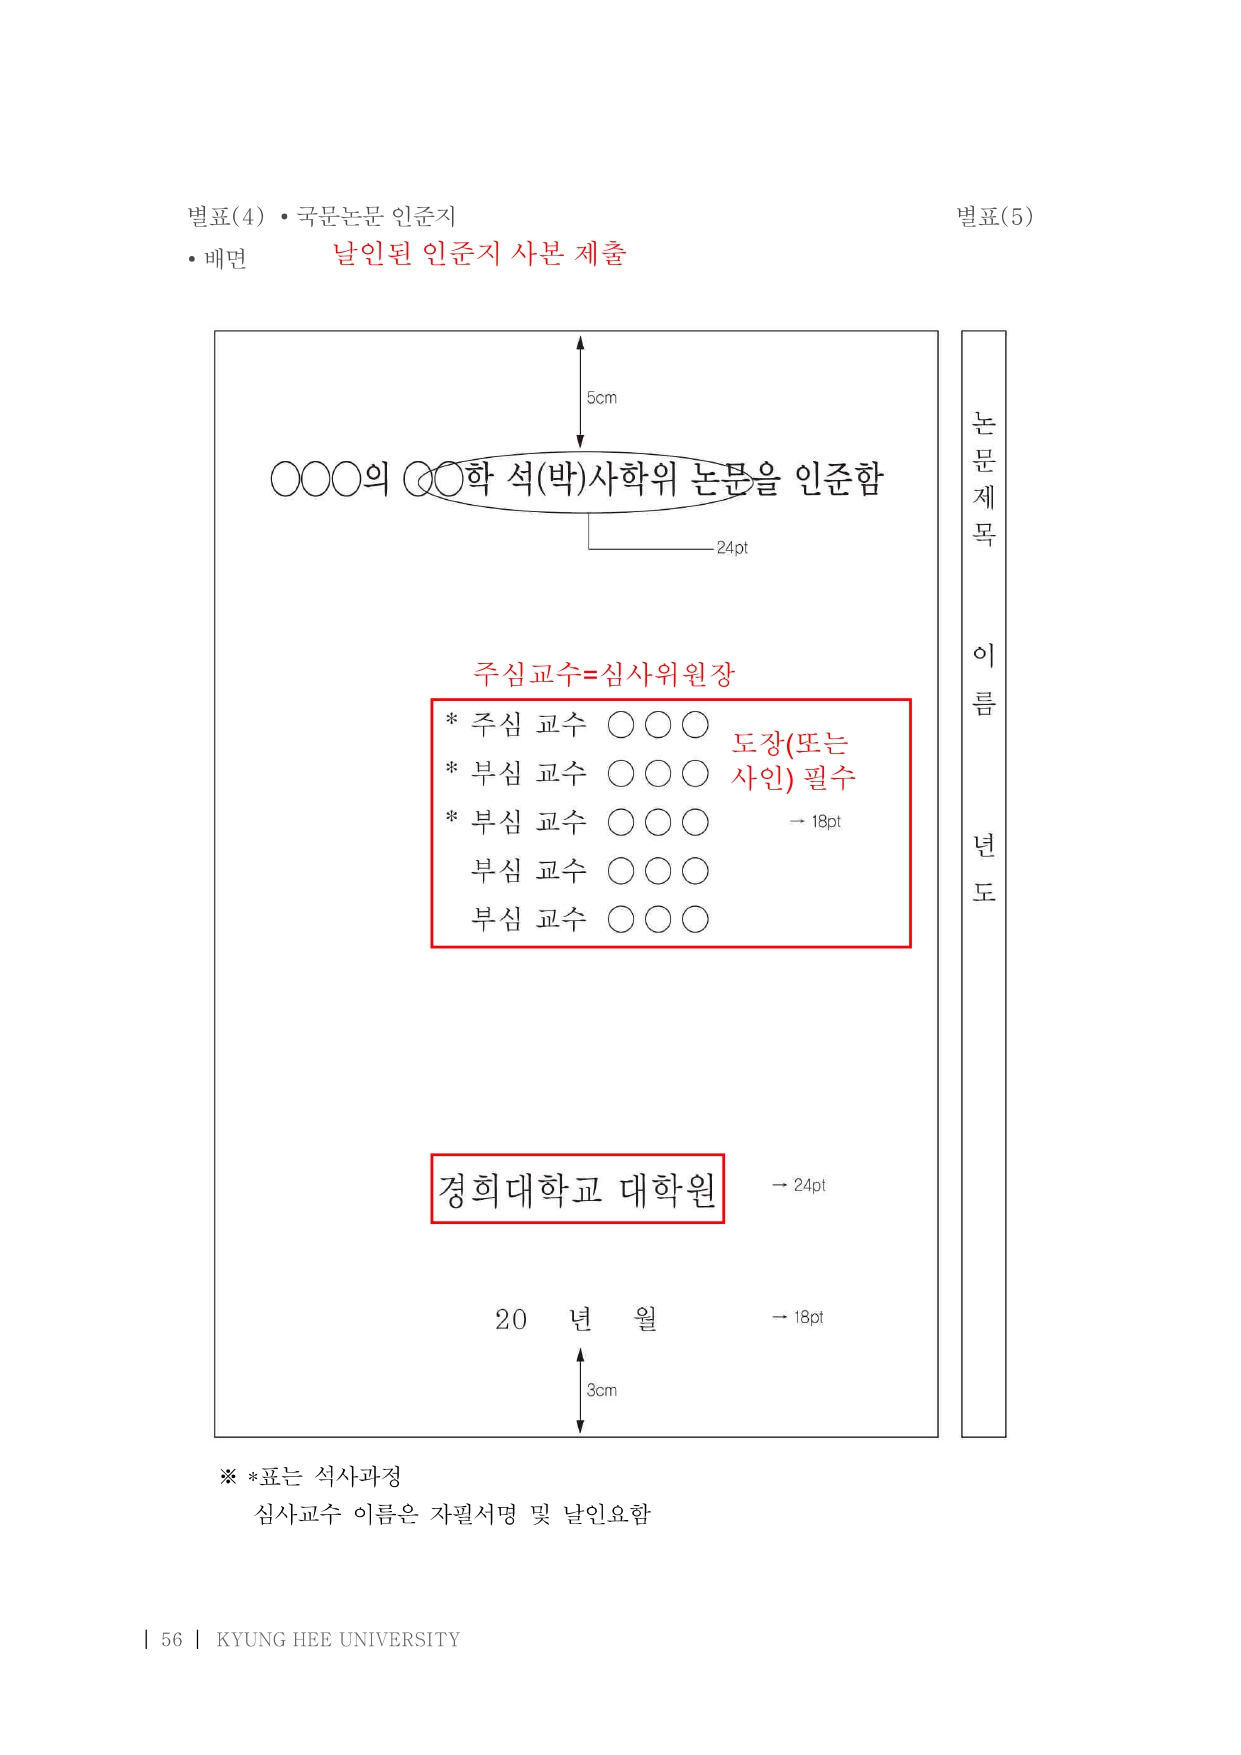
이것은 나를 너무 힘들게 했었던 졸업논문표지 양식이다...
온갖 화살표에 Figure라 해야 할지 애매한 것들에다가 세로로 써있는 글씨까지.
이것은 과연 업스테이지 Document Parse가 어떻게 Output을 줄 것인가
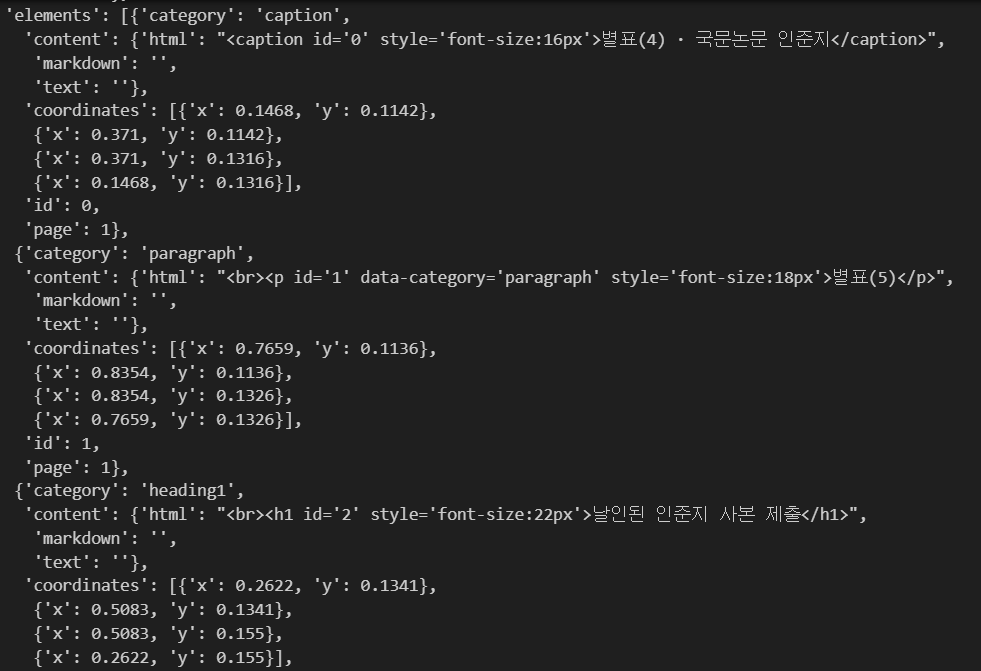
일단 위에 있는 것들은 caption이니 heading1이니 하는 것들로 추출이 잘 된 것 같은데...
'html': '<figure id=\'4\'><img style=\'font-size:20px\' alt="5cm\n논\n문\n○○○의 ○학 석(박)사학위 논문을 인준함\n제\n목\n24pt\n이\n주심교수=심사위원장\n름\n* 주심 교수 ○ ○ ○\n도장(또는\n* 부심 교수 ○ ○ ○ 사인) 필수\n* 부심 교수 ○ ○ ○ → 18pt\n년\n부심 교수 ○ ○ ○\n도\n부심 교수 ○○ ○\n경희대학교 대학원 → 24pt\n20 년 월 → 18pt\n3cm" data-coord="top-left:(207,319); bottom-right:(1007,1444)" /></figure>'그 아래는(큰 제목부터 20 년 월 까지)는 figure로 한 번에 추출된 것을 볼 수 있다. 그리고 오른쪽에 세로로 써 있는 글자는 왼쪽에서 오른쪽으로 추출되는 특성 때문에 따로 분리되지 않는다는 것도 다소 아쉬운 점.
그래도 보면 \n나 글자는 모두 잘 추출된 것으로 보인다. 동그라미, 네모 등 다양한 모양이 있으니 카테고리도 굳이 따지자면 figure가 맞는 듯.
 아래 56페이지와 경희유니버시티.는 footer로 잘 추출된 것을 볼 수 있다.
다소 애매(하고 악랄)한 문서는 맞지만, 중간에 공백이 있는 만큼 한 번에 뭉둥그려 추출되는 것이 아닌 따로따로 추출되었다면 더 좋지 않았을까 하는 생각이 든다. 그래도 생각보다 잘 해줘서 만족!
위에서 언급한 강의에서는 아동 상담 기록이나 보고서에 대한 pdf를 input으로 한다고 하였다. 아마 이러한 경우 복잡한 flow chart가 들어갈 일이 거의 없을 테니, 현재의 업스테이지 Document Parse 제품으로도 충분히 구현 가능할 것으로 보인다.
아직 완벽하진 않을지라도, HTML로 카테고리가 구분되고 상대 좌표까지 추출 가능하다는 점이 전처리를 훨씬 편하게 할 수 있을 것 같다.
업스테이지 콘솔: console.upstage.ai
공식 홈페이지: upstage.ai