목차
- 기본형
- 참조형
1. 기본형
1)정수형
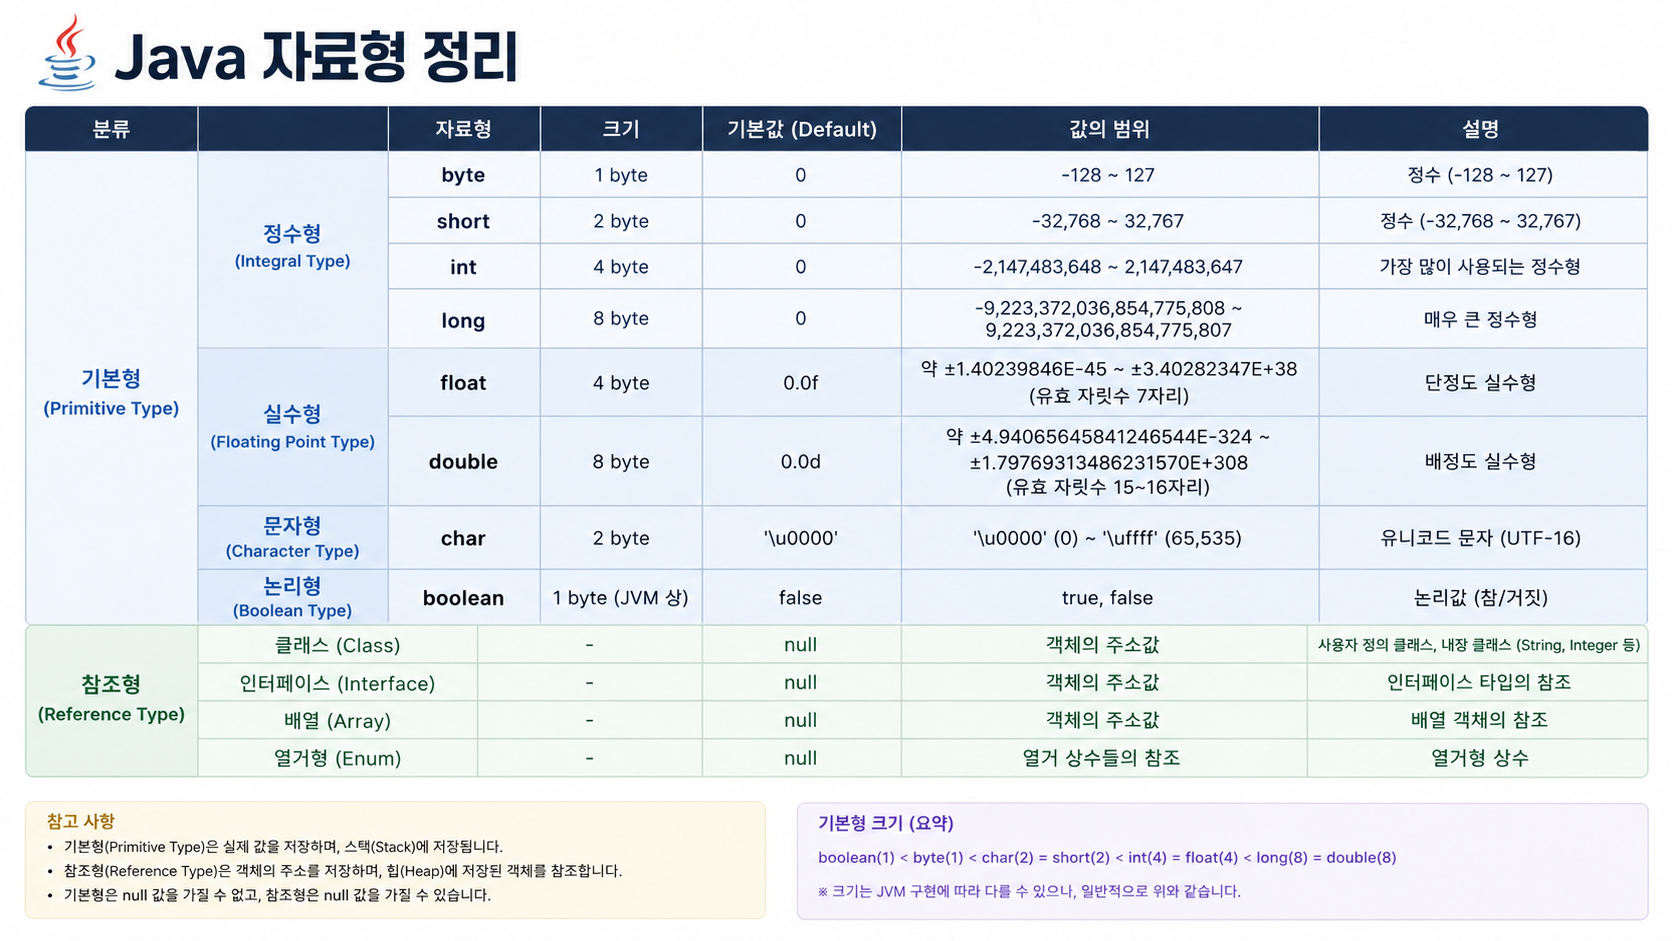
정수형태의 자료형에는 byte, short, int, long이 있다.
뒤로 갈수록 값의 범위와 메모리 크기가 증가한다.
그렇다면 왜 사람들은 long대신 int를 많이 사용할까?
그 이유는 크기가 커질수록 메모리 사용량이 증가하기 때문이다.
간단히 계산해보면 int는 4byte, long은 8byte로 2배의 메모리를 사용하는것을 알 수 있다.
2)실수형
실수형 자료형에는 float와 double이 있다.
정수형과 마찬가지로** double은 float의 2배의 메모리를 사용한다.
float는 약 7자리, double은 약 15~16자리까지 정확하게 표현할 수 있다.
하지만, 컴퓨터에서는 소수를 정확히 표현하는게 불가능하여 값의 손실이 발생하게 된다.
이 때문에, 메모리 크기가 작고 정밀한 계산을 요구하지 않는 작업을 할때에는 float를 사용한다. 현대 컴퓨터에서는 메모리 부담이 크지 않고 더 높은 정밀도가 필요하기 때문에 대부분 double을 사용한다.
값이 손실되는 이유?
System.out.println(0.1 + 0.2);위와 같은 코드를 작성하였을 때, 사람의 관점에서는 결과값이 0.3일 것이라 예상한다.
하지만 컴퓨터는 실수를 2진수 형태로 저장하기 때문에 0.1과 0.2를 정확하게 표현할 수 없다.
예를 들어 컴퓨터가 0.1을 2진수 형태로 표현하려 하면 무한히 반복되는 소수가 되기 때문에, 컴퓨터는 이를 근사값으로 저장하게 된다. 이러한 이유로 실제 출력값은 다음과 같은 식으로 출력된다.
0.30000000000001이런 문제를 줄이기 위해 정수 형태로 변환하여 계산하거나, BigDecimal과 같은 클래스를 사용하기도 한다.
3) 문자형
문자형에는 char가 있다.
char a = 'a';
char a2 = 97;
char a3 = '\u0061';
대부분 char a = 'a';같은 방식으로 작성하지만, 위 이미지와 같이 아스키코드나 유니코드로도 표현이 가능하다.
또한, char타입은 값을 유니코드 값으로 저장하기 때문에
char a = 'c' - 2;이런 코드를 작성한다면 'c'는 99로 분류되어, 99에서 2를 뺀 값인 97이 저장되며, 문자 'a'가 출력된다.
4) 논리형
논리형에는 boolean이 있다.
boolean은 참을 뜻하는 true와 거짓을 뜻하는 false 두가지의 값을 가진다.
boolean a = (1<2);       //true
boolean b = (1==2);      //false
boolean c = ('a' < 'b'); //true
이를 활용하여 참인지 거짓인지 판단하는 연산이 가능하다.
이는 반복문이나 조건문에 자주 사용된다.
오버플로우, 언더플로우
오버플로우와 언더플로우는 자료형이 저장할 수 있는 범위를 벗어났을때 생기는 현상이다.
예를 들어 byte의 범위는 -128 ~ 127인데
byte a = 127;이라 선언하고 a++연산을 수행할경우 값의 최대 범위를 초과하게 되어 -128이 되어버린다.
반대도 똑같이 -128일때 a--연산을 수행할경우 127로 바뀌게 된다.
실수형의 경우에는 오버플로우가 발생하게 되면 무한대를 의미하는 Infinity값으로 변하게되며, 언더플로우가 발생할경우 표현할 수 있는 최소 범위보다 더 작은 값이 되어 0에 가까운 값으로 소실된다.
2. 참조형
기본형은 변수 자체에 값을 저장하지만,
참조형은 데이터가 저장된 메모리의 주소값을 저장한다.
- 기본형 → 실제 값을 직접 저장
- 참조형 → 값이 저장된 위치를 저장
한다는 차이가 있다.
대표적인 참조형에는 배열(Array), 클래스(Class), 인터페이스(Interface) 등이 있으며, 그 중 가장 자주 사용하는 것이 바로 String이다.
많은 사람들이 문자열이기 때문에 String을 문자형이라고 생각하지만, Java에서 String은 기본형이 아닌 참조형이다.
예를 들어:
String str = "Hello";라는 코드를 작성하였을때, 변수에 직접 실제 문자값을 저장하는 char과는 다르게, String 객체를 생성하고 그 객체의 주소값을 변수를 저장하는 방식으로 동작한다.
String str = null;이러한 특징 때문에, String은 null값을 가질수있다.