최근 cursor나 windsurf와 같은 AI가 적용된 에디터를 활용해 개발을 하고 있다. 내 손으로 일일히 코드를 치지 않게 되어 의존하게 되는 단점이 있지만, 모르는 로직에 대해서 묻고 구현을 해나가면서 과정을 이해하는데에 큰 도움을 받고 있다.
그러나 앞으로 회사에 취직하면 보안상 사용하지 못할 것을 대비해 로컬 AI를 통한 코드 리뷰나 테스트 코드 생성을 하는 시도를 해보았다.
결론부터 말하자면 활용할 수 있는 수준은 만들어 내지 못했고, 단순 코드리뷰 머신으로 사용하게 되었다.
모델 선정
ollama는 무료로 모델을 내 로컬에 설치해 실행할 수 있는 meta에서 만든 LLM이다. 여기에는 다양한 모델들이 있는데 사양에 따라 선택하면 되고, 나는 테스트용으로 codellama 7b 모델을 설치해서 사용했다. (설치할 때 내 7b를 설치했는데 나중에 내 램이 32기가 인걸 보고 13b로 변경했다.)
python 코드 작성하기
해당 시스템을 구축하기 위한 나의 전략은 아래와 같다.
1. 로컬에서 ollama serve로 모델 실행
2. python 파일에서 api로 ollama 호출
3. 파일 내에 작성된 프롬프트로 테스트 코드 생성
여기서 가장 중요한 것은 3번이다.
사실 나는 python으로 코딩을 해본 적이 없어서 llama를 호출하기 위한 코드는 ai의 도움을 받아서 간단하게 생성했지만, 프롬프팅은 계속 발전시켜야 했다.
테스트 코드 생성해보기
import requests
import sys
import os

class TestCodeGenerator:
    def __init__(self):
        self.api_base = "http://localhost:11434/api"

    def generate_test(self, source_code: str, source_path: str) -> str:
        # 소스 파일 경로에서 src/ 이후 부분을 추출
        import_path = source_path.split('src/')[-1]
        if import_path.endswith('.ts'):
            import_path = import_path[:-3]  # .ts 확장자 제거

        prompt = f"""Please generate Vitest test code for the following source code.

Important: Generate only TypeScript test code, not any other language.
Specifically, create test code for the functions defined in the source code.
Use vitest for testing.

- Exclude unnecessary explanations or comments
- DO NOT include any code block markers (```) or language indicators
- Generate only pure executable test code
- DO NOT include any markdown formatting
- DO NOT include any explanatory text

Please consider the following aspects when writing tests:
1. For date-related tests:
   - Consider edge cases for month-end/year-end
   - Utilize JavaScript Date object's automatic overflow handling
   - Use proper date calculation methods (e.g., setDate()) instead of simple arithmetic
   - Consider leap years

2. General test considerations:
   - Include edge cases as well as normal cases
   - Include tests for exception scenarios
   - Each test should verify only one behavior

3. Parameter handling:
   - Always provide valid values for all required parameters
   - For error case testing:
     - Fill all parameters with valid default values first
     - Then modify only the specific parameter being tested for error
     - Use expect().toThrow() or similar assertions for error cases

Write the test code starting directly with the imports, like this:

import {{ describe, it, expect }} from 'vitest';
import {{ functionName }} from '@/{import_path}';

describe('Test Suite Name', () => {{
    // Test cases
}});

Source code:
{source_code}"""

        response = requests.post(
            f"{self.api_base}/chat",
            json={
                "model": "codellama:13b",
                "messages": [
                    {
                        "role": "user",
                        "content": prompt
                    }
                ],
                "stream": False,
                "options": {
                    "temperature": 0.2,  # 온도값 낮춤 (더 결정적인 출력)
                    "top_p": 0.8,        # top_p 값도 조정
                    "max_tokens": 2000    # 최대 토큰 수 제한
                }
            }
        )

        if response.status_code == 200:
            return response.json()["message"]["content"]
        else:
            raise Exception(f"API 호출 실패: {response.status_code}")

def main():
    if len(sys.argv) < 2:
        print("사용법: python code_generator.py <소스코드_파일_경로>")
        return

    source_path = sys.argv[1]
    generator = TestCodeGenerator()

    # 소스 파일 읽기
    with open(source_path, 'r') as file:
        source_code = file.read()

    # 테스트 파일 경로 생성
    test_path = source_path.replace('/utils/', '/__tests__/utils/').replace('.ts', '.test.ts')

    # __tests__ 디렉토리 생성
    os.makedirs(os.path.dirname(test_path), exist_ok=True)

    # 테스트 코드 생성
    test_code = generator.generate_test(source_code, source_path)

    # 테스트 파일 저장
    with open(test_path, 'w') as test_file:
        test_file.write(test_code)

    print(f"테스트 파일이 생성되었습니다: {test_path}")

if __name__ == "__main__":
    main()
이것이 테스트 코드를 생성하기 위해 마지막까지 시도했던 내 python 파일이다.
이런 괴랄한 형태가 나오기까지의 기억을 기록하고자 내가 겪었던 문제들에 대한 회고를 해보려고 한다.
모델 선정
나는 처음에는 7b모델로 실행했지만 생각보다 램이 많이 남아 13b를 새로 설치해서 실행했다. 이 과정에서 무조건 데이터가 많은 모델이 유리한가? 에 대한 고찰을 겪을 수 있었다.
결론은 꼭 그렇지는 않다는 것이다.
정확성
데이터가 많은 모델이 항상 정확한 결과를 만들어 낼까?
실제로 테스트 해본 결과 나는 유의미한 차이를 못느꼈다. 아니 오히려 13b 모델일 때 동일한 프롬프트에서 이상한 결과를 만들어 내는 경우가 있었다.
AI 전문가가 아니라서 왜 그렇게 되었는지는 파악하기 어렵지만, 설정 옵션이나 프롬프트에 따라서 더 큰 모델이 오히려 지나친 오지랖 코드를 만들어 내는 것이 아닐까 싶다.
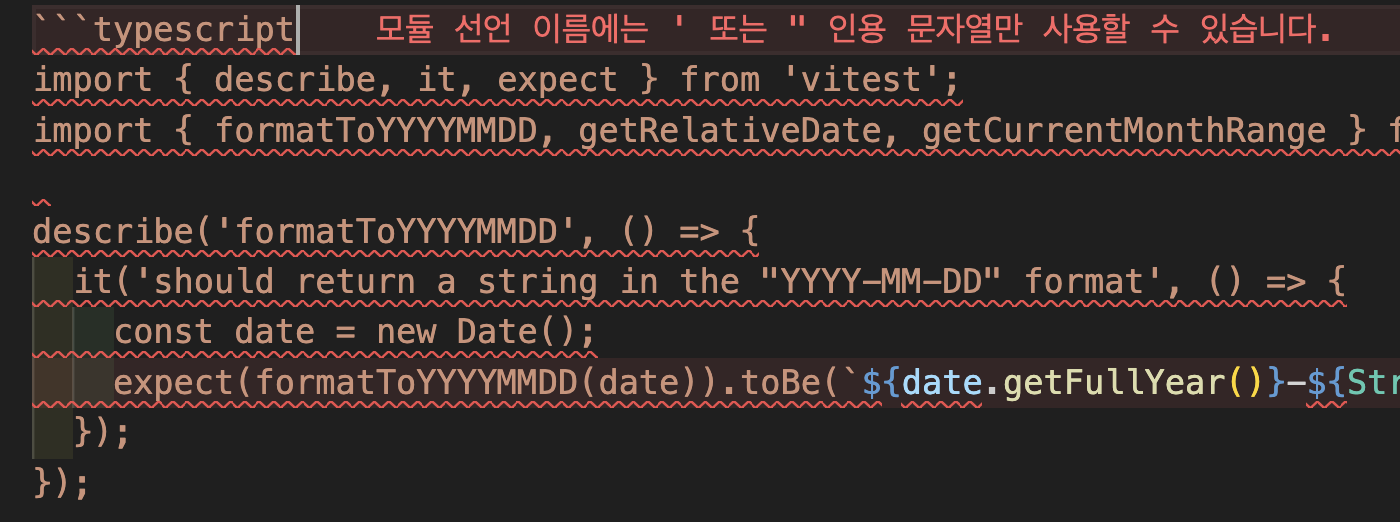
위의 프롬프트를 보면 알 수 있지만 분명 마크다운 문법이나 코드블럭 없이 코드만 작성해서 생성하라 했음에도 불구하고, 13b는 계속 말을 안듣는다.
(7b는 코드블럭없이 잘 만들어줬다....)
시간
생산성을 높이기 위한 시스템 구축에서 시간이 오래 걸린다면 그렇게 좋은 사용자 경험은 아닐 것이다.
아래의 사진은 7b 모델과 13b 모델이 같은 파일에 대해 테스트 코드를 생성했을 때 걸리는 시간이다.
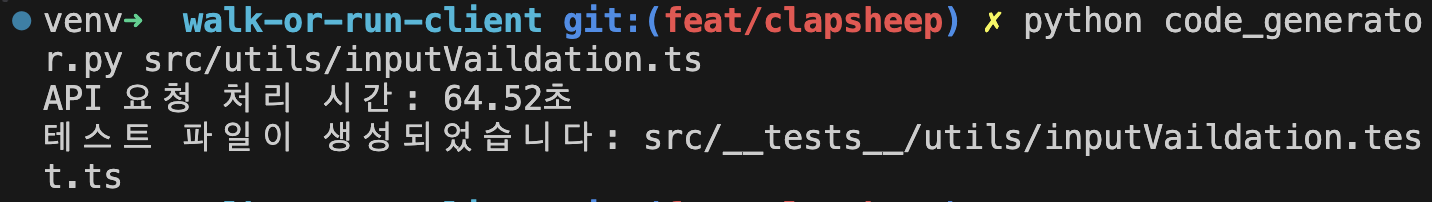
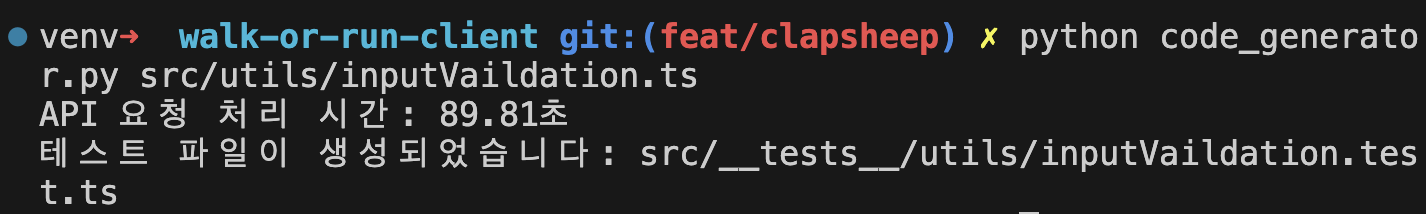
결과는 7b 64.5초, 13b 89.8초 정도로 약 28%의 차이가 난다.
이는 단일 파일일 때 발생하는 시간이므로 두 모델이 만들어 내는 결과가 유의미한 차이가 없다면 더 빠른 7b 모델을 선택할 것이다.
모델 옵션 튜닝
모델을 사용할 때, 여러 수치를 조정해서 신뢰할 만한 값을 찾는 것이 중요했다. 이 수치들에 따라 모델을 더 도전적인 결과를 낼 수도, 보수적인 결과를 낼 수도 있다고 한다.
- temperature (0 ~ 1)
- 값이 낮을수록 (0에 가까울수록)
- 더 안정적이고 예측 가능한 출력
- 항상 가장 확률이 높은 토큰 선택
- 반복적인 작업에 적합
- 코드 생성같은 정확성이 필요한 작업에 좋음 - 값이 높을수록 (1에 가까울수록):
- 더 창의적이고 다양한 출력
- 예상치 못한 결과가 나올 수 있음
- 창의적인 글쓰기에 적합
- top_p (0 ~ 1) 핵심 샘플링을 제어하는 파라미터
- 값이 낮을수록:
- 더 보수적인 선택
- 가장 가능성 높은 토큰들만 선택
값이 높을수록:
- 더 다양한 선택지 고려
- 덜 일반적인 토큰도 선택 가능
- max_tokens
- 생성될 수 있는 최대 토큰 수 제한
- 너무 긴 출력을 방지
- 리소스 사용량 제어
- 응답 시간 관리
이러한 특성을 보아 나는 아래와 같이 설정했다.
temperature: 0.2 (낮게) → 일관된 코드 생성
top_p: 0.8 (중간값) → 적절한 다양성 유지
max_tokens: 2000 → 충분한 길이의 테스트 코드 생성 가능
프롬프팅
파이썬 코드 내부에서 propt를 통해 codellama에게 미리 사전 정보를 학습시킬 수 있다. 내가 입력한 프롬프트의 핵심 내용들만 모아봤다.
- 영어로 프롬프트 입력하기
- import 문 제어하기
- 파라미터 제어하기
여기서 테스트 코드 생성의 한계를 느꼈는데, 단순한 프롬프팅 만으로는 완벽한 테스트 코드를 만들어 내는 것이 어려웠다.
내가 만들었던 로직에 들어가는 모든 케이스의 경우의 수를 누락없이 생성하기 위해 많은 시간을 들여서 프롬프트를 수정해보았지만 cursor나 windsurf로 context를 읽어 만들어낸 코드보다는 성능이 떨어졌다.
그래서 그냥 코드 리뷰 시스템 구축으로 방향을 틀었다.
코드리뷰를 위한 활용
import requests
import json
import os
from typing import Dict, List, Optional

class CodeReviewer:
    def __init__(self):
        self.api_base = "http://localhost:11434/api"

    def review_code(self, source_code: str, file_path: str) -> Dict:
        """
        코드를 분석하고 리뷰 결과를 반환합니다.

        Args:
            source_code (str): 리뷰할 소스 코드
            file_path (str): 소스 코드 파일 경로

        Returns:
            Dict: 리뷰 결과를 포함하는 딕셔너리
        """
        prompt = f"""다음 코드를 검토하고 상세한 분석을 한글로 제공해주세요.
다음 주요 측면들에 집중해주세요:

1. 코드 품질:
   - 클린 코드 원칙
   - 코드 구조
   - 명명 규칙
   - 함수/메서드 길이
   - 코드 중복

2. 모범 사례:
   - TypeScript/JavaScript 모범 사례
   - 오류 처리
   - 성능 고려사항
   - 보안 고려사항

3. 잠재적 문제:
   - 버그 위험
   - 엣지 케이스
   - 오류 시나리오
   - 성능 병목

4. 구체적 제안:
   - 구체적인 코드 개선점
   - 대안적 접근 방법
   - 최적화 기회

다음 JSON 형식으로 검토 결과를 제공해주세요:
{{
    "summary": "코드 개요",
    "issues": [
        {{
            "severity": "high|medium|low",
            "category": "quality|security|performance|maintainability",
            "description": "문제 설명",
            "suggestion": "개선 방법",
            "line_numbers": [해당되는 줄 번호]
        }}
    ],
    "best_practices": [
        "코드에서 발견된 좋은 사례들"
    ],
    "suggestions": [
        "개선 제안 사항들"
    ]
}}

소스 코드 ({file_path}):
{source_code}
"""

        response = requests.post(
            f"{self.api_base}/chat",
            json={
                "model": "codellama:13b",
                "messages": [
                    {
                        "role": "user",
                        "content": prompt
                    }
                ],
                "stream": False,
                "options": {
                    "temperature": 0.2,
                    "top_p": 0.8,
                    "max_tokens": 2000
                }
            }
        )

        if response.status_code == 200:
            try:
                review_content = response.json()["message"]["content"]

                # 응답에서 JSON 부분만 추출하기 위한 처리
                try:
                    # 응답에서 첫 번째 '{' 부터 마지막 '}' 까지만 추출
                    json_start = review_content.find('{')
                    json_end = review_content.rfind('}') + 1
                    if json_start != -1 and json_end != -1:
                        json_content = review_content[json_start:json_end]
                        return json.loads(json_content)

                except json.JSONDecodeError as e:
                    print(f"JSON 파싱 실패. 응답 내용: {review_content}")
                    # 기본 형식으로 응답 생성
                    return {
                        "summary": "코드 분석이 완료되었습니다.",
                        "issues": [
                            {
                                "severity": "medium",
                                "category": "quality",
                                "description": "리뷰 결과를 파싱하는 중 오류가 발생했습니다.",
                                "suggestion": "수동 검토가 필요합니다."
                            }
                        ],
                        "best_practices": [],
                        "suggestions": ["자동 리뷰 결과를 파싱할 수 없어 수동 검토가 필요합니다."]
                    }
            except Exception as e:
                print(f"예상치 못한 오류 발생: {str(e)}")
                print(f"전체 응답 내용: {response.text}")
                raise Exception("리뷰 응답 처리 중 오류가 발생했습니다.")
        else:
            raise Exception(f"API 호출 실패: {response.status_code}")

    def generate_markdown_report(self, review_result: Dict, file_path: str) -> str:
        """
        리뷰 결과를 마크다운 형식의 보고서로 변환합니다.
        """
        report = [
            f"# 코드 리뷰 보고서: {file_path}\n",
            f"## 요약\n{review_result['summary']}\n",

            "## 발견된 문제점\n"
        ]

        severity_labels = {
            "high": "심각",
            "medium": "중요",
            "low": "낮음"
        }

        category_labels = {
            "quality": "코드 품질",
            "security": "보안",
            "performance": "성능",
            "maintainability": "유지보수성"
        }

        for issue in review_result["issues"]:
            severity_emoji = {
                "high": "🔴",
                "medium": "🟡",
                "low": "🟢"
            }.get(issue["severity"], "⚪")

            category = category_labels.get(issue["category"], issue["category"])
            severity = severity_labels.get(issue["severity"], issue["severity"])

            report.append(
                f"### {severity_emoji} {category} ({severity})\n"
                f"- **설명**: {issue['description']}\n"
                f"- **제안**: {issue['suggestion']}\n"
                + (f"- **해당 줄**: {', '.join(map(str, issue['line_numbers']))}\n"
                   if issue.get('line_numbers') else "")
                + "\n"
            )

        if review_result.get("best_practices"):
            report.append("## 발견된 모범 사례\n")
            for practice in review_result["best_practices"]:
                report.append(f"- ✅ {practice}\n")
            report.append("\n")

        if review_result.get("suggestions"):
            report.append("## 개선 제안\n")
            for suggestion in review_result["suggestions"]:
                report.append(f"- 💡 {suggestion}\n")

        return "".join(report)

def main():
    if len(sys.argv) < 2:
        print("Usage: python code_reviewer.py <source_code_file_path>")
        return

    source_path = sys.argv[1]
    reviewer = CodeReviewer()

    # 소스 파일 읽기
    with open(source_path, 'r') as file:
        source_code = file.read()

    # 리뷰 수행
    try:
        review_result = reviewer.review_code(source_code, source_path)

        # 마크다운 리포트 생성
        report = reviewer.generate_markdown_report(review_result, source_path)

        # 리포트 파일 저장
        report_path = f"{source_path}.review.md"
        with open(report_path, 'w') as report_file:
            report_file.write(report)

        print(f"Review report generated: {report_path}")

    except Exception as e:
        print(f"Error during code review: {str(e)}")

if __name__ == "__main__":
    import sys
    main()
내가 작성한 코드에 대한 md문서를 작성하는 방식을 선택했고, 이에 따른 리포트를 md파일로 잘 만들어주는 것을 확인했다.
# 코드 리뷰 보고서: src/core/user/composables/useGetUserInfo.ts
## 요약
이 코드는 사용자 정보를 가져오고 반환하는 컴포저블 함수를 제공합니다.

## 발견된 문제점
### 🟢 코드 품질 (낮음)
- **설명**: 이 코드는 명확하고 간결한 명명 규칙을 따르는 클린 코드 원칙을 준수합니다. 각 함수가 단일 책임을 가지도록 코드 구조가 잘 구성되어 있습니다.
- **제안**: 각 함수의 목적과 입력/출력을 설명하는 주석이나 문서를 추가하세요.

### 🟢 모범 사례 (낮음)
- **설명**: 이 코드는 불변 변수에 `let` 대신 `const`를 사용하고 불필요한 주석을 피하는 등 TypeScript/JavaScript 모범 사례를 사용합니다.
- **제안**: 사용자 정보를 여러 번 가져오는 것을 방지하기 위해 캐싱 메커니즘을 사용하세요.

### 🟢 모범 사례 (낮음)
- **설명**: 이 코드는 예상치 못한 오류를 적절히 처리하기 위한 오류 처리와 로깅을 포함합니다.
- **제안**: 입력 데이터를 검증하고 오류를 더 우아하게 처리하세요.

## 발견된 모범 사례
- ✅ 불변 변수에 `let` 대신 `const`를 사용하고 불필요한 주석을 피하는 등 TypeScript/JavaScript 모범 사례를 사용합니다.
- ✅ 예상치 못한 오류를 적절히 처리하기 위한 오류 처리와 로깅을 포함합니다.

## 개선 제안
- 💡 각 함수의 목적과 입력/출력을 설명하는 주석이나 문서를 추가하세요.
- 💡 사용자 정보를 여러 번 가져오는 것을 방지하기 위해 캐싱 메커니즘을 사용하세요.
- 💡 입력 데이터를 검증하고 오류를 더 우아하게 처리하세요.
마무리
결론적으로 원하는 수준의 결과를 얻어내지는 못했던 시도였지만,로컬 LLM 활용적인 측면에서는 좋은 시도였다고 생각한다.
테스트를 위한 RAG나 상황들을 더 잘 학습하고, 언어의 환경이나 특정 테스트 코드 라이브러리에 특화된 모델을 개발한다면 충분히 가능성이 있지 않을까 하는 생각도 했다.
만약 취업하게 될 회사에서 이러한 시스템을 구축하는 부서가 있다면 꼭 한번 일해보고 싶은 분야라는 생각을 했고 재미있게 일할 수 있겠다는 생각을 했다.