본 포스팅의 내용은 Gareth James, Daniela Witten, Trevor Hastie, Robert Tibshirani, Jonathan Taylor (2023), 「An Introduction to Statistical Learning with Applications in Python」, Springer 를 참고하였습니다.
2.1 통계적 학습이란 무엇인가
통계적 학습이란 데이터를 이해하기 위한 방대한 도구의 모음이다.
통계적 학습은 지도하는 출력 데이터의 유무(정답 세트)에 따라 지도(supervised)학습, 비지도(unsupervised)학습으로 분류 할 수 있다.
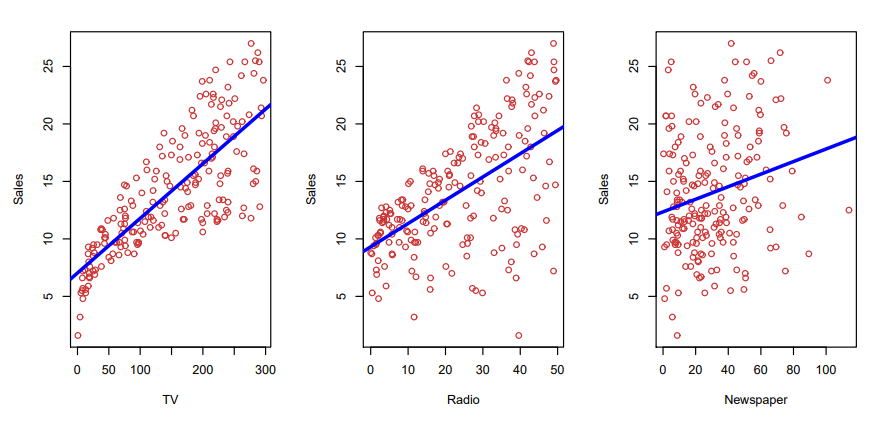
[그림 2.1] 200개 시장에 대한 세 가지 매체의(TV, Radio, Newspaper)의 광고 예산당 판매량
- 입력변수 X (TV, Radio, Newspaer):
- 예측변수(predictor variable)
- 독립변수(independent variable)
- 특징(featuer)
- 변수(variable)
- 출력 변수 Y (Sales):
- 반응변수(responsible variable)
- 종속 변수(dependent variable)
양적 반응변수 와 개의 서로다른 예측변수 를 관측할 때, 여기서 와 사이의 모종의 관계가 있다고 가정한다면 다음과 같은 형태로 쓸수 있다.
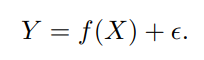
는 예측변수에 대한 고정된 미지의 함수이다. 는 랜덤한 오차항으로, 와 독립이며, 평균은 0이다.
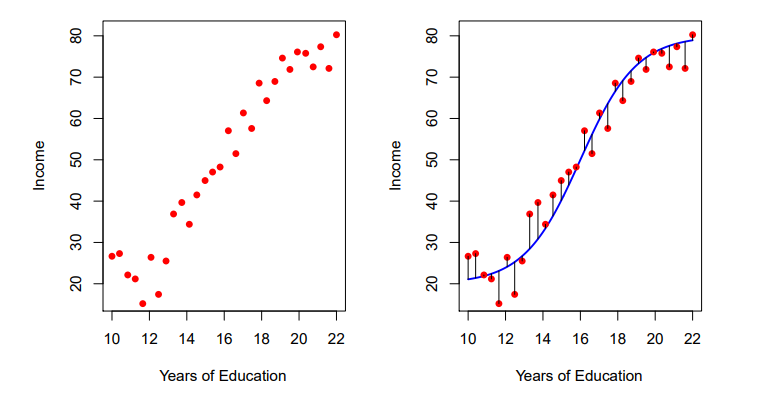
[그림2.2] 교육 연수에 따른 소득 데이터세트(왼쪽). 소득과 연수 사이 관계를 나타낸 파란색 선(오른쪽)
- 파란색 곡선: 함수는 우리가 모르는 함수이므로 관측 점을 기반으로 한 를 추정할 필요가 있다.
- 세로 선: 오차항()으로 근사적으로 평균은 0으로 수렴한다.
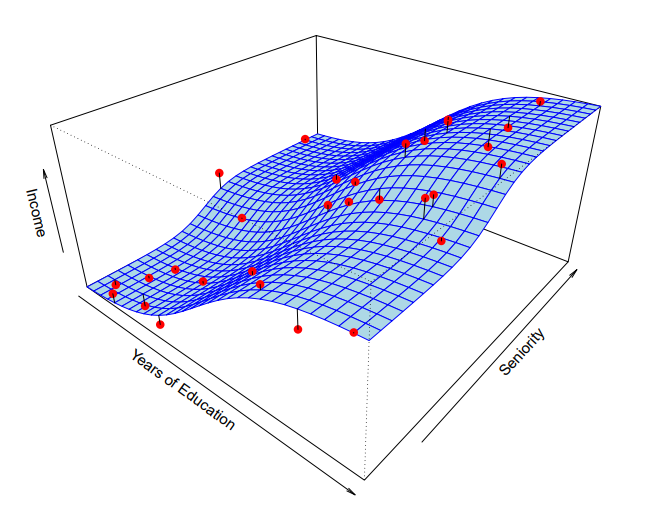
[그림 2.3] 2개(Years of Education, Seriority)의 입력변수를 수반한 함수
2.1.1 왜 를 추정하는가?
를 추정하려는 이유
- 예측
- 추정
1) 예측
입력 집합 는 쉽게 확보 가능하지만, 출력 은 쉽게 얻기 힘들며, 오차항()의 평균은 0이기 때문에 를 다음과 같이 예측할 수 있다.
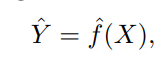
(black box, 의 정확한 값에만 초점을 둔다는 개념)은 의 추정값, 은 그 결과 얻은 에 대한 예측이다.예) 실험실에서 측정가능한 환자 혈액 샘플을 통해 특정한 약에 대한 심각한 부작용을 예측하려고 한다.
를 환자 혈액 샘플의 특성을 나타내는 변수이고, 를 특정한 약에 대한 심각한 부작용의 위험(risk)라는 변수라고 할 때, 를 이용해 를 예측할 수 있다.
에 대한 예측으로서 의 정확도는 축소가능 오차(reducible error)와 축소불가능한 오차(irreducible error)의 양에 따라 달라진다.
- 축소가능 오차: 는 에 대한 추정을 위한 부정확성으로 인한 오차, 통계적 학습을 통해 정확도를 잠재적으로 향상 가능
- 축소불가능 오차: 오차항()의 영향으로 인한 오차, 통계적 학습과 관련 없이 오차 축소 불가능
- 약 제조 과정의 변동
- 환자의 건강 상태
과 가 고정되어있고, 에서만 변동이 있다고 가정한다면, 다음 식이 성립함을 알수 있다.
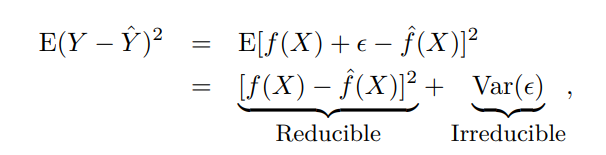
: 실제값과 예측값 사이의 차의 제곱에 대한 기댓값(평균)
: 오차항에 대한 분산
이 책에서는 주로 추정가능한(Reducible) 의 추정 기법에 초점을 맞추고 있다.
2) 추론
정확한 값을 예측하는 것이 아닌, 간의 연관성을 이해하려고 할 때, 를 단지 black box로 취급하지 않고, 정확한 형태를 파악하려고 하는 것을 목표로 한다.
- 추론과 관련된 예시
- 어떤 예측 변수가 반응변수와 연관성이 있을까?
- 반응 변수와 예측변수 사이에는 어떤 관계가 있을까?
- 와 각 예측변수 사이의 관계를 선형식(1차식)으로 적절하게 요약할수 있을까? 아니면 복잡할까?
통계적 학습은 한 곳의 상황에서만 이루지지 않고, 예측, 추론의 복합적인 상황에서 이루어진다.
2.1.2 어떻게 를 추정하는가?
우리의 목표는 통계적 학습 방법을 훈련 데이터에 적용해서 를 추정하고자 한다. 이러한 작업을 위한 대부분의 학습 방법은 모수적(parametic)방법과 비모수적(non-parametic)방법으로 나눌 수 있다.
1) 모수적 방법
두 단계의 모형 기반 접근법을 수반한다.
1. 의 함수 형태나 모형에 대한 가정(예: 가 의 선형함수이다.)
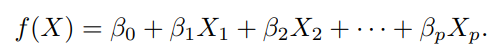
차원 함수 를 추정하는 대신, 개의 모수()만 추정한다.
2. 모형에 적합(fit)하거나 훈련(train)하는 절차가 이루어진다.
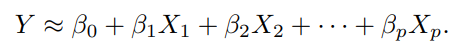
즉, 모수적 방법은 모수 형태를 가정하여 를 추정하는 문제를 단순화시키기 위해 문제를 모수를 집합을 추정하는 문제로 축소시키는 방법이라고 할 수 있다.
하지만 모수적 방법은 함수 의 미지의 참 형태와 일치하지 않는 단점을 가지고 있다.
이러한 문제를 해결하기 위해 유연한(flexible)한 모형을 선택할 수 있다.
하지만 유연한 모형 선택으로 인한 복잡한 모형은 데이터에 과적합(overfitting)을 초래할 수 있다.
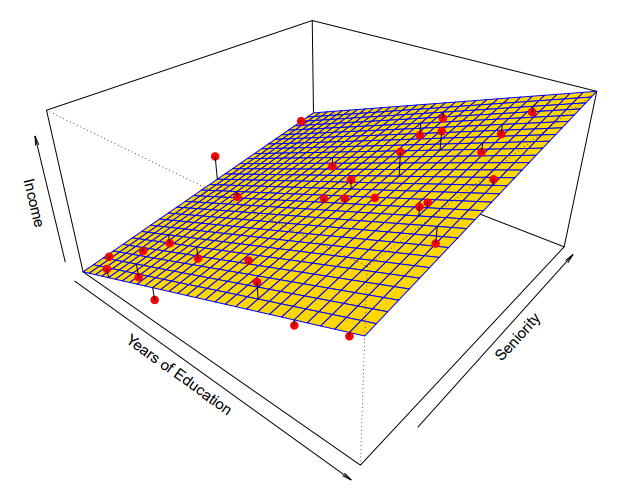
[그림2.4] 선형 모형 적합 결과. Income 데이터에 최소제곱법으로 선형모형을 적합
함수를 선형 모형이라고 가정했을 때, 관측값(빨간점)에 완전히 들어맞다고 할수 없다.
2) 비모수적 방법
함수 형태에 대한 명시적 가정이 없다. 대신 관측값에 최대한 근접하기 위한 함수의 추정값을 구하는 것을 목적으로 한다.
적은 수의 모수로 축소하지 않는 대신, 매우 많은 수의 관측이 있어야 를 추정할 수 있다.
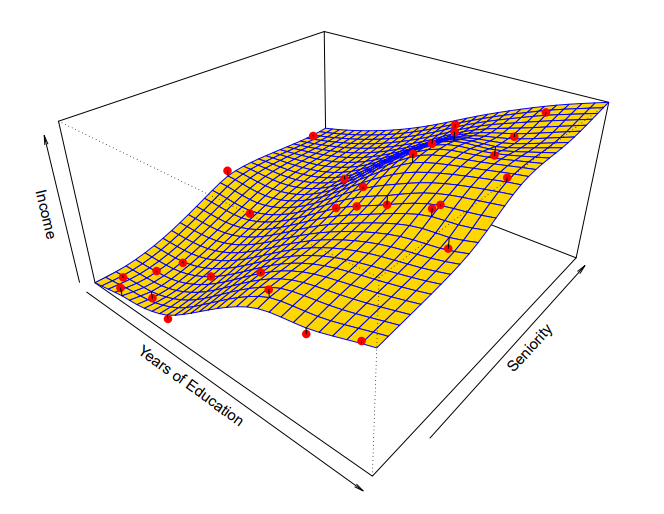
그림[2.5] 평활 박판 스플라인(smooth thin-plate spline) 적합(낮은 평활도 수준)
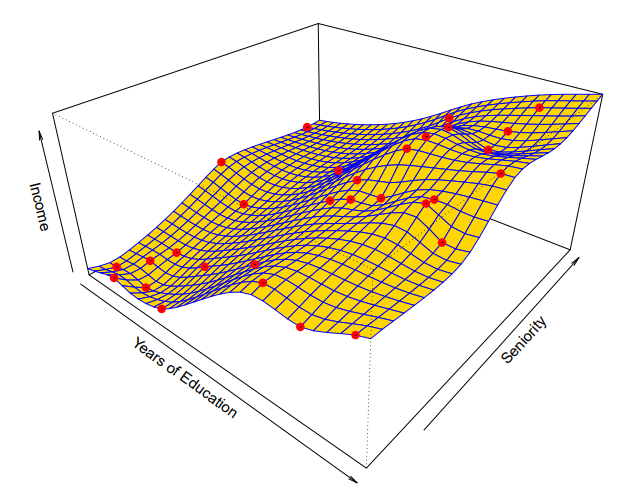
그림[2.6] 울퉁불퉁한 박판 스플라인 적합(높은 평활도 수준)
비모수적 방법은 에 대한 어떠한 모형 지정없이 관측 데이터를 가능한 한 가깝게 얻기 위한 시도가 이루어진다.
이러한 시도는 앞선 선형모형이라고 가정했을 때 표현한 모형에 비해 데이터 과적합에 대한 문제가 생긴다.
또한 테스트 데이터세트에 없는 훈련 데이터세트에 대한 추정이 힘든 단점이 있다.
2.1.3 예측 정확도와 모형 해석 가능성 사이의 트레이드 오프
왜 아주 유연한 접근법을 사용하지 않고, 상대적으로 제약이 많은 방법을 사용할까?
추론이 목적일 경우, 제약이 많은 모형(선형모형)이 유리하다.
예측이 목적일 경우, 제약이 적은 유연한 모형을 사용하는 것이 유리하다.
하지만 실제 예측의 많은 경우가 덜 유연한 방법을 통한 정확한 예측이 이루어진다. 이는 데이터의 과적합 가능성과 연관이 있다.
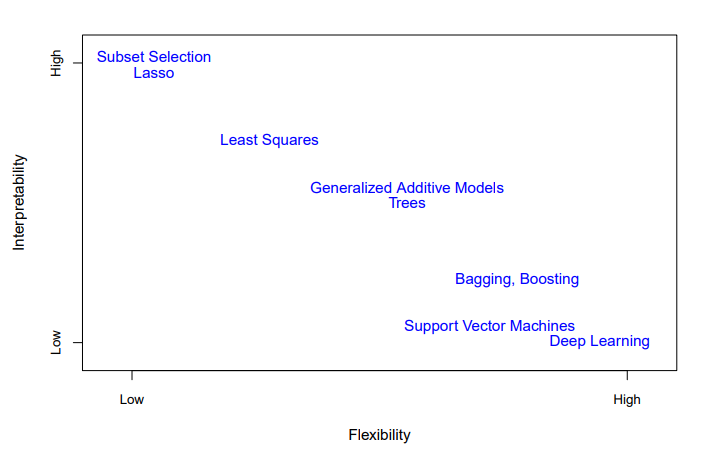
그림[2.7] 다양한 통계적 학습방법의 유연성과 해석 가능성 사이의 트레이드 오프
2.1.4 지도학습대 비지도학습
지도학습: 미래 관측에 대한 반응을 예측하거나(예측), 반응변수와 예측변수 사이의 관계를 더 잘 이해하기 위한 반응(추론)을 예측변수에 관련시키는 모형을 적합
비지도학습: 측정값만 존재하며, 예측할 반응변수가 없는 상황, 변수 사이의 관계 또는 관측 사이의 관계를 이해하려고 할때 시도(군집분석(cluster analysis))
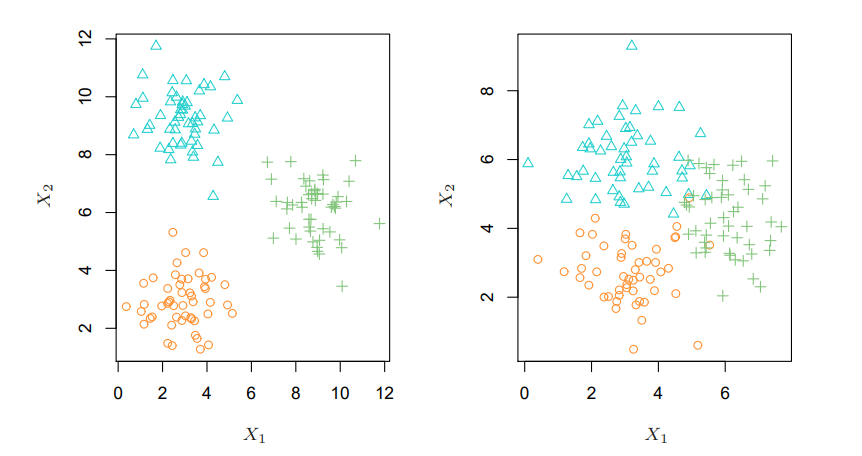
그림[2.8] 세 집단으로 이루어진 데이터 세트의 군집화
앞의 그래프는 변수 에 대한 분포를 통해 군집을 확인할 수 있다.
하지만 현실에는 변수가 2개가 아닌 다수이므로 시각적인 검토를 통한 군집 분석은 어렵다.
준지도학습: 일부의 변수에만 반응 변수가 있을 때의 경우
2.1.5 회귀 문제 대 분류 문제
변수는 특성에 따라 양적/질적 변수로 설명할 수 있다.
- 양적 변수: 수칫값을 가진 변수
- 사람의 나이, 키, 소득, 주택가격, 주가
- 질적 변수: K개의 서로 다른 부류, 범주 중 하나의 값
- 결혼 상태, 재품의 브랜드, 채무 불이행 여부
양적 변수가 있는 경우는 회귀 문제, 질적변수가 포항된 문제는 분류 문제라고 할 수 있다.
하지만 이러한 구분이 명확하게 구분되지 않는 경우도 있다.
예): 로지스틱회귀분석은 질적 변수(두 부류, 이진)가 있을 때 사용되는 분류방법이지만, 각 분류의 확률을 추정하는 점에서 회귀라고 할 수 있다.
2.2 모형의 정확도 평가
높은 모형의 정확도는 데이터 세트에 따른 통계적 학습 방법이 요구된다.
2.2.1 적합도 측정
데이터 세트에 대한 통계적 학습 방법의 성능을 평가하기 위해서는 예측 결과가 실제 관측 데이터에 잘 부합하는지 측정할 방법이 필요하다. 회귀 상황에서 가장 일반적으로 사용되는 측도는 평균제곱오차(MSE, mean squared error)이 있다.
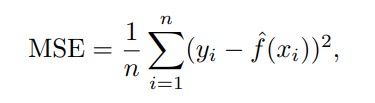
MSE는 번째 관측에서 제공되는 예측값인 이 참 반응값에 대해 얼마나 가까운지에 대한 수치를 제공한다.
MSE는 모형을 적합하는 데 사용된 훈련 데이터를 이용해 계산된다.
하지만 훈련 데이터가 아닌() 테스트 데이터()에 방법을 적용했을 때 얻는 정확도에 더욱 관심이 필요하다.
즉, 낮은 훈련 데이터에 대한 MSE가 필요한 것이 아닌 낮은 테스트 데이터에 대한 MSE가 필요하다.
다음은 실제 테스트 관측에 대한 제곱예측오차의 평균에 관한 식이다.
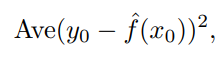
우리는 테스트 MSE를 최소화하기 위한 통계적 학습 방법이 필요하다.
하지만 가능한 테스트 관측 데이터가 없다면 어떻게 할까?
이 경우 낮은 훈련 MSE를 선택하는 것은 좋은 방법이 아니다. 왜냐하면 훈련 MSE와 테스트 MSE가 연관성이 있다는 보장이 없기 때문이다.
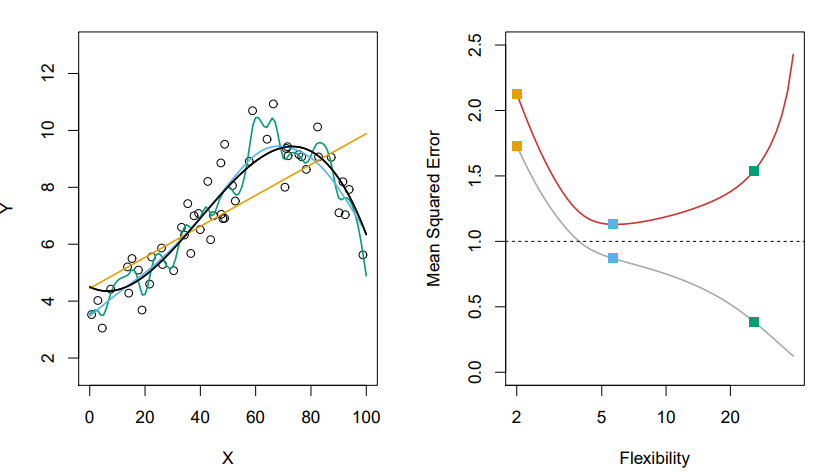
그림[2.9] 실제 함수의 추정값과 서로 다른 통계적 학습을 통해 적합한 결과에 대한 추정값
왼쪽 그래프:
- 검정색 곡선: 참 함수
- 노란색 곡선: 선형회귀 적합 결과
- 파란색 곡선: 평활도가 낮은 평활 스플라인 적합 결과
- 초록색 곡선: 평활도가 높은 평활 스플라인 적합 결과
오른쪽 그래프:
- 회색 곡선: 평균적인 훈련 MSE를 평활 스플라인에 대한 유연성의 함수(자유도)
- 빨간색 곡선: 테스트 MSE에 대한 함수
훈련 MSE의 결과값과는 다르게 통계적 방법의 유연성이 올라갈수록 MSE의 값이 올라갈 수 있다는 것을 알 수 있다.
여기에서는 파란색 선으로 표시된 통계적 방법이 최적의 통계적 방법이라고 할 수 있다.
이렇게 통계적 학습 방법이 유연성이 증가하면서 훈련 MSE는 단조 감소하고, 테스트MSE는 U-자형을 띈다는 점은 통계적 학습 방법의 기본 성질이라고 할 수 있다.
이렇게 통계적 학습의 유연성이 증가함에 따라 테스트 MSE 값이 클 때 데이터를 과적합(overfitting)했다고 할 수 있다.
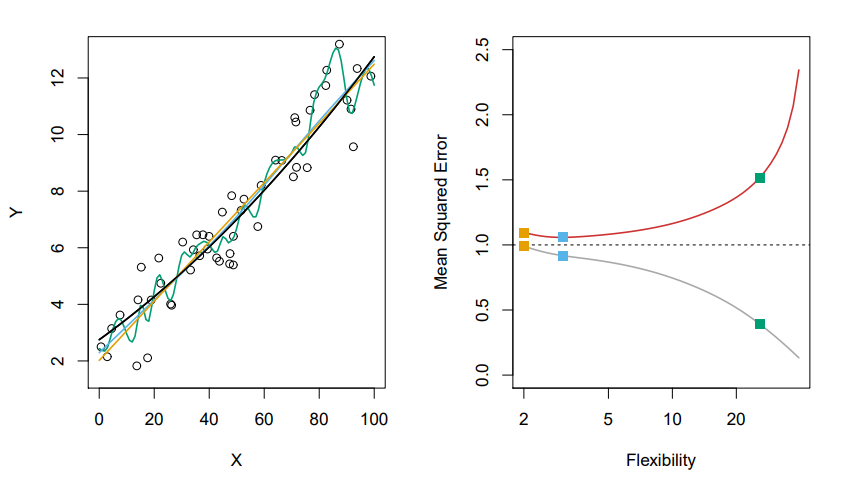
그림[2.10] 데이터 세트가 선형회귀 데이터에 잘 맞는 경우
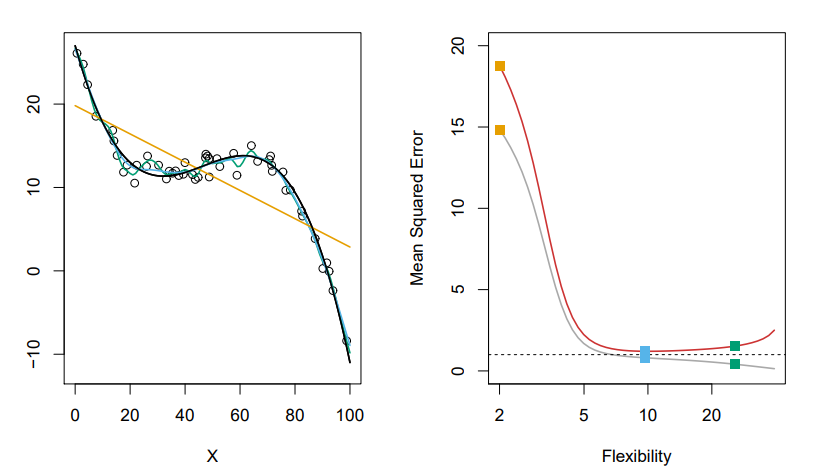
그림[2.11] 데이터 세트가 선형회귀 데이터에 잘 맞지 않은 경우
이처럼 테스트 MSE가 최소인 모형에 대응되는 유연성의 수준은 데이터의 세트에 따라 상당이 달라질 수 있다.
2.2.2 편향-분산 트레이드 오프
주어진 값 에 대한 테스트 MSE의 기댓값은 의 분산, 의 편향의 제곱, 오차항 의 분산의 세가지 기본적인 수량의 합으로 분해된다.
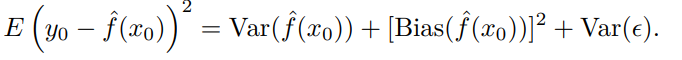
: 기대 테스트 MSE, 많은 훈련 데이터 세트를 통해 반복된 의 추정의 평균
오차항은 축소불가능 오차이므로 제외하고, 낮은 분산과 낮은 편향을 달성하는 통계적 학습을 통해 기대 테스트 MSE를 최소화해야한다.
1) 분산
다른 훈련 데이터 세트를 사용해 를 추정했을 때, 얼마나 변하는 지 나타낸다. 훈련 데이터 세트가 달라지면 값 또한 달라질 것이다.
특정한 방법에서 분산이 높은 경우, 훈련 데이터의 작은 변화가 의 큰 변화를 초래할 수 있다. 일반적으로 유연한 통계적 방법일수록 분산은 높다.
관측치에 대한 의존을 많이한 통계적 방법은 관측값이 일부 달라지면 예측치 또한 크게 달라지기 때문이다.
2) 편향
현실세계의 문제를 단순한 문제로 근사할 때 생기는 오차를 일컫는다.
수 많은 변수를 선형 관계로 축소시킨 선형회귀는 높은 편향을 초래한다.
즉 통계적 방법이 유연할수록 편향은 작아진다.
유연한 통계적 학습 방법을 사용할수록 분산은 커지지만, 편향은 작아진다.
따라서 분산과, 편향을 최소화시키는 일정 지점의 통계적 학습방법을 선택하는 것이 중요하다.
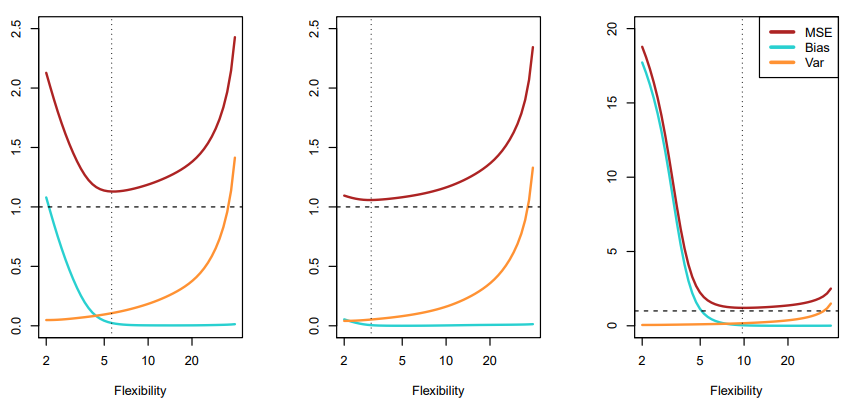
그림[2.12] 앞선 세 개의 데이터 세트에 대한 테스트 데이터의 MSE, 편향, 분산
- 첫 번째 데이터 세트: 유연성이 5 부근일 때 최소 MSE를 띈다.
- 두 번째 데이터 세트: 분산에 대한 변화가 중요. 첫 번째 데이터일 때보다 유연성이 작을 때 최소 MSE를 띈다.
- 세 번째 데이서 세트: 편향에 대한 변화가 중요. 첫 번째 데이터일 때보다 유연성이 클 때 최소 MSE를 띈다.
이를 편향-분산의 트레이드 오프라고 한다.
2.2.3 분류 상황
지금까지는 회귀에 초점을 맞춘 모형의 정확도 이야기였다면, 이번에는 분류 상황일 때 모형의 정확도에 대해 이야기를 시작한다.
분류 상황은 회귀 상황과는 다르게 변수가 질적 변수이므로 식에서 몇가지를 수정해야한다. 다음 모형 정확성을 수량화하는 가장 일반적 접근법은 훈련 오류율(error rate)이다.
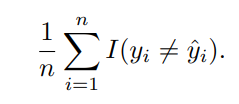
는 를 사용해 번째 관측에서 예측된 분류 레이블이다. 일 경우 올바르게 분류한 것이라고 할 수 있다.
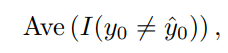
다음은 테스트 데이터에 대한 테스트 오류율이다. 좋은 분류기는 이 테스트 오류율이 가장 작은 분류기라고 할 수 있다.
1. 베이즈 분류기
테스트 오류율을 평균적으로 최소화하는 가장 단순한 분류 방법은 예측변수 벡터값에 대해 가장 가능도가 높은 부류에 할당하는 분류기라고 할 수 있다.
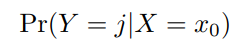
이 식은 조건부 확률으로 예측변수 벡터 이 주어졌을때, 일 확률을 뜻한다. 부류 가 2개일 경우 사용된다.
이렇게 단순한 분류기를 베이즈 분류기(bayes calssifier)라고 한다.
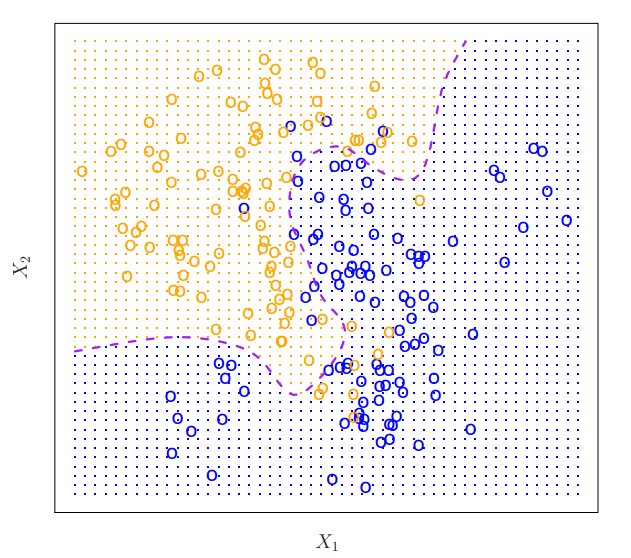
그림[2.13] 100개의 관측을 두 가지 색으로 표시한 시뮬레이션 데이터
- 주황색 음영: 점의 집합
- 파란색 음영: 점의 집합
- 보라색 파선: 점의 집합, 베이즈 결정경계(Bayes decision boundary)
베이즈 분류기는 베이즈 오류율이라는 가능한 가장 낮은 테스트 오류율을 만든다.
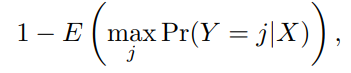
기댓값은 의 가능한 모든 값에 대한 확률을 평균 낸 것이다.
여기서 베이즈 오류율은 0.133이며, 이전에 논의된 축소불가능 오차와 유사하다.
2. K-최근접 이웃
현실 데이터에서는 조건부 분포를 알 수 없으므로(베이즈 분포는 도달 불가능한 황금 표준의 역할)다른 분류기를 사용해야한다.
많은 방법 중 하나는 K-최근접이웃(KNN,K-nearest neighbors) 분류기이다. 양의 정수 K와 테스트 관측가 주어질때, 훈련데이터에서 에 가장 가까운 K개의 점을 찾아낸다.
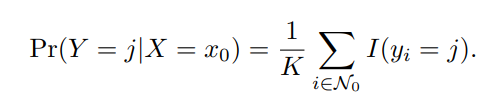
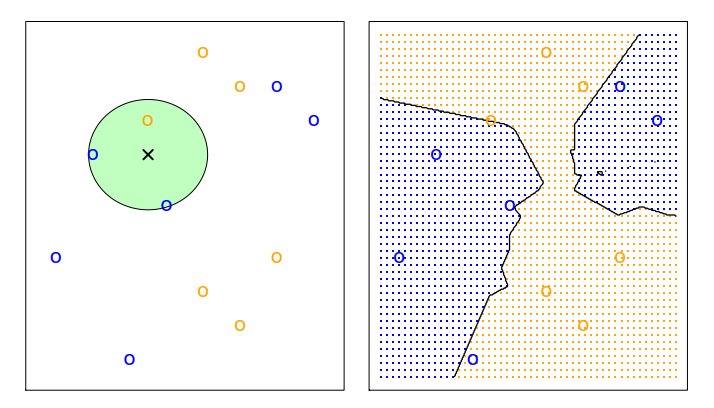
그림[2.14]K=3(왼쪽), K=6(오른쪽)의 KNN접근법
- 주황색 음영: 점의 집합
- 파란색 음영: 점의 집합
- 검정색 선: 점의 집합, KNN 결정경계(KNN decision boundary)
다음은 K=10에서 KNN을 사용한 테스트 오류율은 0.1363으로 베이즈 분류기를 사용한 테스트 오류율 0.1304에 근접하다.
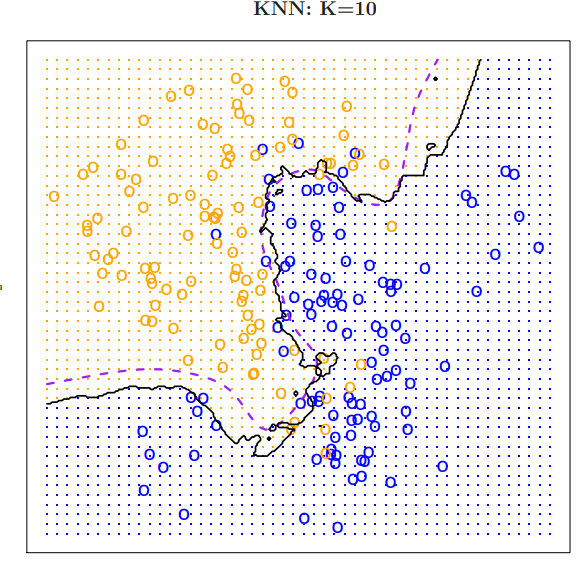
그림[2.15] K=10의 KNN접근법
다음은 K의 값에 따라 달라지는 유연성에 따라 나타나는 편향과 분산의 차이를 나타낸다.
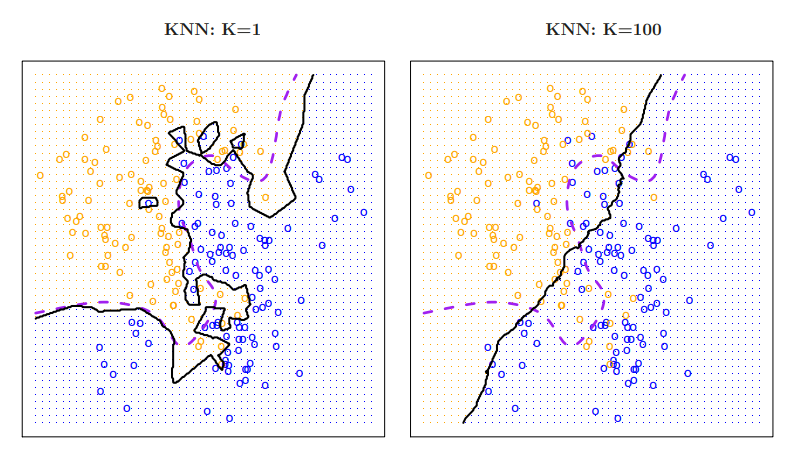
그림[2.16] K=1(왼쪽), K=100(오른쪽)의 KNN접근법
- K=1일 때 분류기: 편향은 낮지만 분산이 매우 높음
- K=100일 때 분류기: 분산은 낮지만 편향이 매우높음
회귀 상황과 마찬가지로 테스트 오류율과 훈련 오류율의 강한 상관관계는 없다.
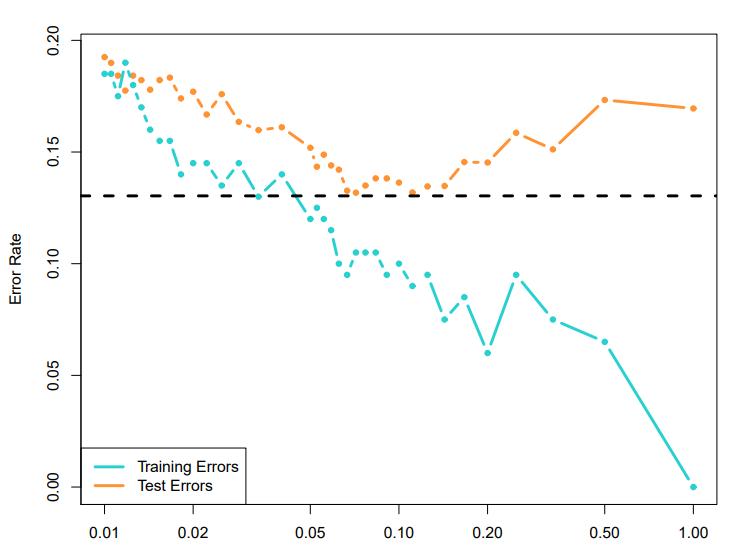
그림[2.17]훈련 오류율과 테스트 오류율에 대한 그래프
- 검정색 파선: 베이즈 오류율
테스트 오류율은 앞선 회귀 상황과 같이 특유의 U-자형을 보여줌을 알 수 있다.(과적합 문제)
따라서 모든 회귀와 분류 상황에서 올바른 수준의 유연성을 선택하는 일은 통계적 학습 방법의 성공을 위해 매우 중요하다.
