11장은 각자 읽어보는 것으로 하고, 12장으로 건너 뛰기로 했다.
이렇게 건너 뛴 12장, 내용 발표는 누구일까?
바로 나. 그리고 늘 감사하고, 좋아하는 언니이다.
언니가 알려준 나와바리 핫플은 2026을 놀라게 할 최고의 장소들이였다.
어떤 체팅 시스템을 설계할까?
면접관과의 대화를 통해 어떤 시스템을 설계해야할지 명확히 얻어와야한다.
책에서는 가상 사례를 들어 우리가 설계해야할 프로그램을 이렇게 정의한다.
1:1 채팅: 두 사용자가 메시지를 주고받을 수 있어야 한다.
그룹 채팅: 최대 100명이 참여하는 채팅을 지원해야 한다.
낮은 응답 지연: 메시지가 상대방에게 실시간에 가깝게 전달되어야 한다.
접속 상태: 사용자의 온라인·오프라인 및 마지막 접속 상태를 표시해야 한다.
웹 + 모바일: 웹과 모바일 환경 모두 지원해야 한다.
다중 단말: 하나의 계정으로 여러 단말에서 동시에 접속할 수 있어야 한다.
푸시 알림: 오프라인 상태의 사용자에게도 새 메시지 알림을 전달해야 한다.
텍스트 메시지: 텍스트 형태의 메시지만 지원한다.
간단히 훑고, 자세한건 아래 내용을 살펴보며 파악해보도록 하자.
체팅 서버의 동작 (개략적 설계안 제시)
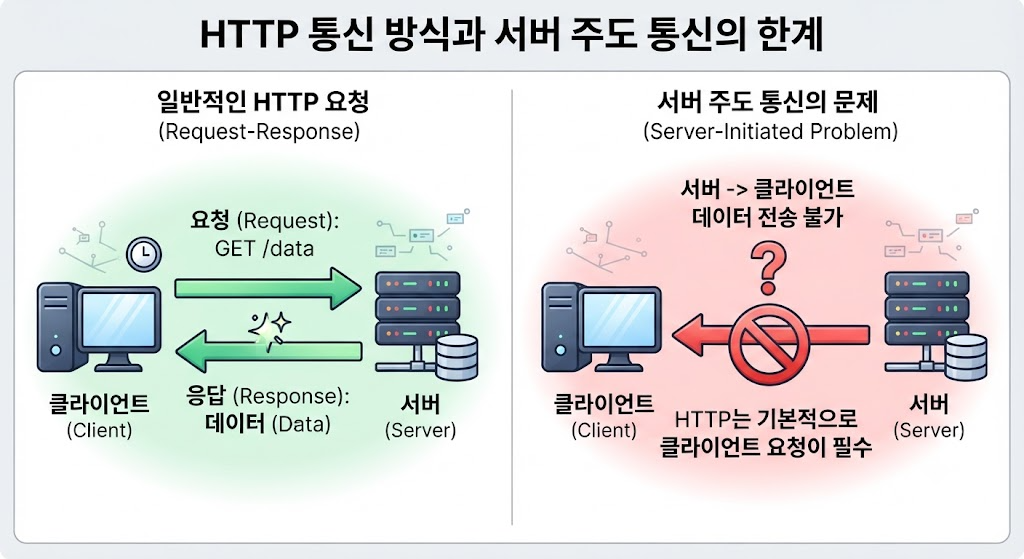
HTTP 요청을 살펴보자.
클라이언트가 서버에게 먼저 요청을 보내야 하는 방식이다.
그런데 채팅은 서버가 클라이언트에게 먼저 요청을 보낸다.
어떻게 설계해야 하는 것일까? 책에서는 설계해야 하는 시스템에 맞춘 몇 가지 방법을 제시한다.
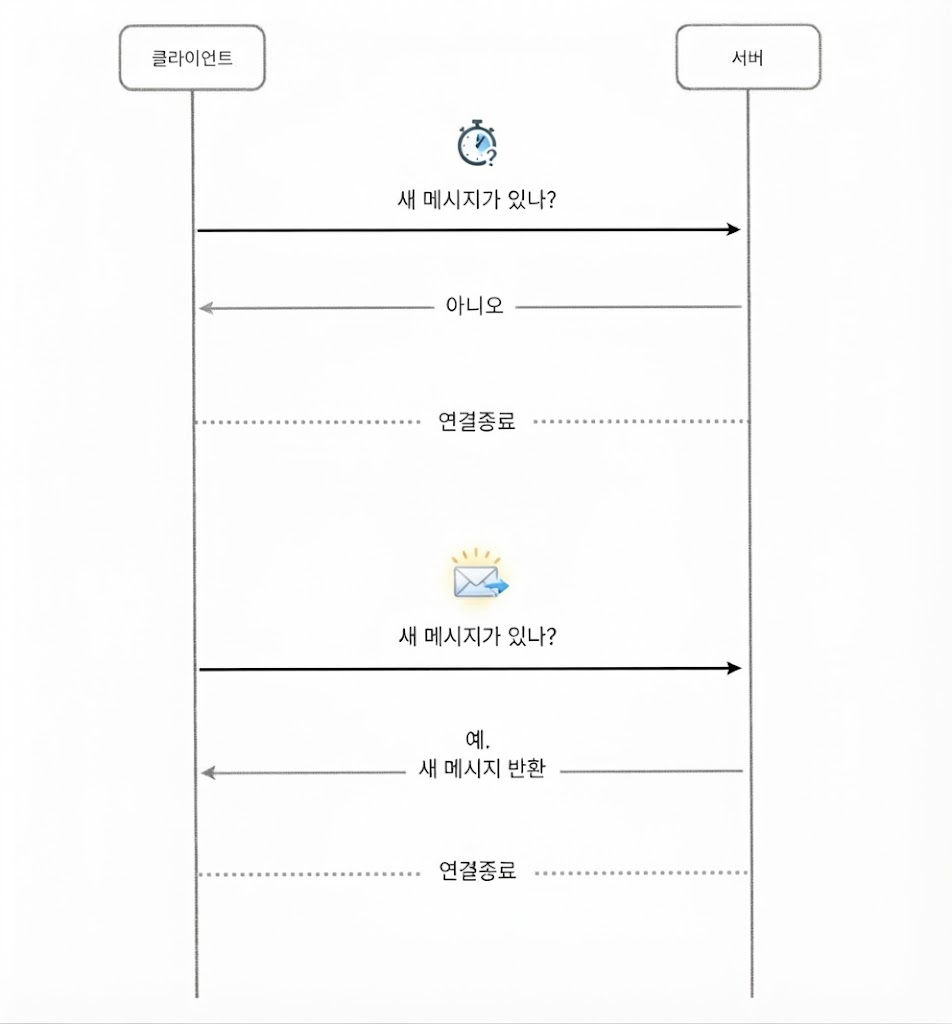
폴링
- 폴링: 클라이언트가 주기적으로 서버에 새 메시지가 있는지 확인하는 방식.
- 단점: 메시지가 없어도 계속 요청해 서버 자원이 낭비되고, 요청이 잦을수록 비용이 증가함.
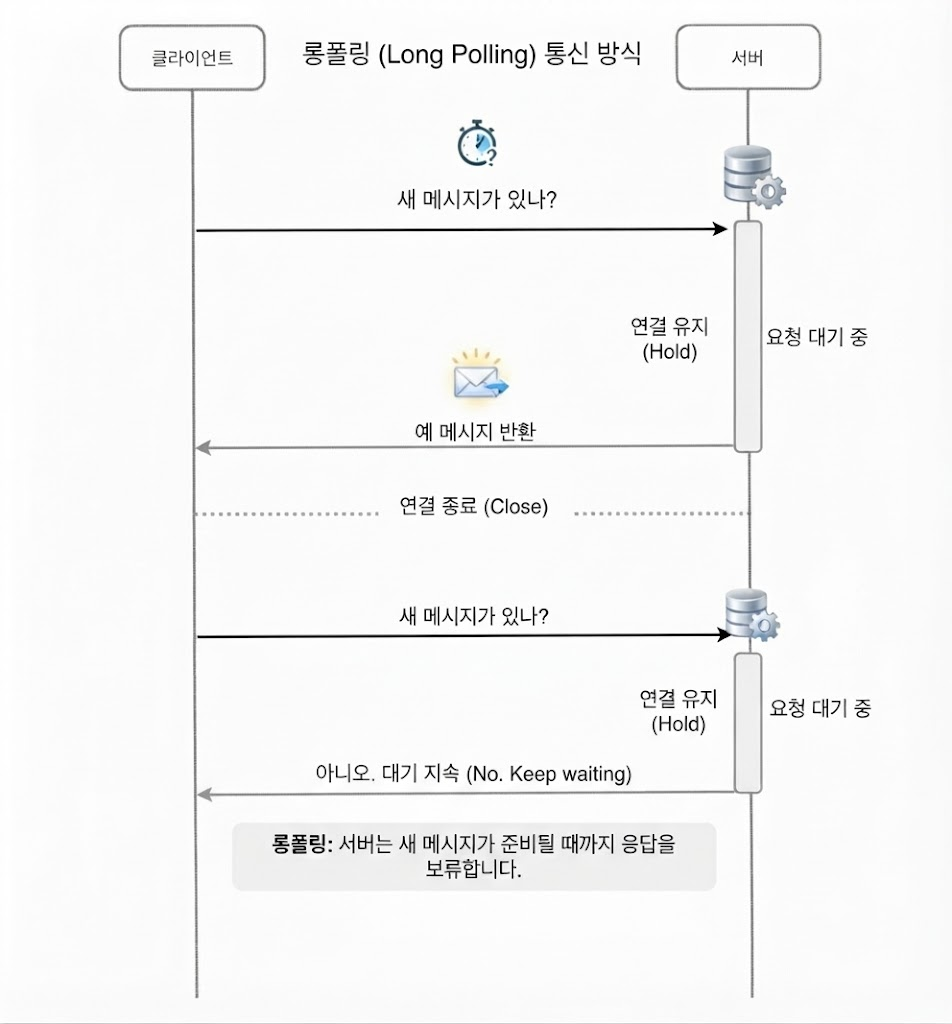
롱폴링
- 롱 폴링: 폴링처럼 반복해서 확인하지 않고, 한 번 요청한 뒤 새 메시지가 올 때까지 서버가 연결을 유지하는 방식.
- 단점: 새 메시지가 오기 전까지 연결을 계속 유지해 서버 자원이 점유될 수 있음.
웹소켓
-
웹소켓: 폴링·롱 폴링과 달리 연결을 한 번 맺은 후, 클라이언트와 서버가 양방향으로 실시간 메시지를 주고받는 방식.
메시지를 보내고 받을 때 동일한 프로토콜을 사용해 설계와 구현이 단순하고 직관적임. -
단점: 연결이 지속적으로 유지되므로 서버에서 연결을 효율적으로 관리해야 함.
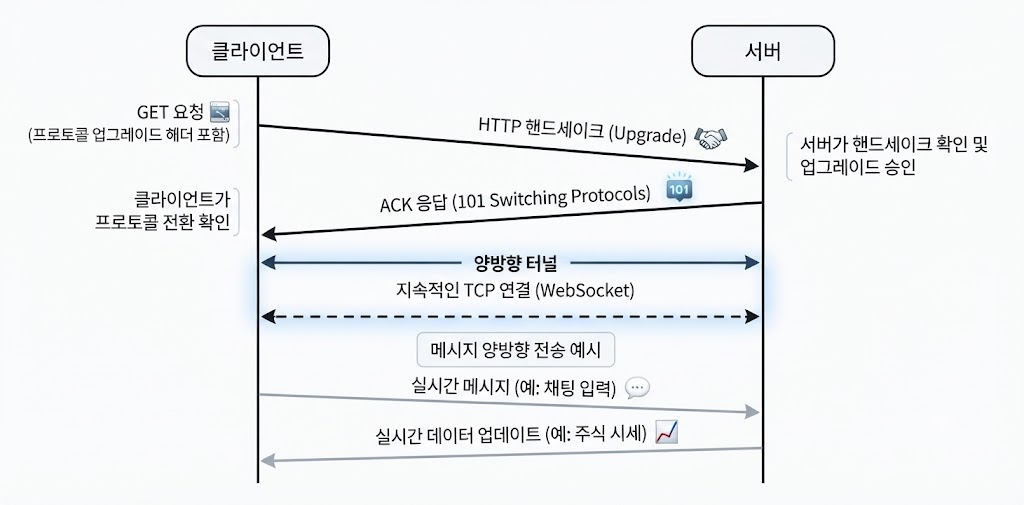
이런 이유로, 책은 서버자원 낭비를 최소화 할 수 있을 것으로 보이는 웹소켓 방식을 채택한다.
이에 맞는 서버구조, 확장성, 데이터베이스에 대해서는 ms가 설명해주었으니
이제부터 데이터베이스 모델과 상세 설계에 대해서 고민해보자.
데이터베이스 모델
키-값 저장소를 데이터 계층 기술로 사용하기로 했으니, 메시지 데이터를 어떻게 보관할 것인지 자세히 살펴보자.
먼저, 1:1 채팅과 그룹 채팅에서 대화 내역을 검색하는 상황을 가정한다.
'2026을 강타'라는 키워드를 언제 사용했는지 알고 싶다고 할 때, 김키핑과의 1:1 대화를 검색한다면 나와 김키핑이 나눈 메시지만 확인하면 된다.
하지만 그룹 채팅방에서 같은 키워드를 찾으려면, 채널에 쌓인 메시지 양 자체가 훨씬 많을 수 있기 때문에 이를 감안한 검색 범위 설계가 필요하다.
이를 효율적으로 처리하려면 데이터를 어떻게 분산할지(샤딩), 무엇을 기준으로 적재할지(파티션 설계)를 함께 고민해야 한다.
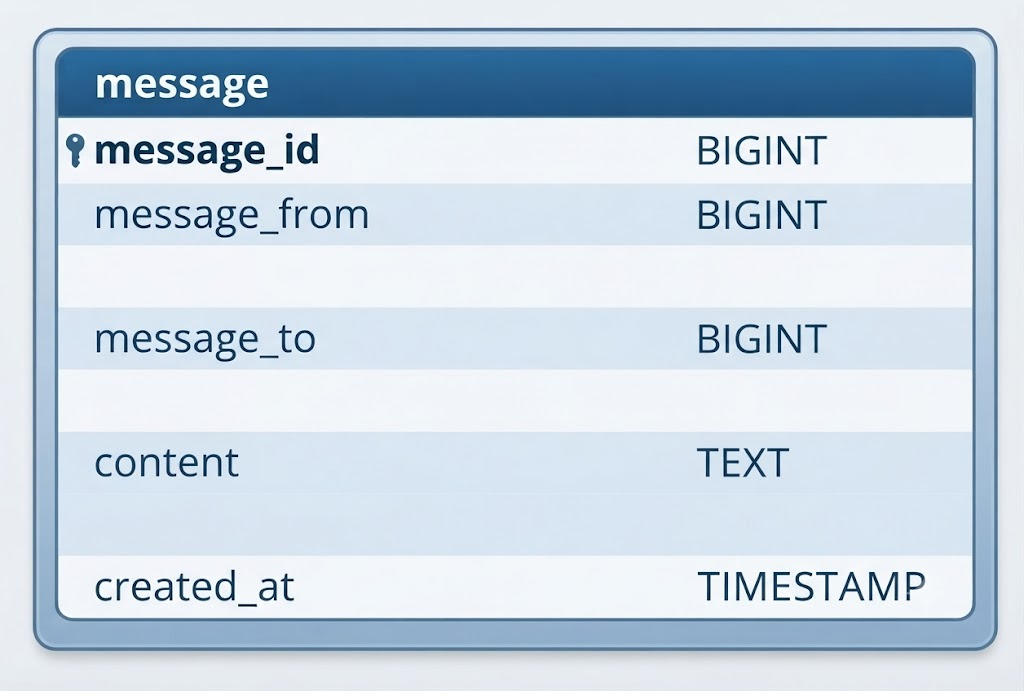
1:1 채팅을 위한 메시지 테이블
이를 효율적으로 처리하려면 데이터를 어떻게 분산할지(샤딩), 무엇을 기준으로 적재할지(파티션 설계)를 함께 고민해야 한다.
책은 이를 위해서는 1:1 채팅에서 효율적인 메시지 테이블 설계는 기본키를 message_id로 사용해야 한다고 말한다.
그룹 채팅을 위한 메시지 테이블
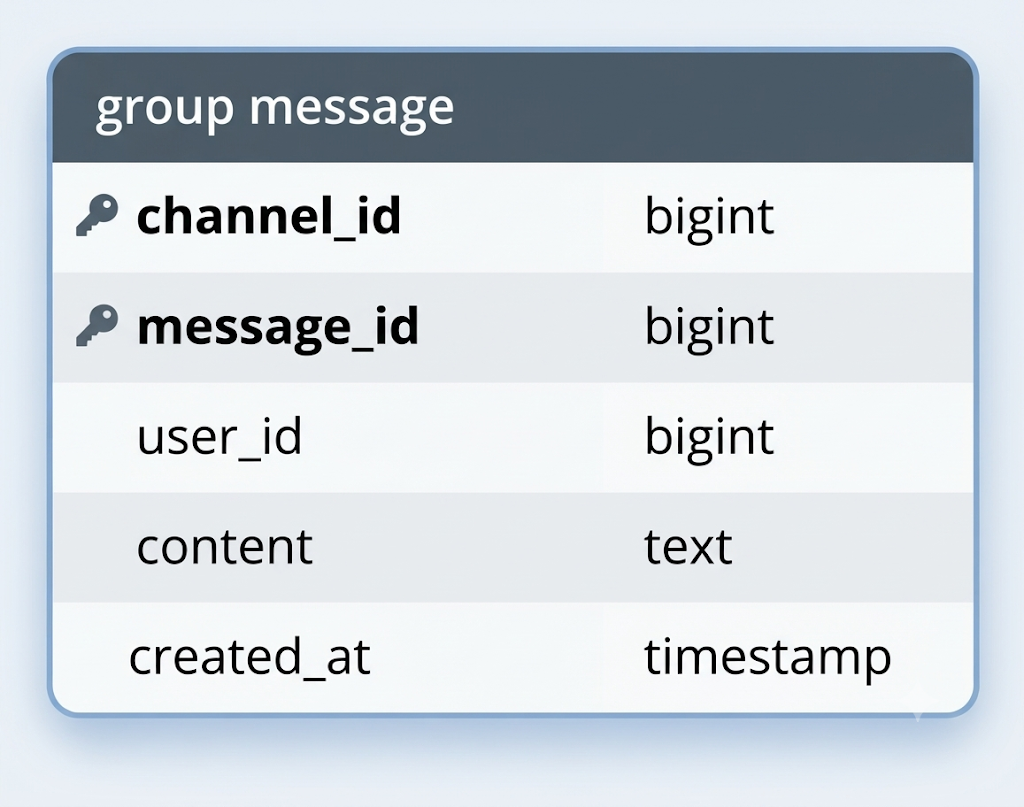
1:1 체팅과 달리 channel_id, message_id 를 복합 기본 키로 사용하여 channel_id를 채팅방을 구분하는 파티션 키로 사용한다면
앞서 언급했던 문제를 해결하면서 체팅 내 효율적인 검색 범위를 설계할 수 있다.
메시지 ID에 대한 고찰
메시지가 생성될 때마다 시스템이 순차적으로 발급하는 고유번호에 관하여
메시지 2개가 정확히 같은 시각(예: 오후 11시)에 생성됐다고 해보자.
- created_at (생성 시각 타임스탬프): 두 메시지 모두 "오후 11시"로 찍혀서 순서를 구분할 수 없음
- message_id: 메시지가 생성될 때마다 시스템이 순차적으로 발급하는 고유 번호라 절대 겹치지 않으므로, message_id 순서를 그대로 메시지 생성 순서로 신뢰할 수 있음
즉, message_id가 지켜야 할 조건은 두 가지다:
1. 값이 고유해야 함 (중복 없음)
2. 새로 생성된 ID는 이전 ID보다 항상 커야 함 (순서 보장)
이 두 조건을 어떻게 만족시킬 것인가
① RDBMS의 auto-increment
- MySQL 같은 관계형 DB에서는 기본 제공되는 기능
- 하지만 NoSQL(키-값 저장소)은 보통 이 기능을 제공하지 않음 → 채팅 메시지 저장소로 NoSQL을 쓴다면 다른 방법이 필요
② 전역적 순서 번호 생성기 (예: 스노우플레이크)
- 시스템 전체에서 유일한 64비트 ID를 생성
- 전체 서비스 어디서든 겹치지 않는 ID를 보장
③ 지역적 순서 번호 생성기 (local sequence number generator)
- 핵심 아이디어: "ID는 전체 시스템에서 유일할 필요 없고, 같은 그룹(채널) 안에서만 유일하면 된다"
- 이게 가능한 이유: 메시지 순서는 어차피 같은 채널 또는 같은 1:1 대화 세션 안에서만 지켜지면 충분하기 때문.
- 전역적 생성기보다 구현이 더 쉬운 방법.
상세 설계
서비스 탐색(service discovery), 메시지 전달 흐름, 사용자 접속 상태를 표시하는 방법 정도에 대해 자세히 다룬다.
서비스 탐색(service discovery)
클라이언트의 위치, 서버 용량등을 고려하여 클라이언트에게 가장 적합한 체팅 서버를 추천하는 기능이다.
주로 쓰이는 오픈소스 솔루션은 아파치 주키퍼(Apache ZooKeeper).
사용 가능한 모든 채팅 서버를 여기 등록시켜 두고, 클라이언트가 접속을 시도하면 사전에 정한 기준에 따라 최적의 채팅 서버를 골라 주면된다.
최적의 체팅서버가 선택되고, 사용자가 해당 서버에 접속하기까지의 과정은 아래와 같다.
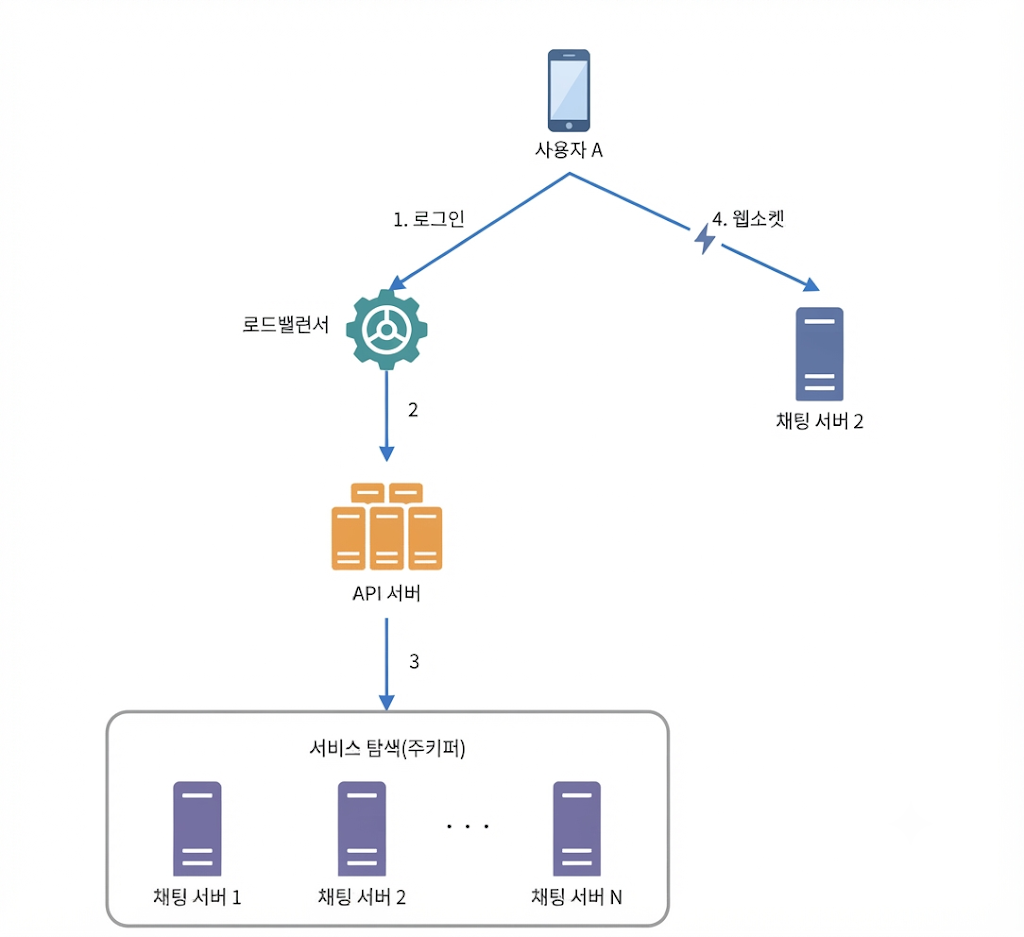
① 로그인 시도
사용자 A가 시스템에 로그인을 시도한다.
② 로드밸런서 라우팅
로드밸런서가 로그인 요청을 여러 API 서버 중 하나로 분배한다.
③ 인증 + 서비스 탐색
API 서버가 사용자 인증을 처리한 뒤, 서비스 탐색(service discovery) 기능이 동작하여 이 사용자를 처리할 최적의 채팅 서버를 찾는다.
→ 이 예제에서는 채팅 서버 2가 선택되어 사용자 A에게 반환됨.
④ 웹소켓 연결
사용자 A는 반환받은 채팅 서버 2와 웹소켓(WebSocket) 연결을 맺는다.
메시지 전달 흐름
1:1 채팅은 메시지를 상대방 한 명에게만 전달하면 처리가 끝나지만,
그룹 채팅은 채널에 속한 여러 참여자에게 메시지를 전달해야 하고, 나아가 각 참여자가 접속한 여러 단말(device) 간에도 메시지를 동기화해야 하기 때문에 처리 흐름이 더 복잡하다.
1:1 채팅 메시지 처리 흐름
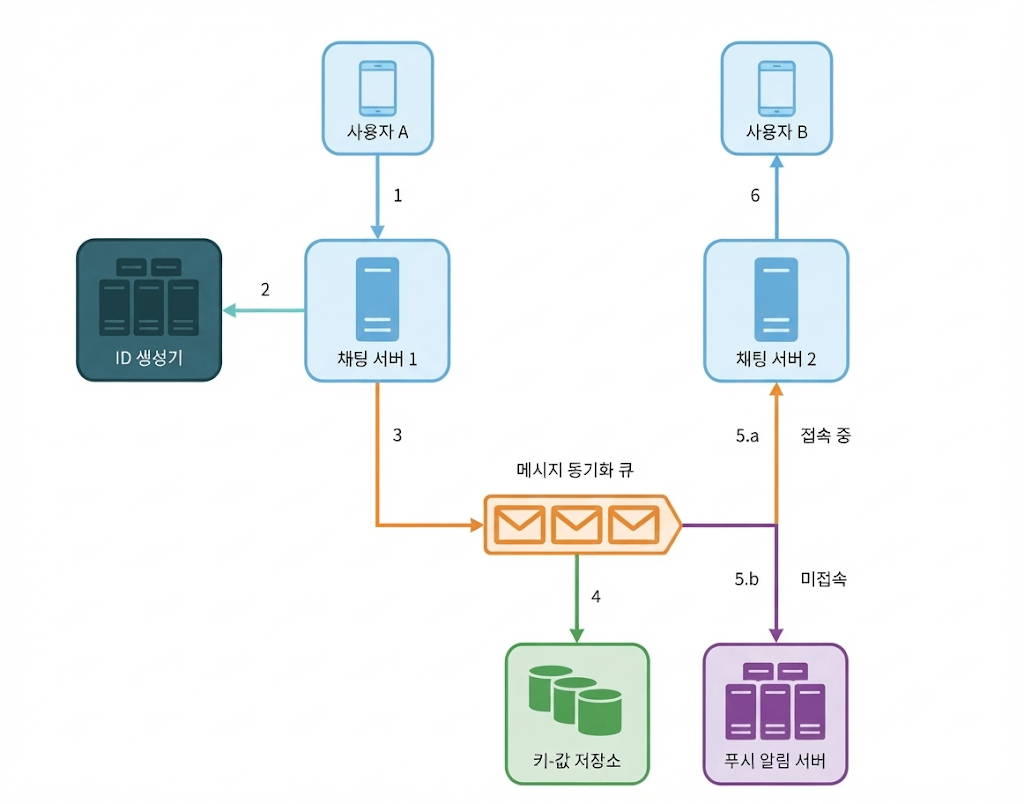
① 사용자가 메시지 전송
사용자 A가 채팅 서버 1로 메시지를 전송한다.
② 메시지 ID 생성
채팅 서버 1은 ID 생성기를 사용해 해당 메시지의 ID를 결정한다.
③ 동기화 큐 전송
채팅 서버 1은 해당 메시지를 메시지 동기화 큐(sync queue)로 전송한다.
④ 저장
메시지가 키-값 저장소(key-value store)에 보관된다.
⑤ 수신자 상태에 따른 분기
(a) 사용자 B가 접속 중인 경우 → 메시지는 사용자 B가 접속해 있는 채팅 서버(이 예제에서는 채팅 서버 2)로 전송됨
(b) 사용자 B가 접속 중이 아닌 경우 → 푸시 알림 메시지를 푸시 알림 서버로 보냄
⑥ 최종 전달
채팅 서버 2는 메시지를 사용자 B에게 전송한다. 사용자 B와 채팅 서버 2 사이에는 이미 웹소켓 연결이 맺어져 있으므로, 그 연결을 이용해 실시간으로 전달한다.
1:1 채팅 vs 소규모 그룹 채팅
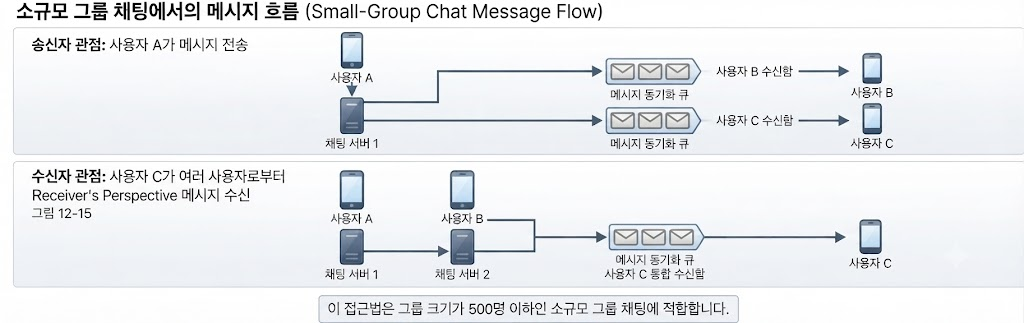
① 메시지 복사 (Fan-out)
- 1:1 채팅: 메시지를 받는 상대방 1명의 큐/서버로만 전달됨
- 그룹 채팅: 사용자 A가 메시지를 보내면, 그룹에 속한 모든 수신자(사용자 B, C 등) 각각의 메시지 동기화 큐에 메시지가 복사되어 전달됨. 즉 하나의 발신이 여러개로 퍼져나감.
② 수신자의 큐 구조 (통합 수신함)
- 1:1 채팅: 내 큐에는 상대방 한 명의 메시지만 쌓임
- 그룹 채팅: 한 수신자의 메시지 동기화 큐에는 여러 사용자(A, B 등)로부터 오는 다양한 메시지가 동시에 수신되어 쌓임
③ 확장성 및 한계
- 그룹 크기가 작을 때(예: 위챗 기준 500명 이하)는 흐름이 단순해서 유리함
- 하지만 멤버가 수천 명 이상인 매우 큰 그룹일 경우, 모든 사람의 큐에 일일이 복사해야 하는 비용(부하)이 너무 커져 이 구조를 그대로 사용하기 어려움
한 사람이 여러개의 단말을 사용한다면?
메시지 동기화를 사용해야한다.
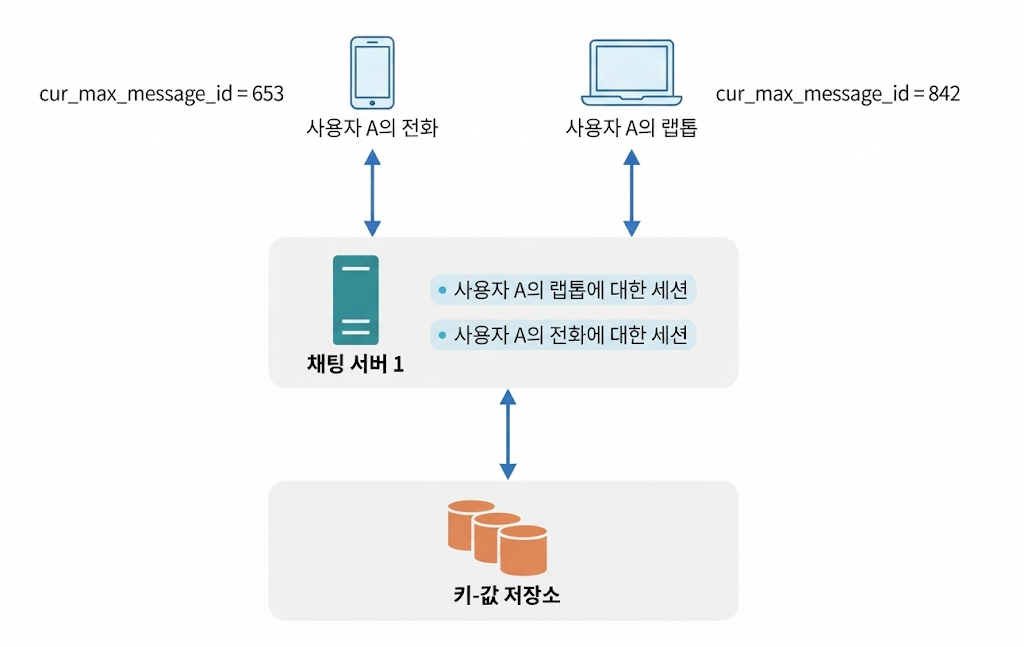
메시지 동기화의 핵심은 cur_max_message_id이다. 이 cur_max_message_id는 사용 중인 단말기에서 가장 최근 확인한 메시지의 ID이다.
"수신자 ID가 내 ID와 같은가", "메시지 ID가 cur_max_message_id보다 큰가"
이 두 조건을 확인한다. 조건을 만족하는(=아직 안 읽은) 메시지가 있다면, 그 시점부터의 메시지를 가져와 다른 단말에서도 내게 온 메시지를 읽을 수 있게 한다.
message_id는 시간순으로 증가하도록 설계되어 있어 "ID가 크다 = 더 최신"이라는 규칙이 성립하기 때문에, 복잡한 비교 없이 단말별로 이 값만 각자 관리하면 여러 단말 간 동기화를 단순하게 구현할 수 있는 것이다.
접속상태 표시
_k_rafton-aliens 워크스페이스에 1빈씨가 있다.
1빈씨가 온라인일 경우, 같은 워크스페이스에 속한 사람들은 모두 1빈씨의 이름 아래 온라인 표시를 볼 수 있지만, 동일 워크스페이스에 속하지 않은 사람은 온라인 표시를 볼 수 없다.
이는 상태정보 시스템이 워크스페이스 단위로 채널을 구성해서, 같은 워크스페이스에 속한 사용자끼리만 서로의 접속 상태를 구독(subscribe)하도록 설계했기 때문이다.
즉 1빈씨의 상태 변화는 "같은 워크스페이스" 채널에만 발행(publish)되고, 그 채널을 구독하는 사람들에게만 전달되는 구조다.
이 구조에서 핵심 메커니즘은 발행-구독 모델(Publish-Subscribe)이다.
발행-구독 모델(Publish-Subscribe)
로그인으로 온라인 상태가 되거나 로그아웃 또는 접속장애로 오프라인 상태가 될 때마다, 이 변화를 친구들에게 알려야 하는데, 이때 사용하는 방식이 발행-구독 모델이다.
각각의 친구 관계마다 채널을 하나씩 둔다.
- 예: 사용자 A의 친구가 B, C, D라면 → A-B, A-C, A-D 세 채널이 존재
- A의 접속상태가 바뀌면(로그인·로그아웃·접속장애 복구 등) → 그 변화를 세 채널 모두에 발행(publish)해서 볼 수 있게 함
- 통신은 실시간 웹소켓으로 처리
한계: 그룹(친구 수)이 커지면 비효율적
- 그룹에 10만 명이 있다면, 상태 변화 1건당 10만 개의 이벤트 메시지가 발생 → 비용·시간 부담 급증
해결책 (대규모 그룹 대응)
1. 사용자가 그룹 채팅에 입장하는 순간에만 상태정보를 읽어가게 함
2. 친구 목록의 접속상태 갱신을 수동(manual)으로 하도록 유도
기타용어
로그인
웹소켓 연결이 맺어지면 접속상태 서버가 키-값 저장소에 status: online과 last_active_at 타임스탬프를 저장한다.
로그아웃
키-값 저장소의 status 값이 online에서 offline으로 바뀐다.
접속 장애 대응
- 문제: 짧은 연결 끊김(터널 등)마다 즉시 오프라인 처리하면 사용자 경험이 나빠진다.
- 해결: 클라이언트가 주기적으로 박동(heartbeat) 이벤트를 보내고, x초 이내 다음 박동이 없을 때만 오프라인으로 전환한다.
추가로 논의 가능한 것
| 항목 | 주요 내용 | 핵심 기술 및 사례 |
|---|---|---|
| 미디어 지원 | 텍스트에 비해 용량이 큰 사진·비디오 파일 전송 처리 | 압축 방식, 클라우드 저장소, 섬네일 생성 |
| 종단 간 암호화 (E2EE) | 발신자와 수신자 외에는 제3자가 메시지 내용을 열람할 수 없는 보안 | 왓츠앱(WhatsApp) 적용 사례 |
| 캐시 | 클라이언트 측에 이미 읽은 메시지를 임시 저장 | 서버와 주고받는 데이터 트래픽 감소 |
| 로딩 속도 개선 | 데이터와 채널을 지리적으로 분산하여 앱 반응 속도 최적화 | 슬랙(Slack)의 지역적 네트워크 분산 |
| 오류 처리 (서버 장애) | 대규모 서버 다운 시 클라이언트가 새로운 서버에 다시 접속하도록 조치 | 주키퍼(ZooKeeper) 등 서비스 탐색 기능 활용 |
| 오류 처리 (메시지 전송) | 네트워크 유실 등에 대비해 메시지의 안정적 전달 보장 | 재시도(Retry), 큐(Queue) 기법 활용 |