아 에바임 글 수정하다 저장안해서 날렸어요. ㄹㅇ임 ㄹㅇㄹㄹㅇㄹㅇㄹㅇㄹㅇㄹㅇㄹㅇㄹㅇ
웹크롤러란
검색 엔진에서 널리 쓰는 기술로, 웹에 새로 올라오거나 갱신된 콘텐츠를 찾아내는 것이
주된 목적이다.
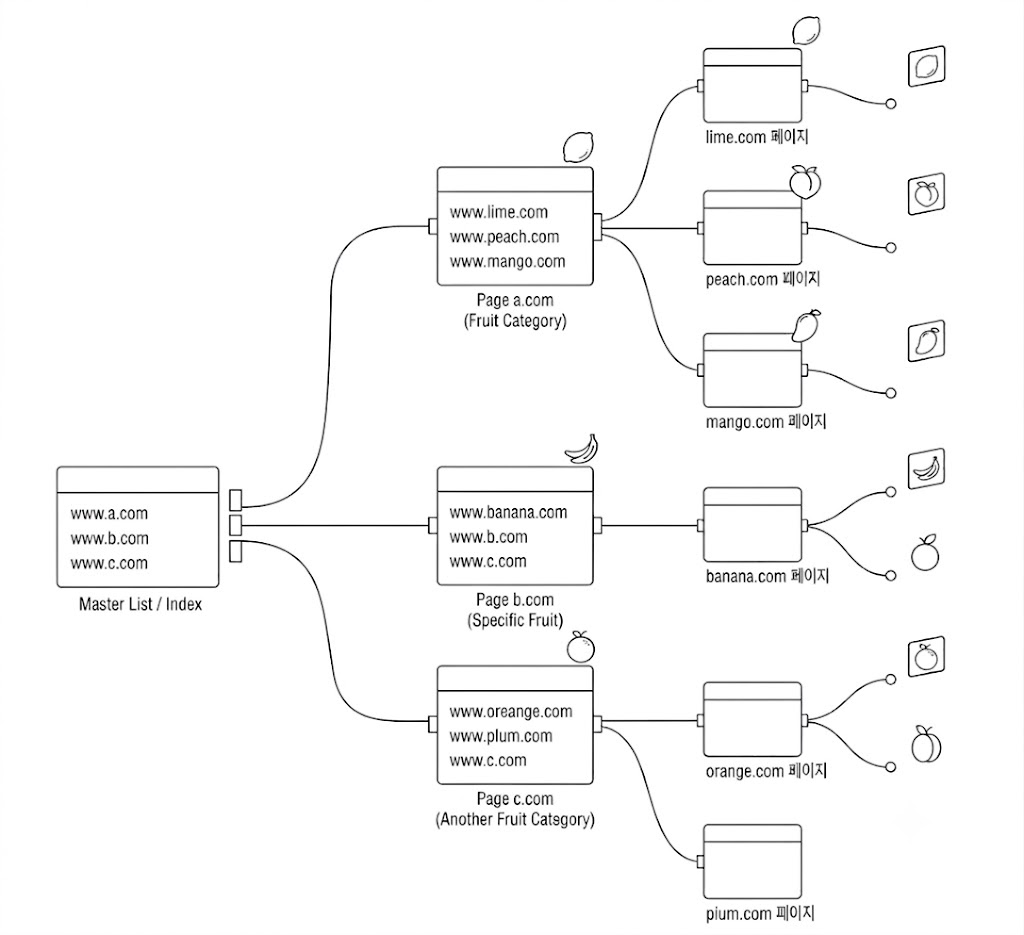
여기서 콘텐츠는 웹 페이지일 수도 있고, 이미지나 비디오, 또는 PDF 파일일 수도 있다. 웹 크롤러는 몇 개 웹 페이지에서 시작하여 그 링크를 따라 나가면서 새로운 콘텐츠를 수집한다.
웹크롤러의 별명
1. 로봇(robot)
사람이 일일이 웹 페이지를 방문하는 대신, 자동화된 프로그램이 사람을 대신해 반복적으로 페이지를 방문하고 수집하는 작업을 하기 때문
2. 스파이더 (spider)
웹(web, 거미줄)을 따라 이 페이지에서 저 페이지로 링크를 타고 옮겨 다니며 돌아다니는 모습이, 마치 거미가 거미줄 위를 기어다니는 것과 비슷하기 때문
웹크롤러의 사용예시
검색 엔진 인덱싱(search engine indexing)
가장 흔하게 쓰이는 방식이다. 크롤러가 웹 페이지들을 모아서 검색할 때 쓸 색인(목록)을 만든다. 우리가 아는 구글 검색도 Googlebot이라는 크롤러가 이렇게 모은 정보를 바탕으로 작동한다.
웹 아카이빙(web archiving)
나중에 다시 보거나 보관해두려고 웹 상의 자료들을 모아두는 것이다. 여러 나라의 국립 도서관들이 이런 식으로 크롤러를 돌려서 웹사이트들을 저장해두고 있고, 미국 국회 도서관이나 EU 웹 아카이브가 대표적인 예다.
웹 마이닝(web mining)
웹이 워낙 빠르게 커지다 보니, 그 안에 쌓인 데이터에서 쓸만한 정보를 뽑아내는 작업도 활발해졌다. 예를 들어 금융 회사들은 크롤러로 기업들의 주주총회 자료나 연간 보고서를 긁어모아서, 그 회사가 어떤 방향으로 사업을 하고 있는지 파악하는 데 활용한다.
웹 모니터링(web monitoring)
인터넷에서 누가 저작권이나 상표권을 침해하고 있지는 않은지 감시하는 용도로도 쓰인다. 디지마크(Digimarc)라는 회사는 크롤러를 이용해 불법 복제된 콘텐츠를 찾아내서 신고하는 일을 한다.
1단계 문제 이해 및 설계 범위 확정
"문제를 이해하고 개략적인 설계안을 제시하자"
웹 크롤러의 기본 알고리즘은 간단하다.
1. URL 집합이 입력으로 주어지면, 해당 URL들이 가리키는 모든 웹 페이지를
다운로드한다.
2. 다운받은 웹 페이지에서 URL들을 추출한다.
3. 추출된 URL들을 다운로드할 URL 목록에 추가하고 위의 과정을 처음부터
반복한다
그런데
웹 크롤러가 정말로 이처럼 단순하게 동작할까? 그렇지 않다.
웹 크롤러는 실제로는 절대 단순하지 않으며, 대규모로 확장 가능한 크롤러를 설계하는 건 매우 어려운 작업이라 인터뷰 시간 안에 완성하기 힘들다. 그래서 본격적인 설계에 앞서 질문을 통해 요구사항을 파악하고 설계 범위를 좁혀야 한다.
질문예시
지원자: 이 크롤러의 주된 용도는 무엇인가요? 검색 엔진 인덱스 생성용인가
요? 아니 면 데이터 마이닝 ? 아니면 그 외의 다른 용도가 있나요?
면접관: 검색 엔진 인덱싱에 쓰일 것입니다.
지원자: 매달 얼마나 많은 웹 페이지를 수집해야 하나요?
면접관: 10억 개(Ibillion)의 웹 페이지를 수집해야 합니다.
지원자: 새로 만들어진 웹 페이지나 수정된 웹 페이지도 고려해야 하나요?
면접관: 그렇습니다.
지원자: 수집한 웹 페이지는 저장해야 합니까?
면접관: 네. 5년간 저장해 두어야 합니다.
지원자: 중복된 콘텐츠는 어떻게 해야 하나요?
면접관: 중복된 콘텐츠를 갖는 페이지는 무시해도 됩니다.
이렇듯 면접관과의 대화를 통해 기능 요구사항을 확실히 해두면 좋다.
좋은 웹크롤러
면접관과 함께 크롤러의 기능 요구사항을 명확히 하면서, 동시에 좋은 크롤러가 갖춰야 할 속성(규모 확장성, 안정성, 예절, 확장성)에도 주의를 기울이자.
| 속성 | 설명 |
|---|---|
| 규모 확장성 (scalability) | 웹에는 수십억 개의 페이지가 존재하므로, 병행성(parallelism)을 활용해야 효과적으로 크롤링할 수 있다 |
| 안정성 (robustness) | 잘못 작성된 HTML, 무응답 서버, 장애, 악성 링크 등 함정이 많은 웹 환경에서 비정상적 입력이나 상황에도 잘 대응해야 한다 |
| 예절 (politeness) | 수집 대상 웹 사이트에 짧은 시간 동안 너무 많은 요청을 보내지 않아야 한다 |
| 확장성 (extensibility) | 이미지 등 새로운 형태의 콘텐츠를 지원할 때 전체 시스템을 새로 설계할 필요 없이 쉽게 확장할 수 있어야 한다 |
개략적 규모 추정
문제 이해 및 범위 확정을 통해 개략적 설계안을 제시하고, 면접관의 동의를 구한다.
책에서의 개략적 설계안은 아래와 같다.
| 항목 | 계산/가정 | 결과 |
|---|---|---|
| 월간 다운로드 페이지 수 | 가정 | 10억(1,000,000,000) 개 |
| 평균 QPS | 10억 / 30일 / 24시간 / 3600초 | 약 400 페이지/초 |
| 최대(Peak) QPS | 평균 QPS × 2 | 800 |
| 웹 페이지 평균 크기 | 가정 | 500KB |
| 월간 저장 용량 | 10억 페이지 × 500KB | 500TB/월 |
| 5년간 저장 용량 | 500TB × 12개월 × 5년 | 30PB |
2단계 개략적 설계안 제시 및 동의 구하기
요구사항이 분명해지면 개략적 설계를 진행하자.
이를 위해서는 크롤러를 이루는 각 시스템 컴포넌트를 하나하나 살펴봐야 한다.
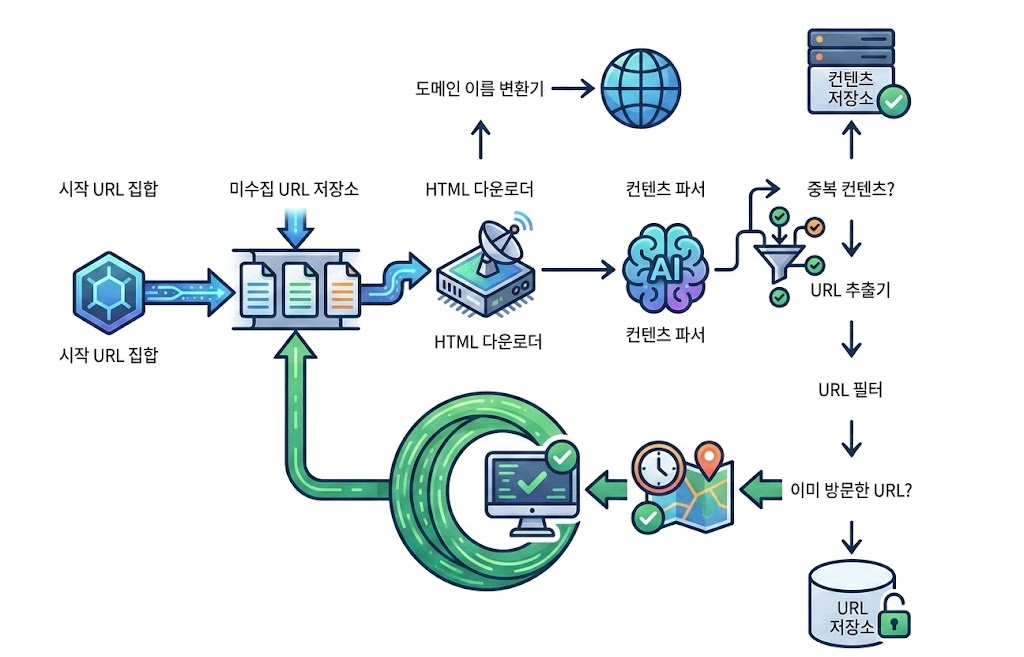
시작 URL 집합
크롤링을 시작하는 출발점 URL들의 모음으로 크롤러가 가능한 한 많은 링크를 탐색할 수 있도록 하는 URL을 고르는 것이 바람직하다.
예시)
좋아하는 여자가 참여한 프로젝트 중, 알려진 프로젝트인 TypeSomething을 살펴보자.
바쁜와중에도 이런걸 만들다니, 정말 대견하다? 자랑스럽다? 암튼 짱이다.
https://typesomething.vercel.app/ 에 있는 모든 노래와
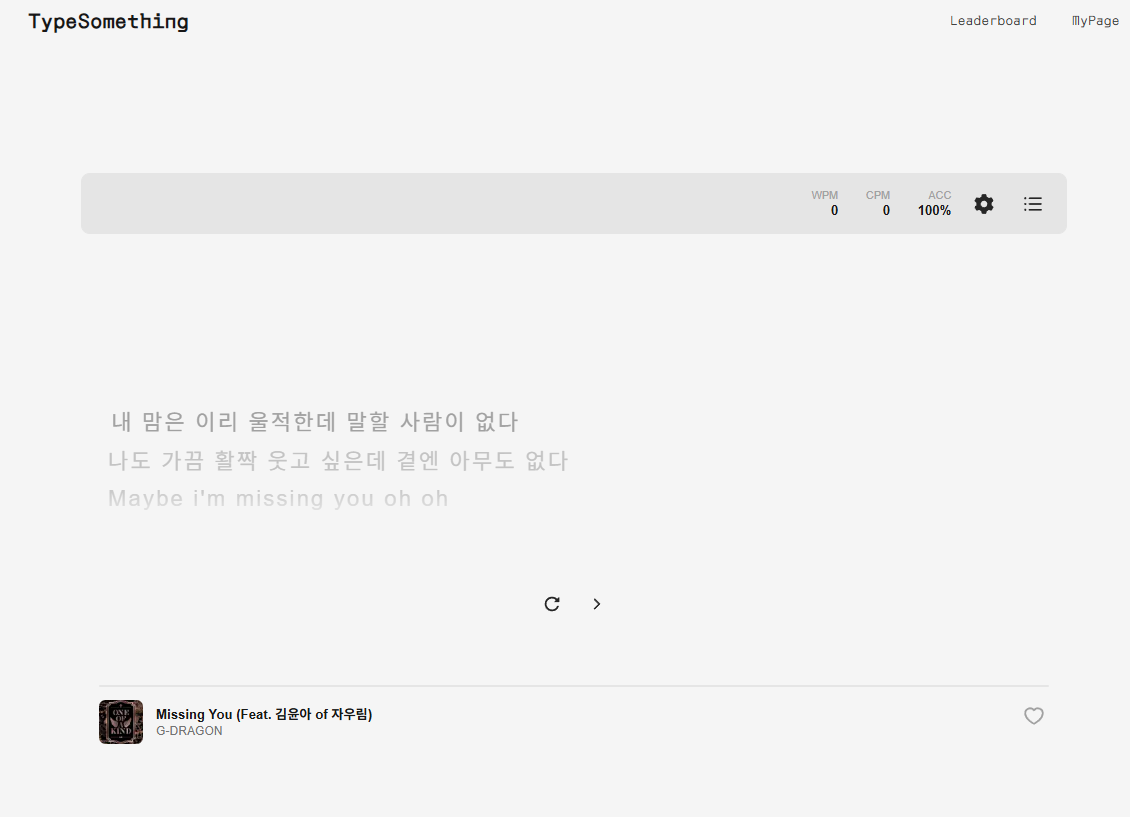
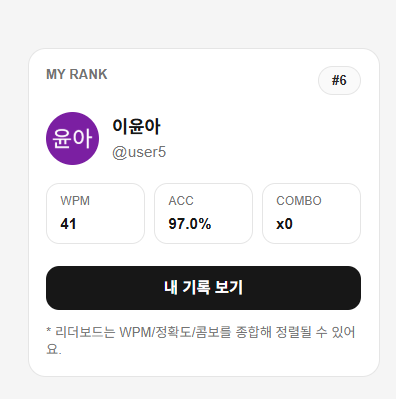
https://typesomething.vercel.app/leaderboard
유저랭킹,
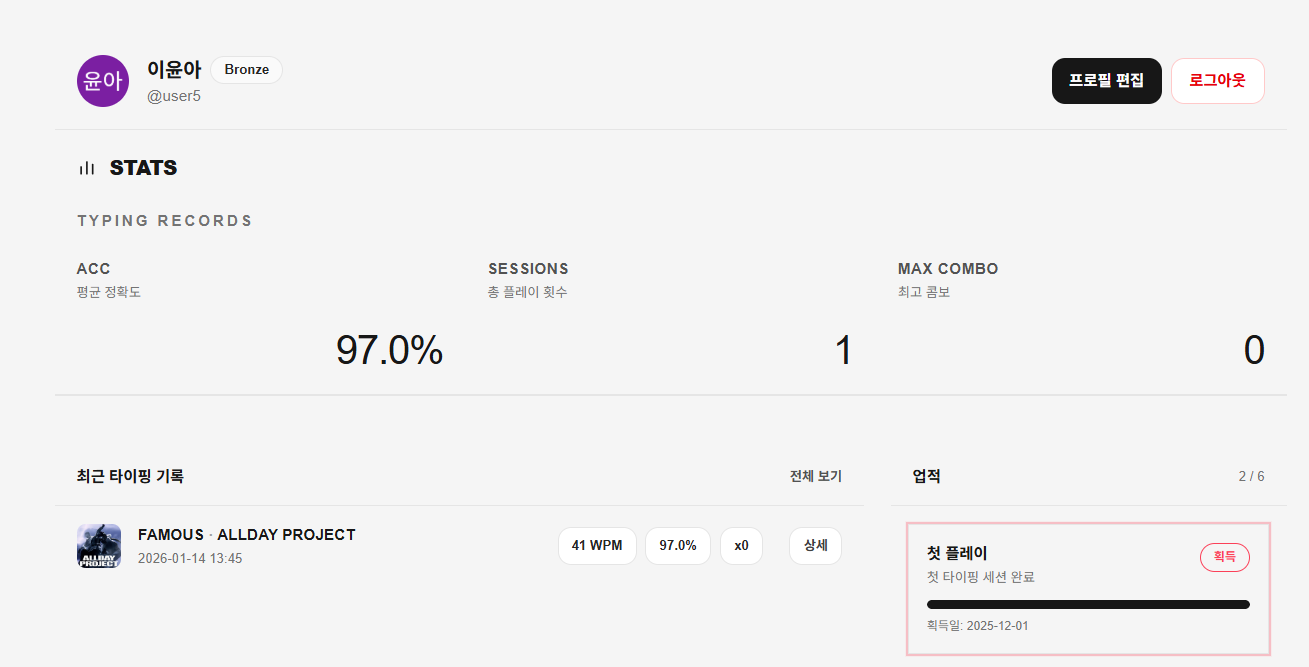
https://typesomething.vercel.app/my
마이페이지
업적, 최근 플레이한 곡 등을 크롤링한다고 해보자.
크롤러가 가능한 한 많은 링크를 탐색할 수 있도록, 루트도메인인
https://typesomething.vercel.app 에서 크롤링을 시작하자.
미수집 URL 저장소 (URL Frontier)
다운로드할 URL들을 관리하는 컴포넌트로, FIFO 큐와 유사하게 작동한다.
HTML 다운로더
인터넷에서 웹 페이지를 다운로드하는 컴포넌트이다.
도메인 이름 변환기
URL을 IP 주소로 변환하는 역할을 한다.
콘텐츠 파셔
다운로드된 웹 페이지를 파싱하고 검증하여 문제가 있는 페이지를 걸러낸다.
중복 콘텐츠 확인
웹 페이지의 해시 값을 비교하여 데이터 중복을 줄인다.
콘텐츠 저장소
HTML 문서를 보관하는 시스템으로, 디스크와 메모리를 함께 사용하여 효율성을 높인다.
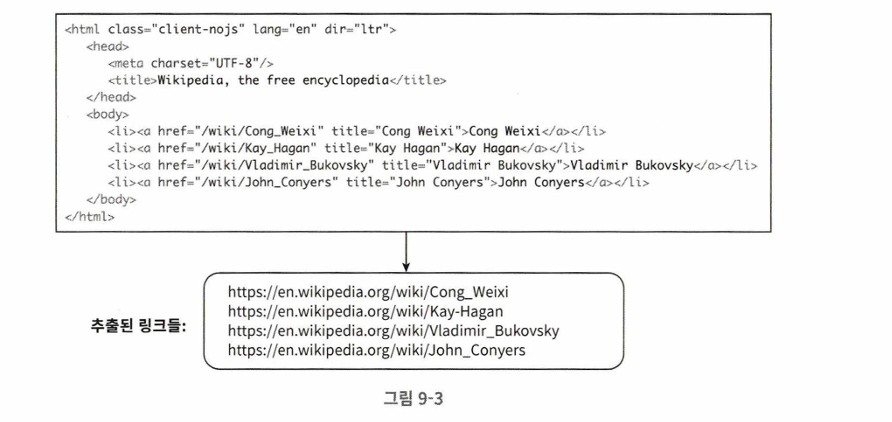
URL 추출기
HTML 페이지를 파싱하여 링크들을 추출한다.
URL 필터
특정 콘텐츠 타입, 오류 발생 URL, 접근 제외 목록에 포함된 URL 등을 크롤링 대상에서 배제한다.
이미 방문한 URL 추적
블룸 필터나 해시 테이블을 사용하여 같은 URL을 여러 번 처리하는 것을 방지하고 서버 부하를 줄인다.
URL 저장소
이미 방문한 URL을 보관하는 저장소이다.
웹 크롤러 작업 흐름
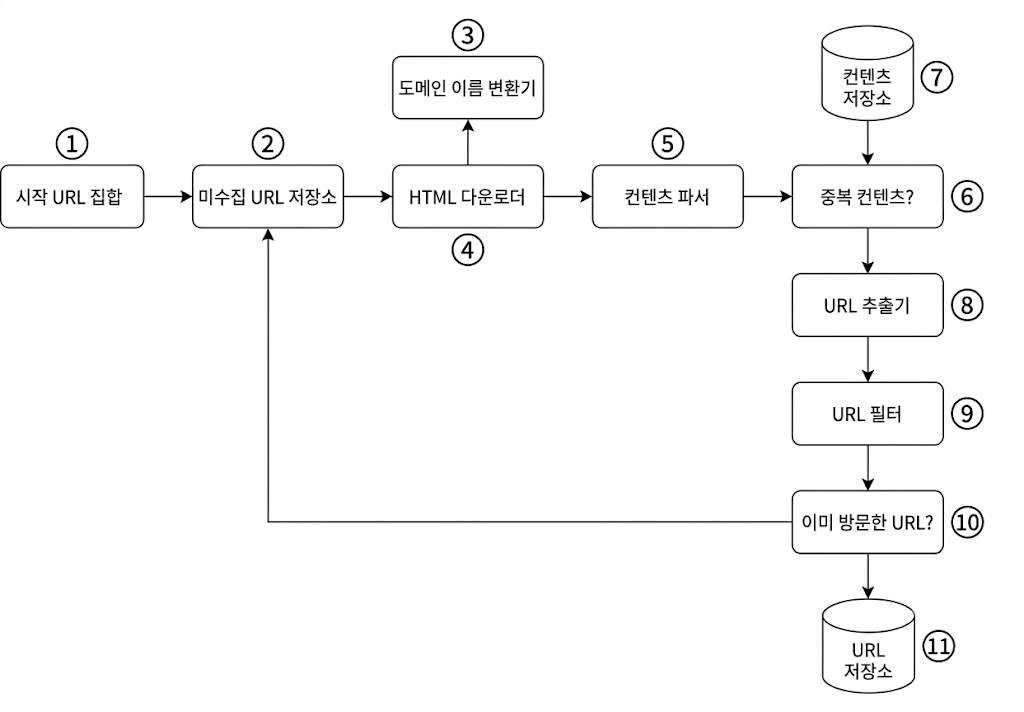
위에서 잠시 확인했던 그림을 다시 보자
-
시작 URL들을 미수집 URL 저장소에 저장한다.
-
HTML 다운로더는 미수집 URL 저장소에서 URL 목록을 가져와 IP 주소를 변환 후 웹 페이지를 다운로드한다.
-
콘텐츠 파서는 다운된 HTML 페이지를 파싱하고 검증하며, 중복 콘텐츠인지 확인 후 저장한다.
-
중복이 아닌 콘텐츠는 URL 추출기로 전달되어 링크를 추출하고, URL 필터를 거친다.
-
필터링된 URL은 URL 저장소에서 이미 처리한 URL인지 확인 후, 저장소에 없는 URL은 URL 저장소와 미수집 URL 저장소에 추가한다.
3단계 상세 설계
개략적 설계안에 따른 컴포넌트와 구현 기술에 대해 생각해보자.
| 항목 | 핵심 내용 |
|---|---|
| DFS vs BFS | 웹은 그래프 구조(페이지=노드, 링크=엣지)로 볼 수 있음. DFS는 그래프가 매우 깊을 경우 부적합. BFS가 일반적으로 널리 쓰이는 크롤링 순회 방식이나, 표준 BFS도 두 가지 문제가 있음: ① 한 페이지에서 나온 링크는 대부분 같은 사이트로 연결되어 예절성 위반 우려, ② URL 우선순위를 고려하지 않음(모든 페이지를 동일한 우선순위로 처리) |
| 미수집 URL 저장소 (URL Frontier) | 위 BFS의 두 문제(예절성, 우선순위)를 해결하기 위한 컴포넌트. 다운로드할 URL을 관리하는 자료구조로, 예절성 관리용 큐와 우선순위 관리용 큐로 구성되며 FIFO 큐 형태 |
| HTML 다운로더 | 실제로 URL 프론티어에서 URL을 가져와 웹 서버로부터 페이지를 다운로드하는 컴포넌트. DNS 확인(Resolver) 등이 관련됨 |
| 안정성 확보 전략 | ① 안정 해시(Consistent Hashing) - 다운로더 서버 부하 분산 ② 크롤링 상태 저장 - 중단 시 재개 가능하도록 진행 상태 및 데이터 저장 ③ 예외 처리 - 오류 발생해도 전체 시스템이 멈추지 않도록 처리 ④ 데이터 검증 - 시스템 오류 방지를 위한 검증 로직 |
| 확장성 확보 전략 | 새로운 형태의 콘텐츠(이미지, PDF 등) 지원을 쉽게 하기 위해, 새 모듈을 플러그인 형태로 끼워 넣을 수 있도록 모듈화·유연한 설계 지향 |
| 문제 있는 콘텐츠 감지 및 회피 전략 | ① 중복 콘텐츠 - 해시/체크섬 비교로 중복 제거 ② 거미 덫(Spider Trap) - 무한 루프를 유발하는 링크 구조 감지 및 회피(예: URL 길이 제한) ③ 데이터 노이즈 - 광고, 스크립트 코드, 스팸 URL 등 크롤링 가치 없는 콘텐츠 제외 |
DFS를 쓸 것인가, BFS를 쓸 것인가
DFS는 그래프가 너무 깊어질 위험 때문에 애초에 쓰지 않고, BFS는 채택하지만 예절성 문제(서버 과부하)와 우선순위 문제(페이지 동급 취급)라는 결함이 있다.
웹 크롤러 설계에서 중요한 컴포넌트와 구현 기술을 심도 있게 살펴본다.
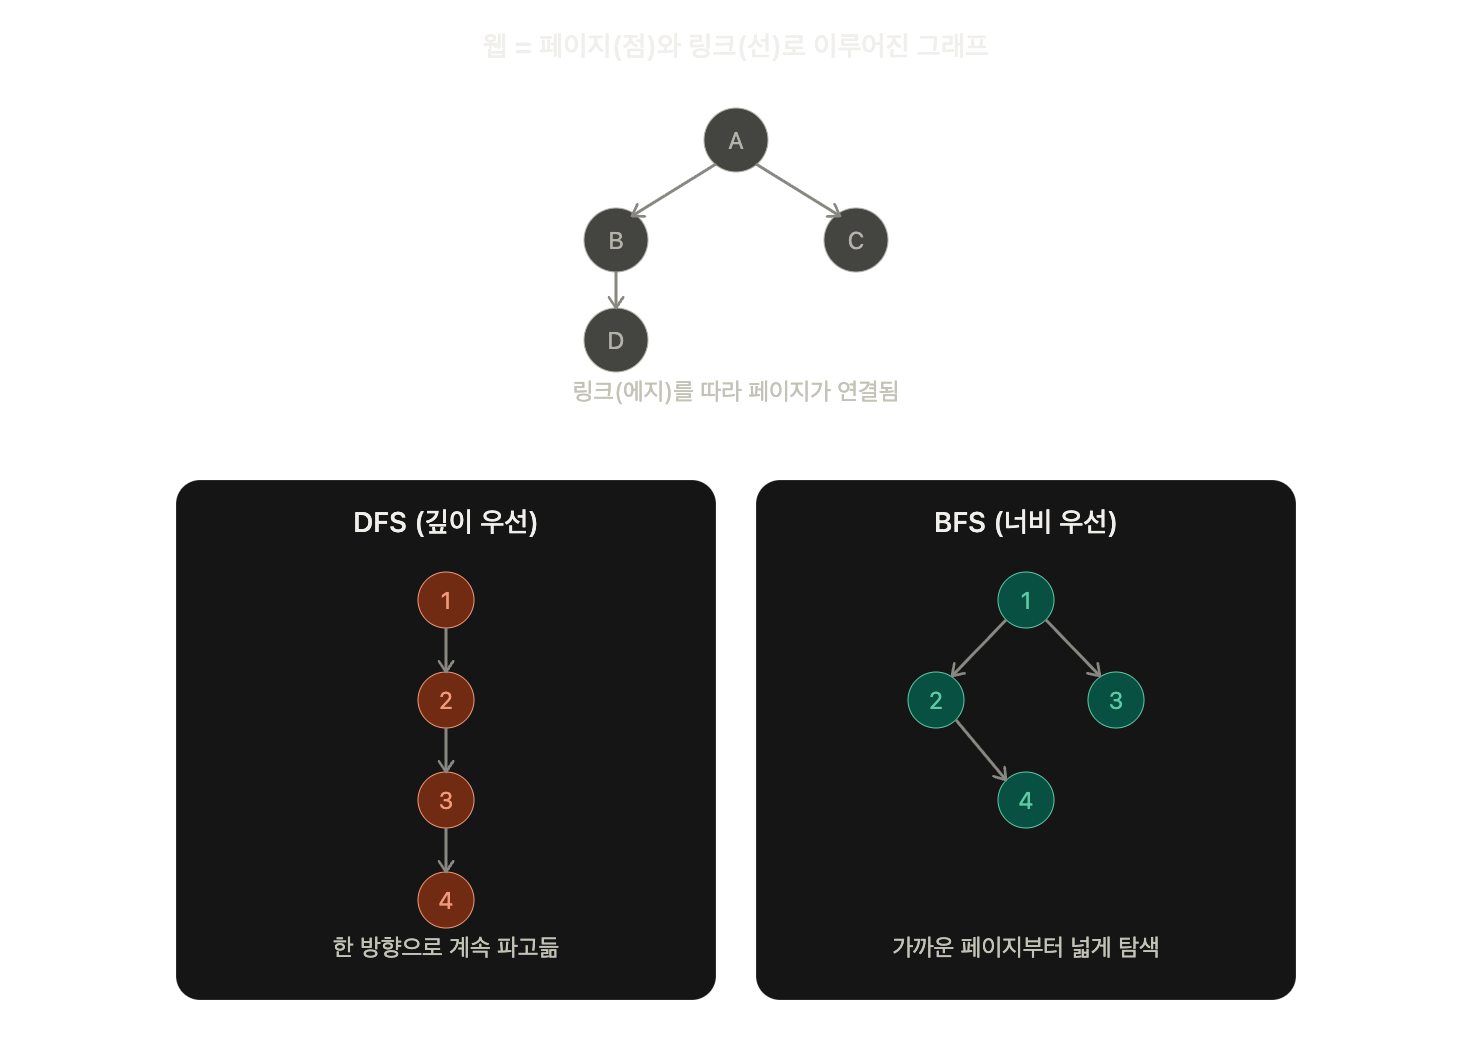
웹은 유향 그래프(directed graph)나 마찬가지다. 페이지는 노드(node), 하이퍼링크(URL)는 에지(edge)로 볼 수 있고, 크롤링은 이 그래프를 에지를 따라 탐색하는 과정이다. 그래프 탐색에는 대표적으로 DFS와 BFS 두 알고리즘이 쓰인다.
DFS(깊이 우선 탐색)는 좋은 선택이 아니다. 그래프 크기가 클 경우 얼마나 깊이 들어가게 될지 가늠하기 어렵기 때문이다.
그래서 웹 크롤러는 보통 BFS(너비 우선 탐색)를 사용한다. BFS는 FIFO(선입선출) 큐를 이용해, 한쪽으로 탐색할 URL을 넣고 다른 쪽으로 꺼내는 방식으로 동작한다. 하지만 이 방식에는 두 가지 문제가 있다.
문제점 1 — 동일 서버 과부하
한 페이지에서 나온 링크의 상당수는 같은 서버로 되돌아간다. 예를 들어 위키피디아(wikipedia.com) 페이지에서 추출한 링크 대부분은 같은 wikipedia.com 서버 내 다른 페이지를 가리키는 내부 링크다. 이런 링크들을 병렬로 한꺼번에 다운로드하면 그 서버에 요청이 몰려 과부하가 걸리게 되고, 이런 크롤러는 '예의 없는(impolite)' 크롤러로 여겨진다.
문제점 2 — 우선순위 부재
표준 BFS는 URL 간 우선순위를 두지 않아 모든 페이지를 동일하게 처리한다. 하지만 실제로는 페이지마다 품질과 중요도가 다르므로, 페이지 순위(page rank), 사용자 트래픽 양, 업데이트 빈도 등의 척도를 반영해 처리 우선순위를 구별하는 것이 합리적이다.
→ 이 두 가지 문제(예절성, 우선순위)를 해결하기 위해 등장하는 컴포넌트가 바로 미수집 URL 저장소(URL Frontier)다.
해결방법부터는 2026을 강타할 최고의 스터디장이 진행할 것.
4단계
+ 이번주 잼얘
프리미엄 대방어 코스를 위한 적금,
대방어 적금을 만들었다.