들어가며
| 문제 | 묻는 질문 |
|---|---|
| Quantization | 왜 분포를 한 값으로 버리는가? → 정보손실 문제 |
| Token/Calibration | probability가 정말 quality probability인가? → 정보손실 문제 |
| Ordinal scale | 정말 0,1,2,3,4,5사이의 거리가 같은가? → Geometry 문제 |
본 문서는 3가지 문제를 다룬다. 문제를 다루기만 할 뿐 뾰족한 해법을 주지 않는다. 문제 삼은 방식은 여전히 사용되며, 어디서는 문제라고 다루지 않을 수 있다. 또한 모든 곳에서 이렇게 쓰지 말자 이런 건 아니다. 어떤 태스크에서는 유용하게 쓰이는 방식이다!!
이 문제 제안 문서 오롯이 문서 작성자(은빈이)의 사견이라는 점을 미리 밝힌다 !
LLM-as-a-Judge의 초기 방식
Rate the response:
0 = terrible
1 = ...
...
5 = excellent
→
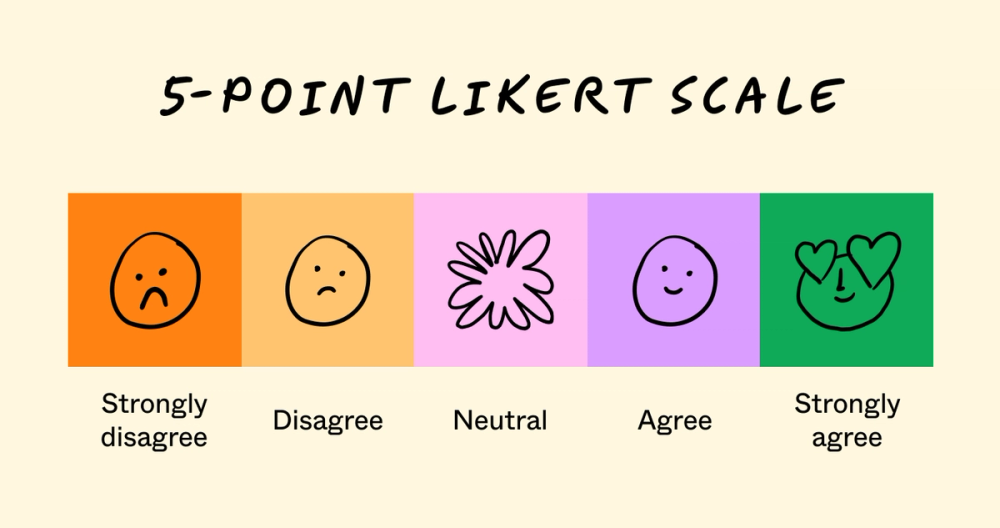
Likert scale
{"score": 4}초기에는 API가 이런 식으로 쓰기 편했을뿐더러, 특히 Closed Model API는 과거 Token logprob, 내부 representation에 접근할 수 없었다. 그래서 생성 모델을 measurement instrument로 사용하는 가장 간단한 interface였다.
Quantisation Loss
사람도 Discrete한 0~5사이의 값을 고를 때 많은 고민을 한다 !
LLM은 어떻게 생각(?)할까?
Prompt:
당신은 어쩌구 평가를 내리는 전문가입니다.
다음 답변의 품질을 0~5 중 하나로 평가하시오!

Score:
최종 출력 → Score: 4
이지만?
출력 직전 → “4일 확률 49%, 5일 확률 48%라고 생각한다”라면? 이 값이 정말 Quality가 4점일 확률이 49%일까?
49%, 48%는 ‘객관적으로 이 답변이 4점일 확률/5점일 확률’이 아니라 이 prompt가 주어졌을 때 다음 score token으로 4와 5를 얼마나 선호하는가” 일 뿐이다.
Uncertainty / Margin Loss
마지막 layer에서 hidden state 를 계산한다. 이후 Vocab Projection을 진행하며, 가 되고, 여기서 이고 vocabulary에 있는 모든 token 하나하나에 logit이 생긴다.
token       logit  # Logit 자체는 확률이 아니다. unnormalized score

"0"        -2.3
"1"        -1.7
"2"        -0.8
"3"         1.0
"4"         5.02
"5"         5.00
"Yes"       0.4
"The"       0.1
"\n"        0.8
...
→ 여기서 Softmax 함수를 거쳐 확률값으로 변한다
Where is Temperature
Score 4일 확률 49%?
관심 없는 다른 토큰은 버리고 Score Token만 놓고는 Normalise를 진행한다.
⇒ valid score token 중에서 4에 49%, 5에 48%의 conditional token probability를 배정했다
| Score | probability |
|---|---|
| 0 | 0.1% |
| 1 | 0.2% |
| 2 | 0.7% |
| 3 | 2.0% |
| 4 | 49.0% |
| 5 | 48.0% |
기존 Judge방식은 이 모든 걸 버린다
일반적 generation은 이기에 결과는 로 도출된다.
Case A
Case B
임에도 불구하고 두 결과 모두 로 된다
이 결과를 그대로 사용하는 평가 방식에는 큰 Information Compression이 존재한다. 그러니까, 이 행위로 인해 ranking, confidence, uncertainty, reward 등 너무 많은 정보가 버려진다.
쉽게 말하자면 Decision boundary와의 거리를 버린다.
Tie Explosion
quantization의 downstream consequence
100개의 candidate가 있다고 가정해보자.
candidate 1 → 5
candidate 2 → 5
candidate 3 → 4
candidate 4 → 5
candidate 5 → 4
...
앞서 언급한 Quantisation의 결과. 로 크게 tie된다. 후보가 많아지면 6개의 Bucket밖에 없으므로 Ranking Resolution이 매우 낮아진다.
Retrieval / best-of-N / agent trajectory selection 과 같은 Task 시 특히 0~5 hard label이 특히 불편하다. 결국 원하는 평가는 의 fine ordering이기 때문이다.
Tokenisation / Verbaliser bias
LLM에서 숫자는 Language Token일 뿐이다. 0에서 5사이의 값은 Abstract Numerical Classes가 아니다.
카테고리: 0, 1, 2, 3, 4, 5👧(사람): 6개 카테고리군… 흠냐
🤖(LLM): Pretrained Language Token이라서 Tokeniser, Verbaliser, Token Prior, Temperature의 영향을 받음
“4”, “ 4”, “, 4”, “\n4”일 수도 있고, 모두 동일한 방식으로 Tokenize된다는 보장도 전혀 없다.
"4" → [token_4] 와 "17" → [token_1, token_7] 로 될 수도 있다… 이렇게 되면 는 한 번의 next-token probability 이며, 은 로 된다.
따라서 와 이 뒤엉킨다.
A~E라고 해도 모델은 A~E를 균등한 abstract class로 배우지 않았다. 특정 Letter/ Token이 원래 더 자주 등장할 수도 있고, 숫자 역시 마찬가지다.
Judge에서 이상적으로 보고싶은 것은
지만, 이런 형태로 관찰할 경우
로 진행된다. 이 둘은 절대 같지 않다. 다르다 !
Score 4일 확률 49%? 또한
- 실제 사람들은 보통 49%의 확률로 4점을 주더라~
- 진짜 4점짜리 퀄리티일 객관적 확률 49%
모두 아니다.
그냥 !
Temperature 역시 영향을 준다 !
이전에 언급했듯이 Softmax에 Temperture 영향이 가해진다.
예를 들어 일 때,
이라면,
이라면,
로 Distribution이 훨씬 뾰족해진다. 반대로 이라면, 분포가 평평해진다.
그래서 score-token probabilities를 이용하려면 Generation Sampling Temperature와 Probability Extraction의 의미를 명확히 통제해야 한다.
Ordinal Scale Problem
LLM이나 사람이나 똑같이 생기는 문제
0 = 매우 나쁨
1 = 나쁨
2 = 조금 나쁨
3 = 보통
4 = 좋음
5 = 매우 좋음
0부터 5까지의 값이 다음과 같이 나누어질 때, 각 값은 정확히 순서가 보장된다( ).
하지만 이것만으로는 을 알 수 없다. 즉, 5와 4의 심리적 차이가 4와 3의 차이와 같다고 보장할 수 없다.
사람도 똑같다.
Score 0 → quality 0
Score 1 → quality 10
Score 2 → quality 20
Score 3 → quality 40
Score 4 → quality 70
Score 5 → quality 100
사람의 머릿속 Quality가 다음과 같이 대응된다면,
0→1 : +10
1→2 : +10
2→3 : +20
3→4 : +30
4→5 : +30
숫자는 1씩 증가하지만, 실제 의미 간격은 다르다.
즉, Ordinal Scale에서 “5가 4보다 좋다” 는 자연스럽지만, “5는 4보다 정확히 1만큼 좋다”는 부자연스럽다.
이게 왜 문제야?
답변 A, B, C의 값이 각 5, 4, 3일 경우 로 평균을 내거나 혹은 모델 A의 평균 = 4.31, 모델 B의 평균 4.17로 비교한다.
이 순간 암묵적으로 이라는 Interval-scale 가정을 한다.
원래 0~5 Rubric이 단순 Likert-style Ordinal Categories 였다면 이 가정은 성립하지 않지만, 숫자 자체를 의미 있는 연속량처럼 계산하는 것이 정당한가? 라는 측정론(measurement theory) 문제다.
끝으로
Ordinal 방식보다 앞서 말한 Logit Expectation 방식이 더 많은 Distribution 정보를 보존한다는 점에서 분명히 더 나은 방법이다. Softmax expectation이 Quantization 문제는 완화하지만 Ordinal-Scale 문제까지 해결하는 것은 아니다. 즉, argmax로 4 하나만 쓰는 것보다 distribution 정보를 더 많이 보존한다는 점에서는 분명히 낫지만, 여전히 , 를 같은 크기의 이동이라고 가정하고 있다.
