DNA language models are powerful predictors of genome-wide variant effects
INTRODUCTION
GWAS 연구가 많이 축적되면서, 어떤 유전자 부위가 특정 형질이나 질병과 관련 있는지 점점 더 많이 알려지고 있다. 하지만 GWAS는 보통 "이 근처가 관련 있다"는 연관성(linkage)를 보여줄 뿐, 그 안에 있는 수많은 변이 중 causal variant (진짜 원인인 변이)가 무엇인지 알려주지 못한다.
기존에는 하나하나 실험을 통해 검증해야 했지만 이는 시간과 비용이 많이 들게 되었고 어떤 변이가 더 중요할 가능성이 높은지 계산적으로 먼저 걸러낼 수 있는 방법을 찾는게 중요해졌다.
그래서 computational variant effect predictor가 사용되었다. 그렇다면 이 논문에서 제안하는 방법 이전에 사용되던 non-coding variant effects prediction method들은 무엇이 있을까?
- Functional genomics 예측 기반 모델
e.g. DeepSEA, Enformer, Sei
- DNA 서열을 입력으로 받아 functional genomics 데이터를 예측함.
- reference sequence와 variant sequence에서 예측되는 functional genomics signal의 차이로 variant effect를 평가함.
⚠️ 대량의 functional genomics 데이터가 필요함 ▶️ 많은 생물종에 적용하기 어려움
- Variant type-specific 모델
특정 variant 종류만 예측하는 모델
| 예시 | 설명 |
|---|---|
| Splicing variant | - sequence만 이용 - intron variant가 splicing 패턴에 미치는 영향 예측 |
| Regulatory sequene classifier | - SVM - regulatory sequence vs random sequence |
| 3D genome structure prediction | - sequence로 Hi-C signal 예측 - variant가 DNA folding에 미치는 영향을 분석 |
| DNA methylation prediction | sequence로 CpG methylation level 예측 |
⚠️ variant 종류별로 따로 모델이 필요함 ▶️ 서로 비교가 불가능(e.g. 환자에서 missense variant, promotor variant가 둘 다 있을 때 어느 것이 더 중요한지 비교 못함)
⚠️ rare variant detection, fine-mapping, polygenic score 계산에서 불리함 ▶️ genome-wide(저네 genome에 있는 variants를 동시에 비교하는 것) 비교가 필요함
- Conservation 기반 점수
e.g. phyloP, phastCons
- 여러 종의 genome alignment 이용
- 진화적으로 보존된 위치가 기능적으로 중요하다 판단함
⚠️ variant effect를 직접 학습하지 못함 ▶️ 단순히 evolutionary conservation만 반영
⚠️ alignment quality에 의존
⚠️ lineage-specific 기능 탐지 어려움
- 통합 variant predictor
e.g. CADD
- conservation과 functional genomics annotation을 합쳐서 begin vs pathogenic variant를 분류함
⚠️ human 중심 모델
⚠️ annotation 데이터 의존
이러한 한계를 극복하기 위해 본 논문에서는 DNA 서열만을 이용하여 genome-wide variant effect를 예측할 수 있는 모델인 GPN (Genomic Pre-trained Network)을 제안한다. GPN은 multispecies genome sequence를 이용한 self-supervised pretraining을 통해 학습된 DNA language model로, functional genomics 데이터 없이도 variant effect를 예측할 수 있다.
Method
Training a Multispecies DNA Language Model
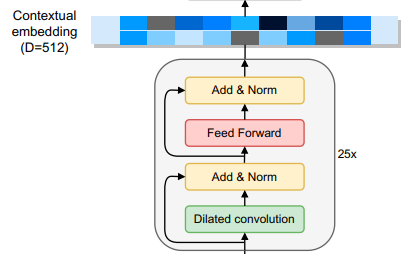
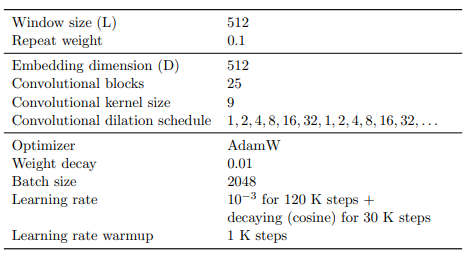
애기장대(A.thaliana)와 Brassicales 목(order)에 속하는 7개의 근연종의 unaligned reference genomes를 사용하여, CNN 기반 언어 모델을 사전 학습하였다.
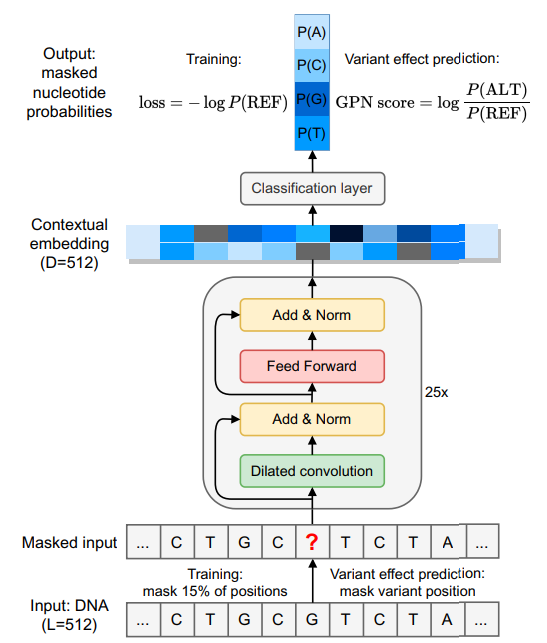
이 모델은 local genomic context를 조건으로 하여 masked nucleotides를 예측하도록 설계되었다.
CNN으로 어떻게 문맥을 이해할 수 있을까?
e.g. DNA sequence : C T G T A T G T A & kernel_size = 3이라고 가정하자
기존 CNN의 동작은 다음과 같다
- (C T G) T A T G T A
- C (T G T) A T G T A
- C T (G T A) T G T A
이런 식으로 주변 kernel_size개의 문자로 현재 위치의 특징을 계산한다. 한 층만 사용하면 문맥이 작으므로 CNN을 여러층을 쌓아 문맥을 확장했다.
하지만, 기존 방법처럼 문맥을 확장하면 넓은 문맥은 보지 못하고 좁은 문맥만 볼 수 있다. 그래서 dilated convolution을 통해 넓은 문맥을 포함해서 본다.
layer마다 다른 dilation을 줘서 서로 다른 넓이의 문맥을 보도록하여 문맥을 잘 이해할 수 있게 한다.Diltation
e.g. DNA sequence : C T G T A T C T A & kernel_size = 3
- normal convolution = C T G
- dilation convolution(=2) = C T C
유전체에는 같은 패턴이 반복되는 DNA가 많다. 이는 기능이 있을 수도 있지만 유전체에서 너무 많이 존재한다. 하지만 실제 연구에서 관심 있는 영역은 보통 gene, promotor, enhancer, regulatory region으로 대부분 nonrepetitive region이다.
DNA LM은 prediction loss를 최소화하도록 학습하는데 반복 서열이 많으면 모델은 자연스럽게 반복 서열을 잘 맞추는데 집중하게 되어 중요한 nonrepretitive region 학습이 약해지게 된다.
그래서 repetitive region에서 발생하는 loss의 weight를 줄여 모델이 nonrepetitive region을 더 중요하게 학습하도록 하였다.
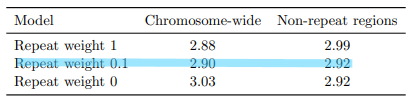
Perplexity
모델이 다음 문자를 얼마나 헷갈려 하는지에 대한 지표
- 낮은 perplexity ▶️ 모델이 잘 예측
- 높은 perplexity ▶️ 모델이 헷갈림
Unsupervised Clustering of Genomic Regions
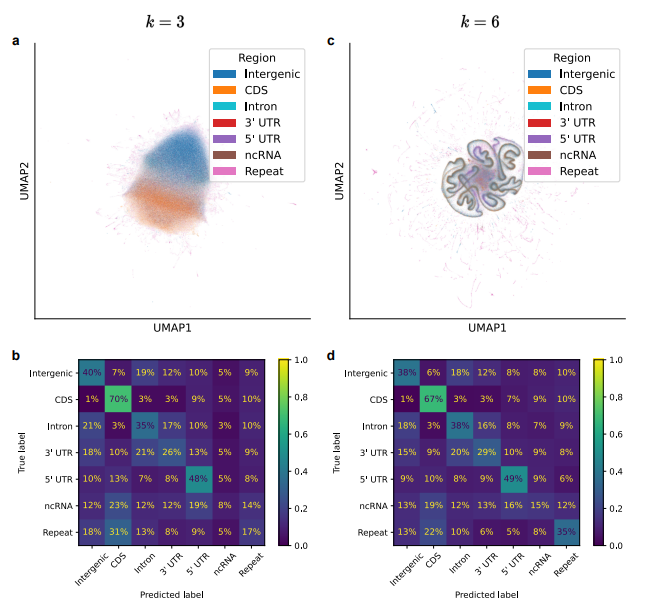
모델이 유전체의 구조를 얼마나 잘 학습했는지를 이해하기 위해, 참조 유전체에서 100bp 윈도우 단위로 뉴클레오타이드에 대한 GPN의 contextual embeddings(512차원)을 평균낸 뒤, 이를 UMP(32)을 사용해 시각화하였다.
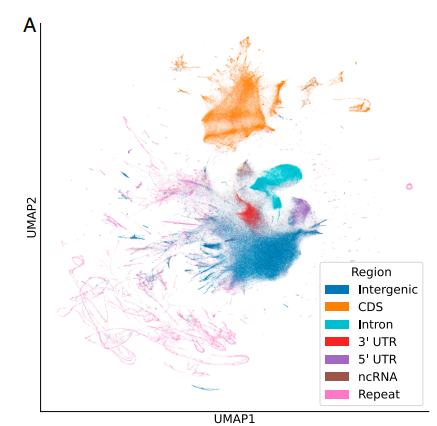
unsupervised로 학습된 GPN이 이미 유전자 사이 영역(intergenic), 인트로(introns), 코딩 서열(CDS), 비번역 영역(UTR), 그리고 non-coding RNA와 같은 유전체 영역을 구분하는 법을 학습했다는 것이다.
GPN이 이러한 유전체 영역을 얼마나 잘 구분하는지 정량적으로 평가하기 위해, 평균 임베딩을 feature로 사용하는 로지스틱 회귀 분류기를 학습시켰다.
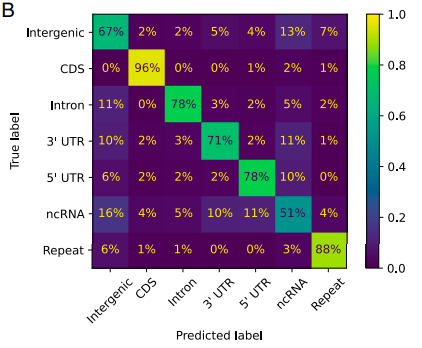
위 수준의 정확도는 단순히 k-mer 빈도만으로는 달성할 수 없다.
((a,b) k =3, (c,d) k = 6)
DNA Motifs Revealed by High-Confidence Model Predictions
유전체의 각 위치를 하나씩 개별적으로 마스킹한 뒤, 해당 위치의 뉴클레오타이드에 대해 모델이 예측하는 output distribution을 얻었다.

위 이미지에서 Sequence Logo는 해당 뉴클레오타이드의 예측 확률에 비례하며, 전체 높이는 비트 단위로 측정되는 정보량으로 나타남.
모델의 예측 신뢰도는 해당 위치의 expected functionality와 상관관계를 보인다.
-
Exon Positioin
엑손 위치는 주변 인트론보다 더 높은 신뢰도로 예측된다.(except in canoical splice acceptor and donor dinucleotide motifs) -
Codon
일반적으로 아미노산 정체성에 영향을 주지 않는 세 번째 뉴클레오타이드(CDS3)가 첫 번째와 두 번째 위치(CDS1, CDS2)보다 더 낮은 신뢰도로 예측됨. Start codon과 stop codon motif 역시 대체로 잘 예측됨
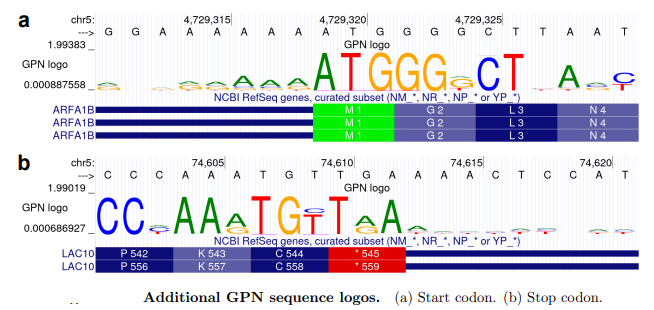
테스트 염색체의 1Mb 구간을 분석해봤다. 264개 유전자와 471개 전사체가 포함되었다.
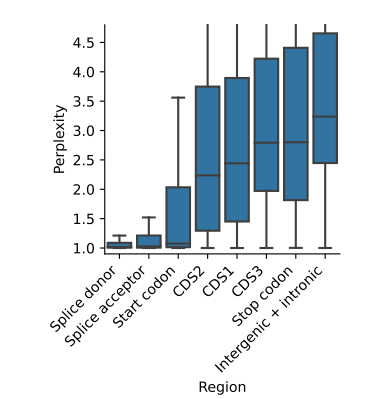
결과를 보면 기능적으로 중요한 영역(Splice donor, Splice acceptor, Start codon, CDS2, CDS1, CDS3, Stop codon)의 median preplexity는 intergenic + intron 영역보다 유의하게 작았다. 또한 CDS(단백질 코딩 영역)에서도 차이가 보였다.(CDS2 < CDS2 < CDS3)
이러한 결과는 기능적으로 중요한 위치일수록, DNA 서열이 강하게 보존되어 있고 모델이 더 쉽게 예측이 가능함을 의미한다. 즉, 생물학적 evolution constraint가 큰 영역일수록 perplexity가 낮음을 시사한다.
이를 통해서 promoter 영역에 GPN이 높은 점수를 주는 짧은 DNA 구간은 transcription factor binding sites일 가능성이 있다고 생각할 수 있다. transcription factor binding sites는 기능적으로 중요한 서열이므로 모델이 높은 confidence로 예측할 가능성이 있기 때문이다.
이를 확인하기 위해 TF-MoDISco를 변형하여 사용하였다
TF-MoDISco
1.높은 점수를 가진 DNA 구간 추출
2. 비슷한 서열을 motif로 군집화
3. 이를 기존 motif database와 비교
promoter 영역에서 분석한 결과 약 160개의 motif가 발견되었으며 그 중 4개는 다음과 같았다.
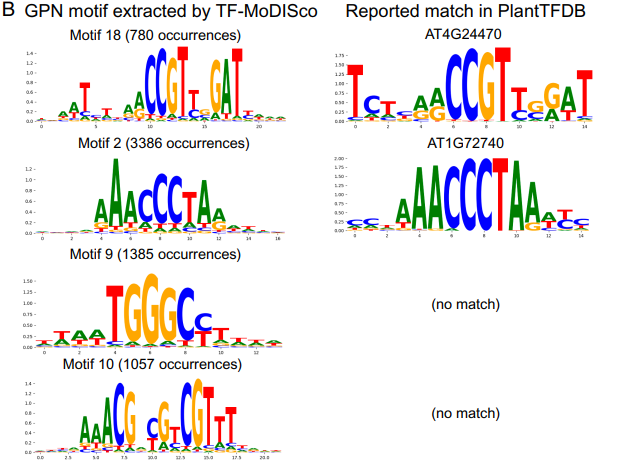
결과를 보면 첫번째와 두 번째 motif가 plantTFDB와 유의하게 일치하였다. ( in Tomotom) 또한 일부 motif(세번째 motif)는 데이터베이스에서는 매칭되지 않았지만 문헌에서는 이미 알려진 motif들도 있었다. 그리고 일부 motif(4번째 motif)는 새로운 promoter 요소일 가능성을 제시한다. 이 motif들은 회문형 구조와 대칭적인 entropy를 보여주며 RNA 또는 DNA의 대ㅔ 이차 구조를 형성할 가능성을 시사한다.
Unsupervised Variant Effect Prediction
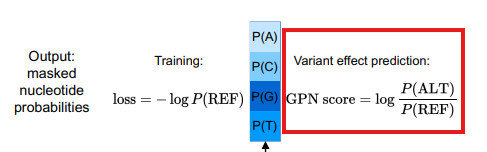
GPN은 genome 내 모든 SNP에 대해, alternate allele와 reference allele 사이의 log-likelihood ratio를 이용해 pathogenicity 또는 functionality 점수를 계산하는데 사용할 수 있다. 이는 Logo plot에서 각 문자 높이를 비교하는 것에 해당한다.
In silico mutagenesis
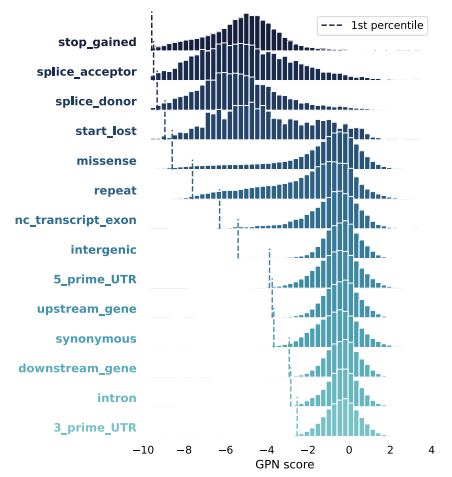
1Mb 구간 내 SNP들에 대해 인 실리코 돌연변이 유발을 수행하여 GPN 점수를 계산하고, 그 결과를 위 이미지처럼 변이 유형별로 집계하였다. 변이 유형의 순위는, 일반적으로 잘 알려진 유해성(deleteriousness)에 대한 기존 개념과 일치했다.
(e.g. 가장 낮은 점수를 받은 네 가지 변이 유형 splice donor, splice acceptor, stop gained, start lost 변이 ▶️ open reading frame을 크게 교란시킴)
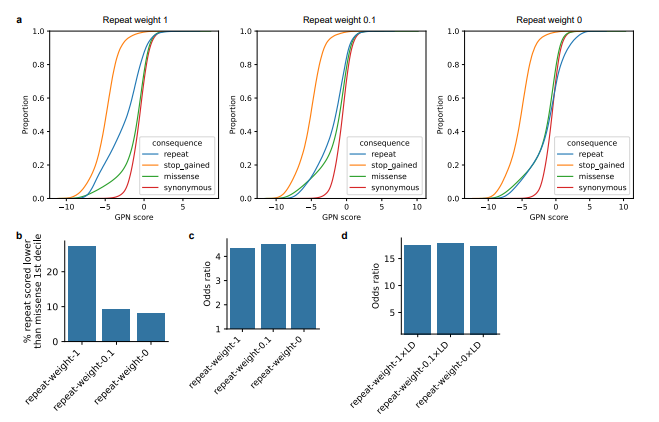
Missense variant(단백질 아미노산을 바꾸는 변이)가 Synonymous variant(아미노산이 바뀌지 않는 변이)보다 더 큰 영향을 미치는 것으로 예측되었다. 하지만 일부 Repetitive elements 내부의 변이들이 매우 낮은 GPN 점수가 되었고 이는 모델 학습 시 반복서열에 부여한 가중치에 영향을 받았음을 보여주었다. 이 문제는 반복서열에 대한 학습 손실 가중치를 설정하므로 해결할 수 있다.
Enrichment of GWAS hits in regions with low GPN scores
1001 Genomes Project의 자연적으로 존재하는 accession들로부터 얻은 1천만 개가 넘는 SNP를 분석하였다.
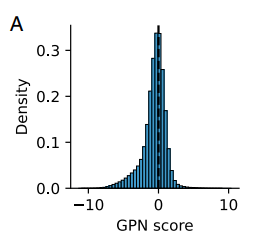
대부분의 변이는 중립적인 GPN 점수를 가지지만, 음의 GPN 점수를 보이는 putative functional variants가 두꺼운 고리를 형성하고 있음을 보인다.
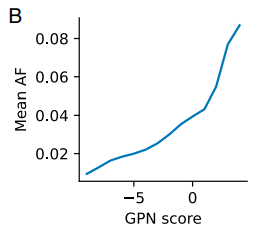
특히, GPN 점수가 더 낮은 변이일수록 평균적으로 집단 내 빈도가 더 낮았는데, 이는 이러한 변이들이 purifying selection을 받고 있을 가능성을 시사한다.
putative functional variants를 식별하기 위해, genome 전반의 점수 분포 꼬립 부분에서 희귀 변이와 흔한 변이의 enrichment를 평가하였다.
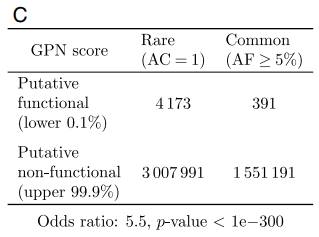
잠재적 가능성 SNP를 GPN 점수 하위 0.1%로 정의했을 때, 이들은 희귀 변이에서 5.5배의 농축을 보였다.

GPN을 기존 변이 효과 예측 방법인 phyloP와 phastCons와 비교하였다. GPN의 성능이 우수했으면, GPN 점수와 기존 conservation 기반 점수의 상관관계를 비교했을 때 둘다 낮았으며 이는 GPN은 기존 conservation 방법과 다른 정보를 포착함을 확인할 수 있었다.
GPN의 주목할만한 장점은, whole-genome alignment의 실패로 인한 phyloP와 phastCons가 점수를 부여할 수 없었던 변이들에도 점수를 매길 수 있다는 점이다.
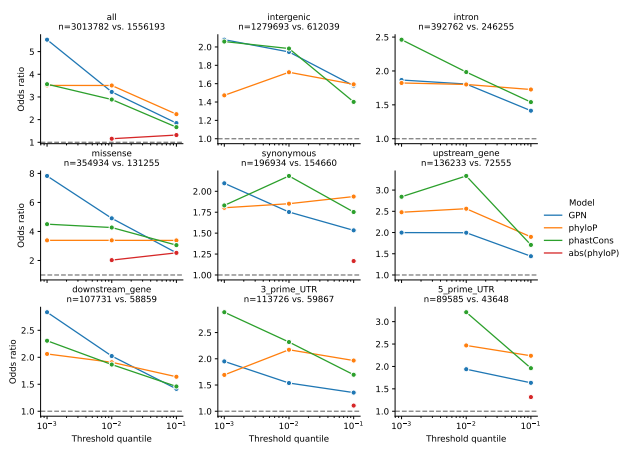
잠재적 기능성 SNP를 정의할 때 덜 엄격한 임계값을 사용하면, GPN은 phyloP 및 phastCons와 비슷한 수준의 성능을 보였으며, 이는 극단적인 꼬리 부분에 존재하는 유해 변이를 탐지하는 데 GPN이 강점을 가짐을 시사한다.
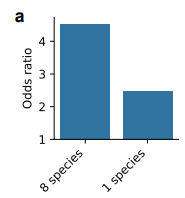
GPN은 특정 변이 클래스 내부에서만 계산했을 때도 유의미한 odds ratio를 달성했지만, phyloP와 phastCons와 비교한 상대적 성능은 경우에 따라 달랐다. 한편, 반복서열에 대해 중간 수준의 손실 가중치를 사용해 학습한 GPN 모델은 약간 더 높은 odds ration를 달성했고,
반대로, 단일 종만으로 학습한 모델의 성능은 상당히 더 낮았다
Enrinchment of GWAS hits in regions with low GPN scores
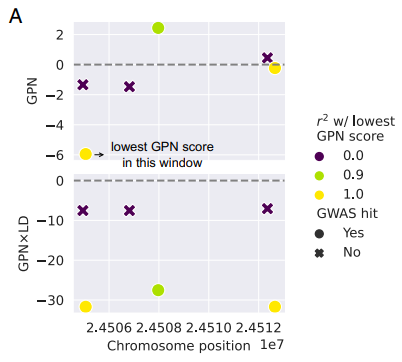
A.thaliana의 GWAS를 종합적으로 정리한 데이터베이스인 AraGWAS Catalog를 조사하였다. GWAS 히트가 낮은 GPN 점수를 가지는 영역에 enrinchment되어 있을 것이라고 가정했다.
GPN의 장점 중 하나는 서로 강한 linkage disequilibrium에 있는 변이들이라 하더라도 주변 문맥이 다르면 상당히 다른 점수를 부여할 수 있다는 점이다. 반면, 표준 GWAS는 이런 변이들에 비슷한 점수를 주게 된다.
이 차이를 반영하기 위해, GPN 점수에 LD를 가중한 GPN x LD라는 점수를 고안하였고, 이 접근법을 사용하면, GPN x LD는 GWAS 히트와 비히트를 효과적으로 구별한다.
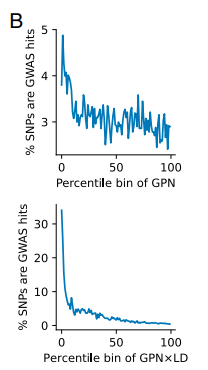
보다 일반적으로, 게놈 전체와 모든 형질을 걸쳐 보았을 때, GPN x LD 점수 분포의 꼬리 부분은 GWAS 히트에 크게 농축되어 있었으며, 이는 원래의 GPN 점수 분포 꼬리보다 훨씬 더 강했다.
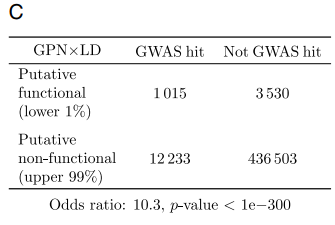
특히 odds ratio를 분석한 결과
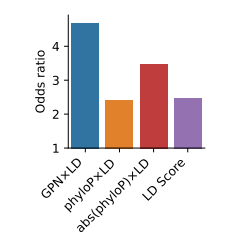
GPN x LD 점수 하위 1%에 속하는 SNP들은 상위 99%에 비해 GWAS 히트에서 10.3배 농축되어 있었고, 다른 방법들에서는 7.5배 미만의 농축만이 관찰되었다
AraGWAS에서 권장하는 permutation 기반 유의성 임계값 대신 Bonferroni 보정을 사용할 경우, 모든 방법에서 odds ratio는 더 낮아졌지만, GPN x LD는 여전히 가장 높은 노욱도를 달성했다.
반복서열에 대해 중간 수준의 손실 가중치를 사용해 학습한 GPN 모델이 가장 좋은 성능을 보였다.
단일 종만으로 학습한 모델은 더 낮은 성능을 보였다.
Discussion
이 연구에서는 DNA 언어모델의 사전학습을 기반으로 한 비지도 방식의 전장 유전체 변이 효과 예측기인 GPN을 제시하였다. 연구 결과, GPN은 식물 모델 생물인 Arabidopsis thaliana에서 기존의 게놈 전반 변이 예측 방법보다 더 우수한 성능을 보였다. 특히 GPN은 DNA 서열만으로 학습되기 때문에 기능 유전체 데이터가 부족한 비모델 생물에도 적용할 수 있다는 장점이 있다.
연구진은 GPN을 일종의 “일반화된 보존성 점수”로 설명한다. 기존 방법인 phyloP와 phastCons가 특정 위치의 염기 빈도를 기반으로 보존성을 평가하는 것과 달리, GPN은 유전체 전반에서 유사한 서열 문맥의 염기 분포를 학습한다. 또한 whole-genome alignment에 의존하지 않기 때문에 비코딩 영역에서도 안정적으로 변이를 평가할 수 있다.
GPN 점수는 게놈 전체 변이를 동일한 척도로 평가할 수 있어 희귀 질환 분석, fine-mapping, polygenic risk score와 같은 다양한 유전체 연구에 활용될 수 있다. 또한 GPN 예측을 TF-MoDISco와 결합하면 전사인자 결합 부위와 같은 기능적 DNA 모티프를 발견하는 데 도움이 될 수 있다.
한편 반복서열은 DNA 언어모델에서 어려운 문제를 만든다. 반복서열은 게놈에서 과도하게 많이 존재하고 변이도 적기 때문에 모델이 이를 과도하게 학습할 수 있다. 연구에서는 반복서열의 학습 가중치를 낮추는 방법을 제안했지만, 반복서열의 종류나 연령에 따라 가중치를 조정하는 추가 연구가 필요하다고 제안하였다.
마지막으로, 현재 GPN 모델은 단백질 언어모델에 비해 훨씬 작은 규모이므로 더 큰 모델과 더 많은 학습 데이터를 사용하면 성능을 더 향상시킬 수 있을 것으로 예상된다. 또한 DNA 특이적 구조나 장거리 유전체 정보를 모델에 통합하는 방법도 향후 중요한 연구 방향으로 제시되었다.