TamGen: drug design with target-aware molecule generation through a chemical language model
Introduction
생성형 약물 설계는 기존의 화합물 라이브러리에서 후보를 찾는 스크리닝 방식과 달리, 원하는 특성을 가진 새로운 분자를 처음부터 생성하는 접근법이다. 기존 스크리닝이 주로 (10^4\sim10^8) 규모의 화합물 라이브러리를 탐색한다면, 생성 모델은 이론적으로 (10^{60})개 이상으로 추정되는 방대한 화학 공간을 탐색할 수 있다. 따라서 알려진 hit compound가 없거나 기존 약물에 대한 내성이 발생한 표적에서도 새로운 화합물 구조를 찾을 가능성이 있다.
최근에는 autoregressive model, GAN, VAE, diffusion model 등 다양한 생성 모델을 활용하여 표적 단백질 정보를 조건으로 새로운 화합물을 생성하는 연구가 활발히 진행되고 있다. 하지만 생성된 분자가 높은 활성을 예측하더라도 실제 합성이 어렵거나 적절한 물리화학적 특성을 갖지 못하는 경우가 많아, 실험적 검증까지 이어지는 사례는 상대적으로 제한적이다.
이를 해결하기 위해 제안된 TamGen(Target-aware Molecular Generation)은 GPT와 유사한 화학 언어 모델을 이용해 drug-like compound를 생성한다. 분자를 문자열 형태인 SMILES로 표현하고, GPT 기반 autoregressive 모델을 통해 새로운 분자 구조를 생성한다. 또한 표적 단백질 구조와 화합물 정보를 각각 처리하는 모듈을 도입해 두 가지 기능을 수행한다.
- Target-aware generation: 단백질 구조 정보를 조건으로 새로운 화합물 생성
- Molecular refinement: 기존 seed compound를 기반으로 구조를 개선하여 후보 화합물 탐색
TamGen은 단순히 새로운 분자를 생성하는 것에 그치지 않고 약리학적 활성과 합성 접근성 사이의 균형을 고려하도록 설계되었다. 연구진은 이를 결핵균 Mycobacterium tuberculosis의 단백질 분해에 중요한 ClpP(Caseinolytic protease P) 표적에 적용하였다.
그 결과 Design–Refine–Test 파이프라인을 통해 14개의 활성 후보 화합물을 발견했으며, 이들은 1.88–35.2 μM 범위의 IC50을 나타냈다. 특히 생성된 화합물은 새로운 hit 후보를 제공하는 것뿐만 아니라 이후 hit expansion과 SAR(Structure–Activity Relationship) 연구를 위한 출발 구조(anchor)로 활용될 수 있다는 점에서 의미가 있다.
즉, TamGen은 단백질 구조를 직접 조건으로 활용해 새로운 분자를 생성하고, 실제 합성과 생물학적 실험 검증까지 연결했다는 점에서 표적 기반 생성형 약물 설계의 실용적 가능성을 보여준 연구라고 볼 수 있다.
Method
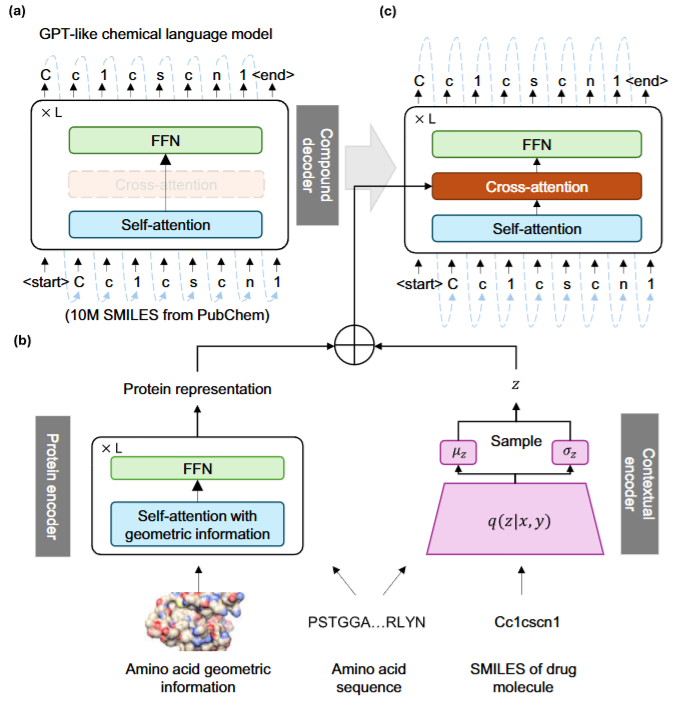
- : 결합 포켓을 구성하는 아미노산 (전체 아미노산이 아님!)
- : 결합 포켓을 구성하는 아미노산의 3D 좌표
- : 시퀀스 길이
- : 아미노산 의 중심 좌표
- 는 one-hot 벡터로, 벡터의 길이는 20(가능한 아미노산 종류의 수)
- : 결합 포켓
- : ligand / compound의 길이 인 SMILES 문자열
Processing 3D input
모든 아미노산 는 embedding layer 를 통해 차원 벡터로 매핑된다. 좌표 는 linear mapping을 통해 차원 벡터로 매핑된다.
단백질 구조를 3D 공간에서 회전시키거나 이동시켜도 본질적인 구조는 변하지 않으므로, 좌표에 data augmentation을 적용한다.
- : 학습 가능한 행렬로 모델 학습 과정에서 최적화
- : 좌표를 원점으로 이동
- : 무작위 회전-이동 연산으로 좌표에 무작위로 회전과 이동을 적용하여 augmentation
따라서 이산 입력 를 개의 연속적인 hidden representation 으로 변환한다.
Protein encoder
binding pocket에서는 sequence 상 멀리 떨어진 residue라도 실제 3D 구조에서 가까울 수 있으므로 아미노산의 공간적 거리를 모델링하기 위해 distance-aware attention을 제안한다.
마지막 블록의 출력인 가 인코더에서 얻어진 의 최종 표현이다.
Contextual encoder
다양한 생성을 촉진하기 위해 VAE 프레임워크를 따르며, 동일한 입력에 대해 다양한 생성을 제어하기 위한 확률 변수 를 사용한다.
단백질 결합 포켓 가 주어지면 화합물 는 분포 에 따라 샘플링된다.
VAE encoder(표준 Transformer encoder 아키텍처)의 입력으로는 protein과 ligand를 같이 넣어준다.
ligand는 3D 정보가 제공되지 않으므로 distance-aware 방식이 아닌 vanilla self-attention layer를 사용한다.
마지막 블록의 출력은 linear mapping을 통해 각 위치 의 평균 와 공분산 행렬 로 매핑된다.
이때 ligand representation, 즉 인 는 를 구성하는 데 사용되지 않는다.
Chemical language model
PubChem에서 무작위로 선택한 1,000만 개의 화합물을 사용하여 다음 목적함수로 decoder를 사전학습한다.
이를 통해 decoder가 protein 정보 없이도 기본적인 chemical grammar와 drug-like molecular pattern을 먼저 학습하도록 한다.
chemical language model의 사전학습 이후 compound decoder에 cross-attention module을 추가한다. 이 cross-attention은 protein encoder의 최종 출력인
을 입력받아, SMILES를 생성할 때 binding pocket 정보를 참고할 수 있도록 한다.
VAE를 사용하는 경우에 protein encoder의 출력 에 contextual encoder가 생성한 latent variable 를 더한 값을 cross-attention 입력으로 사용한다.
학습 및 compound refinement에서는 실제 ligand 가 존재하므로 에서 latent vector를 샘플링하고, 를 cross-attention에 입력한다.
반면 de novo inference에서는 정답 ligand 가 없으므로 를 계산할 수 없으므로, prio distribution인 에서 latent vector를 무작위 샘플링 한 뒤 를 cross-attention의 입력으로 사용한다.
Training
첫 번째 항은 모델이 입력 pocket을 기반으로 합리적인 ligand를 생성하는 방법을 학습하도록 한다. 두 번째 항인 KL divergence constraint는 학습된 latent space가 prior distribution 와 유사해지도록 하며, 이를 통해 smooth interpolation과 generalization을 촉진한다.
이는 approximate posterior distribution, 즉 encoder의 출력을 prior distribution, 일반적으로 단순한 Gaussian에 가깝게 유도함으로써 encoder를 regularize한다
Results
TamGen design novel inhibitors targeting Tuberculosis ClpP protease
저자들은 TamGen의 실제 drug discovery 적용 가능성을 검증하기 위해 Mycobacterium tuberculosis(Mtb)의 ClpP protease를 표적으로 삼았다.
ClpP는 bacterial homeostasis 유지에 필수적인 protease로, 항생제 개발의 유망한 target이다. 기존에는 human 26S proteasome inhibitor인 Bortezomib이 bacterial ClpP 억제 활성을 보이는 것으로 알려져 있었지만, ClpP를 표적으로 하는 발전된 항생제 후보는 거의 보고되지 않았다.
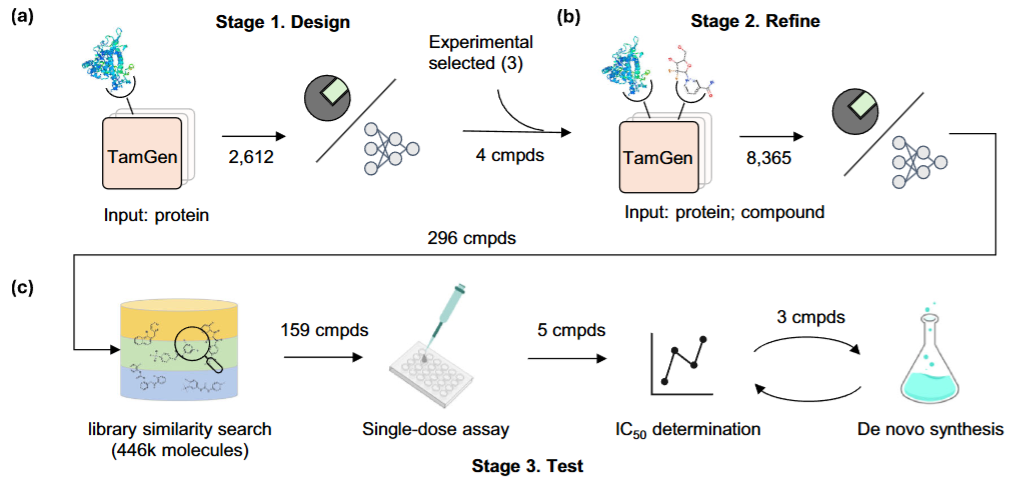
이에 저자들은 TamGen 기반의 Design–Refine–Test pipeline을 구축하여 잠재적인 ClpP inhibitor를 발굴하였다.
- Design 단계
-
ClpP crystal structure(PDB ID: 5DZK)에서 얻은 binding pocket을 조건으로 TamGen을 사용하여 2,612개의 unique compound를 생성하였다.
- 이 단계에서는 seed compound가 없기 때문에 latent variable 는 prior distribution인 에서 무작위로 샘플링된다.
-
생성된 compound를 molecular docking과 phenotypic activity prediction model인 Ligandformer를 이용하여 screening하였다.
- Bortezomib보다 docking score가 좋지 않은 compound 제거
- Ligandformer에서 inactive로 예측된 compound 제거
- Bortezomib의 불리한 ADME 특성과 관련된 peptidomimetic compound 제거
-
최종적으로 4개의 representative compound를 Refine 단계의 seed compound로 선정하였다.
- Refine 단계
-
Refine 단계에서는 target protein과 seed compound를 동시에 조건으로 TamGen을 적용하였다.
-
Seed compound는 총 7개를 사용하였다.
- Design 단계에서 TamGen이 생성한 representative compound 4개
- 기존 실험에서 Mtb ClpP에 대해 약한 inhibitory activity()를 보인 compound 3개
-
이 조건에서 TamGen은 8,635개의 unique compound를 생성하였다.
-
생성된 compound를 Design 단계와 동일한 방식으로 screening한 뒤, 최종적으로 296개의 compound를 Test 단계 후보로 선정하였다.
-
Chemical space 분석
TamGen이 생성한 compound들은 기존 chemical library의 compound와 구별되는 영역에도 분포하였다. 이는 TamGen이 ClpP를 조건으로 기존 library에서 충분히 탐색되지 않은 chemical space를 탐색할 수 있음을 보여준다.- 회색: 기존 chemical library
- 초록색: Stage 1(Design)에서 생성된 compound
- 빨간색: Stage 2(Refine)에서 생성된 compound
-
Test 단계
-
296개의 TamGen-generated compound를 모두 직접 합성하는 대신, 저자들은 먼저 446,000개의 commercial compound library에서 구조적으로 유사한 compound를 검색하였다.
-
296개 TamGen compound 중 하나와 비교했을 때 Maximum Common Substructure(MCS) similarity score가 0.55를 초과하는 159개의 analog를 선정하였다.
-
159개의 commercial analog에 대해 ClpP1P2 peptidase activity assay를 수행한 결과, 5개의 analog가 유의한 inhibitory effect를 나타냈다.
Subsequent dose-response assay에서는 5개 모두 을 보였으며, 특히 Analog-005는 으로 가장 강한 활성을 나타냈다.
또한 이 5개 compound는 이전에 ClpP inhibitor로 보고된 적이 없었다.
중요하게도, Analog-001~005는 TamGen이 직접 생성한 molecule이 아니라 TamGen-generated molecule과 구조적으로 유사한 commercial library compound이다.
SAR 분석 및 추가 합성
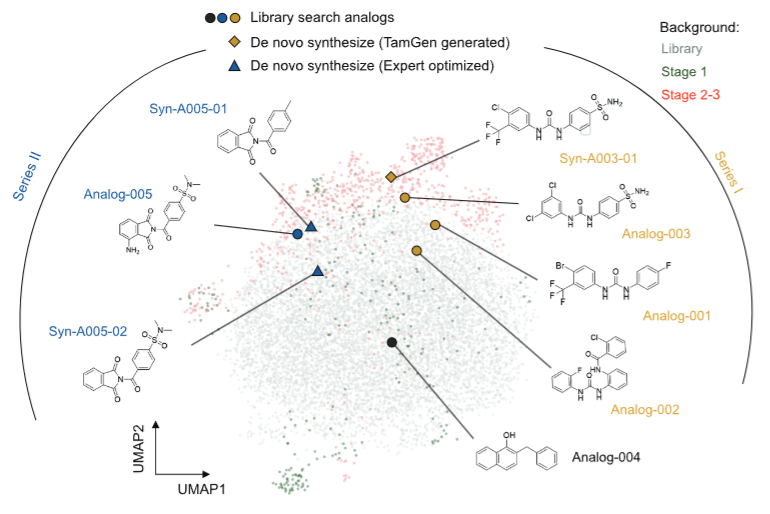
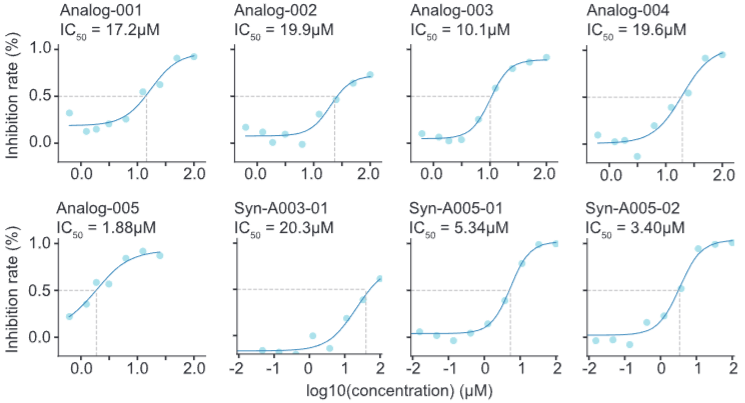
저자들은 hit compound를 확장하고 structure–activity relationship(SAR)을 분석하기 위해 commercial library에 존재하지 않는 3개의 새로운 compound를 추가로 합성하였다.
Series I
Analog-003은 single-dose peptidase assay에서 Bortezomib 대비 48% 수준의 강한 inhibitory effect를 보였다.
이에 저자들은 Analog-003과 대응되는 원래 TamGen-generated source compound인 Syn-A003-01을 직접 합성하였다.
관계는 다음과 같다.
TamGen 생성
→ Syn-A003-01
→ commercial library에서 구조적으로 유사한 compound 탐색
→ Analog-003 발견
Syn-A003-01, Analog-001, Analog-002, Analog-003은 모두 diphenylurea core를 공유하며, 저자들은 이를 새로운 ClpP inhibitor scaffold로 제시하였다.
SAR 분석에서는 다음과 같은 경향을 확인하였다.
- trifluoromethyl group을 chlorine으로 치환했을 때 inhibitory activity가 크게 향상됨
- 저자들은 이 치환이 인접한 urea group의 charge distribution을 변화시켜 hydrogen bonding에 영향을 주었을 가능성을 제안
- sulfonamide group을 fluorine으로 치환한 경우에도 activity가 중간 정도 향상됨
Series II
Commercial analog 중 가장 좋은 를 보인 Analog-005를 기반으로 두 개의 derivative를 추가로 합성하였다.
- Analog-005
- Syn-A005-01
- Syn-A005-02
세 compound는 서로 유사한 수준의 inhibitory activity를 보였다.
저자들은 이를 통해 derivative에서 변경한 functional group이 전체 inhibitory activity에 미치는 영향은 비교적 작다고 해석하였으며, 이러한 scaffold가 향후 추가 optimization의 출발점이 될 수 있다고 보았다.
Structural insights on the mechanisms of compound binding
저자들은 inhibitor의 binding mechanism을 분석하기 위해 서로 다른 두 chemical series를 대표하는 compound인 Syn-A003-01(Series I)과 Analog-005(Series II)를 선택하였다.
두 compound를 ClpP structure(PDB ID: 5DZK)에 docking하고, 기존 reference compound인 Bortezomib과 binding pose를 비교하였다.
Syn-A003-01과 Analog-005 모두 Bortezomib과 마찬가지로 ClpP1과 여러 hydrogen bond interaction을 형성하는 것으로 예측되었다.
특히 Analog-005의 carbonyl carbon은 catalytic residue인 Ser98과 covalent bond를 형성할 가능성이 제시되었다. 저자들은 이러한 interaction이 Analog-005의 높은 inhibitory activity를 설명할 수 있는 하나의 가능한 mechanism이라고 해석하였다.
또한 Syn-A003-01과 Analog-005의 sulfonamide group은 ClpP의 다음 residue들로 이루어진 deep pocket 방향으로 확장되었다.
- Glu101
- Phe102
- Met150
- Asn154
이러한 binding mode는 Bortezomib에서는 관찰되지 않았으며, 저자들은 sulfonamide group이 ClpP binding에 추가적으로 기여할 가능성을 제안하였다.