AI Agent?
단순히 "질문에 답하는 모델"이 아닌 목표를 받아 환경을 관찰하고, 필요한 행동을 선택하며, 상태를 갱신하면서 목표 달성을 시도하는 시스템이다.
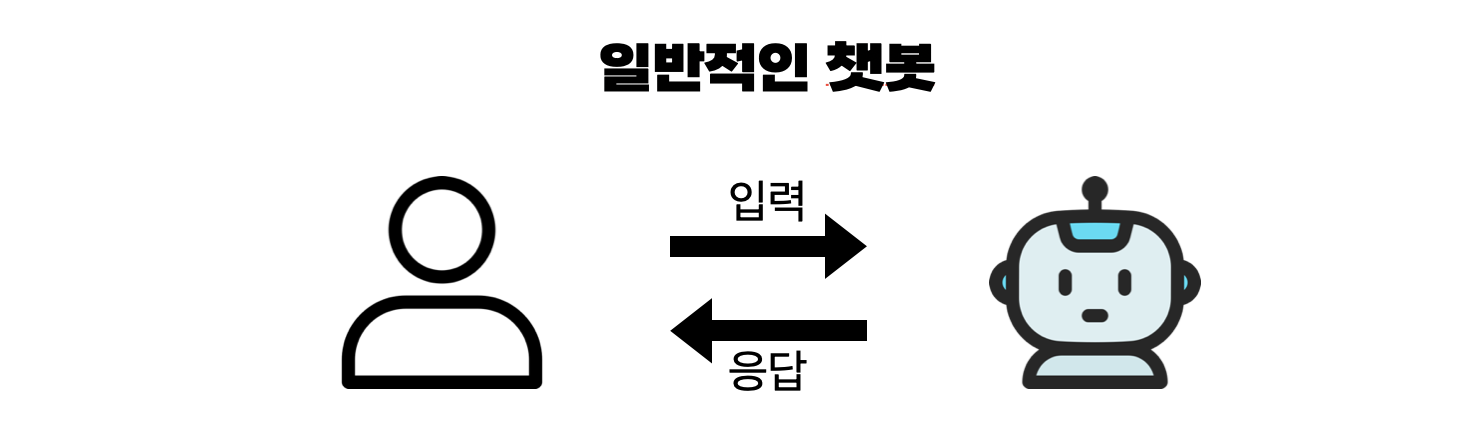
즉, 일반적인 챗봇이 "입력 ➡️ 응답"에 가까운 구조라면
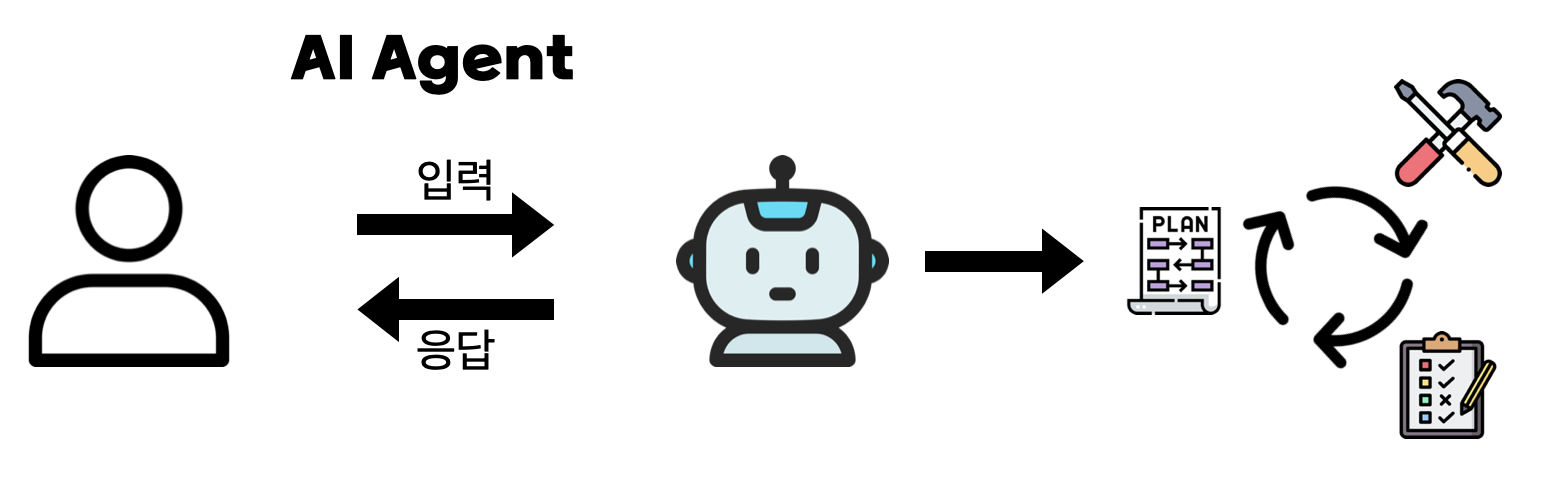
AI Agent는 다음과 같은 구조를 가진다.
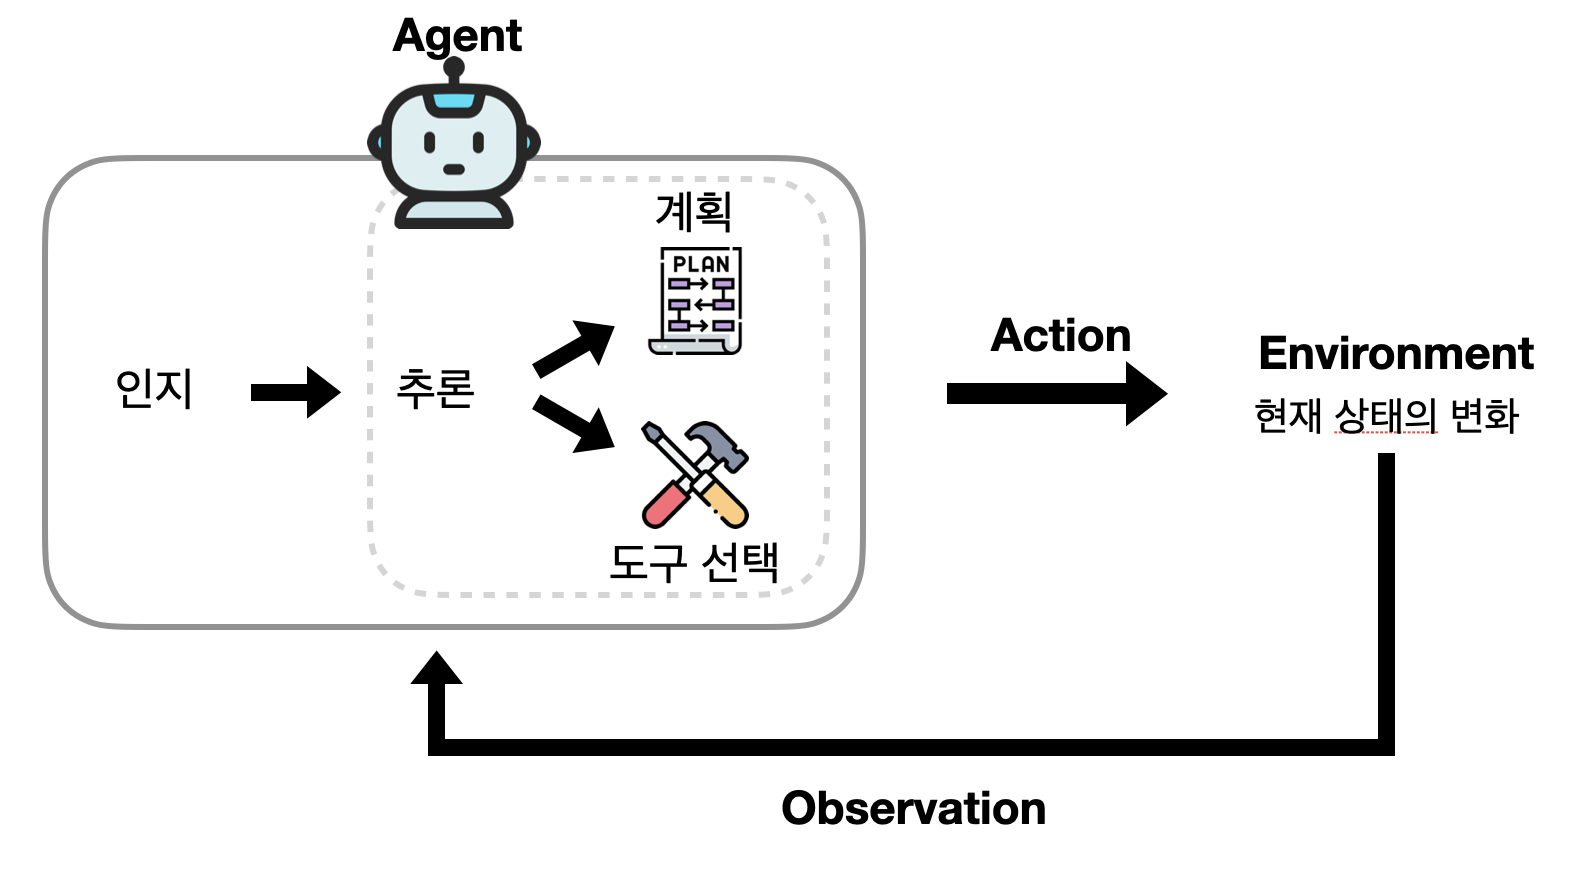
목표 수립 ➡️ 환경 / 입력 관찰 ➡️ 계획 생성 ➡️ 도구 실행(Optional) 후 도구 결과 통합 ➡️ 결과 평가 ➡️ 필요 시 재계획 ➡️ 최종 출력
이 때문에 Agent는 단발성 응답보다 문제 해결 프로세스에 가깝다.
AI Agent의 핵심 구성요소
(1) 목표 (Goal)
사용자가 task를 주면, Agent는 내부적으로 실행 가능한 목표로 바꾼다(2) 관찰 (Observation)
Agent는 사용자 입력, 이전 대화, tool 실행 결과, 외부 DB 검색 결과 등을 환경 정보로 받아들인다.(3) 상태 (State)
현재까지 무엇을 했고 무엇이 남았고, 어떤 자료를 출력했는지, 어떤 오류가 났었는지 등을 저장한다.(4) 계획 (Planning)
복잡한 문제를 하위 task로 나누고 순서를 정한다(5) 행동 (Action)
검색, 계산, 코드 실행 등 실제로 무언가를 수행한다.(6) 기억 (Memory)
Agent는 단기 기억과 장기 기억을 가질 수 있다.(7) 평가와 피드백 (Evaluation / Reflection)
중간 결과가 목표에 부합하는지 스스로 평가하고, 부족하면 다시 계획을 세우거나 다른 도구를 사용한다.
그렇다면 AI Agent는 어떤 한계를 가질까?
- Hallucination
계획 단계나 도구 해석 단계에서 틀린 전제를 세울 수 있다 - Tool misuse
잘못된 도구를 고르거나, 올바른 결과를 잘못 해석할 수 있다 - State drift
여러 단계가 길어질수록 현재 상태를 잘못 추적할 수 있다. - Cost / Latency
툴 호출과 반복 추론이 많아지면 느리고 비싸진다 - Evaluation difficulty
한 번의 답변 정확도보다, 전체 실행 과정의 신뢰성을 평가해야 해서 벤치마킹이 어렵다
Memory
Agent System은 대화창 내에서의 기억인 Short term memory와 대화창 너머 전반적인 기억 저장소인 Long term memory가 있다.
Short term memory는 챗봇 구현에 필수적이며, Long-term memory는 장기작업, 사용자 선호도 저장을 위해 활용된다.
메모리는 보통 세 종류로 나뉜다
1) Semantic memory
사용자 선호, 프로젝트 정보, 도메인 지식처럼 비교적 안정적인 사실
2) Episodic memory
과거에 무슨 일이 있었는지, 어떤 시도를 했는지에 대한 기록
3) Procedural memory
해동 방식, 규칙, workflow
그렇다면 어떻게 저장할까?
1) Raw transcript 저장
대화 전체를 그대로 저장한다. 이 경우 정보 손실은 적지만 검색 비용이 크고 노이즈가 많다
2) Summarized memory 저장
대화에서 미래에 유용할 정보만 요약해서 저장한다
3) Structured extraction 저장
대화에서 특정 슬롯만 뽑아 저장한다
{
  "user_preferences": {
    "language": "ko",
    "answer_style": "technical"
  },
  "project": {
    "name": "single-cell analysis agent",
    "status": "experimenting"
  }
}
저장했다면 어떻게 다시 꺼내올까? 핵심은 retrieval이다. 모델이 매번 모든 memory를 읽는 게 아니라, 현재 질문과 관련 있는 것만 가져온다. 대표적으로 keyword / metadata retrieval, Vector similarity retrieval, Hybrid retrieval 방식이 있다.
memory는 그러면 언제 쓸까? 세 시점으로 나뉜다
1. 입력 전
사용자 질문이 들어오면 관련 memory를 먼저 검색해서 프롬프트에 붙인다
2. 추론 중
Agent가 도구를 쓰다가 "이전에 이런 정보가 있었나?"하면서 추가 검색한다
3. 출력 후
이번 상호작용에서 장기적으로 유용한 내용을 새 memory로 저장한다.
즉, 루프는 대체로 다음과 같다 interaction ➡️ extract ➡️ store ➡️ retrieve ➡️ inject ➡️ reason
컨텍스트 엔지니어링
우리가 사용하는 Agent 서비스는 대화 이력, tool 결과, 메모리, 중간 추론 산출물 때문에 실제로 모델에 들어가는 context가 쉽게 비대해진다. 그래서 이걸 줄이거나 통제하는 실무적 접근을 'context engineering'이라고 부룬다.
핵심은 단순히 "이전 history를 다 넣지 말자"가 아닌, 현재 필요한 정보만 선별해서 넣고, 나머지는 압축,외부화,지연 로딩하는 것이다.
문제를 분해해보면 Agent에서 context overflow 원인은 보통 다음과 같다.
-
대화 history 누적
이전 사용자 / assistant 메시지가 계속 쌓임 -
tool output 비대화
검색 결과, 문서 본문, JSON 응답이 너무 큼 -
working memory 오염
이미 끝난 subtask 정보까지 프롬프트에 남아 있음 -
멀티스텝 계획의 잔재
초기에 세운 계획, 중간 생각, 실패한 시도까지 계속 포함됨
그래서 해결도 다음 4개 축으로 대부분 이루어진다.
- 선별 (Selection)
- 압축 (Compression)
- 외부화 (Externalization)
- 구조화 (Structuring)
Sliding Window
최근 N개 턴만 유지하고 오래된 history는 버리는 가장 단순한 방법이다.
| 설명 | |
|---|---|
| 장점 | 구현이 매우 쉬움 latency와 비용 통제가 쉬움 |
| 단점 | 오래된 중요한 제약조건을 잃기 쉬움 "초반에 말한 요구사항"이 사라질 수 있음 |
짧은 customer support agent, 세션 지속성이 길지 않은 챗봇, 장기 기억보다 최근 상호작용이 중요한 경우에 주로 사용된다.
최근 대화는 원문으로 유지하며 오래된 대화는 summary로 유지하는 방식이 최근에 많이 사용된다.
Conversation Summarization
오래된 history를 통째로 버리지 않고 요약본으로 압축하는 방식
| 설명 | |
|---|---|
| 장점 | 긴 세션 유지 가능 중요한 state를 남길 수 있음 |
| 단점 | 요약 과정에서 정보 손실 잘못 요약 시 모든 턴이 오염됨 |
실무에서는 요약을 자유문장 하나로 두지 말고 구조화된 요약으로 만듦. 이렇게 해야 나중에 필요한 필드만 다시 주입하기 쉬움
{
	"user_goal" : "...",
    "confirmed_constraints" : ["...","..."],
    "decisions_made" : ["...","..."],
    "open_questions" : ["..."],
    "facts_to_preserve" : ["..."]
}
Memory 분리
history를 모두 대화창에 두지 않고, 메모리 계층으로 나눈다
- Immediate context
현재 턴에서 꼭 필요한 정보 - Session memory
이번 세션 동안 유지할 상태 - Long-term memory
사용자 성향, 자주 쓰는 설정, 반복되는 사실
이러한 방법을 통해 모든 걸 history로 저장하지 않으면서 중요도에 따라 보존 기간을 다르게 줄 수 있다.
⭐️ Retrieval-based Context Injection
history를 전부 넣는 대신, 필요할 때만 검색해서 넣는 방식
예를 들어, 사용자가 "아까 말한 제약조건 반영해서 다시 설계해"라고 하면 전체 history를 다 넣는 대신, 과거 대화 / 메모리에서 "제약조건"관련 chunk만 검색한다.
| 설명 | |
|---|---|
| 장점 | 긴 세션에서 매우 유용 토큰 낭비가 적음 |
| 단점 | retrieval miss가 나면 중요한 과거 사실을 못 가져옴 semantic retrieval만으로는 정확한 constraint 회수가 어려울 수 있음 |
Fact / Constraint Extraction
대화 전체를 넣지 않고, 대화에서 명시적 사실과 제약조건만 추출해서 별도 상태로 관리한다.
예를 들어 Agent가 매 턴마다 다음을 갱신한다.
- 사용자 목표, 하드 제약조건, 선호 사항, 이미 결정된 사항, 금지된 방법, 현재 진행 상태
{
  "goal": "Agent context overflow 해결 방안 정리",
  "hard_constraints": [
    "한국어로 설명",
    "실무적인 방법 중심"
  ],
  "preferences": [
    "구체적 예시 선호"
  ],
  "resolved_items": [
    "overflow 원인 분류 완료"
  ]
}
이렇게 하면 과거의 발화를 매번 다 넣지 않아도 된다.
Tool Output Compression
검색 결과 20개 전문, 긴 HTML, 대형 JSON 등을 모델에 그대로 얺으면 바로 context가 터진다. 이를 해결하기 위해서 다음과 같은 방법을 따른다
- tool 결과를 바로 요약
- 정답에 필요한 필드만 추출
- 원문은 외부 저장소에 두고 pointer만 유지
- 후속 질문이 있을 때만 원문 재조회
Hierarchical Context
긴 정보를 한 번에 넣지 않고, 계층적으로 다루는 방식
큰 그림 ➡️ 관련 문서 ➡️ 관련 섹션 ➡️ 필요한 문단 / 행 / 코드 조각 처럼 coarse-to-fine으로 내려간다.
Context Routing
모든 정보를 한 프롬프트에 넣는 대신, 질문 유형에 따라 필요한 컨텍스트 종류 자체를 바꾸는 방식
- 일정 관련 질문 ➡️ calender memory만
- 사용자 preference 질문 ➡️ profile memory만
- 기술 디버깅 질문 ➡️ 최근 code / tool context만
Scratchpad / Deliberation 분리
Agent가 중간 계획이나 reasoning 흔적을 계속 history에 남기면 금방 커진다. 그래서 실무에서는 사용자에게 보여줄 대화, 내부 작업 상태, 툴 호출 로그를 분리한다.
최종 답변만 chat history에 남기고, 중간 계획은 별도 scratchpad store에 저장한다. 다음 턴에는 scratchpad 전체가 아니라 요약된 task state만 주입하는 흐름으로 운영이 된다.