리눅스 시스템 기초 · 입문편 — 본문의 "N편"은 입문 과정 번호다. 번호별 글과 전체 250편 구성은 통합 로드맵에서 확인할 수 있다.
리눅스 시스템 기초 39 / 50 · Part 4. 프로세스·서비스·리소스
실습 환경: Rocky Linux 9 (10.0.0.200) ·free·vmstat은 실습 환경 실제 출력
이전 글: 38. cron 작업 스케줄링
1. 들어가며
33편 top에서 CPU 항목(us·sy·wa)과 메모리의 avail Mem을 잠깐 봤다. 이번 글은 CPU와 메모리를 조금 더 깊이 다룬다.
현업에서 자주 받는 질문이 있다.
"서버 메모리가 거의 다 찼다고 모니터링에 뜨는데, 문제인가요?"
대부분은 문제가 아니다. Linux는 놀고 있는 메모리를 파일 캐시로 채워 두기 때문이다. 반대로 진짜 메모리가 부족하면 커널은 OOM Killer 로 프로세스를 강제 종료한다. 이때 종료되는 대상이 DB나 보안 에이전트라면, 37편에서 본 signal=KILL 흔적이 남는다. 장애와 공격을 구분하려면 이 구조를 알아야 한다.
2. 핵심 개념
2-1. CPU 쪽 지표 복습과 보완
| 지표 | 도구 | 의미 |
|---|---|---|
| load average | uptime, top | R + D 상태 평균 개수. 코어 수와 비교 (33편) |
| us / sy / wa / st | top, vmstat | 사용자 / 커널 / I/O 대기 / 가상화 뺏김 |
r / b | vmstat | CPU 대기 프로세스 수 / D 상태 수 |
| nice (NI) | ps, top | 우선순위. -20(높음) ~ 19(낮음) |
nice·renice로 우선순위를 조정할 수 있다. 일반 사용자는 우선순위를 낮추는 것만 가능하고, 높이는 것은 root만 된다.
2-2. 메모리 용어
| 항목 | 의미 |
|---|---|
used | 프로세스가 실제로 쓰는 메모리 |
buff/cache | 디스크 파일을 메모리에 올려 둔 캐시. 필요하면 즉시 반납 |
free | 아무 용도로도 안 쓰는 메모리 |
available | 새 프로그램이 스왑 없이 쓸 수 있는 추정치 ≈ free + 회수 가능한 캐시 |
swap | 메모리가 부족할 때 디스크로 내보내는 공간 |
| RSS / VSZ | 프로세스별 실제 물리 메모리 / 예약한 가상 주소 크기 (32편) |
판단 기준은 free가 아니라 available 이다.
2-3. OOM Killer
메모리를 더 이상 확보할 수 없으면 커널은 점수(oom_score)가 가장 높은 프로세스를 SIGKILL로 종료 한다. 점수는 주로 메모리 사용량으로 정해지며, oom_score_adj(-1000 ~ 1000)로 보정할 수 있다. -1000이면 절대 종료 대상이 되지 않는다.
3. 동작 원리
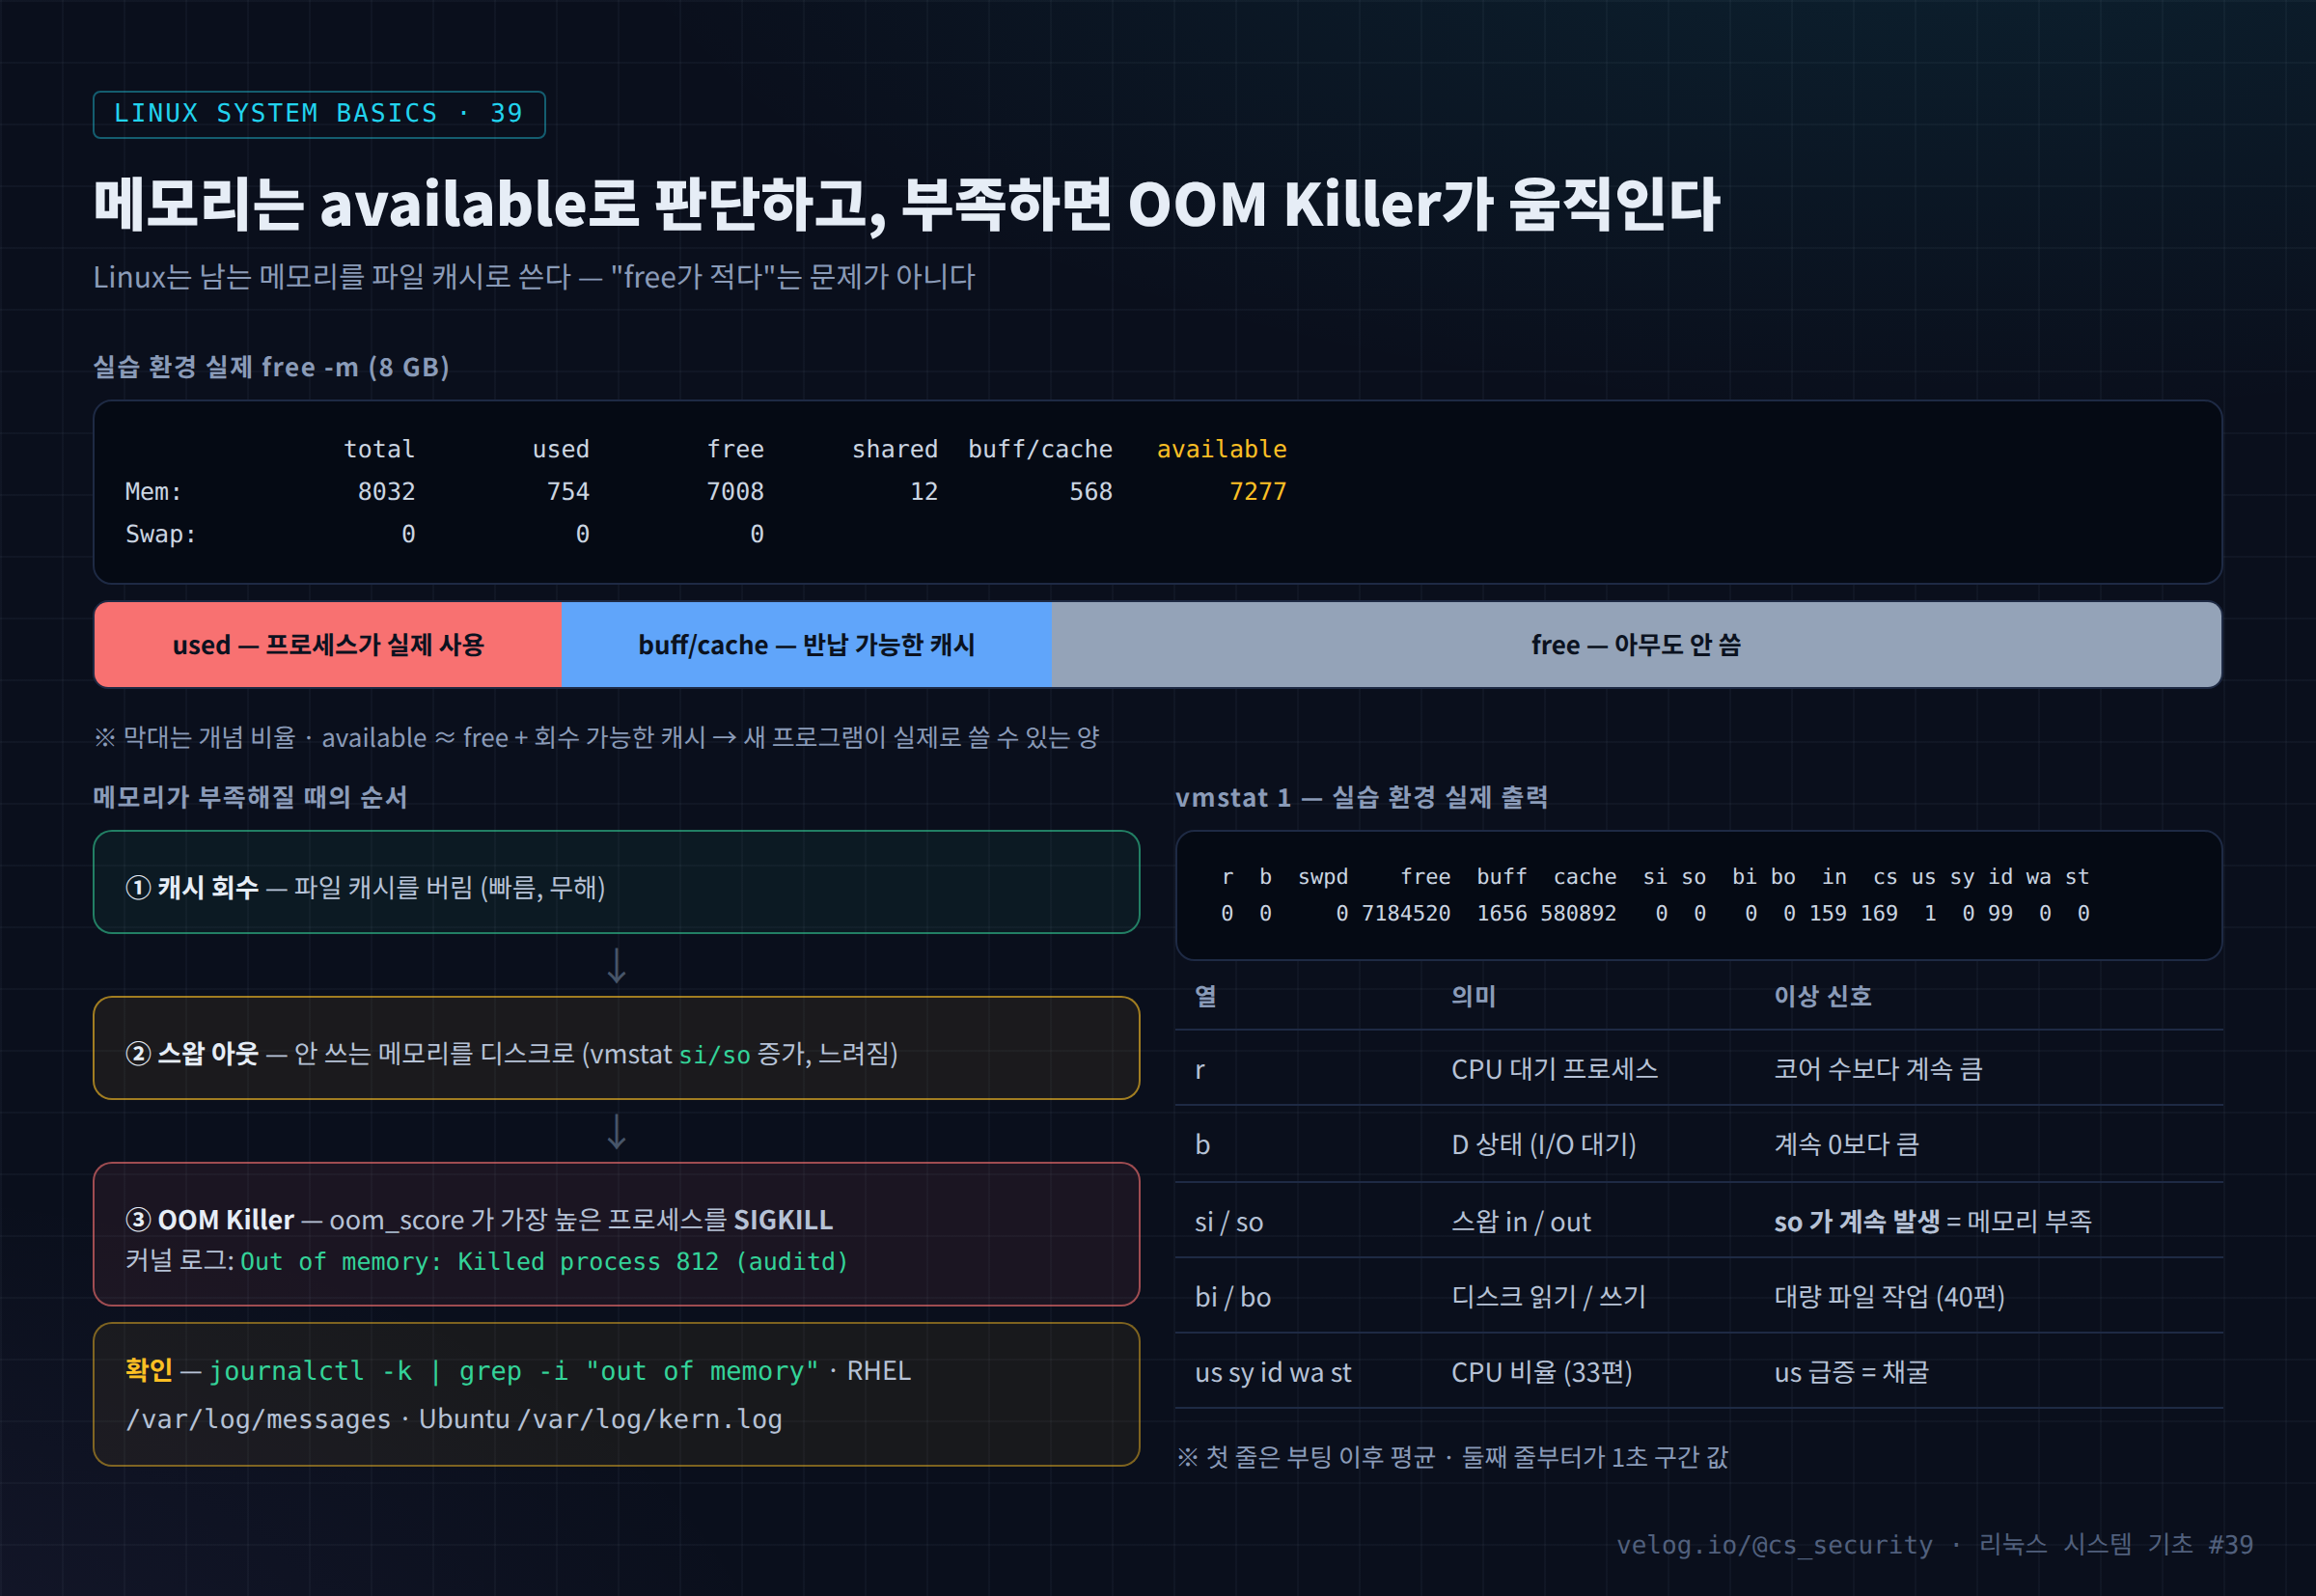
실습 환경의 실제 출력이다.
$ free -m
               total        used        free      shared  buff/cache   available
Mem:            8032         754        7008          12         568        7277
Swap:              0           0           0

$ vmstat 1 2
procs -----------memory---------- ---swap-- -----io---- -system-- -------cpu-------
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st gu
 0  0      0 7176912   1656 580880    0    0   620    33  282    1  2  1 97  0  0  0
0 0 0 7184520 1656 580892 0 0 0 0 159 169 1 0 99 0 0 0vmstat의 첫 줄은 부팅 이후 평균 이고, 두 번째 줄부터가 실제 1초 구간 값이다. 그래서 vmstat 1 5처럼 여러 번 찍어 두 번째 줄부터 본다. (최신 procps의 gu는 게스트 VM 실행 시간이다.)
메모리가 부족해질 때 커널은 다음 순서로 대응한다.
- 캐시 회수 — 파일 캐시는 원본이 디스크에 있으므로 그냥 버린다. 빠르고 무해하다.
- 스왑 아웃 — 잘 안 쓰는 프로세스 메모리를 스왑으로 내보낸다.
vmstat의so가 올라가고, 다시 필요할 때si가 올라간다. 이때부터 서버가 눈에 띄게 느려진다. - OOM Killer — 그래도 부족하면 프로세스를 강제 종료한다.
4. 실습
# 1) CPU
nproc; uptime
vmstat 1 5
mpstat -P ALL 1 3            # sysstat 패키지, 코어별

# 2) 메모리
free -h
grep -E 'MemTotal|MemAvailable|^Cached|SwapTotal|SwapFree' /proc/meminfo
ps -eo pid,user,rss,%mem,comm --sort=-rss | head   # 메모리 상위 (32편)

# 3) 스왑
swapon --show
vmstat 1 5 | awk 'NR>3 {print "si="$7, "so="$8}'

# 4) OOM 기록
journalctl -k --since "7 days ago" | grep -iE 'out of memory|oom-kill|killed process'
sudo grep -i 'out of memory' /var/log/messages     # RHEL
sudo grep -i 'out of memory' /var/log/kern.log     # Ubuntu

# 5) OOM 점수
cat /proc/<PID>/oom_score /proc/<PID>/oom_score_adj

# 6) 우선순위
nice -n 10 ./batch.sh
sudo renice -n 5 -p <PID>
5. 결과 분석
아래 이상 상황 출력은 형식 설명용 예시다.
① 메모리 부족 진행 중 (vmstat 1)
 r  b   swpd   free  buff  cache   si   so  bi   bo  ...  us sy id wa
3 2 812340 51200 1020 60112 2410 5120 3100 5400 ... 20 15 20 45| 값 | 해석 |
|---|---|
free 50MB, cache 60MB | 캐시까지 거의 다 회수됨 |
si/so 수천 | 스왑을 계속 읽고 씀 (thrashing) |
b 2, wa 45 | 디스크 대기로 느려짐 |
② OOM Killer 기록 (journalctl -k)
kernel: Out of memory: Killed process 4411 (java) total-vm:9123456kB, anon-rss:6510232kB, ... oom_score_adj:0
kernel: oom_reaper: reaped process 4411 (java), now anon-rss:0kB
anon-rss 6.5GB를 쓰던 java가 종료되었다. 서비스 쪽에서는 37편처럼 code=killed, signal=KILL 또는 Result: oom-kill로 보인다.
판단 구분
| 상황 | OOM 기록 | 해석 |
|---|---|---|
서비스 signal=KILL + 커널 OOM 기록 있음 | 있음 | 자원 문제 (메모리 누수, 과부하) |
서비스 signal=KILL + OOM 기록 없음 | 없음 | 외부에서 kill -9 → 누가 했는지 조사 (37편) |
6. 보안 관점
| 공격 | CPU·메모리 징후 |
|---|---|
| 채굴 (T1496) | us 급증, 코어 수만큼 %CPU, 높은 nice(낮은 우선순위)로 숨기기 |
| 메모리 상주 악성코드 | 디스크 파일 없이 메모리에만 존재 (/proc/PID/exe → (deleted) 또는 memfd:, 29편) |
| 자원 고갈 DoS | fork bomb(Tasks 급증), 메모리 고갈 → OOM으로 보안 에이전트까지 종료 될 수 있음 |
| 보안 에이전트 종료 위장 | OOM처럼 보이게 하려 해도 커널 OOM 기록이 없으면 구분 가능 |
운영 측면에서는 중요 보안 프로세스(auditd, 로그 수집기)의 oom_score_adj를 낮게 두어 OOM 시 먼저 죽지 않게 하는 것이 좋다. systemd Unit에서는 OOMScoreAdjust=-900처럼 설정한다.
7. SOC / 보안관제 활용
7-1. 자원 이상 1차 스냅샷
{
  date; nproc; uptime
  free -m
  vmstat 1 5
  ps -eo pid,ppid,user,%cpu,%mem,rss,etimes,args --sort=-%cpu | head -10
  journalctl -k --since "1 hour ago" | grep -iE 'oom|killed process'
} > /root/evidence/res_$(hostname)_$(date +%Y%m%d_%H%M).txt 2>&1
7-2. 분석 흐름
[Alert]   모니터링: 메모리 사용률 97%
   ↓
[free]    available 5.9GB / buff/cache 5.6GB → 캐시가 대부분, 실제 부족 아님 → 오탐 처리
          (임계치를 used 기준이 아닌 available 기준으로 변경 건의)

[Alert 2] 서비스 auditd signal=KILL
   ↓
[OOM?]    journalctl -k 에 Out of memory 없음, available 충분
   ↓
[판단]    자원 문제 아님 → 외부 강제 종료 → sudo·로그인 기록 조사 (37편)
8. 핵심 정리
- CPU 부하는 load average를 코어 수와 비교 하고,
vmstat의r(CPU 대기)·b(I/O 대기)로 보완한다. - 메모리 여유는
available로 판단한다.buff/cache는 필요하면 반납된다. - 부족해지면 캐시 회수 → 스왑(
si/so) → OOM Killer(SIGKILL) 순서로 진행된다. - OOM 기록:
journalctl -k, RHEL/var/log/messages, Ubuntu/var/log/kern.log. signal=KILL인데 OOM 기록이 없으면 외부 강제 종료 를 의심한다.- 중요 보안 프로세스는
oom_score_adj/OOMScoreAdjust로 보호한다.
9. 다음 글
다음 글 「40. Disk 사용량 관리」 는 Part 4의 마지막 글이다. df와 du의 차이, inode 고갈, 삭제했는데 용량이 줄지 않는 경우(lsof +L1), logrotate, 그리고 디스크가 가득 차서 로그가 기록되지 않는 상황 을 관제 관점에서 정리한다.
참고 자료
- free(1), vmstat(8) — https://man7.org/linux/man-pages/man8/vmstat.8.html
- proc(5) — /proc/meminfo, oom_score_adj — https://man7.org/linux/man-pages/man5/proc.5.html
- Kernel docs — Out Of Memory handling — https://www.kernel.org/doc/gorman/html/understand/understand016.html
- MITRE ATT&CK T1496 Resource Hijacking — https://attack.mitre.org/techniques/T1496/
