서비스 · 프로세스 관리 04 / 50 · Part 1. 프로세스 기초
실습 환경: Rocky Linux 9.8 · Ubuntu 24.04.5 (systemd로 부팅한 Docker 격리 컨테이너, 테스트 계정analyst)
1. 들어가며
ps aux를 실행하면 STAT 열에 Ss, R+, S<s, Z 같은 알 수 없는 문자가 보인다. 이 한두 글자가 프로세스가 지금 무엇을 하고 있는지 를 알려 준다. CPU를 쓰는 중인지, 무언가를 기다리는지, 멈춰 있는지, 이미 죽었는데 치워지지 않았는지다.
이번 글에서는 R·S·T·Z 상태를 실제로 만들어 보고, D 상태가 왜 장애 분석에서 중요한지, 보조 플래그(s, +, <, N)를 어떻게 읽는지 정리한다.
2. 핵심 개념
2-1. 주 상태 코드
| 코드 | 이름 | 의미 | 예 |
|---|---|---|---|
| R | Running / Runnable | CPU에서 실행 중 또는 실행 대기열에 있음 | 계산 루프, 압축 작업 |
| S | Interruptible Sleep | 이벤트를 기다리는 중. 시그널로 깨울 수 있음 | sleep, 접속 대기 데몬, 입력 대기 셸 |
| D | Uninterruptible Sleep | 커널 I/O 완료를 기다리는 중. 시그널을 받지 않음 | 느린 디스크·NFS 응답 대기 |
| T | Stopped | 시그널로 정지 (SIGSTOP, SIGTSTP) | Ctrl+Z 한 작업 |
| t | Tracing stop | 디버거에 의해 정지 | gdb/strace에 붙잡힌 프로세스 |
| Z | Zombie | 종료됐지만 부모가 회수하지 않음 | <defunct> 표시 |
| I | Idle | 유휴 커널 스레드 | [kworker/...] |
2-2. 보조 플래그
| 플래그 | 의미 |
|---|---|
< | 높은 우선순위 (nice 값이 음수) |
N | 낮은 우선순위 (nice 값이 양수) |
s | 세션 리더 (로그인 셸, 데몬의 첫 프로세스 등) |
l | 멀티스레드 프로세스 |
+ | 터미널의 포그라운드 프로세스 그룹에 속함 |
L | 메모리 페이지를 잠금(mlock) |
예를 들어 S<s는 "대기 중(S) + 높은 우선순위(<) + 세션 리더(s)"다.
2-3. load average와 상태의 관계
Linux의 load average는 R 상태 + D 상태 프로세스 수의 평균이다. CPU 사용률이 낮은데 load가 높다면 D 상태(디스크 I/O 대기)가 쌓였을 가능성이 크다. 이 내용은 07편 top에서 이어 본다.
3. 동작 원리
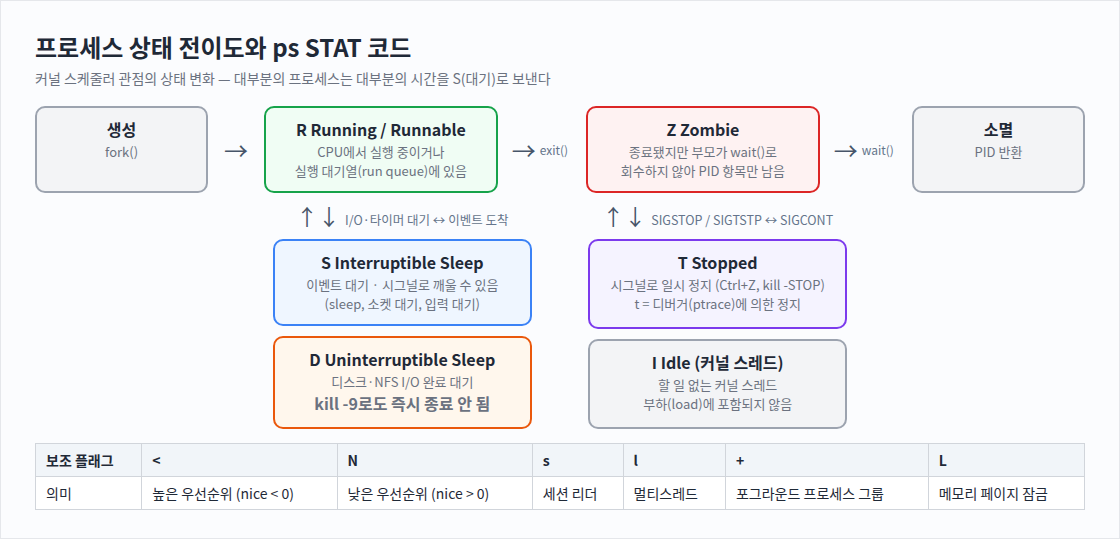
fork() → R ⇄ S       (대부분의 시간: 이벤트 대기 S ↔ 실행 R)
         R ⇄ D       (디스크 I/O 요청 → 완료될 때까지 D)
         R/S → T     (SIGSTOP·SIGTSTP) → SIGCONT로 복귀
         R → exit() → Z → 부모 wait() → 소멸
S와 D의 차이 가 실무에서 중요하다. S는 시그널을 받으면 깨어나 처리할 수 있지만, D는 커널이 I/O 중간 상태를 보호하기 위해 시그널 처리를 미룬다. 그래서 D 상태 프로세스는 kill -9를 보내도 I/O가 끝나기 전까지 사라지지 않는다. 좀비(Z)도 kill로 없앨 수 없는데, 이미 죽은 프로세스이기 때문이다(08편).
4. 명령어 실습
# 1) 상태별 프로세스 만들기 (analyst 계정)
timeout 20 sh -c 'while :; do :; done' &      # R: CPU를 계속 사용하는 루프 (20초 후 자동 종료)
sleep 60 &                                     # S: 타이머 대기
sleep 60 & sleep 0.2; kill -STOP $!            # T: 정지 시그널
python3 -c 'import os,time
if os.fork()==0: os._exit(0)                   # 자식은 즉시 종료
time.sleep(60)' &                              # 부모는 wait() 없이 잠만 잔다 → 자식은 Z

# 2) 상태와 대기 지점(wchan) 확인
sleep 1; ps -o pid,ppid,stat,wchan:16,cmd -u analyst

# 3) T → S 복귀
kill -CONT %3; ps -o pid,stat,cmd -p $(jobs -p %3)

# 4) 시스템 전체 상태 분포
ps -eo stat= | cut -c1 | sort | uniq -c

# 5) (Ubuntu, root) 보조 플래그 확인
ps -o pid,ni,stat,cmd -p 1,$(pgrep -x systemd-journal),$(pgrep -x cron),$$
nice -n 10 sleep 30 & sleep 0.2; ps -o pid,ni,stat,cmd -p $!
grep -E '^(State|Threads)' /proc/$(pgrep -x systemd-journal)/status
1)의 R 루프는 CPU 코어 하나를 100% 사용한다. 운영 서버에서는 실행하지 않고, 실습에서도
timeout으로 반드시 종료 시간을 건다.
5. 실행 결과
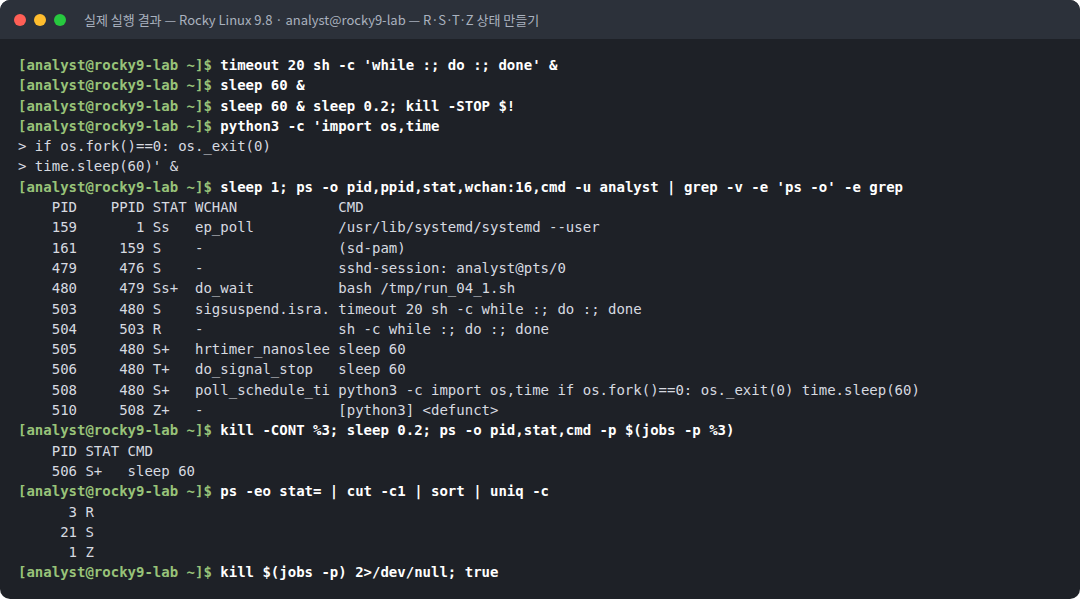
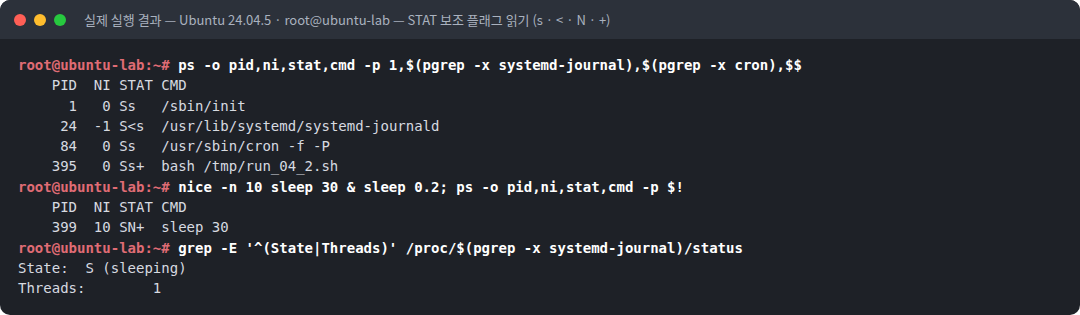
텍스트 원본(실제 출력):
[analyst@rocky9-lab ~]$ timeout 20 sh -c 'while :; do :; done' &
[analyst@rocky9-lab ~]$ sleep 60 &
[analyst@rocky9-lab ~]$ sleep 60 & sleep 0.2; kill -STOP $!
[analyst@rocky9-lab ~]$ python3 -c 'import os,time
> if os.fork()==0: os._exit(0)
> time.sleep(60)' &
[analyst@rocky9-lab ~]$ sleep 1; ps -o pid,ppid,stat,wchan:16,cmd -u analyst | grep -v -e 'ps -o' -e grep
    PID    PPID STAT WCHAN            CMD
    159       1 Ss   ep_poll          /usr/lib/systemd/systemd --user
    161     159 S    -                (sd-pam)
    479     476 S    -                sshd-session: analyst@pts/0
    480     479 Ss+  do_wait          bash /tmp/run_04_1.sh
    503     480 S    sigsuspend.isra. timeout 20 sh -c while :; do :; done
    504     503 R    -                sh -c while :; do :; done
    505     480 S+   hrtimer_nanoslee sleep 60
    506     480 T+   do_signal_stop   sleep 60
    508     480 S+   poll_schedule_ti python3 -c import os,time if os.fork()==0: os._exit(0) time.sleep(60)
    510     508 Z+   -                [python3] <defunct>
[analyst@rocky9-lab ~]$ kill -CONT %3; sleep 0.2; ps -o pid,stat,cmd -p $(jobs -p %3)
    PID STAT CMD
    506 S+   sleep 60
[analyst@rocky9-lab ~]$ ps -eo stat= | cut -c1 | sort | uniq -c
      3 R
     21 S
      1 Z
[analyst@rocky9-lab ~]$ kill $(jobs -p) 2>/dev/null; true
root@ubuntu-lab:~# ps -o pid,ni,stat,cmd -p 1,$(pgrep -x systemd-journal),$(pgrep -x cron),$$
PID NI STAT CMD
1 0 Ss /sbin/init
24 -1 S<s /usr/lib/systemd/systemd-journald
84 0 Ss /usr/sbin/cron -f -P
395 0 Ss+ bash /tmp/run_04_2.sh
root@ubuntu-lab:~# nice -n 10 sleep 30 & sleep 0.2; ps -o pid,ni,stat,cmd -p $!
PID NI STAT CMD
399 10 SN+ sleep 30
root@ubuntu-lab:~# grep -E '^(State|Threads)' /proc/$(pgrep -x systemd-journal)/status
State: S (sleeping)
Threads: 16. 결과 해석
| 관찰 | 의미 |
|---|---|
sh -c while :; do :; done → R | 빈 루프가 CPU를 계속 차지한다. wchan이 -인 것은 커널 안에서 기다리는 곳이 없다는 뜻 |
timeout 20 ... → S, wchan sigsuspend | timeout 자체는 자식이 끝나거나 시간이 되기를 시그널 대기 중이다 |
sleep 60 → S+, wchan hrtimer_nanosleep | 고해상도 타이머를 기다리는 대기 상태. +는 터미널 포그라운드 그룹 |
정지한 sleep → T+, wchan do_signal_stop | SIGSTOP으로 멈췄다. kill -CONT 후 다시 S+ 로 돌아왔다 |
python 부모 → S+, 자식 → Z+ [python3] <defunct> | 자식은 종료했지만 부모가 wait()하지 않아 좀비로 남았다. 이름이 대괄호로 표시된다 |
bash → Ss+, wchan do_wait | 실습 셸은 세션 리더(s)이며 자식을 wait하는 중이다 |
| 전체 분포: S 21, R 3, Z 1 | 시스템 대부분은 S다. R 3개는 루프, 그리고 이 순간 실행 중이던 ps와 파이프라인 명령이다 |
| Ubuntu journald → S<s, NI -1 | systemd가 journald를 nice -1로 실행해 <가 붙었다. 로그 수집이 밀리지 않도록 한 설정이다 |
nice -n 10 sleep → SN+, NI 10 | 낮은 우선순위 표시 N |
/proc/PID/status의 State: S (sleeping) | ps의 STAT 첫 글자와 같은 값을 커널에서 직접 읽은 것 |
D 상태는 일부러 재현하기 어렵다(느린 NFS·고장 난 디스크가 필요하다). 실무에서
ps -eo stat,pid,wchan:30,cmd | awk '$1 ~ /^D/'로 D 상태 프로세스와 대기 지점을 찾는 방법을 기억해 두자.
7. 보안 관점
| 주제 | 내용 |
|---|---|
| 지속적인 R 상태 | 알 수 없는 프로세스가 오랫동안 R 상태로 CPU를 점유하면 크립토마이너 를 의심한다 (47편) |
| T 상태 악용 | 공격자가 보안 에이전트(EDR, auditd)에 SIGSTOP을 보내면 프로세스는 살아 있는 것처럼 보이지만 동작하지 않는다. 에이전트의 상태가 T인지 확인해야 한다 |
| t 상태 | 정상 운영 중인 서비스가 t라면 누군가 ptrace(gdb/strace)로 붙어 있다는 뜻이다. 메모리에서 자격 증명을 빼내는 공격 도구도 ptrace를 쓴다 |
| 좀비 대량 발생 | 좀비는 PID를 점유한다. 대량 발생 시 새 프로세스를 만들지 못하는 서비스 거부로 이어질 수 있다 |
| D 상태와 가용성 | D 상태가 쌓이면 load가 치솟고 서비스가 멈춘다. 공격이 아닌 스토리지 장애일 가능성도 함께 본다 |
8. 보안관제 관점
[Detection]  모니터링: 보안 에이전트 하트비트 끊김, 그러나 프로세스는 존재
     ↓
[확인]       ps -o pid,stat,wchan:20,lstart,cmd -C <agent>
             → STAT T  (do_signal_stop)
     ↓
[판단]       누군가 SIGSTOP으로 에이전트를 멈춤 → 방어 회피(Defense Evasion) 의심
     ↓
[Evidence]   auditd kill 시스템 콜 기록(a1=19 SIGSTOP), 해당 시각 로그인 세션
     ↓
[Response] kill -CONT 로 복구 → 정지 주체 계정 조사 → 에이전트 자기보호 설정 점검| 관점 | 확인 명령 |
|---|---|
| 상태 분포 요약 | ps -eo stat= \| cut -c1 \| sort \| uniq -c |
| 좀비와 그 부모 | ps -eo pid,ppid,stat,cmd \| awk '$3 ~ /^Z/' |
| D 상태와 대기 지점 | ps -eo pid,stat,wchan:30,cmd \| awk '$2 ~ /^D/' |
| 정지된 프로세스 | ps -eo pid,stat,user,cmd \| awk '$2 ~ /^[Tt]/' |
9. 실무에서 자주 발생하는 실수
| 실수 | 결과 | 예방 |
|---|---|---|
좀비를 kill -9로 지우려 함 | 아무 효과 없음 | 부모 프로세스를 처리해야 한다 (08편) |
| D 상태 프로세스를 계속 kill | 효과 없음, 원인 방치 | wchan과 dmesg로 I/O 원인(스토리지·NFS)을 확인 |
| CPU 사용률만 보고 부하 판단 | D 상태로 인한 load 상승을 놓침 | load average와 %wa(I/O 대기)를 함께 확인 |
| T 상태를 "정상 대기"로 오해 | 멈춘 에이전트·작업 방치 | T는 누군가 멈춘 것이다. 원인 확인 후 CONT 또는 종료 |
| STAT의 보조 플래그를 무시 | 포그라운드/세션 리더 구분 실패 | s, +, <, N, l의 의미를 함께 읽는다 |
10. 실습 체크리스트
[ ] R, S, T, Z 상태의 프로세스를 직접 만들었다
[ ] wchan 으로 S 상태 프로세스가 무엇을 기다리는지 확인했다
[ ] kill -STOP / kill -CONT 로 T ↔ S 전환을 확인했다
[ ] <defunct> 좀비와 그 부모(wait 하지 않는 python)를 확인했다
[ ] S<s, SN+ 등 보조 플래그를 해석했다
[ ] D 상태가 kill -9 로도 사라지지 않는 이유를 설명할 수 있다
11. 핵심 정리
- STAT 첫 글자는 주 상태(R·S·D·T·Z·I), 뒤 글자는 보조 플래그(
<·N·s·l·+)다. - 대부분의 프로세스는 S(대기) 상태이며, R은 CPU 사용 또는 실행 대기다.
- D 상태와 Z 상태는 kill로 없앨 수 없다. D는 I/O 원인, Z는 부모를 처리해야 한다.
- load average는 R + D 프로세스 수이므로 CPU가 한가해도 load가 높을 수 있다.
- 보안 에이전트가 T 상태라면 방어 회피 공격을 의심한다.
12. 다음 편 예고
다음 글 「05. /proc으로 프로세스 들여다보기」 에서는 ps와 top이 정보를 가져오는 원천인 /proc/PID 디렉터리를 직접 읽는다. cmdline, exe, cwd, fd, maps, environ에서 무엇을 알 수 있고, 다른 사용자의 프로세스는 어디까지 보이는지 권한 경계를 확인한다.
참고 자료
- ps(1) — PROCESS STATE CODES — https://man7.org/linux/man-pages/man1/ps.1.html
- proc_pid_status(5) — https://man7.org/linux/man-pages/man5/proc_pid_status.5.html
- proc_pid_wchan(5) — https://man7.org/linux/man-pages/man5/proc_pid_wchan.5.html
- Brendan Gregg, Linux Load Averages: Solving the Mystery — https://www.brendangregg.com/blog/2017-08-08/linux-load-averages.html
시리즈 이동
- [이전 글] 03. PID·PPID와 프로세스 트리
- [현재 글] 04. 프로세스 상태 (R·S·D·T·Z)
- [다음 글] 05. /proc으로 프로세스 들여다보기
