서비스 · 프로세스 관리 18 / 50 · Part 2. 시그널·자원·세션
실습 환경: Rocky Linux 9.8 · Ubuntu 24.04.5 (systemd로 부팅한 Docker 격리 컨테이너, 테스트 계정analyst)
1. 들어가며
17편의 ulimit은 프로세스 하나 의 한도였다. 하지만 실제 서비스는 여러 프로세스로 이루어지고, 우리가 막고 싶은 것은 "이 서비스 전체가 CPU를 20% 이상 쓰지 못하게", "이 서비스는 메모리를 1GB까지만" 같은 묶음 단위의 제한 이다. 이를 담당하는 커널 기능이 cgroup(control group) 이다.
이번 글에서는 프로세스가 어느 cgroup에 속하는지 확인하고, systemd-run으로 CPU 20%·프로세스 5개 제한 을 건 임시 서비스를 만들어 제한이 실제로 동작하는 것을 측정한다.
2. 핵심 개념
2-1. cgroup이 하는 일
| 기능 | 내용 |
|---|---|
| 묶기 | 프로세스들을 계층형 그룹으로 묶는다. fork한 자식은 부모의 cgroup에 자동 소속 |
| 제한 | 그룹 전체의 CPU·메모리·프로세스 수·I/O 상한 |
| 측정 | 그룹별 사용량 집계 (systemd-cgtop) |
| 추적 | 이중 fork·고아화해도 cgroup은 바뀌지 않는다 → 서비스가 만든 모든 프로세스 추적 |
2-2. systemd와 cgroup
systemd는 모든 서비스(.service), 로그인 세션(.scope), 그룹(.slice)을 cgroup 하나씩으로 만든다. 그래서 cgroup 설정을 직접 파일로 만지는 대신 unit 속성 으로 제어한다.
| 방법 | 예 | 지속성 |
|---|---|---|
| unit 파일 / drop-in | [Service] CPUQuota=50% | 영구 (28편) |
systemctl set-property | systemctl set-property nginx MemoryMax=1G | 영구 (--runtime이면 임시) |
systemd-run -p | systemd-run -p TasksMax=5 cmd | 임시 서비스 |
2-3. cgroup v1과 v2
| 구분 | v1 | v2 (unified) |
|---|---|---|
| 구조 | 자원(controller)마다 별도 트리 | 하나의 트리 에 모든 자원 |
/proc/PID/cgroup | 여러 줄 (4:memory:/...) | 한 줄 (0::/system.slice/crond.service) |
| 기본 사용 | 구형 배포판 | Rocky 9, Ubuntu 22.04+ 기본 |
이 실습 컨테이너는 호스트 커널이 cgroup v1(hybrid) 모드로 동작하고, 경로 앞에
/docker/<컨테이너ID>가 붙는다. 실제 Rocky 9·Ubuntu 24.04 서버라면/proc/PID/cgroup은0::/system.slice/crond.service한 줄로 보인다. systemd 명령(systemd-cgls,systemctl show,systemd-run -p)의 사용법은 두 버전에서 같다.
3. 동작 원리
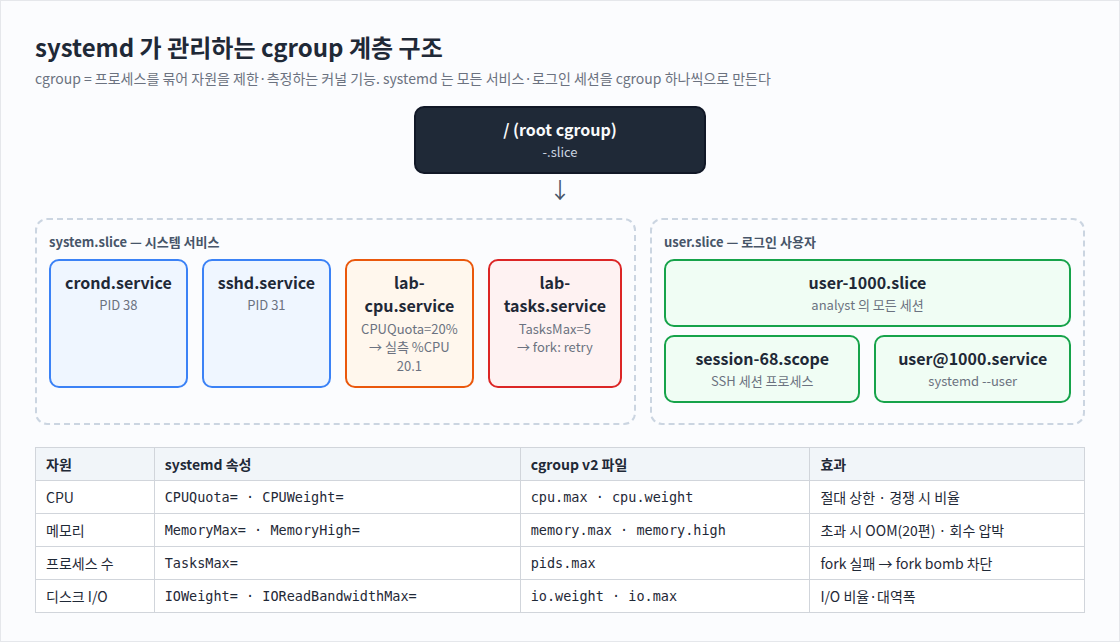
systemd-run --unit=lab-tasks -p TasksMax=5 bash -c '10개 fork'
  → systemd: system.slice/lab-tasks.service cgroup 생성, pids.max = 5
  → bash 와 자식들이 이 cgroup 에 소속
  → 5번째 태스크 이후 fork() → 커널이 EAGAIN 반환
  → bash: "fork: retry: Resource temporarily unavailable"
CPU 제한 CPUQuota=20%는 "100ms 주기마다 20ms까지만 CPU를 쓸 수 있다"로 변환된다. 무한 루프라도 그 이상은 쓰지 못한다. 09편의 nice(경쟁 시 비율)와 달리 CPU가 남아 있어도 상한이 걸린다.
4. 명령어 실습
# 1) 프로세스의 cgroup 확인
cat /proc/$$/cgroup | head -5
systemd-cgls --no-pager -u system.slice | head -14
systemctl status crond --no-pager | sed -n '1,12p'      # CGroup: 줄

# 2) 제한을 건 임시 서비스
systemd-run --unit=lab-cpu -p CPUQuota=20% /usr/bin/timeout 15 sh -c 'while :; do :; done'
systemd-run --unit=lab-tasks -p TasksMax=5 /bin/bash -c 'for i in $(seq 10); do sleep 30 & done; wait'
sleep 6; ps -o pid,%cpu,cmd -C sh
systemctl show lab-cpu -p CPUQuotaPerSecUSec,ControlGroup
systemctl show lab-tasks -p TasksMax,TasksCurrent
journalctl -u lab-tasks --no-pager | grep -m2 -i 'fork'

# 3) 정리
systemctl stop lab-cpu lab-tasks; systemctl reset-failed
운영 중인 서비스에 제한을 걸 때는
systemctl set-property SERVICE CPUQuota=50%처럼 적용하고, 먼저--runtime으로 시험한 뒤 영구 적용한다. 메모리 제한은 너무 낮으면 즉시 OOM 종료로 이어진다(20편).
5. 실행 결과
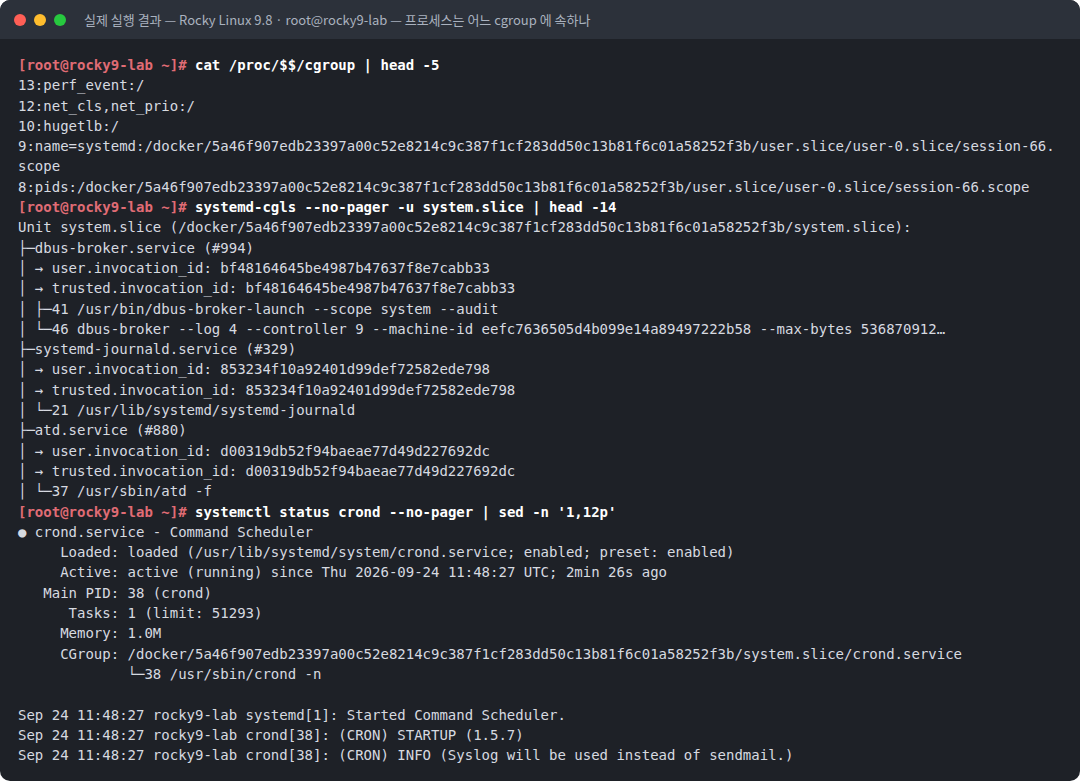
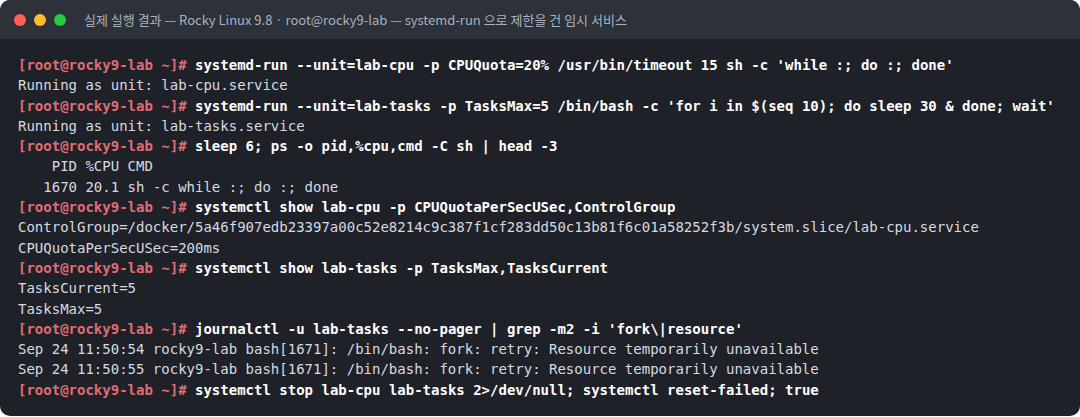
텍스트 원본(실제 출력):
[root@rocky9-lab ~]# cat /proc/$$/cgroup | head -5
13:perf_event:/
12:net_cls,net_prio:/
10:hugetlb:/
9:name=systemd:/docker/5a46f907edb23397a00c52e8214c9c387f1cf283dd50c13b81f6c01a58252f3b/user.slice/user-0.slice/session-66.scope
8:pids:/docker/5a46f907edb23397a00c52e8214c9c387f1cf283dd50c13b81f6c01a58252f3b/user.slice/user-0.slice/session-66.scope
[root@rocky9-lab ~]# systemd-cgls --no-pager -u system.slice | head -14
Unit system.slice (/docker/5a46f907edb23397a00c52e8214c9c387f1cf283dd50c13b81f6c01a58252f3b/system.slice):
├─dbus-broker.service (#994)
│ → user.invocation_id: bf48164645be4987b47637f8e7cabb33
│ → trusted.invocation_id: bf48164645be4987b47637f8e7cabb33
│ ├─41 /usr/bin/dbus-broker-launch --scope system --audit
│ └─46 dbus-broker --log 4 --controller 9 --machine-id eefc7636505d4b099e14a89497222b58 --max-bytes 536870912…
├─systemd-journald.service (#329)
│ → user.invocation_id: 853234f10a92401d99def72582ede798
│ → trusted.invocation_id: 853234f10a92401d99def72582ede798
│ └─21 /usr/lib/systemd/systemd-journald
├─atd.service (#880)
│ → user.invocation_id: d00319db52f94baeae77d49d227692dc
│ → trusted.invocation_id: d00319db52f94baeae77d49d227692dc
│ └─37 /usr/sbin/atd -f
[root@rocky9-lab ~]# systemctl status crond --no-pager | sed -n '1,12p'
● crond.service - Command Scheduler
     Loaded: loaded (/usr/lib/systemd/system/crond.service; enabled; preset: enabled)
     Active: active (running) since Thu 2026-09-24 11:48:27 UTC; 2min 26s ago
   Main PID: 38 (crond)
      Tasks: 1 (limit: 51293)
     Memory: 1.0M
     CGroup: /docker/5a46f907edb23397a00c52e8214c9c387f1cf283dd50c13b81f6c01a58252f3b/system.slice/crond.service
             └─38 /usr/sbin/crond -n

Sep 24 11:48:27 rocky9-lab systemd[1]: Started Command Scheduler.
Sep 24 11:48:27 rocky9-lab crond[38]: (CRON) STARTUP (1.5.7)
Sep 24 11:48:27 rocky9-lab crond[38]: (CRON) INFO (Syslog will be used instead of sendmail.)
[root@rocky9-lab ~]# systemd-run --unit=lab-cpu -p CPUQuota=20% /usr/bin/timeout 15 sh -c 'while :; do :; done'
Running as unit: lab-cpu.service
[root@rocky9-lab ~]# systemd-run --unit=lab-tasks -p TasksMax=5 /bin/bash -c 'for i in $(seq 10); do sleep 30 & done; wait'
Running as unit: lab-tasks.service
[root@rocky9-lab ~]# sleep 6; ps -o pid,%cpu,cmd -C sh | head -3
PID %CPU CMD
1670 20.1 sh -c while :; do :; done
[root@rocky9-lab ~]# systemctl show lab-cpu -p CPUQuotaPerSecUSec,ControlGroup
ControlGroup=/docker/5a46f907edb23397a00c52e8214c9c387f1cf283dd50c13b81f6c01a58252f3b/system.slice/lab-cpu.service
CPUQuotaPerSecUSec=200ms
[root@rocky9-lab ~]# systemctl show lab-tasks -p TasksMax,TasksCurrent
TasksCurrent=5
TasksMax=5
[root@rocky9-lab ~]# journalctl -u lab-tasks --no-pager | grep -m2 -i 'fork\|resource'
Sep 24 11:50:54 rocky9-lab bash[1671]: /bin/bash: fork: retry: Resource temporarily unavailable
Sep 24 11:50:55 rocky9-lab bash[1671]: /bin/bash: fork: retry: Resource temporarily unavailable
[root@rocky9-lab ~]# systemctl stop lab-cpu lab-tasks 2>/dev/null; systemctl reset-failed; true6. 결과 해석
| 관찰 | 의미 |
|---|---|
/proc/$$/cgroup의 여러 줄 (perf_event, pids, name=systemd...) | cgroup v1은 자원별로 트리가 따로 있어 줄이 여러 개다 |
.../user.slice/user-0.slice/session-66.scope | 내 root 셸은 로그인 세션 66 의 scope에 속한다 |
systemd-cgls에서 서비스별로 PID가 묶여 표시 | dbus-broker는 프로세스 2개(41, 46)가 한 서비스 cgroup에 있다 |
→ trusted.invocation_id: ... | systemd가 cgroup에 붙인 실행 고유 ID. 같은 서비스라도 재시작마다 바뀐다 |
systemctl status crond의 Tasks: 1 (limit: 51293), Memory: 1.0M, CGroup: | 서비스 상태 화면이 cgroup 사용량을 보여 준다 |
lab-cpu의 sh %CPU 20.1 | 무한 루프가 정확히 20% 근처에서 막혔다 |
CPUQuotaPerSecUSec=200ms | 1초당 200ms = 20% |
TasksCurrent=5, TasksMax=5 | bash + sleep 4개에서 더 만들 수 없다 |
bash: fork: retry: Resource temporarily unavailable | 17편 nproc 초과와 같은 오류지만, 이번에는 서비스 단위 로 걸렸다 |
7. 보안 관점
| 주제 | 내용 |
|---|---|
| 피해 격리 | 웹 서비스가 탈취되어 채굴기를 돌려도 CPUQuota=가 걸려 있으면 서버 전체가 마비되지 않는다. TasksMax=는 fork bomb을 서비스 안에 가둔다 |
| 출처 추적 | 악성 프로세스가 이중 fork로 PPID 1이 되어도 cgroup은 원래 서비스·세션 을 가리킨다. /proc/PID/cgroup에 nginx.service가 보이면 웹 서비스 경유 실행이다 (08편 연결) |
| 컨테이너 | Docker·Kubernetes 자원 제한과 격리도 cgroup 위에서 동작한다. 컨테이너 탈출 공격은 cgroup 설정 악용을 포함한다 |
| 로그인 세션 | 사용자 slice에도 TasksMax가 기본 적용되어(UserTasksMax) 한 사용자가 PID를 고갈시키는 것을 막는다 |
8. 보안관제 관점
[Detection]  의심 프로세스 PID 4127 — PPID 1, 이름 "kworker"
     ↓
[소속 확인]  cat /proc/4127/cgroup
             → 0::/system.slice/php-fpm.service     (v2 서버 예)
     ↓
[판단]       커널 스레드 이름인데 php-fpm 서비스 cgroup 소속 → 웹 경유 실행된 위장 프로세스
     ↓
[범위 확인]  systemd-cgls -u php-fpm.service       ← 같은 cgroup 의 다른 프로세스 전부
     ↓
[Response]   증거 수집 → 해당 cgroup 의 악성 프로세스만 종료 또는 서비스 격리
systemctl set-property php-fpm.service CPUQuota=10% --runtime (임시 억제)| 명령 | 용도 |
|---|---|
cat /proc/PID/cgroup | 프로세스 소속 서비스·세션 |
systemd-cgls | 트리 전체 |
systemd-cgtop | cgroup별 CPU·메모리 실시간 사용량 |
systemctl status UNIT | 서비스 cgroup의 모든 프로세스 |
9. 실무에서 자주 발생하는 실수
| 실수 | 결과 | 예방 |
|---|---|---|
| cgroup 파일을 직접 수정 | systemd가 덮어쓰거나 충돌 | systemctl set-property, unit 속성 사용 |
| nice로 CPU 상한을 걸려 함 | CPU가 남으면 100% 사용 | CPUQuota= |
MemoryMax=를 너무 낮게 | 서비스가 반복 OOM 종료 | MemoryHigh=로 먼저 압박, 사용량 측정 후 설정 |
| v1 경로 기준 스크립트를 v2 서버에서 사용 | 경로 없음 | stat -fc %T /sys/fs/cgroup → cgroup2fs면 v2 |
임시 unit을 reset-failed 없이 반복 생성 | 같은 이름으로 재실행 불가 | 실습 후 systemctl reset-failed |
10. 실습 체크리스트
[ ] /proc/PID/cgroup 으로 프로세스의 소속 cgroup 을 확인했다
[ ] systemd-cgls 로 서비스별 프로세스 묶음을 확인했다
[ ] systemd-run -p CPUQuota=20% 로 CPU 상한이 걸리는 것을 측정했다
[ ] TasksMax=5 로 fork 실패를 재현했다
[ ] cgroup v1 과 v2 의 /proc/PID/cgroup 형식 차이를 설명할 수 있다
[ ] cgroup 으로 고아화된 프로세스의 출처를 추적하는 방법을 이해했다
11. 핵심 정리
- cgroup은 프로세스를 묶어 그룹 단위로 자원을 제한·측정 하는 커널 기능이다.
- systemd는 서비스·세션마다 cgroup을 만들고,
CPUQuota=,MemoryMax=,TasksMax=같은 속성으로 제어한다. - CPUQuota는 절대 상한(실측 20.1%), nice는 경쟁 시 비율이다.
- cgroup은 이중 fork로도 벗어날 수 없어 프로세스 출처 추적 에 강력하다.
- Rocky 9·Ubuntu 24.04의 기본은 cgroup v2다. 실습 컨테이너의 v1 출력과 형식이 다르다.
12. 다음 편 예고
다음 글 「19. 세션·터미널·데몬 프로세스」 에서는 10편에서 본 세션(SID)과 제어 터미널을 정리하고, 전통적인 데몬 만들기(fork → setsid → fork) 를 직접 구현한다. 터미널이 없는(TTY ?) 프로세스가 무엇인지, 시스템 데몬과 사용자가 만든 데몬을 어떻게 구분하는지 확인한다.
참고 자료
- cgroups(7) — https://man7.org/linux/man-pages/man7/cgroups.7.html
- Control Group v2 (kernel docs) — https://docs.kernel.org/admin-guide/cgroup-v2.html
- systemd.resource-control(5) — https://www.freedesktop.org/software/systemd/man/latest/systemd.resource-control.html
- systemd-run(1) — https://www.freedesktop.org/software/systemd/man/latest/systemd-run.html
시리즈 이동
- [이전 글] 17. 프로세스 자원 제한 (ulimit·limits.conf)
- [현재 글] 18. cgroup으로 자원 제어하기
- [다음 글] 19. 세션·터미널·데몬 프로세스
