서비스 · 프로세스 관리 20 / 50 · Part 2. 시그널·자원·세션
실습 환경: Rocky Linux 9.8 · Ubuntu 24.04.5 (systemd로 부팅한 Docker 격리 컨테이너, 테스트 계정analyst)
1. 들어가며
새벽에 DB 서비스가 갑자기 죽었다. 애플리케이션 로그에는 아무 오류도 없고, 프로세스는 흔적 없이 사라졌다. 이런 "조용한 죽음"의 가장 흔한 원인이 OOM Killer(Out Of Memory Killer) 다. 메모리가 바닥나면 커널은 시스템 전체가 멈추는 것을 막기 위해 프로세스 하나를 골라 SIGKILL로 종료한다.
Part 2의 마지막 글에서는 OOM Killer가 누구를 고르는지(oom_score), 서비스를 어떻게 보호하거나 희생양으로 지정하는지, 그리고 메모리 한도를 넘긴 서비스가 OOM으로 종료되는 과정을 로그로 추적 하는 방법을 실습한다.
2. 핵심 개념
2-1. 메모리가 부족하면 일어나는 일
메모리 요청 → 여유 부족 → 페이지 캐시 회수 → swap 사용 → 그래도 부족
  → OOM Killer: 희생 프로세스 선택 → SIGKILL → 메모리 회수
2-2. 관련 값
| 항목 | 위치 | 의미 |
|---|---|---|
oom_score | /proc/PID/oom_score | 0~1000(+adj). 높을수록 먼저 종료. 주로 메모리 사용 비율 로 계산 |
oom_score_adj | /proc/PID/oom_score_adj | -1000~+1000 보정값. -1000이면 절대 종료되지 않음 |
OOMScoreAdjust= | systemd unit | 서비스의 oom_score_adj 설정 |
MemoryMax= | systemd unit | cgroup 메모리 상한 → 넘으면 cgroup 안에서 OOM |
MemoryHigh= | systemd unit | 넘으면 강한 회수 압박(느려짐), 종료는 아님 |
OOMPolicy= | systemd unit | OOM 발생 시 서비스 전체를 멈출지(stop) 계속할지(continue) |
2-3. 두 가지 OOM
| 종류 | 발생 조건 | 선택 범위 | dmesg 표시 |
|---|---|---|---|
| 시스템 OOM | 시스템 전체 메모리 고갈 | 모든 프로세스 | Out of memory: Killed process |
| cgroup(memcg) OOM | 서비스 cgroup이 MemoryMax 초과 | 그 cgroup 안 에서만 | Memory cgroup out of memory |
3. 동작 원리
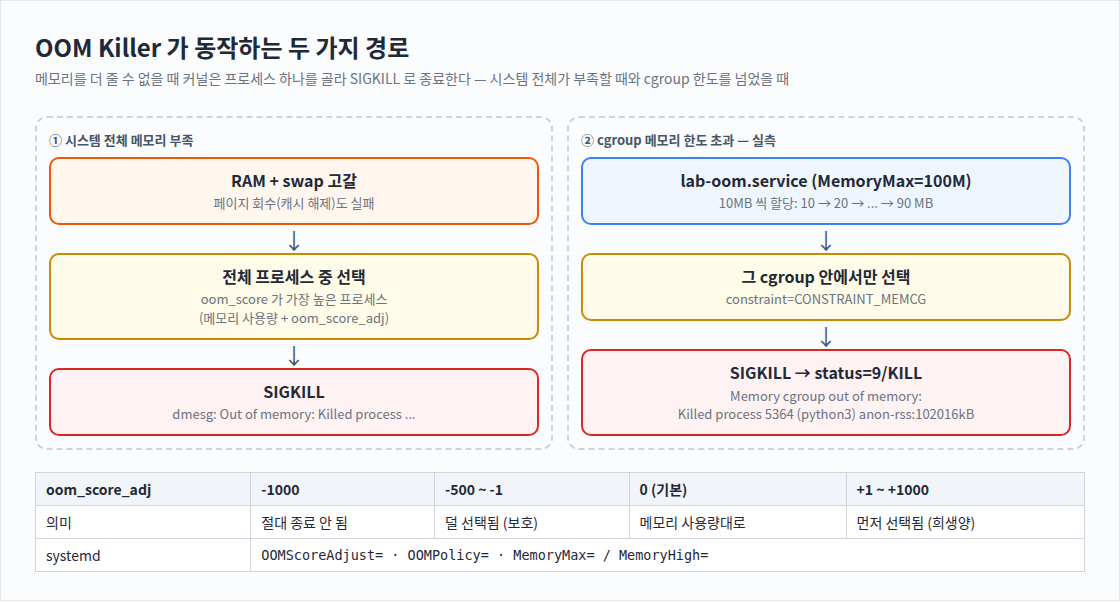
lab-oom.service (MemoryMax=100M, MemorySwapMax=0)
  python: 10MB 씩 bytearray 할당 → 90MB 까지 성공
  다음 10MB 할당 → cgroup 사용량 100MB 초과 → 회수할 캐시 없음
  → 커널: "python3 invoked oom-killer" (constraint=CONSTRAINT_MEMCG)
  → cgroup 안에서 oom_score 최고 = python3(5364) → SIGKILL
  → systemd: Main process exited, code=killed, status=9/KILL
프로그램 입장에서는 예외를 잡을 기회도, 로그를 남길 기회도 없다. SIGKILL이기 때문이다(13편). 그래서 애플리케이션 로그는 조용하고, 흔적은 커널 로그(dmesg, journal)와 systemd 로그에만 남는다.
4. 명령어 실습
# 1) 메모리 상황과 프로세스별 점수
free -m
for p in 1 $(pgrep -xo sshd) $(pgrep -x systemd-journal) $$; do
  printf '%-6s %-18s score=%-4s adj=%s\n' $p $(cat /proc/$p/comm) $(cat /proc/$p/oom_score) $(cat /proc/$p/oom_score_adj)
done
systemctl show sshd systemd-journald -p Id,OOMScoreAdjust

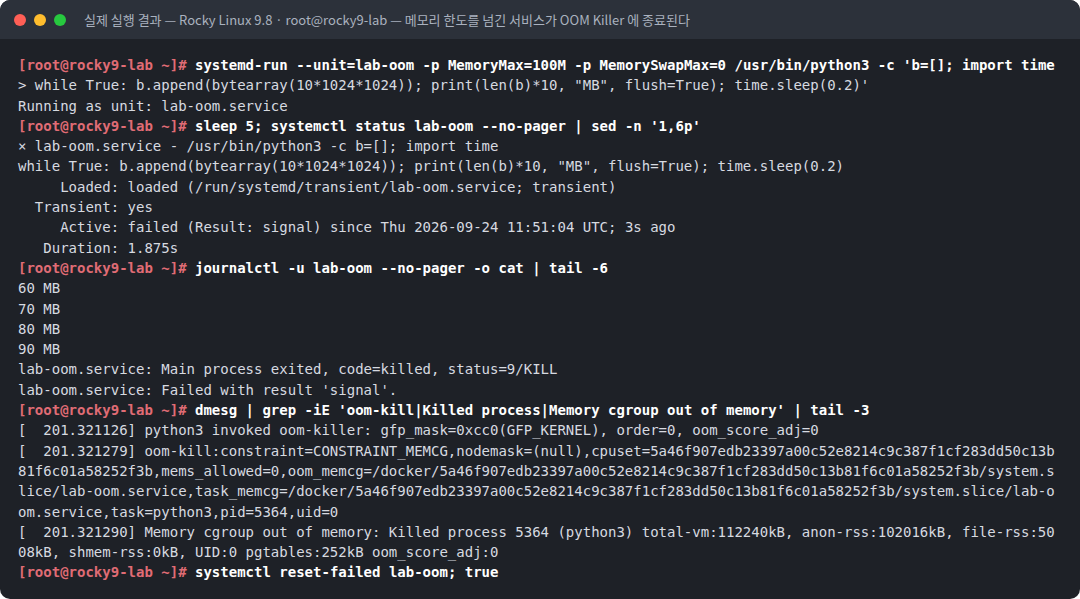
# 2) 메모리 한도 100MB 서비스에서 메모리 계속 할당 → OOM
systemd-run --unit=lab-oom -p MemoryMax=100M -p MemorySwapMax=0 /usr/bin/python3 -c 'b=[]; import time
while True: b.append(bytearray(10*1024*1024)); print(len(b)*10, "MB", flush=True); time.sleep(0.2)'
sleep 5; systemctl status lab-oom --no-pager | sed -n '1,6p'
journalctl -u lab-oom --no-pager -o cat | tail -6
dmesg | grep -iE 'oom-kill|Killed process|Memory cgroup out of memory' | tail -3
systemctl reset-failed lab-oom
시스템 전체 OOM을 일부러 일으키는 실습은 하지 않는다. 운영 서버라면 sshd·로그 수집기까지 종료될 수 있다. 실습은 반드시 cgroup 한도 안에서 한다.
5. 실행 결과
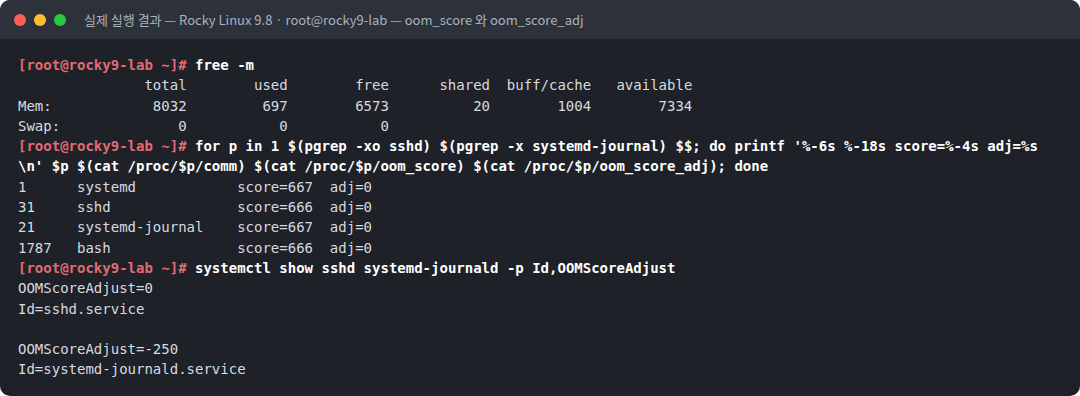
텍스트 원본(실제 출력):
[root@rocky9-lab ~]# free -m
               total        used        free      shared  buff/cache   available
Mem:            8032         697        6573          20        1004        7334
Swap:              0           0           0
[root@rocky9-lab ~]# for p in 1 $(pgrep -xo sshd) $(pgrep -x systemd-journal) $$; do printf '%-6s %-18s score=%-4s adj=%s\n' $p $(cat /proc/$p/comm) $(cat /proc/$p/oom_score) $(cat /proc/$p/oom_score_adj); done
1      systemd            score=667  adj=0
31     sshd               score=666  adj=0
21     systemd-journal    score=667  adj=0
1787   bash               score=666  adj=0
[root@rocky9-lab ~]# systemctl show sshd systemd-journald -p Id,OOMScoreAdjust
OOMScoreAdjust=0
Id=sshd.service

OOMScoreAdjust=-250
Id=systemd-journald.service
[root@rocky9-lab ~]# systemd-run --unit=lab-oom -p MemoryMax=100M -p MemorySwapMax=0 /usr/bin/python3 -c 'b=[]; import time
> while True: b.append(bytearray(10*1024*1024)); print(len(b)*10, "MB", flush=True); time.sleep(0.2)'
Running as unit: lab-oom.service
[root@rocky9-lab ~]# sleep 5; systemctl status lab-oom --no-pager | sed -n '1,6p'
× lab-oom.service - /usr/bin/python3 -c b=[]; import time
while True: b.append(bytearray(10*1024*1024)); print(len(b)*10, "MB", flush=True); time.sleep(0.2)
Loaded: loaded (/run/systemd/transient/lab-oom.service; transient)
Transient: yes
Active: failed (Result: signal) since Thu 2026-09-24 11:51:04 UTC; 3s ago
Duration: 1.875s
[root@rocky9-lab ~]# journalctl -u lab-oom --no-pager -o cat | tail -6
60 MB
70 MB
80 MB
90 MB
lab-oom.service: Main process exited, code=killed, status=9/KILL
lab-oom.service: Failed with result 'signal'.
[root@rocky9-lab ~]# dmesg | grep -iE 'oom-kill|Killed process|Memory cgroup out of memory' | tail -3
[ 201.321126] python3 invoked oom-killer: gfp_mask=0xcc0(GFP_KERNEL), order=0, oom_score_adj=0
[ 201.321279] oom-kill:constraint=CONSTRAINT_MEMCG,nodemask=(null),cpuset=5a46f907edb23397a00c52e8214c9c387f1cf283dd50c13b81f6c01a58252f3b,mems_allowed=0,oom_memcg=/docker/5a46f907edb23397a00c52e8214c9c387f1cf283dd50c13b81f6c01a58252f3b/system.slice/lab-oom.service,task_memcg=/docker/5a46f907edb23397a00c52e8214c9c387f1cf283dd50c13b81f6c01a58252f3b/system.slice/lab-oom.service,task=python3,pid=5364,uid=0
[ 201.321290] Memory cgroup out of memory: Killed process 5364 (python3) total-vm:112240kB, anon-rss:102016kB, file-rss:5008kB, shmem-rss:0kB, UID:0 pgtables:252kB oom_score_adj:0
[root@rocky9-lab ~]# systemctl reset-failed lab-oom; true6. 결과 해석
| 관찰 | 의미 |
|---|---|
free -m: Swap 0 | 이 환경은 swap이 없어 메모리가 부족하면 바로 OOM 단계로 간다 |
모든 프로세스 score=666~667, adj=0 | 실습 환경(격리된 VM의 컨테이너)은 커널 정책상 oom_score_adj 변경이 막혀 있고 점수도 비슷하게 보인다. 일반 서버에서는 메모리를 많이 쓰는 프로세스일수록 점수가 높고, 대부분 한 자릿수~수십이다 |
systemd-journald OOMScoreAdjust=-250 | systemd는 journald를 덜 죽도록 설정한다. 로그 수집이 OOM에 먼저 희생되면 원인 기록도 사라지기 때문이다. (이 환경에서는 적용이 막혀 adj=0으로 보였다) |
서비스 로그 10 MB ... 90 MB 후 종료 | 100MB 한도 직전까지 할당하다 멈췄다. 애플리케이션 자체의 오류 메시지는 없다 |
code=killed, status=9/KILL, Result: signal | SIGKILL로 종료되었다. 11·13편의 status=9/KILL과 같은 형태다 |
dmesg python3 invoked oom-killer ... oom_score_adj=0 | OOM Killer를 유발한 프로세스(메모리를 요청한 쪽) |
constraint=CONSTRAINT_MEMCG, oom_memcg=.../lab-oom.service | 시스템 전체가 아니라 서비스 cgroup 한도 때문에 발생했다 |
Memory cgroup out of memory: Killed process 5364 (python3) ... anon-rss:102016kB | 종료된 프로세스와 당시 사용량(약 100MB). OOM 조사의 핵심 한 줄이다 |
7. 보안 관점
| 주제 | 내용 |
|---|---|
| 보안 에이전트 보호 | 메모리 고갈 공격이나 장애 때 EDR·로그 수집기가 먼저 죽으면 관제 공백 이 생긴다. 보안 서비스는 OOMScoreAdjust= 음수, 공격 표면이 큰 서비스는 MemoryMax=로 격리한다 |
| 메모리 고갈 DoS | 한 서비스의 메모리 누수·공격(대량 요청, 압축 폭탄)이 시스템 OOM으로 번지면 관계없는 서비스가 희생 될 수 있다. cgroup 한도로 피해를 그 서비스 안에 가둔다 |
| -1000의 위험 | oom_score_adj=-1000을 남발하면 OOM Killer가 고를 대상이 없어져 시스템이 멈춘다. 공격자가 악성 프로세스를 -1000으로 설정해 살아남으려 할 수도 있다(root 필요) |
| 증거 | OOM은 SIGKILL이라 애플리케이션 로그에 흔적이 없다. 커널 로그 보존과 중앙 수집이 필요하다 |
8. 보안관제 관점
[Detection]  서비스 다운 경보: mysqld.service failed
     ↓
[원인 분류]  journalctl -u mysqld -n 20            → code=killed, status=9/KILL ?
             journalctl -k | grep -i 'out of memory\|oom-kill'   ← 같은 시각 OOM 기록
     ↓
[OOM 이면]   시스템 OOM(전체 부족) vs memcg OOM(서비스 한도) 구분
             "invoked oom-killer" 한 프로세스 = 메모리를 요청한 쪽 (원인 후보)
             "Killed process" = 희생된 쪽 (피해자)
     ↓
[판단]       원인 프로세스가 정상 서비스의 누수인가? 알 수 없는 프로세스의 폭증인가?
     ↓
[Response] 서비스 재시작 · 원인 프로세스 조사 · MemoryMax/OOMScoreAdjust 조정| 로그 문구 | 의미 |
|---|---|
X invoked oom-killer | X가 메모리를 요청하다 OOM을 촉발했다 (X가 죽은 것은 아님) |
Out of memory: Killed process N | 시스템 전체 OOM으로 N 종료 |
Memory cgroup out of memory: Killed process N | cgroup 한도 초과로 N 종료 |
oom-kill:constraint=CONSTRAINT_NONE | 시스템 전체 |
oom-kill:constraint=CONSTRAINT_MEMCG | cgroup 한도 |
9. 실무에서 자주 발생하는 실수
| 실수 | 결과 | 예방 |
|---|---|---|
| 서비스가 죽은 원인을 앱 로그에서만 찾음 | OOM은 앱 로그에 없음 | journalctl -k, dmesg 확인 |
| "invoked oom-killer" 프로세스를 피해자로 오해 | 원인·피해 뒤바뀜 | invoked = 요청자, Killed = 피해자 |
| 중요 서비스 전부 -1000 | OOM 시 시스템 전체 정지 | 보호는 음수 일부, 격리는 MemoryMax= |
free의 free 값만 보고 여유 판단 | 캐시를 고려하지 않음 | available 기준 (07편) |
| swap을 무작정 끔/켬 | OOM 시점·성능 변화 | 서비스 특성에 맞게 설계 |
10. 실습 체크리스트
[ ] /proc/PID/oom_score 와 oom_score_adj 를 확인했다
[ ] systemctl show 로 OOMScoreAdjust 를 확인했다
[ ] MemoryMax=100M 서비스에서 OOM 종료를 재현했다
[ ] status=9/KILL 과 dmesg 의 OOM 로그를 연결했다
[ ] CONSTRAINT_MEMCG 와 시스템 OOM 을 구분했다
[ ] invoked oom-killer(요청자)와 Killed process(피해자)를 구분할 수 있다
11. 핵심 정리
- OOM Killer는 메모리를 더 줄 수 없을 때 oom_score가 가장 높은 프로세스를 SIGKILL로 종료한다.
- 시스템 전체 OOM과 cgroup(
MemoryMax=) OOM이 있으며, 후자는 그 서비스 안에서만 희생자를 고른다. oom_score_adj(-1000~+1000)와 systemdOOMScoreAdjust=로 보호·희생 우선순위를 조정한다.- OOM 종료는 애플리케이션 로그에 남지 않는다.
journalctl -k와 systemd 로그로 확인한다. - 보안 서비스는 보호하고, 위험한 서비스는 cgroup으로 격리한다.
12. 다음 편 예고
Part 3 「systemd와 서비스」를 시작하는 「21. systemd와 PID 1」 에서는 지금까지 여러 번 등장한 PID 1, systemd가 부팅 후 무엇을 하는지 정리한다. 고아 입양·좀비 회수·서비스 관리·cgroup 관리를 모두 맡는 PID 1의 역할과, systemctl이 PID 1과 통신하는 구조를 확인한다.
참고 자료
- proc_pid_oom_score_adj(5) — https://man7.org/linux/man-pages/man5/proc_pid_oom_score_adj.5.html
- Linux kernel docs — Out Of Memory handling — https://docs.kernel.org/admin-guide/mm/concepts.html
- systemd.resource-control(5) — MemoryMax, MemoryHigh — https://www.freedesktop.org/software/systemd/man/latest/systemd.resource-control.html
- systemd.exec(5) — OOMScoreAdjust — https://www.freedesktop.org/software/systemd/man/latest/systemd.exec.html
시리즈 이동
- [이전 글] 19. 세션·터미널·데몬 프로세스
- [현재 글] 20. 메모리 부족과 OOM Killer
- [다음 글] 21. systemd와 PID 1
