서비스 · 프로세스 관리 29 / 50 · Part 3. systemd와 서비스
실습 환경: Rocky Linux 9.8 · Ubuntu 24.04.5 (systemd로 부팅한 Docker 격리 컨테이너, 테스트 계정analyst)
1. 들어가며
서비스가 가끔 죽는다면 사람이 매번 재시작할 수는 없다. systemd의 Restart= 정책은 서비스가 비정상 종료했을 때 자동으로 다시 띄워 가용성을 지킨다. 하지만 설정 오류처럼 몇 번을 재시작해도 실패하는 경우에는 무한 반복이 오히려 시스템을 괴롭히므로, systemd는 StartLimit 이라는 브레이크를 둔다.
이번 글에서는 kill -9로 죽인 서비스가 되살아나는 과정과, 계속 실패하는 서비스가 StartLimit에 걸려 포기되는 과정을 로그로 확인한다. 그리고 이 자동 재시작이 악성 프로세스의 지속성 에도 쓰인다는 점을 관제 관점에서 짚는다.
2. 핵심 개념
2-1. 재시작 관련 설정 ([Service])
| 설정 | 의미 | 기본값 |
|---|---|---|
Restart= | 어떤 종료에서 재시작할지 | no |
RestartSec= | 재시작 전 대기 시간 | 100ms |
RestartPreventExitStatus= | 이 종료 코드면 재시작하지 않음 | — |
RestartForceExitStatus= | 이 종료 코드면 무조건 재시작 | — |
WatchdogSec= | 서비스가 주기적 신호를 보내지 않으면 멈춘 것으로 간주 | — |
2-2. 재시작 제한 ([Unit])
| 설정 | 의미 | 기본값 |
|---|---|---|
StartLimitIntervalSec= | 제한을 세는 기간 | 10초 |
StartLimitBurst= | 기간 안에 허용되는 시작 횟수 | 5 |
StartLimitAction= | 제한 초과 시 동작 (none, reboot 등) | none |
기간 안에 Burst를 넘기면 서비스는 failed가 되고, 이후에는 수동 systemctl start도 거부 된다. systemctl reset-failed로 카운터를 초기화해야 다시 시작할 수 있다.
2-3. 정책 선택 기준
| 정책 | 적합한 경우 |
|---|---|
on-failure | 대부분의 서비스 권장값. 오류·크래시에만 재시작 |
always | 끝나면 안 되는 상주 에이전트 (정상 종료해도 재시작) |
on-abnormal | 오류 코드는 의도적 종료로 보고, 크래시만 재시작 |
no | 일회성 작업, 수동 관리 서비스 |
3. 동작 원리
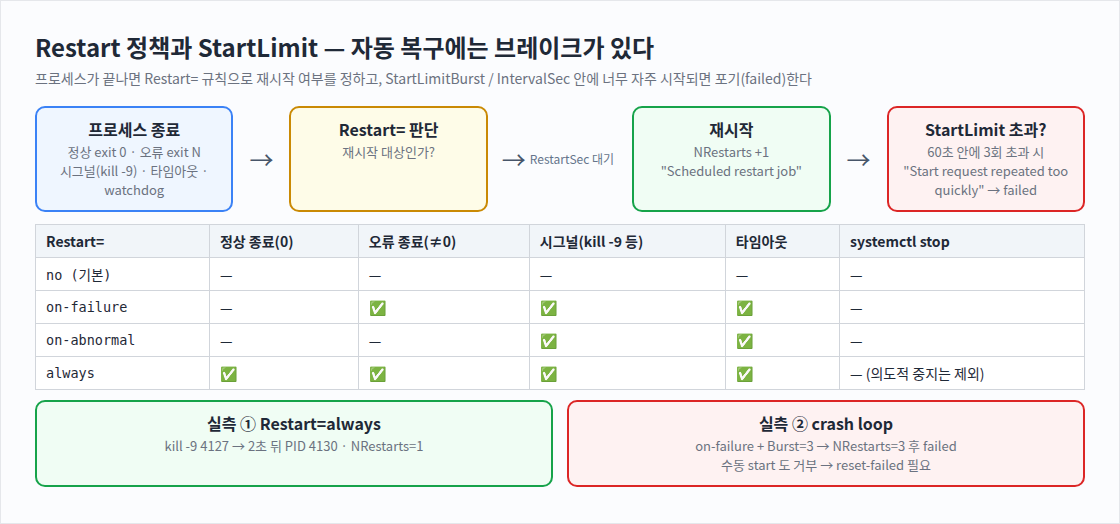
[Restart=always, RestartSec=2]
kill -9 4127 → 커널: 4127 종료 → PID 1 이 SIGCHLD 수신
  → "Main process exited, code=killed, status=9/KILL" → Result='signal'
  → Restart=always → 2초 대기 → "Scheduled restart job, restart counter is at 1"
  → 새 프로세스 4130

[Restart=on-failure, StartLimitBurst=3, StartLimitIntervalSec=60]
시작 → 1초 후 exit 1 → 재시작 #1 → exit 1 → #2 → exit 1 → #3
  → 60초 안에 4번째 시작 시도 → "Start request repeated too quickly" → failed (포기)
systemctl stop으로 멈춘 서비스는 Restart=always여도 재시작하지 않는다. systemd는 의도적 중지와 비정상 종료를 구분 한다. 반면 kill은 비정상 종료로 보이므로 재시작된다(13편의 "kill 대신 systemctl stop" 원칙).
4. 명령어 실습
# 1) Restart=always 서비스를 kill -9
printf '[Unit]\nDescription=Lab always\n[Service]\nExecStart=/bin/sleep infinity\nRestart=always\nRestartSec=2\n' > /etc/systemd/system/lab-always.service
systemctl daemon-reload; systemctl start lab-always
P1=$(systemctl show lab-always -p MainPID --value); echo "PID=$P1"
kill -9 $P1; sleep 3
echo "PID=$(systemctl show lab-always -p MainPID --value) NRestarts=$(systemctl show lab-always -p NRestarts --value)"
journalctl -u lab-always --no-pager -o cat | tail -4
systemctl stop lab-always; systemctl is-active lab-always      # stop 은 재시작하지 않음

# 2) 1초 만에 exit 1 하는 서비스 + 60초에 3회 제한
printf '[Unit]\nDescription=Lab crashloop\nStartLimitIntervalSec=60\nStartLimitBurst=3\n[Service]\nExecStart=/bin/bash -c "echo starting; sleep 1; exit 1"\nRestart=on-failure\nRestartSec=1\n' > /etc/systemd/system/lab-crash.service
systemctl daemon-reload; systemctl start lab-crash; sleep 12
systemctl show lab-crash -p ActiveState,Result,NRestarts --no-pager
journalctl -u lab-crash --no-pager -o short-precise | grep -iE 'Scheduled restart|start request repeated|Failed with' | tail -4
systemctl start lab-crash; systemctl is-active lab-crash       # 제한 상태에서 수동 시작
systemctl reset-failed lab-crash; systemctl show lab-crash -p ActiveState,Result
5. 실행 결과
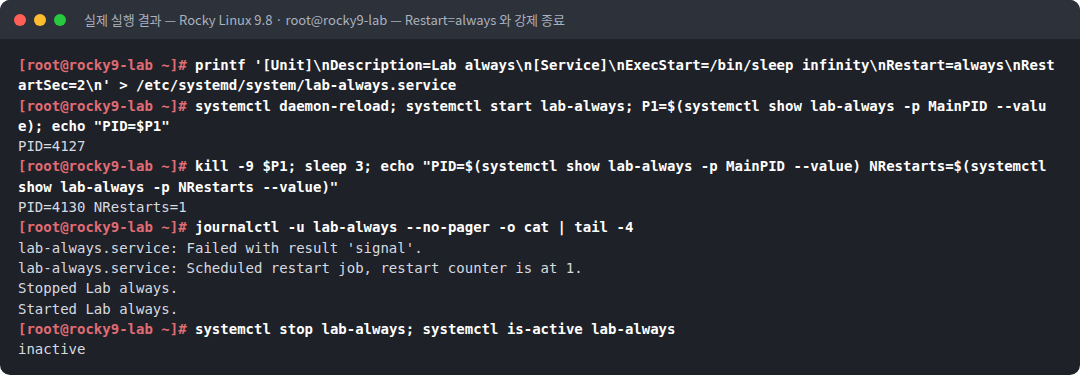
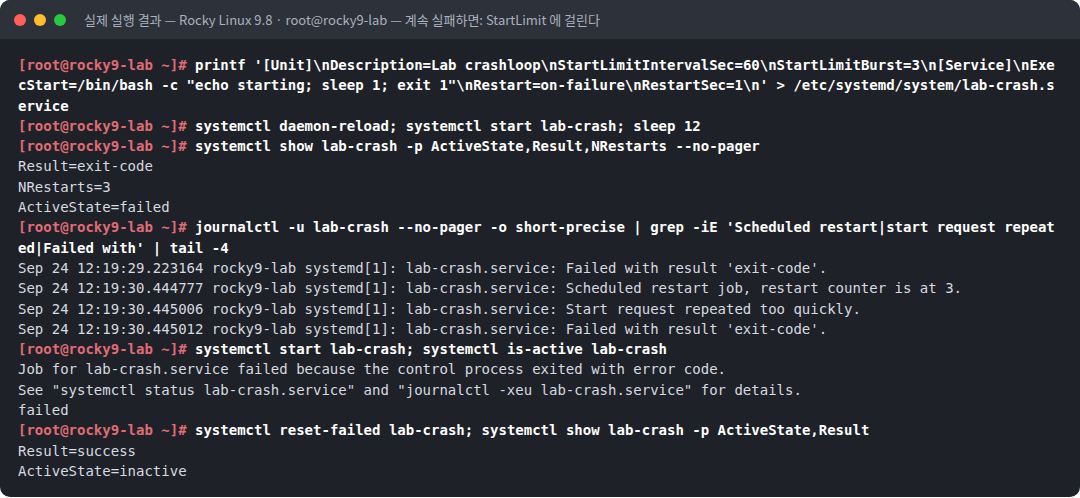
텍스트 원본(실제 출력):
[root@rocky9-lab ~]# printf '[Unit]\nDescription=Lab always\n[Service]\nExecStart=/bin/sleep infinity\nRestart=always\nRestartSec=2\n' > /etc/systemd/system/lab-always.service
[root@rocky9-lab ~]# systemctl daemon-reload; systemctl start lab-always; P1=$(systemctl show lab-always -p MainPID --value); echo "PID=$P1"
PID=4127
[root@rocky9-lab ~]# kill -9 $P1; sleep 3; echo "PID=$(systemctl show lab-always -p MainPID --value) NRestarts=$(systemctl show lab-always -p NRestarts --value)"
PID=4130 NRestarts=1
[root@rocky9-lab ~]# journalctl -u lab-always --no-pager -o cat | tail -4
lab-always.service: Failed with result 'signal'.
lab-always.service: Scheduled restart job, restart counter is at 1.
Stopped Lab always.
Started Lab always.
[root@rocky9-lab ~]# systemctl stop lab-always; systemctl is-active lab-always
inactive
[root@rocky9-lab ~]# printf '[Unit]\nDescription=Lab crashloop\nStartLimitIntervalSec=60\nStartLimitBurst=3\n[Service]\nExecStart=/bin/bash -c "echo starting; sleep 1; exit 1"\nRestart=on-failure\nRestartSec=1\n' > /etc/systemd/system/lab-crash.service
[root@rocky9-lab ~]# systemctl daemon-reload; systemctl start lab-crash; sleep 12
[root@rocky9-lab ~]# systemctl show lab-crash -p ActiveState,Result,NRestarts --no-pager
Result=exit-code
NRestarts=3
ActiveState=failed
[root@rocky9-lab ~]# journalctl -u lab-crash --no-pager -o short-precise | grep -iE 'Scheduled restart|start request repeated|Failed with' | tail -4
Sep 24 12:19:29.223164 rocky9-lab systemd[1]: lab-crash.service: Failed with result 'exit-code'.
Sep 24 12:19:30.444777 rocky9-lab systemd[1]: lab-crash.service: Scheduled restart job, restart counter is at 3.
Sep 24 12:19:30.445006 rocky9-lab systemd[1]: lab-crash.service: Start request repeated too quickly.
Sep 24 12:19:30.445012 rocky9-lab systemd[1]: lab-crash.service: Failed with result 'exit-code'.
[root@rocky9-lab ~]# systemctl start lab-crash; systemctl is-active lab-crash
Job for lab-crash.service failed because the control process exited with error code.
See "systemctl status lab-crash.service" and "journalctl -xeu lab-crash.service" for details.
failed
[root@rocky9-lab ~]# systemctl reset-failed lab-crash; systemctl show lab-crash -p ActiveState,Result
Result=success
ActiveState=inactive6. 결과 해석
| 관찰 | 의미 |
|---|---|
kill -9 후 PID 4127 → 4130, NRestarts=1 | systemd가 강제 종료를 감지하고 2초 뒤 새 프로세스를 띄웠다 |
Failed with result 'signal' → Scheduled restart job, restart counter is at 1 | 종료 원인과 재시작 예약이 로그에 순서대로 남는다 |
systemctl stop 후 inactive 유지 | 의도적 중지는 재시작 대상이 아니다 |
crash loop: NRestarts=3, ActiveState=failed | 3번 재시작한 뒤 한도에 걸려 멈췄다 |
Start request repeated too quickly. | StartLimit에 걸렸다는 핵심 로그. 관제에서 이 문구를 경보로 잡는다 |
Result=exit-code | systemd 252에서는 마지막 실패 원인(exit-code)이 유지된다. 버전에 따라 start-limit-hit로 표시되기도 한다 |
수동 start도 failed | 한도 기간 동안은 사람이 시작해도 거부된다 |
reset-failed 후 inactive / success | 카운터가 초기화되어 다시 시작할 수 있는 상태 |
7. 보안 관점
| 주제 | 내용 |
|---|---|
| 악성 지속성 | 악성 unit은 Restart=always + 짧은 RestartSec을 쓴다. 관제 요원이 kill로 프로세스를 죽여도 몇 초 뒤 다시 살아난다. 먼저 systemctl disable --now 또는 mask로 unit을 멈춰야 한다 |
| 조치 순서 | "프로세스를 죽였는데 계속 살아나요" → 부모(PPID 1 = systemd)와 cgroup을 보면 어느 unit이 재시작하는지 알 수 있다 (18편) |
| 크래시 반복 | 네트워크 서비스가 core-dump로 반복 재시작되면 원격 익스플로잇 시도 가능성이 있다. 재시작이 가용성은 지키지만 공격자에게 반복 시도 기회를 준다 |
| 보안 에이전트 | 반대로 EDR·로그 수집기는 Restart=always로 보호해, 공격자가 kill해도 복구되게 한다. 이때 재시작 기록(NRestarts)이 공격 흔적 이 된다 |
8. 보안관제 관점
[Detection]  의심 프로세스를 kill 했으나 수 초 후 같은 이름으로 재등장
     ↓
[원인 unit]  cat /proc/<새 PID>/cgroup            → .../system.slice/sys-helper.service
             systemctl show sys-helper -p Restart,RestartUSec,NRestarts,FragmentPath
     ↓
[판단]       Restart=always, RestartSec=5, 패키지 미소유 unit → 악성 지속성
     ↓
[Response]   ① systemctl disable --now sys-helper   (또는 mask)
             ② 프로세스·실행 파일 증거 수집
             ③ unit 파일 격리 → daemon-reload
④ 재등장 여부 확인 (cron·타이머 등 다른 지속성도 점검, 45·46편)| 경보로 삼을 로그 | 의미 |
|---|---|
Scheduled restart job, restart counter is at N | 서비스가 비정상 종료 후 재시작됨 |
Start request repeated too quickly | 재시작 한도 초과 — 서비스 중단 상태 |
code=dumped, status=11/SEGV 반복 | 크래시 반복 (버그 또는 공격) |
9. 실무에서 자주 발생하는 실수
| 실수 | 결과 | 예방 |
|---|---|---|
모든 서비스에 Restart=always | 설정 오류도 무한 재시작, 로그 폭주 | 기본은 on-failure |
| StartLimit에 걸린 서비스를 계속 start | 거부됨 | 원인 수정 → reset-failed → start |
| 악성 프로세스를 kill만 함 | 재시작으로 되살아남 | unit을 disable/mask 후 종료 |
| RestartSec을 너무 짧게 | 의존 서비스 준비 전 반복 실패 | 수 초 이상, 필요 시 의존성·순서 보강 |
| StartLimit을 unit의 [Service]에 작성 | 무시됨 (systemd 230+) | [Unit] 섹션에 작성 |
10. 실습 체크리스트
[ ] Restart=always 서비스를 kill -9 로 죽이고 재시작을 확인했다
[ ] NRestarts 값과 Scheduled restart 로그를 확인했다
[ ] systemctl stop 은 재시작되지 않는 것을 확인했다
[ ] StartLimitBurst 초과 후 "Start request repeated too quickly" 를 확인했다
[ ] 한도 상태에서 수동 start 가 거부되고 reset-failed 로 풀리는 것을 확인했다
[ ] 재생성되는 악성 프로세스를 unit 단위로 차단하는 순서를 설명할 수 있다
11. 핵심 정리
Restart=는 종료 유형에 따라 자동 재시작 여부를 정한다. 권장값은on-failure다.systemctl stop은 의도적 중지로 재시작되지 않지만,kill은 비정상 종료로 보고 재시작된다.- StartLimitIntervalSec/Burst를 넘으면
Start request repeated too quickly와 함께 failed가 되고,reset-failed전까지 시작이 거부된다. - 악성 unit의
Restart=always는 kill만으로 제거되지 않는다. unit을 먼저 멈추고 프로세스를 처리한다. - NRestarts와 재시작 로그는 장애·공격의 흔적이다.
12. 다음 편 예고
Part 3의 마지막 글 「30. 서비스 계정과 최소 권한 실행」 에서는 서비스를 어떤 계정으로 실행해야 하는지 다룬다. root 서비스와 DynamicUser= 서비스의 Capability 차이 를 비교하고, 일반 계정이 80번 포트를 열 수 있게 필요한 권한 하나만 부여하는 방법을 실습한다.
참고 자료
- systemd.service(5) — Restart=, RestartSec= — https://www.freedesktop.org/software/systemd/man/latest/systemd.service.html
- systemd.unit(5) — StartLimitIntervalSec=, StartLimitBurst= — https://www.freedesktop.org/software/systemd/man/latest/systemd.unit.html
- MITRE ATT&CK T1543.002 Systemd Service — https://attack.mitre.org/techniques/T1543/002/
시리즈 이동
- [이전 글] 28. drop-in으로 서비스 설정 변경 (systemctl edit)
- [현재 글] 29. Restart 정책과 서비스 자동 복구
- [다음 글] 30. 서비스 계정과 최소 권한 실행
