HTML 문서
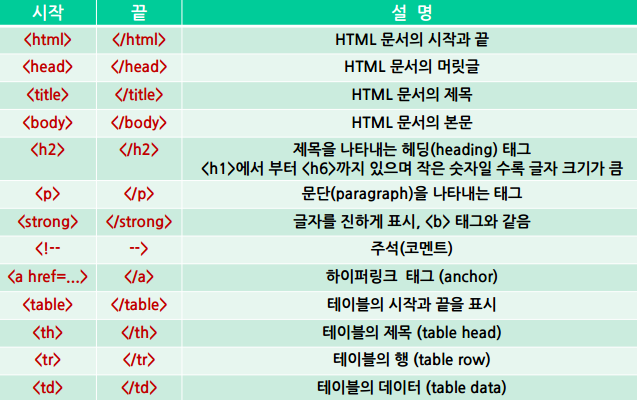
HTML (Hyper Text Markup language)
- 웹에서 사용될 하이퍼 텍스트 문서를 만들기 위한 언어
- 태그 (tag)를 기반으로 원하는 정보를 표현
웹 크롤링
웹 크롤링은 웹 페이지에서 원하는 정보를 추출하는 소프트웨어 기법
- 웹 스크레이핑(Web Scraping) 이라고도 함
- 웹 크롤러(Web Crawler)는 페이지를 방문해서 자료를 수집하는 일을 하는 프로그램
파이썬에서는 웹 크롤링을 위한 뷰티풀 수프(Beautiful Soup) 라이브러리를 제공
- HTML, XML 문서를 구문 분석 (파싱, parsing)하는 라이브러리
- 아나콘다에는 prog 가상환경에 이미 뷰티풀 수프 이미 설치되어 있음
- 필요하다면 pip install beautifulsoup4 명령어를 터미널에 입력하여 설치 가능
뷰티풀 수프
뷰티풀 수프 객체 생성
-
from bs4 import BeautifulSoup
soup = BeautifulSoup(html, 'htmlparser') -
urllib.request.urlopen() 등으로 읽어들인 HTML 문서
HTML 문서 태그 검색 메서드
- soup.find_all(태그이름, 태그 속성)
- 지정된 태그 모두를 검색, 검색 결과는 리스트
- ㅐ그 속성은 {'속성명' : '값' , ...}
- soup.find(name.attrs)
- 지정된 첫 번째 태그만 검색
뷰티풀 수프 - 사용 예
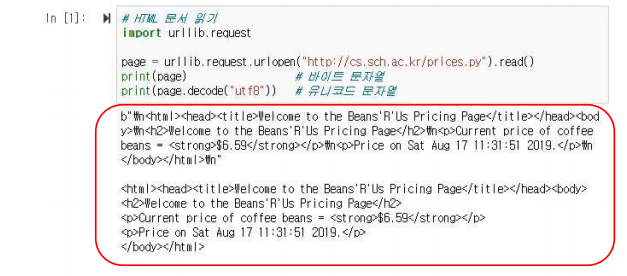
# HTML 문서 읽기
import urllib.request
page = urllib.request.urlopen("https://cs.sch.ac.krprices.py").read()
print(page) # 바이트 문자열
print(page.decode("utf8)) # 유니코드 문자열

# 뷰티풀 수프 객체 생성
from bs4 import BeautifulSoup
soup = BeautifulSoup(page. 'html.parser')

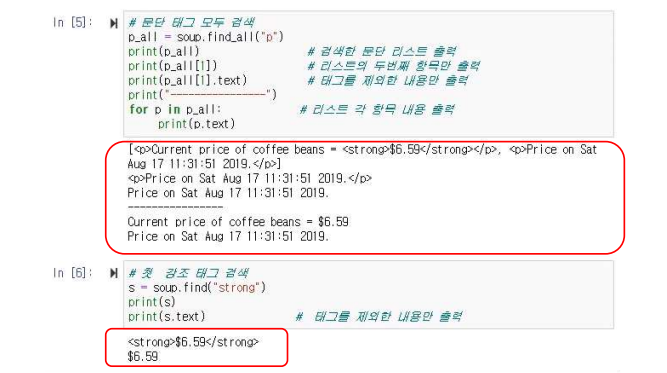
# 문단 태그 모두 검색
p_all = soup.find_all("p")
print(p_all) # 검색한 문단 리스트 출력
print(p_all[1]) # 리스트 두번째 항목만 출력
print(p_all[1].text) # 태그를 제외한 내용만 출력
print("-------------")
for p in p_all:
  print(p.text) # 리스트 각 항목 내용 출력

# 첫 강조 태그 검색
s = soup.find("strong")
print(s)
print(s.text) # 태그를 제외한 내용만 출력
뷰티풀 수프 - 실행 예 (1)
뷰티풀 수프 - 실행 예 (2)
기상 페이지 웹 크롤링 예
기상청 현재 날씨 관측자료를 크롤링하여 파일로 저장하는 예
- 기상청의 관측 자료에서 도시별 현재 날씨 페이지
- https://www.weather.go.kr/w/obs-climate/land/city-obs.do
기상청 페이지 분석
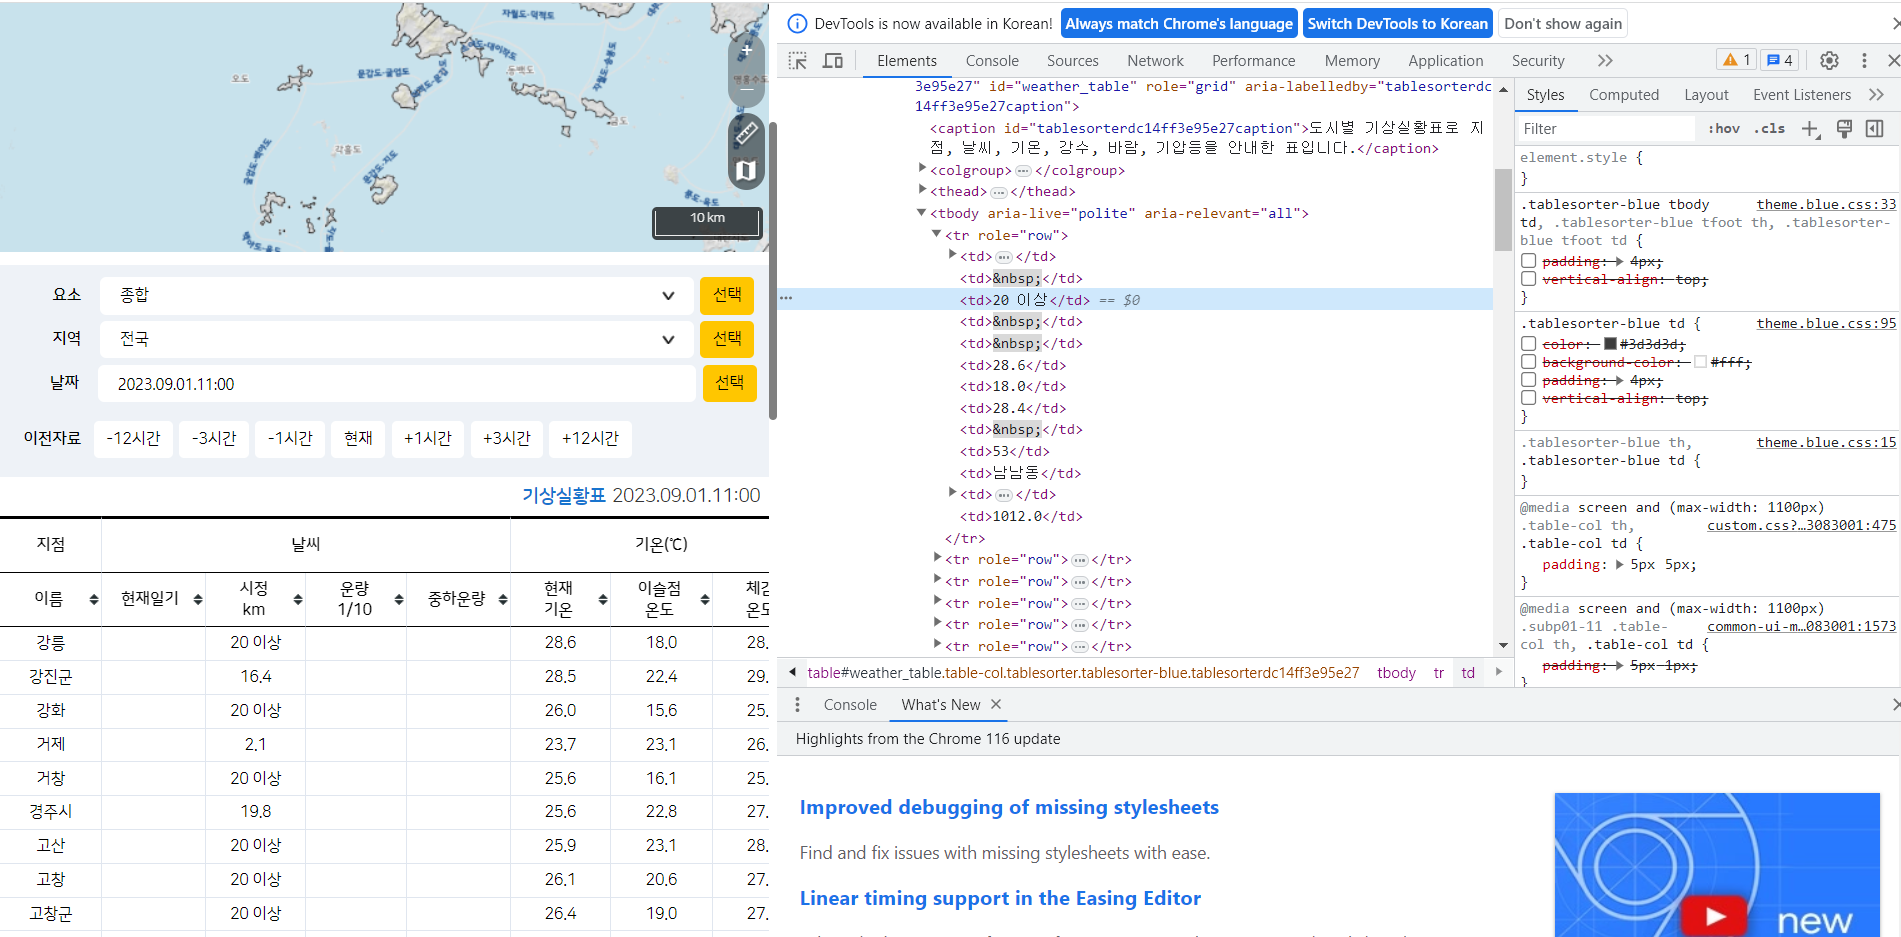
웹 크롤링을 위해서는 해당 페이지의 화면과 HTML과의 연관성을 분석해야 함
- 크롬(Chrome) 웹 브라우저의 개발자 도구 활용
- F12 누르면 개발자 도구 표시
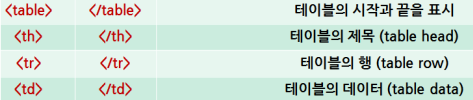
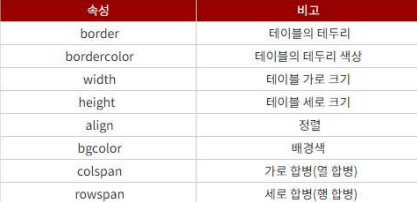
HTML 테이블
기상청 페이지 분석 - 테이블 HTML 분석
페이지의 서울을 클릭하여 관련 태그 및 테이블 분석
- < table >에서 도시 별 데이터는 < tr > 태그로 표시
- 데이터 값은 < td > 태그로 표시
- < td > 태그 안에 < a > 태그에 도시 이름
- 기온은 여섯 번째(인덱스 5) < td >의 값
- 습도는 열 번째(인덱스 9) < td >의 값
기상청 웹 크롤링 코드
#!/usr/bin/env python
# coding: utf-8

import urllib.request
from bs4 import BeautifulSoup

# 기상청 현재 날씨 페이지 읽기
page = urllib.request.urlopen("https://www.weather.go.kr/weather/observation/currentweather.jsp").read()
soup = BeautifulSoup(page, 'html.parser') # 뷰티풀 수프 객체 생성

# 현재 날씨 테이블 검색
table = soup.find('table', {'id': 'weather_table'}) # 테이블 시작, <table id = "weather_table"> 검색

# 데이터 저장 리스트 생성
data = []

# 모든 <tr> 태그를 검색 후 각 도시의 데이터를 가져옴
for tr in table.find_all('tr'):  # 각 도시의 행 tr에 대해 반복
    tds = list(tr.find_all('td'))  # 모든 <td> 태그를 검색해 한 도시의 데이터 (날씨) 리스트 생성
    if tds:  # <td> 태그가 있는 경우만 처리, 사실상 필요 없음
        if tds[0].find('a'):  # <td> 안에 <a> 태그가 있으면 (표 제목이 아니고 도시의 행인지 확인)
            point = tds[0].find('a').text  # <a> 태그 안에서 도시를 가져옴
            temperature = tds[5].text  # <td> 태그 리스트의 여섯 번째(인덱스 5)에서 기온을 가져옴
            humidity = tds[9].text  # <td> 태그 리스트의 열 번째(인덱스 9)에서 습도를 가져옴
            data.append([point, temperature, humidity])  # data 리스트에 도시, 기온, 습도를 추가

# 리스트 data 출력
print(data)
# 데이터 저장할 리스트 생성

# 리스트 data를 보기 좋게 출력하기 위한 코드
for item in data:
    print(f"[지역: {item[0]}, 기온: {item[1]}, 습도: {item[2]}]")
기상청 웹 크롤링 코드 + 시간 추가 코드
#!/usr/bin/env python
# coding: utf-8

import urllib.request
from bs4 import BeautifulSoup

# 기상청 현재 날씨 페이지 읽기
page = urllib.request.urlopen("https://www.weather.go.kr/weather/observation/currentweather.jsp").read()
soup = BeautifulSoup(page, 'html.parser')  # 뷰티풀 수프 객체 생성

# 날짜와 시간 정보 가져오기
date_time_info = soup.find('div', {'class': 'cmp-table-topinfo'}).text.replace("기상실황표", "").strip()
print("날짜와 시간:", date_time_info)  # 날짜와 시간 정보 출력

# 현재 날씨 테이블 검색
table = soup.find('table', {'id': 'weather_table'})  # 테이블 시작, <table id = "weather_table"> 검색

# 데이터 저장 리스트 생성
data = []

# 모든 <tr> 태그를 검색 후 각 도시의 데이터를 가져옴
for tr in table.find_all('tr'):  # 각 도시의 행 tr에 대해 반복
    tds = list(tr.find_all('td'))  # 모든 <td> 태그를 검색해 한 도시의 데이터 (날씨) 리스트 생성
    if tds:  # <td> 태그가 있는 경우만 처리
        if tds[0].find('a'):  # <td> 안에 <a> 태그가 있으면 (표 제목이 아니고 도시의 행인지 확인)
            point = tds[0].find('a').text  # <a> 태그 안에서 도시를 가져옴
            temperature = tds[5].text  # <td> 태그 리스트의 여섯 번째(인덱스 5)에서 기온을 가져옴
            humidity = tds[9].text  # <td> 태그 리스트의 열 번째(인덱스 9)에서 습도를 가져옴
            data.append([point, temperature, humidity])  # data 리스트에 도시, 기온, 습도를 추가

# 리스트 data 출력
for item in data:
    print(f"[지역: {item[0]}, 기온: {item[1]}, 습도: {item[2]}]")
왕초보입니다