머신 러닝 처리 절차
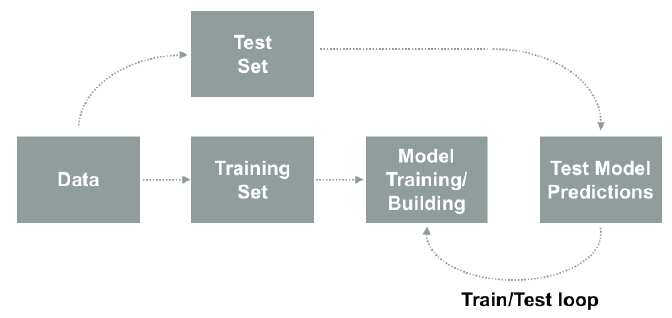
머신 러닝 처리 절차
- 샘플 데이터를 적재
- 데이터를 모델 학습(훈련)용과 테스트용으로 분할
- 학습 데이터로 모델을 학습하고 구축
학습 데이터로 예측하고 결과 관측 - 테스트 데이터로 모델 테스트
MNIST 데이터 소개 (1)
손글씨 숫자의 이미지로부터 숫자를 인식하는 MNIST 예
- MNIST(Modified National Institute of Standards and Technology Database)
1988년 공개 (미국 고등학생과 인구조사국 직원 손글씨) - 학습용 60000개와 테스트용 1만개로 이루어진 흑백 이미지 데이터
- 28 X 28 픽셀 크기의 이미지
- 지도 학습을 위해 이미지 데이터에는 어떤 숫자인지를 나타내는 라벨(label) 정보가 포함
MNIST 데이터 소개 (2)
한 이미지는 28 X 28 = 784 개 원소의 벡터
- 원본 데이터는 0~255 사이의 값으로 각 픽셀의 검은 정도가 표시
- 0과 1 사이의 값으로 정규화하여 학습
한 라벨은 0에서 9까지의 숫자로 구성된 10개의 원소 벡터
각 데이터는 훈련용 6000개, 테스트용 10000개로 구성
MNIST 데이터 적재
파이토치의 torchvision.datasets.MNIST를 사용하여 MNIST 데이터 다운로드
-
이미지 데이터와 라벨(타겟) 다운로드
다운로드된 객체의 data, targets 속성에 이미지와 라벨 데이터 저장 -
훈련 데이터: train_data
이미지: 60000 X 28 X 28 3차원 배열, 라벨: 60000개의 원소의 1차원 배열 -
테스트 데이터: test_data
이미지 10000 X 28 X 28 3차원 배열, 라벨: 10000개의 원소의 1차원 배열
MNIST 데이터: 이미지 표시
matplotlib.pyplot 모듈 사용하여 학습용 이미지 데이터 중 첫 25개를 화면에 표시
-
subplot(5, 5, i+1)
5 X 5 그리드에 i+1 순서대로 여러 개의 그림을 표시 -
imshow (train_data.data[i], cmap='gray')
i 번째 학습용 데이터 28 X 28 픽셀을 화면에 표시
cmap(color map)은 흑백 이미지 (그레이 스케일 적용)
MNIST 데이터 전처리: 픽셀 데이터 변환
0-255 값의 픽셀 데이터를 0-1 사이의 실수 값으로 정규화
- 데이터 값의 범위를 좁혀서 학습의 수렴 속도를 빠르게 함
- 배열 데이터의 형을 실수로 변경하고 각 픽셀 값을 255로 나눔
MNIST 신경망 계층 구조 (1)
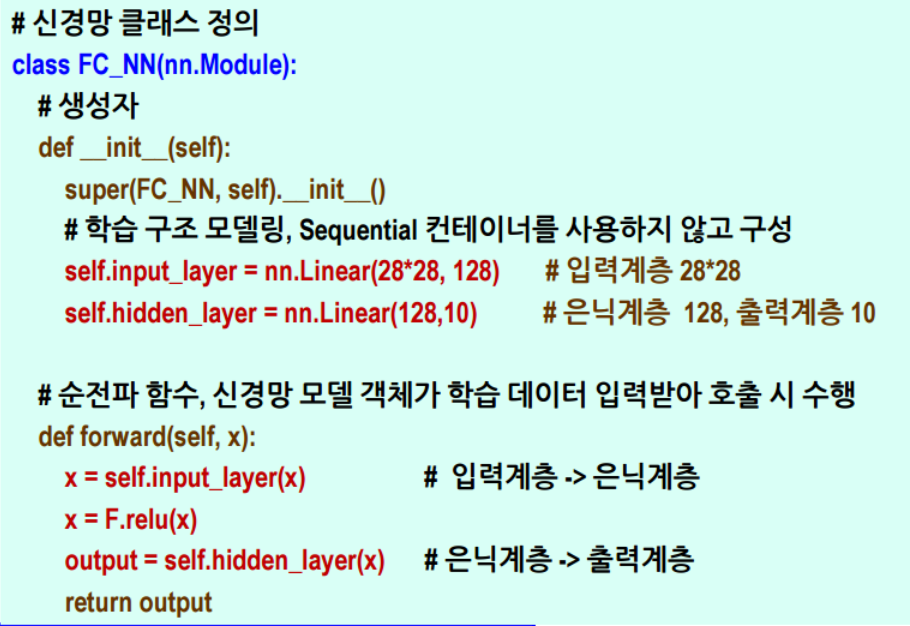
계층 구조
-
입력 계층: 784(28 X 28)개 픽셀
학습 시 28 X 28 2차원 입력을 784개의 1차원 구조로 변환하여 입력 -
은닉 계층: 128개의 뉴런(노드)을 갖는 은닉 계층 1개
relu 활성화 홤수 -
출력 계층: 10개의 숫자 분류
다중 분류를 위해 softmax 활성화 함수
MNIST 신경망 계층 구조 (2)
소프트 맥스 함수 (Softmax Function) (1)
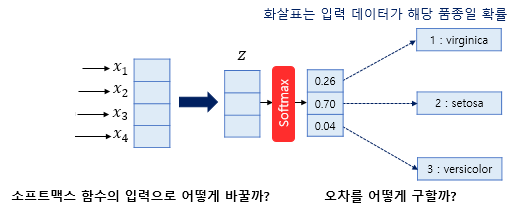
출력 계층에서 두개 이상의 카테고리(클래스)로 데이터를 분류하고 싶을 때에는 시그모이드 함수의 일반화된 형태인 소프트맥스(Softmax) 활성화 함수를 사용
소프트 맥스 함수 (Softmax Function)
- 출력 계층에서 두개 이상의 카테고리(클래스)로 데이터를 분류 시 사용
- 각 클래스에 대한 확률을 생성
- 각 클래스의 확률의 합은 1 이고 가장 높은 값을 가진 클래스가 결과 값이 될 가능성이 가장 높음
- MNIST 예에서는 0~9 까지 각 숫자와 얼마나 비슷한 지에 대한 결과를 10개의 확률을 생성
소프트 맥스 함수 (SOftmax Function) (2)
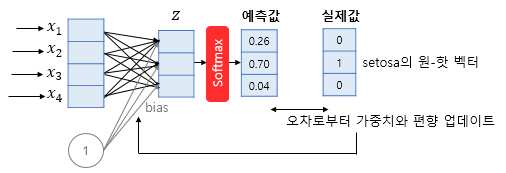
- 입력 값을 모두 지수 값으로 바꾸어 아래와 같이 출력의 합이 1인 확률 함수로 정규화
지수 함수를 사용하여 가중치를 크게 하는 효과
i번째 클래스가 정답일 확률
k차원 벡터의 입력
소프트 맥스 함수 (SOftmax Function) (3)
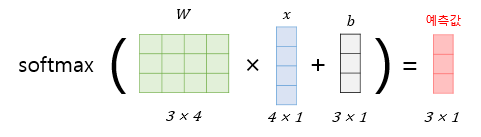
크로스 엔트로피 (Cross Entropy) 손실 함수 (1)
소프트맥스 함수 등과 같은 클래스 분류 모델의 비용(에러, 손실) 함수로는 교차 엔트로피 (cross entropy) 비용함수 적용
엔트로피 (entropy)
-
정보 이론에서 모든 사건 정보량의 기대값으로 전체 사건의 확률 분포의 불확실성 정도를 측정
물리 시스템에서는 혼돈의 정도를 측정하는 척도 -
사건을 관측할 정보량은 확률에 반비례
잘 일어나지 않는 사건은 자주 발생하는 사건보다 정보량이 많음
크로스 엔트로피 (Cross Entropy) 손실 함수 (2)
교차 엔트로피 비용함수
-
실제 확률값(라벨 데이터의 원핫 벡터)와 클래스의 예측 활륙 밧의 곱
-
모델이 예측한 값이 실제 값을 설명하는데 얼마나 비효율적인지를 나타냄
-
값이 적을수록 정확한 예측을 나타낸다는 특징이 있음
가중치 최적화 기법
최적의 가중치 값을 구하는 기법
-
확률론적 경사하강법 (Stocastic Gradient Decent, SDG)
미분의 기울기를 구하여 감소 방향으로 가중치를 갱신 -
모멘텀 (Momentum)
경사하강법에 관성을 도입 -
AdaGrad (Adaptive Gradient)
학습을 진행하면서 학습 속도를 적응적으로 조정 -
RmSProp
AdaGrad에서 갱신량이 0이되는 문제를 개선 -
Adam (Adaptive Moment Estimation)
RMSProp와 AdaGrad의 하이브리드 기법
에포크 (epoch), 미니 배치(batch)
머신 러닝은 전체 데이터 세트에 대해 반복적으로 학습하여 모델의 정확도를 향상
- 에포크(epoch)는 전체 데이터 세트에 대한 반복 학습하는 주기
미니 배치(Mini_Batch) 경사하강법
-
대용량 데이터로 학습하는 경우 데이터 세트의 각 레코드마다 학습(가중치 / 파라미터 업데이트)하면 많은 계산을 수행하여 실행 시간이 오래 걸림
-
전체 데이터를 몇 개의 데이터 세트로 분할한 미니 배치(mini batch) 크기 단위로 학습하여 계산량을 줄임