FFI란?
개요 및 예제
FFI(Foreign Function Interface)는 외부 함수 인터페이스로, 하나의 프로그래밍 언어에서 다른 프로그래밍 언어로 작성된 함수나 라이브러리를 호출할 때 사용할 수 있다.
Node.js에서도 자바스크립트 언어가 C, C++과 같은 언어로 컴파일된 네이티브 함수를 호출할 수 있도록 하기 위해 최근 node:ffi와 관련된 모듈에 다양한 기능들을 추가하고 있다.
Node.js FFI는 v26.1.0에 들어왔으며, 아직까지는 Stability:1 - Experimental 인 상태로 활발히 개발 중에 있다.
간단하게 FFI를 어떻게 사용할 수 있는지 예제와 함께 살펴보자.
// app.js
import { dlopen, suffix } from 'node:ffi';

{
  using handle = dlopen(`./mylib.${suffix}`, {
    add_i32: { arguments: ['int32', 'int32'], return: 'int32' },
  });
  console.log(handle.functions.add_i32(20, 22)); // 42
} // handle.lib.close() is invoked automatically here.
위 JS 코드는 node:ffi 안에 정의된 dlopen과 suffix 함수를 호출하고 있다.
컴파일된 네이티브 코드의 경로와 호출할 함수의 시그니처를 dlopen()을 통해 전달하면 네이티브 함수를 다룰 수 있는 handle을 반환하게 된다. 그리고 이 handle을 통해 정의한 함수를 타입에 맞게 호출한다면 정상적으로 42의 값을 출력할 수 있다.
추가로 using을 사용하여 블록 스코프 내부에서 함수를 실행했기 때문에, 블록을 벗어나면 자동으로 실행된 함수가 마무리되어 handle.lib.close()가 호출되고 자원이 정리된다.
그렇다면
./mylib.${suffix}의 경로에는 어떤 파일이 있어야 호출이 가능할까?
// mylib.c
#include <stdint.h>

int32_t add_i32(int32_t a, int32_t b) {
  return a + b;
}
간단한 예제로 int32타입의 두 개의 매개변수를 받고 그 합을 반환하는 함수를 C언어로 작성하였다. 경로에서 ${suffix}와 같이 동적으로 확장자를 받는 이유는, 운영체제에 따라 확장자가 다르기 때문이다.
| 운영체제 | 확장자 |
|---|---|
| macOS | .dylib |
| Linux 및 Unix 계열 | .so |
| Windows | .dll |
자바스크립트 런타임 중에 컴파일된 네이티브 함수를 실행하려면, 런타임 시점에 해당 함수를 메모리에 로드할 수 있는 동적 라이브러리가 필요하다. 이 동적 라이브러리의 확장자를 suffix를 통해 운영체제에 따라 확정지어 호출할 수 있는 것이다.
mylib.c를 컴파일하면 macOS 기준 mylib.dylib라는 파일로 컴파일을 할 수 있게 된다.
clang -dynamiclib mylib.c -o mylib.dylib간단한 데이터 흐름
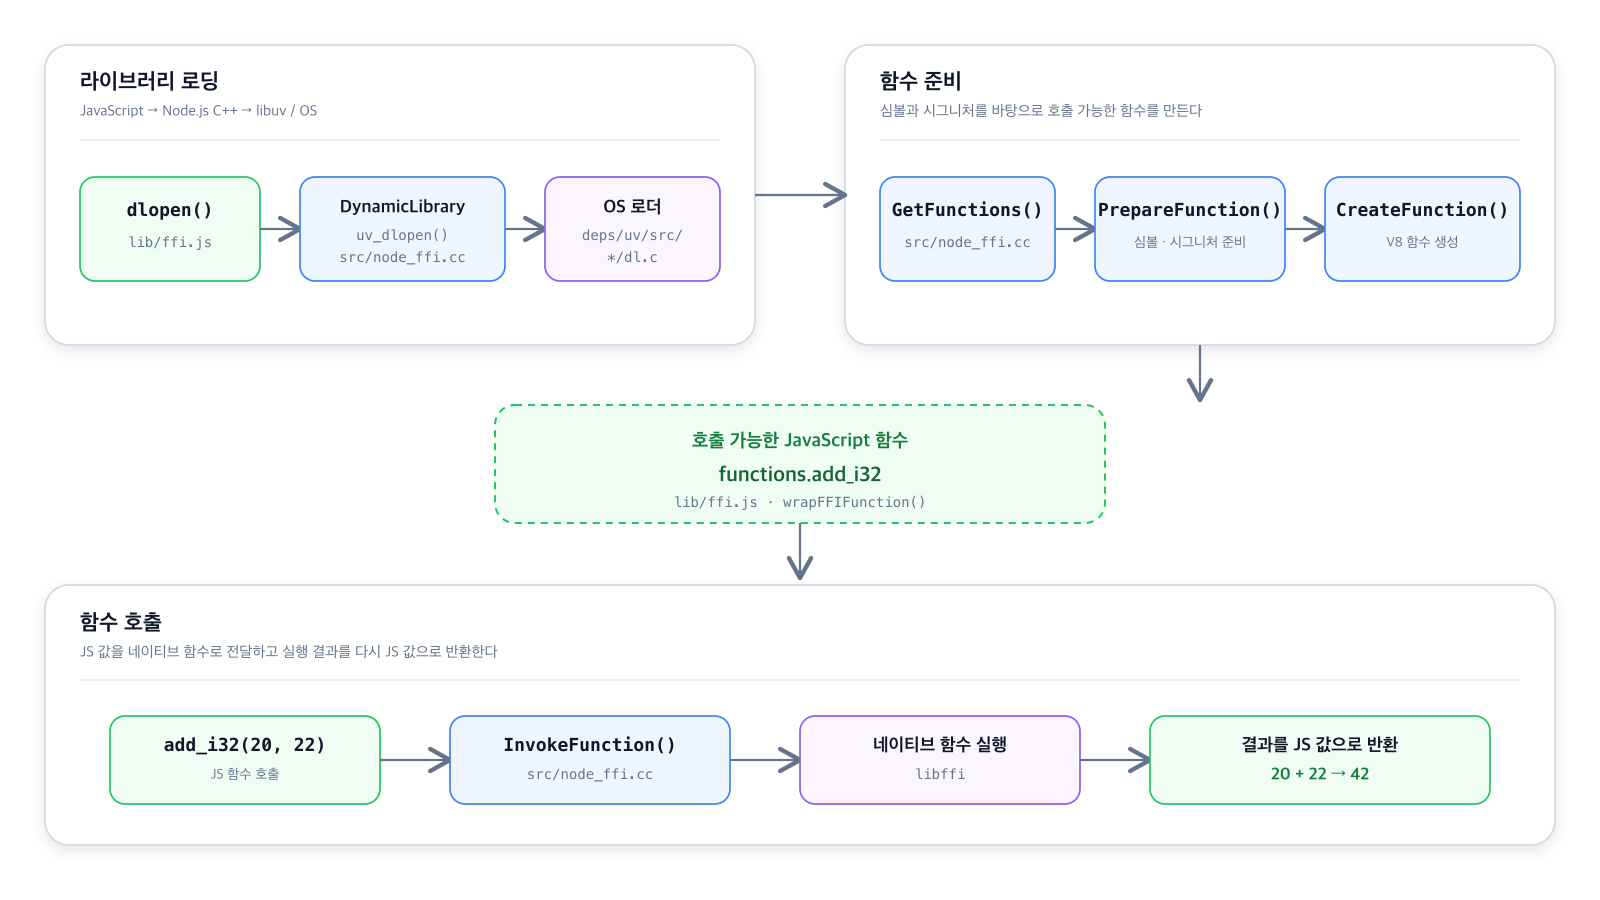
node:ffi는 크게 세 가지 단계(로딩, 준비, 호출)로 나눠진다.
- 로딩
dlopen()을 통해 동적 라이브러리를 로드한다.
- 준비
동적 라이브러리를 로드하면GetFunctions()를 통해 호출할 함수들을 가져오게 된다.GetFunctions():PrepareFunction()과CreateFunction()을 통해 네이티브 함수를 자바스크립트 코드에서 호출이 가능한 형태로handle을 반환하게 된다.PrepareFunction():- 함수 시그니처 파싱
- 심볼 메모리 주소 탐색
- 메모리 주소, 매개변수, 반환 타입 등의 정보를 객체로 생성
CreateFunction(): 함수 정보를 담은 객체를 기반으로 자바스크립트에서 호출 가능한 V8 함수를 생성
- 호출
- 준비 단계가 끝나면 V8 함수를 자바스크립트에서 호출이 가능하도록 래핑된 함수가 포함된
handle을 반환받게 된다. - 이를 통해 함수를 호출하게 되면, 입력값을 네이티브 함수에 맞는 형태로 변환하여 전달하고 그 결과값을 다시 자바스크립트 값으로 변환해 반환한다.
- 준비 단계가 끝나면 V8 함수를 자바스크립트에서 호출이 가능하도록 래핑된 함수가 포함된
어떤 점을 기여할 수 있을까
자바스크립트에서 정적 언어의 함수를 실행시키기 위해서는 두 언어의 타입 규정을 일치시켜야 한다.
현재 node:ffi에서 네이티브 함수 시그니처에 대한 매개변수 타입은 다음과 같이 지원된다.
| 분류 | 지원 타입 |
|---|---|
| 반환값 없음 | void — 반환 타입에만 사용 |
| 문자 | char |
| 문자열 | string |
| 부호 있는 정수 | int8, int16, int32, int64 |
| 부호 없는 정수 | uint8, uint16, uint32, uint64 |
| 부동소수점 | float32, float64 |
| 메모리 / 바이너리 | pointer, buffer, arraybuffer |
| 함수 포인터 / 콜백 | function |
하지만 자바스크립트는 부호 여부, 소수점 여부와 상관없이 모두 다 Number와 Bigint 타입으로 숫자를 받게 된다.
그 말은 즉,
int64,uint64는Bigint타입으로, 나머지 정수 타입은Number로 받아야 한다는 것이다.
자바스크립트가 Number를 처리하는 방법
자바스크립트의 Number 타입은 -(2^53 - 1) ~ -2^53 - 1까지의 정수를 표현할 수 있다.
자바스크립트는 배정밀도 부동소수점 방식으로 숫자를 표현한다.
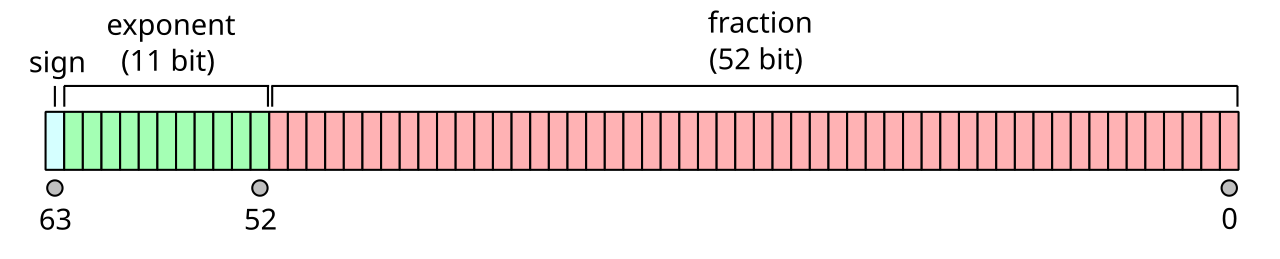
1개의 부호 비트, 11개의 지수부, 52개의 가수부로 총 64비트를 사용한다.
| 구분 | 비트 수 | 역할 |
|---|---|---|
| 부호 (sign) | 1비트 | + / - |
| 지수 (exponent) | 11비트 | 소수점 위치 |
| 가수 (fraction, mantissa) | 52비트 | 실제 숫자 |
예를 들어, 10이라는 숫자를 저장할 때 그 과정을 살펴보자.
10이라는 숫자를 이진수로 표현하면 1010(2)로 표현이 가능하다. 이 때 배정밀도 부동소수점으로 이를 표현하려면 1.010 × 2³ 와 같이 치환이 가능하다.
10 = 1010(2) = 1.010 × 2³여기서 배정밀도 부동소수점에 맞춰 비트를 분석하면,
- 부호: 0 - 양수
- 지수: 3 + 1023 (음수도 양수로 표현하기 위해 bias인 1023을 항상 더해서 표현한다.)
- 가수: 0100000...(52비트)
하지만 만약 이 비트를 통해서 표현할 수 없는 정수를 계산하려고 할 때 문제가 발생한다. 자스크립트에서 흔하게 볼 수 있는 문제점은 소수점을 계산하는 경우다.
0.1 + 0.2 === 0.3 // false
0.1 + 0.2 // 0.30000000000000004
0.1과 0.2는 2진수로 변환하면 그 값이 딱 떨어지지가 않아 끝없이 반복되고 결국 정수를 표현할 수 있는 비트의 수를 초과하게 된다.
0.1₁₀ = 0.00011001100110011...₂그 과정에서 자바스크립트는 표현할 수 있는 비트의 수까지 데이터를 저장하다가 이를 초과하면 반올림하여 표현하게 되고 결국 10진수로는 쉽게 이해하기 어려운 문제가 발생하게 된다.
이러한 문제는 소수점 뿐만 아니라 표현할 수 있는 최대 정수를 초과할 때도 동일하게 발생한다.
Number 타입은 다음과 같이 속성 값으로 MAX_SAFE_INTEGER과 MIN_SAFE_INTEGER를 제공해준다.
Number.MAX_SAFE_INTEGER:Number타입에서 안전하게 표현할 수 있는 가장 큰 정수 (2^53 - 1)Number.MIN_SAFE_INTEGER:Number타입에서 안전하게 표현할 수 있는 가장 작은 정수 (-(2^53 - 1))
이 때, 가장 큰 정수를 초과한 값을 연산하게 되면 아래와 같이 문제가 발생한다.
const x = Number.MAX_SAFE_INTEGER + 1;
const y = Number.MAX_SAFE_INTEGER + 2;

console.log(Number.MAX_SAFE_INTEGER);
// Expected output: 9007199254740991

console.log(x);
// Expected output: 9007199254740992

console.log(y);
// Expected output: 9007199254740992

console.log(x === y);
// Expected output: truex와 y는 최대 정수에 각각 1과 2를 더한 값이다. 하지만 x === y의 값에 대해서는 이상하게 true를 반환하게 된다.
그 이유는 위에서 언급하였듯 Number가 표현할 수 있는 비트의 수를 초과했기 때문이다.
[표현 가능한 53비트 자리]
  11111 ... 111111 = Number.MAX_SAFE_INTEGER
  └──────────────┘
     53비트로 표현
표현할 수 있는 모든 비트를 1로 채우면 2^53-1의 값이 나온다. 하지만 여기에 1을 더하게 되면 비트를 초과하며 다음과 같이 표현된다.
[표현 가능한 53비트 자리]
  10000 ... 000000  0 = Number.MAX_SAFE_INTEGER + 1
  └──────────────┘  │
     53비트로 표현    비트 잘림
만약 여기서 1을 더 더하면 다음과 같이 표현될 수 있다.
[표현 가능한 53비트 자리]
  10000 ... 000000  1 = Number.MAX_SAFE_INTEGER + 2
  └──────────────┘  │
     53비트로 표현    비트 잘림
우리는 1과 2를 더했지만, 결국 이를 구별할 수 있는 비트는 무시되고 최종적으로 동일한 값을 반환받게 된다.
이러한 문제를 해결하기 위해 자바스크립트는 BigInt 타입이 등장하였다.BigInt는 정수 리터럴의 뒤에 n을 붙이거나(10n) 함수 BigInt()를 호출해 생성할 수 있다.
const x = BigInt(Number.MAX_SAFE_INTEGER) + 1n;
const y = BigInt(Number.MAX_SAFE_INTEGER) + 2n;

console.log(Number.MAX_SAFE_INTEGER);
// Expected output: 9007199254740991

console.log(x);
// Expected output: 9007199254740992n

console.log(y);
// Expected output: 9007199254740993n

console.log(x === y);
// Expected output: falseBigInt타입은Math()객체의 메서드와 함께 사용할 수 없다.Number타입과 혼합하여 사용할 수 없다.
기여할 수 있는 문제 발견
문제점
다시 FFI 모듈로 돌아와서 생각해보자.
만약 호출해야 하는 네이티브 함수의 매개변수가
i64,u64타입을 요구한다면 자바스크립트에서는Number로 보내야 할까? 혹은BigInt타입으로 보내야 할까?
이러한 문제는 특히 Buffer를 네이티브 함수에 전달할 때 자주 발생된다.
const ffi = require('node:ffi');
const { functions } = ffi.dlopen(path, {
  sum_buffer: { arguments: ['buffer', 'u64'], return: 'u64' },
});

const bytes = new Uint8Array([1, 2, 3]);
functions.sum_buffer(bytes, BigInt(bytes.byteLength));
버퍼 안에 있는 데이터들의 총합을 구하는 sum_buffer 네이티브 함수는 버퍼와 버퍼의 길이를 매개변수로 함께 받고 있다.
버퍼는 메모리 안에 저장되지만 네이티브 함수에는 버퍼의 시작 메모리 주소와 길이만 전달하여 실제 해당 데이터에 접근할 때는 시작 주소 + 버퍼 길이를 통해 데이터를 참조할 수 있다.
이 때 버퍼의 길이는 그 크기에 따라 Number 타입이 안정적으로 표현할 수 있는 정수의 범위를 초과할 위험이 존재한다. 그렇기에 Node.js에서는 이 값을 i64 혹은 u64로 받으며 자바스크립트 코드에서 BigInt 타입으로 보내도록 규정하고 있다.
하지만 이러한 이유로 네이티브 함수를 호출할 때마다 버퍼를 BigInt()로 감싸서 전달해야 하는 불편함이 발생한다. 그 길이가 Number의 범위 안에 있더라도 항상 BigInt()를 감싸서 전달해야 한다.
이 뿐만 아니라 i64, u64 타입의 매개변수에 대해서 정수를 전달하더라도 10n처럼 작성하거나, BigInt(10)으로 항상 전달하도록 규정하고 있는 것이다.
이에 대해서 "이걸 사용자가 타입을 지켜야하는 것이 맞을까? Number를 보내더라도 내부적으로 Bigint()로 감싸주면 되지 않을까?" 라는 생각이 들었다.
이런 기능이 추가된다면 사용자 입장에서도 항상 BigInt()를 감싸야되는 불편함이 줄어들고 타입을 고려하지 않고 Number 타입을 직접 매개변수로 전달할 수 있는 사용성이 향상될 것이라 생각하였다.
개선 과정
자바스크립트에서 네이티브 함수를 호출하면 그 함수가 실행되는 경로는 총 3가지가 있다.
- Fast API
- V8이 최적화한 JS 코드 경로를 통해 네이티브 함수를 즉시 실행
- SharedBuffer
- JS와 C++이 공유하는 Buffer 내부에서 인자와 함수 값을 공유하며 실행
- Generic libffi
- C++이 JS 인자를 직접 검사·변환한 뒤 호출
가장 빠르게 실행시킬 수 있는 경로인 Fast API부터 검사하며 그 조건을 만족하지 못하면 SharedBuffer로 fallback하고 다시 또 generic libffi로 fallback하는 방식으로 네이티브 함수를 호출하게 된다.
그렇기 때문에 이 세가지 호출 부분에서 기존 i64, u64 검증 로직 부분을 수정해주었다.
여기서 중요한 점은 모든 Number 타입의 값을 허용해주면 안된다는 것이다. 실제로 Number 범위를 초과하는 값이 BigInt가 아닌 Number 타입으로 들어온다면 해당 값은 이미 정밀도를 잃은 상태일 가능성이 존재한다.
const x = Number.MAX_SAFE_INTEGER + 2;
const y = BigInt(Number.MAX_SAFE_INTEGER) + 2n;
const bigX = BigInt(x);

console.log(x);
// 9007199254740992

console.log(bigX);
// 9007199254740992n

console.log(y);
// 9007199254740993n
x를 계산할 때는 이미 자체적으로 반올림되었기 때문에, 그 후에 BigInt()로 감싸준다고 해도 원래 의도했던 값인 9007199254740993n의 값을 복원할 수 없다.
이에 대해 안전한 범위의 Number 타입의 값은 그대로 전달해도 가능하되, 그 범위를 벗어나면 에러를 발생시켜 BigInt로 전달하도록 수정해주어야 한다.
세 가지 경로에 대해 다음의 조건들을 추가하여 코드를 수정하였다.
i64,u64에 대한Number타입 허용Number로 들어올 경우, 안전한 범위 확인i64는 음수부터 양수까지,u64는 0부터 양수까지 범위 확인- 확인이 완료되면
BigInt()로 변환
벤치마킹
작업이 완료되고 issue와 PR을 올렸을 때, 한 리뷰어분께서 벤치마킹에 대한 결과도 함께 올려달라고 부탁하였다.
이에 대해 두 가지 방식으로 벤치마크를 돌려 성능을 평가하였다. 벤치마크 성능 평가의 기준이 될 함수는 간단히 두 개의 값을 더하는 함수로 지정하였다.
const { lib, functions } = ffi.dlopen(libraryPath, {
  add_u64: { return: 'u64', arguments: ['u64', 'u64'] },
});

bench.start();
for (let i = 0; i < n; ++i)
  add(20n, 22n);
bench.end(n);i64, u64의 파일은 한 번의 측정마다 네이티브 함수를 10,000,000회 호출하고 이를 30회 반복 측정해 평균 처리량으로 결과를 얻는다.
1. 기존 방식과 현재 방식에서 동일하게 BigInt 타입을 전달할 때 성능 평가
구현하기 전 main 브랜치에서 BigInt 값을 전달하였을 때의 성능과 구현한 후 BigInt 값을 전달하였을 때의 성능을 비교하였다.
                            confidence   improvement   accuracy (*)    (**)   (***)
ffi/add-i64.js n=10000000  ***            +29.99 %   ±4.82%  ±6.41%  ±8.36%
ffi/add-u64.js n=10000000  ***            +35.96 %   ±5.13%  ±6.83%  ±8.89%

                              -41.1%             0%             +41.1%
ffi/add-i64.js n=10000000                      |██████████████░░     +29.99% ***
ffi/add-u64.js n=10000000                      |█████████████████░░  +35.96% ***
신기하게도 처리하는 조건문이 더 추가되었는데도, 오히려 약 30%의 성능이 더 좋아졌다.
더군다나 현재의 구현에서는 BigInt 타입에 대해 Number의 값이 들어오는 경우에 대해서만 처리하였다.
즉, 기존 BigInt 타입이 들어오는 경로는 사실상 조건문을 통과하기 때문에 실행 흐름에 큰 변화가 없다.
function validate(value) {
  if(isTypeBigInt(value) && isValueNumber(value)) {
    ...Number 범위 검사 및 BigInt 변환
    return BigInt(value)
  }

  ...value 값 검증
  return value
}
이에 대해 JS 코드가 실행될 때 내부적으로 V8 엔진에서 발생하는 최적화에서 변화가 생길 것이라 추측하였다. V8은 자주 호출되는 JavaScript 함수를 최적화하며, inlining을 통해 다음과 같이 일부 함수 호출 비용을 줄일 수 있다.
function add(a, b) {
  return a + b;
}

function main() {
  let result = add(5, 3);
  console.log(result);
}
위와 같이 main() 함수는 add()함수를 항상 호출하여 값을 연산하지만 inlining으로 최적화 조건이 성립된다면 add() 함수 자체를 main() 함수 내부에 박아넣어 호출 시간을 줄인다.
function main() {
  let a = 5;
  let b = 3;
  let result = a + b;
  console.log(result);
}
벤치마킹을 실행하는 여러 옵션 중 다행히 inlining을 제거하는 --no-turbo-inlining 조건이 존재하여 옵션을 설정한 뒤 다시 한 번 더 벤치마킹을 돌려보았다.
                            confidence   improvement   accuracy (*)    (**)   (***)
ffi/add-i64.js n=10000000                  +0.49 %   ±1.57%  ±2.08%  ±2.71%
ffi/add-u64.js n=10000000                  -0.10 %   ±1.59%  ±2.12%  ±2.76%

                              -2.1%              0%              +2.1%
ffi/add-i64.js n=10000000            ░░░░░░░░░░|▓▓▓▓░░░░░░░░░░░░░░░  +0.49%
ffi/add-u64.js n=10000000      ░░░░░░░░░░░░░░░▓|░░░░░░░░░░░░░░       -0.10%
예상했던대로 두 가지 방식에 대해서는 그리 큰 성능차이가 발생하지 않았다. 사실상 두 방식 모두 동일한 흐름으로 데이터를 처리하니 미미한 성능 차이를 보여줄 수 밖에 없다는 것이 증명되었다.
2. 현재 방식에서 Number와 BigInt 타입을 전달할 때 성능 평가
이번에는 구현이 완료된 로직 위에서 동일한 값에 대해 Number 타입과 BigInt 타입으로 보냈을 때 얼마나 성능 저하가 발생하는 지를 테스트하였다.
Number 타입으로 보내게 되면, 내부적으로 이를 검사하고 BigInt로 변환해주어야 하기 때문에 성능이 저하될 수 밖에 없다고 가정하였고 중요한 건 얼마나 저하되었는지를 파악하는 것이었다.
이에 대해 3가지로 분리하여 각각 성능을 평가하였다.
- 미리 만든 Number/BigInt 전달
const a = input === 'number' ? 20 : 20n;
const b = input === 'number' ? 22 : 22n;

bench.start();
for (let i = 0; i < n; ++i)
  add(a, b);
bench.end(n);
미리 BigInt의 값과 Number의 값을 준비하여 벤치마크 내부에서 함수에 이를 전달하는 방식이다.
- 호출 시 Number 자동 변환
// input === 'bigint'
add(BigInt(20), BigInt(22));

// input === 'number'
add(20, 22);
미리 값을 만들어두는 것이 아닌 벤치마크 내부에서 BigInt()를 호출하여 변환 연산를 포함한다.
- Buffer 길이(Number) 직접 전달
const a = Buffer.alloc(64);
const b = Buffer.alloc(256);

// input === 'bigint'
add(BigInt(a.length), BigInt(b.length));

// input === 'number'
add(a.length, b.length);
이번 개선의 목적에 맞게 실제 버퍼와 버퍼 길이를 함께 전달하여 함수 내부에서 타입 변환을 시도한다.
| Argument preparation | Benchmark | BigInt (ops/s) | Number (ops/s) | Change |
|---|---|---|---|---|
| Pre-created values | add-i64 | 29,288,918.5 | 19,523,825.1 | −33.34% |
| Pre-created values | add-u64 | 28,502,908.3 | 19,819,141.9 | −30.47% |
| BigInt(20), BigInt(22) | add-i64 | 29,191,962.6 | 24,779,345.4 | −15.12% |
| BigInt(20), BigInt(22) | add-u64 | 28,580,807.5 | 25,475,704.5 | −10.86% |
| BigInt(a.length), BigInt(b.length) | add-i64 | 18,111,529.1 | 20,226,464.4 | +11.68% |
| BigInt(a.length), BigInt(b.length) | add-u64 | 17,549,515.7 | 19,566,290.2 | +11.49% |
예상했던 대로 Number를 직접 전달하는 것이 BigInt의 값으로 전달하는 것보다 약 30%정도 더 낮은 성능을 보여준다. 30%의 성능은 실제 속도로 환산하면 약 15 ~ 17ns 정도의 저하에 해당한다.
반면, 만약 사용자가 함수를 호출하면서 직접 BigInt()로 감싸게 되면 이를 연산하는 비용이 내부적으로 추가되면서 Number로 직접 전달하는 것이 약 15% 정도의 조금 더 낮은 성능 저하가 발생하게 된다.
더 의외였던 점은, buffer.length를 함수를 호출하면서 BigInt()를 감싸서 호출하는 것에 비해 Number로 직접 전달하는 것이 성능적으로 약 11%정도 개선되었다는 점이다.
결과적으로 함수 호출 하나하나의 저하는 그리 크진 않지만, 무거운 연산으로 루프를 돌려야한다면 함수를 호출하기 전에 미리 BigInt()로 묶어두고 연산을 하는 것이 더 효율적일 것이다.
반면, 단순 호출에 대해서는 Number의 값으로 보내도 된다는 편리성이 보장되었으며 Buffer에 한해서는 Number인 상태로 직접 전달하는 것이 성능적으로 더 효율적일 것이다.
회고
다행히 리뷰어로부터 Approve를 받은 상태이고 현재 Merge를 기다리고 있는 상태다.
OSSCA 활동을 하면서 멘토님과 팀원들과 함께 '어떻게 하면 Node.js 프로젝트에 더 영향력있는 기여를 할 수 있을까?'에 대해서 고민을 하였고 개발이 완료된 안정적인 모듈을 건드리는 것보다, 현재 활발히 개발 중인 모듈에 기여하는 것이 좋을 것 같다는 이야기가 나왔다.
마침 FFI 모듈은 현재 실험 단계에 있기 때문에 더 활발히 개발이 이루어지고 있었고 이에 대해 관심이 있는 멘티들끼리 모여 서로 학습한 내용들을 공유하거나 발표하며 모듈에 대한 전반적인 지식을 길렀다. 이 뿐만 아니라 영향력이 적더라도 FFI와 관련된 몇몇 기여들도 조금씩 쌓아가면서 그 감을 익혀나갔다.
그렇게 모듈에 대한 감이 어느 정도 익었을 때, 조금 더 FFI에 깊은 영향력을 끼칠 수 있는 여러 가지 아이디어들을 논의해보았고 그 중 하나였던 'i64, u64 타입에 대한 사용성 개선'을 기여해볼 수 있었다.
새로운 API를 만든다거나 방향성을 바꿀 정도의 큰 영향력을 못되겠지만, 사용자의 사용성을 조금이나마 더 개선시킴과 동시에 내부적인 동작 로직을 변경했다는 점에서는 도전적인 기여였다고 생각한다. 더군다나 리뷰어와의 이야기를 통해 직접 개선하였던 내용에 대해 성능을 평가해보고, 그 성능의 원인을 파악하거나 그 결과를 종합하여 리뷰어에게 보고해보는 등 양질의 경험을 많이 할 수 있었다. 더군다나, Node.js라는 거대한 프로젝트와 그 프로젝트를 관리하는 대단한 사람들과 소통하며 나 또한 그 일원으로서 어느 정도 영향력을 끼쳤다는 점이 뿌듯함으로 다가오고 소통하며 다 함께 만들어간다는 오픈 소스의 매력을 제대로 느낄 수 있었던 기여였다.
Refs
와우 float의 단정밀도에 대해 공부해본 적 있었는데..
double(배정밀도)를 덕분에 고민해보는 기회가 되었습니다.
c++은 float, double을 둘 다 쓸 수 있고, 선택할 수 있었다면
js는 number 하나 뿐이군요.
성능 측정을 위한 실행 과정 중에 동훈님의 끈기가 정말 많이 느껴졌습니다.
오늘 한 번만 읽지 않고 여러 번 와서 볼게요 :D