Abstract
Face Recognition(FR) task의 핵심은 대규모 얼굴 데이터의 내재적인 구조정보(structure information)을 latent space에 효과적으로 encoding하는 것
즉 모델이 얼굴 이미지를 벡터로 변환했을 때 비슷한 얼굴끼리는 가까이 다른 얼굴끼리는 멀리 위치하도록 학습 시키는 것
그러나 input space와 latent space사이에 structure information을 directly aligning 하게 되면 과적합 문제가 발생하여 latent space에서 구조 붕괴 현상이 일어남
이 문제를 해결하기 위해 PTSA라는 위상 구조 정렬 전략과 SDE라는 하드 샘플 마이닝 전략을 활용하는 새로운 FR모델인 TopoFR을 제시
PTSA: 지속적인 homology를 사용하여 input space와 latent space의 위상구조를 정렬하여 structure information을 보존하고 FR모델의 일반화 성능을 개선
SDE: 각 샘플에 대한 구조손상정보(SDS)를 자동으로 계산하여 하드 샘플을 정확하게 식별하고 모델이 이를 우선적으로 최적화 하도록 함
1. Introduction
기존 연구:
CNN 기반 face features 를 자율적으로 추출
margin-based loss function 개발
unsupervised learning을 통해 모델 일반화 개선에 있어 structure information의 중요성 입증
large-scale face data에서 structure information을 효과적으로 mine하는 방법은 조사되지 않음
powerful하고 substantial한 structure information를 이용해서 최첨단 FR 프레임워크을 구축하고자 함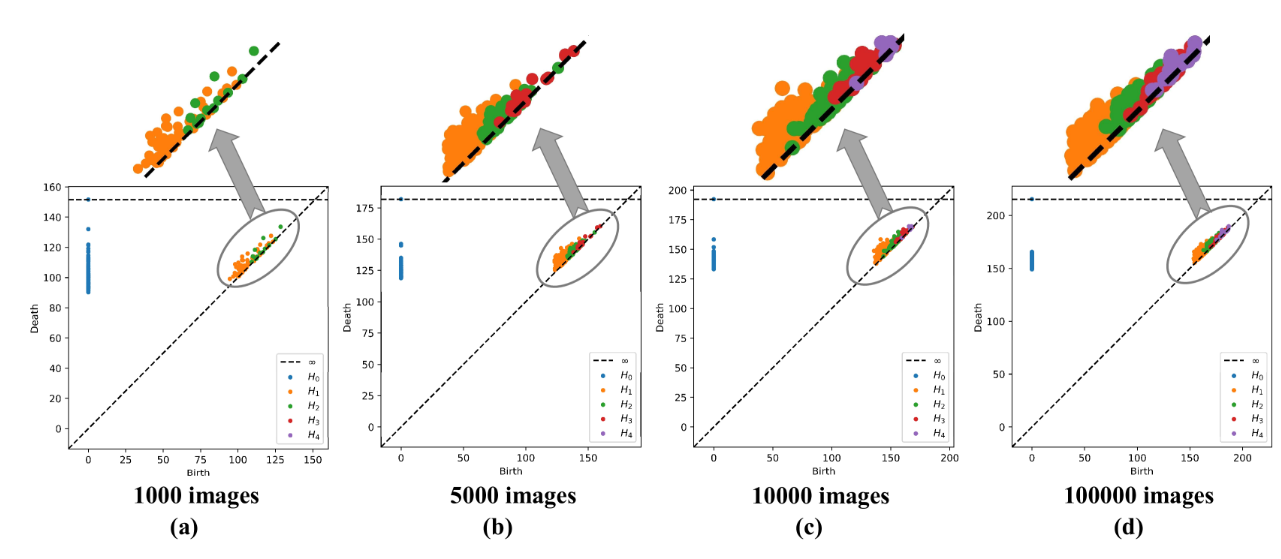 Figure 1
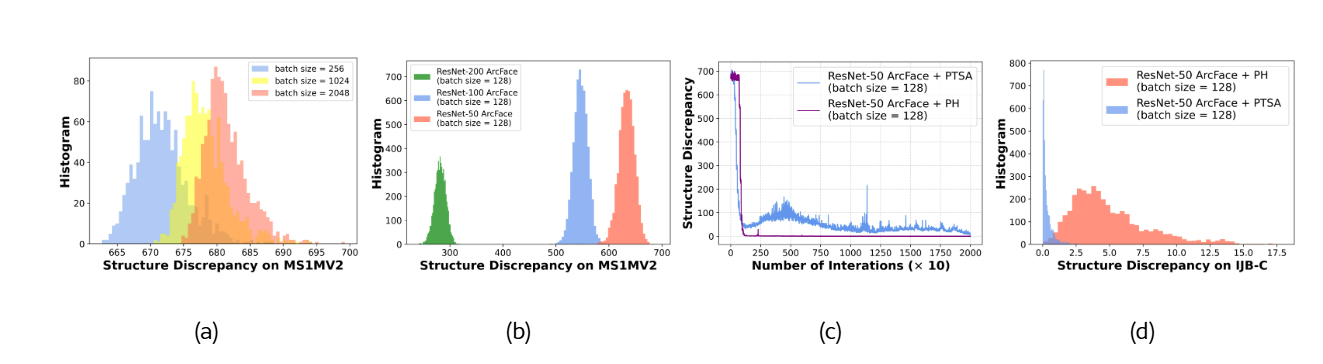 Figure 2
Persistent Homology(PH): topological 데이터 분석에 사용하는 수학적 tool
복잡한 point cloud의 근본적인 toplogical structure를 포착
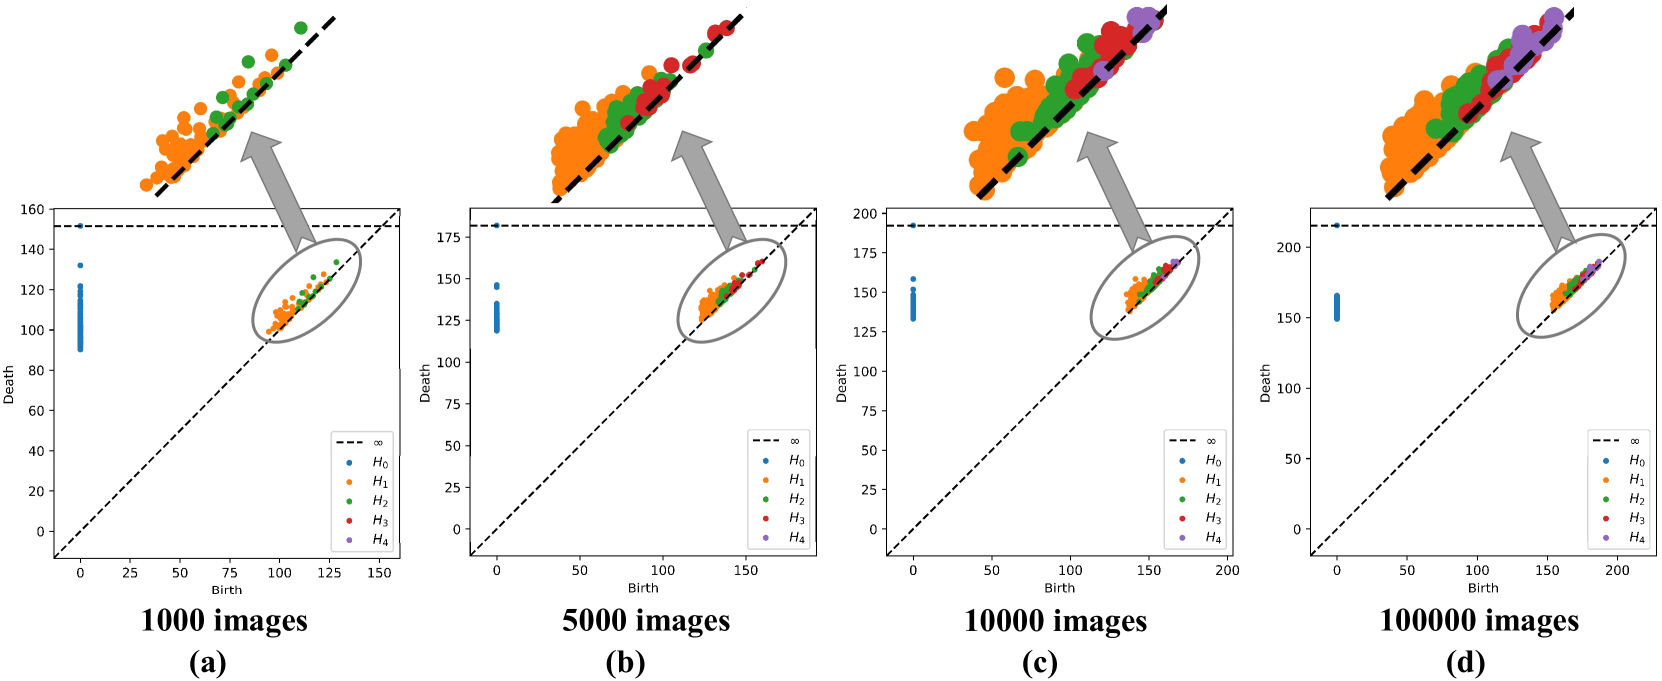
1) 데이터 양이 증가함에 따라 input space topological strcuture가 더 복잡해짐(Figure 1)
2) 데이터 양이 증가함에 따라 input space와 latent space간 topological structure 불일치가 점점 커짐(Figure 2a)
3) 네트워크 깉이가 증가함에 따라 topological structure 불일치가 점점 더 작아짐(모델이 복잡할수록 더 정확도가 높음)
얼굴 데이터 structure가 훈련 중 파괴되어 FR모델의 일반화 능력이 제한 됨 따라서 structure infomation을 보존하여 일반화 성능을 개선시키자
but 실험적으로 input space와 latent space의 topological stucture를 정렬하기 위해 PH를 직접 사용하면 모델이 구조 붕괴 현상(structure collape phenomenon)을 겪게 됨
(1) figure 2c를 보게되면 PH를 직접 사용하면 toplogical stucture불일치가 초기 학습 과정 중 너무 빠르게 0으로 떨어짐
(2) figure 2d에서 즉 test set에서는 input space와 latent space 간의 gap이 존재
즉 PH를 직접 사용하면 과적합되어 test set에서 성능이 제대로 발휘되지 않음(latent space의 structure information이 input space의 structure information을 정확하게 보존하지 못함)
이 문제를 해결하기위해 Perturbation-guided Topological Structure Alignment(PTSA)전략을 제안
PTSA:
random structure perturbation(RSP): latent space에 작은 변화를 주어 구조적 다양성을 증가시킴(모델이 얼굴 특징을 저장하는 공간인 latent space에 변형을 가해 유연하게 만들자)
invariant structure alignment(ISA): 일반화 성능이 강화되도록 input space와 변형된 latent space의 topological stcuture를 정렬함 (모델이 다양한 얼굴 데이터에도 일관되게 특징을 추출할 수 있게)
실제 시나리오에서 훈련 데이터셋에 낮은 퀄리티의 얼굴 샘플(hard samples)은 latent space에 decision boundary에 가까운 비정상적인 위치에 encoding(얼굴이미지를 벡터로 변환하여 임베딩 됨)됨 이는 latent space의 topological stucture를 크게 파괴하고 구조 정렬에 영향을 미침
이를 해결하기 위해 하드 샘플 mining 전략인 Structure Damage Estimation(SDE)를 제안
Structure Damage Estimation(SDE): 예측 불확실성과 예측 확률을 기반으로 각 샘플에 stucture damage score(SDS)를 적응적으로 할당. 상당한 구조 손상이 있는 하드 샘플(SDS가 높은 샘플) 최적화를 우선시함으로 SDE는 이러한 샘플(하드샘플)을 점진적으로 적절한 위치에 되돌려 놓아 FR모델의 일반화 성능을 향상
주요 기여 내용
1) FR task에서 topological sturcture alignment를 최초로 탐구. 원래 input space와 약간 변형된 latent space를 효과적으로 정렬하기 위한 PTSA전략을 제안
2) SDE라는 하드샘플이 latent space에 부정적인 영향을 주는 것을 완화하기 위한 mining 전략 제안.
3) 다양한 벤치마크에서 기존 SoTA보다 우수함을 증명 + ICCV21 MFR-Ongoing 챌린지에서 2위 달성. 방법이 rubust하고 general하다는 것을 증명
2. Related Work
Face Recognition(FR):
CNN의 rubust한 deep facial embedding 추출에 많은 관심이 있었음
그 중 2가지 주요한 방법 1) metric learning-based 2) margin-based softmax
1) metric learning-based: Triplet loss, Tuplet loss, center loss같은 손실함수를 활용하여 face feature의 차이를 학습
2) margin-based softmax: ArcFace 같은 방법을 포함하여 softmax loss 프레임 워크에 margin 패널티를 통합
최근에는 adaptive parameters, mining, learning acceleration, vision transformer achitecture, data uncertainty, 대규모 데이터 세트에서 연구 진행 중
Persistent Homology(PH): 지난 10년 동안 PH는 신호처리, 비디오 분석, 신경과학, 질병진단, 임베딩 전략평가, 일부 머신러닝, 네트워크에 topological representation을 통합하면 모델의 recognition/segmentation성능 향상, topological distance가 GANs의 성능평가 등에 연구 됨
3. Background: Persistent Homology
PH: computational topology 방법으로 topologcial 불변량(space의 변화에도 유지되는 데이터의 위상적 특징들)이 scale 매개변수 ρ가 변할 때 Vietoris-Rips 복합체의 위상적 특성이 어떻게 변화하는지를 측정
Vietoris-Rips 복합체: 일정 거리(ρ) 이하인 점들을 연결해서 위상적 구조를 만드는 방법 즉 toplogical 불변량을 측정하기 위한 도구
즉 데이터의 위상적 특징이 스케일(ρ)이 변함에 따라 어떻게 유지되거나 사라지는지를 분석하는 기법
𝒳: 점군 (1부터 n까지 점들의 집합)
μ:𝒳×𝒳→ℝ 점 𝒳 2개를 입력받아 실수 거리를 출력하는 함수 μ
ℳ: 점군의 모든 거리 정보를 담은 행렬
Vietoris-Rips 복합체: 점들의 집합에서 특정거리(ρ) 이하인 점들을 연결해서 형성되는 위상적 구조(toplogical structure) 이 구조를 이용하여 공간의 위상적 특징을 근사할 수 있음
= 점군 𝒳에 대한 Vietoris-Rips 복합체
각 점 가 거리 이면 연결됨.
스케일이 증가하면 기존 구조가 포함관계를 유지하면서 확장 됨
즉 작은 ρ 구조는 큰 ρ 구조에 포함 됨
또한 Vietoris-Rips 복합체는 점들의 실제 좌표가 아니라 점들 간의 거리만 있으면 생성 가능
Homology Group: 위상적 특징을 분석하는 대수적 구조
: connected components(개별 점들이 연결되면서 그룹이 합쳐지는 과정 추적)
: cycle(사이클이 생성되고 사라지는 과정 추적)
: void(고차원 공간의 빈 공간이 어떻게 유지되는지 분석)
: higher-dimensional features
위상 특징 이 스케일 ρ가 변할 때 어떻게 변화하는지 추적하여 다중 스케일에서 공간의 위상적 특징을 이해할 수 있음
따라서 PH는 ρ를 변화시키면서 어떤 위상적 구조가 오래 유지되는지 분석하는 기법
Persistence Diagram and Persistence Pairing: 지속성 다이어그램 𝒟는 위상적 특징의 생성주기를 시각화한 그래프
각 점 (𝑏,𝑑)은 위상적 특징이 생성된 시점(birth, 𝑏)에서의 스케일 ρ과 사라진 시점(death, 𝑑)에서의 스케일 ρ를 나타냄
지속성 페어링 𝛾 는 인덱스 (𝑖,𝑗)를 포함하며, 이는 Vietoris-Rips 복합체 에 속하는 단순체에 해당한다. 이 단순체들은 각각 지속성 다이어그램 𝐷에 의해 식별된 위상적 특징을 생성하고 소멸시킨다
4. Methodology
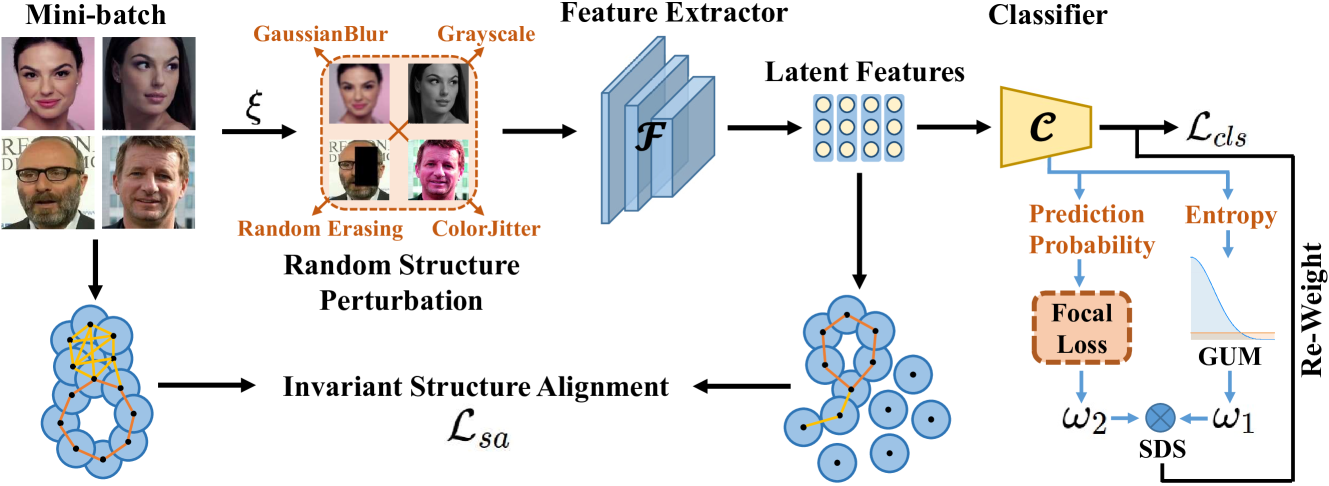
이 논문에서는 FR(Face Recognition) 모델이 latent features에서 input space의 위상적 구조 정보를 보존하도록 제약을 가하는 새로운 프레임워크 TopoFR을 제안
TopoFR은 2가지 컴포넌트 특징 추출기 𝐹와 이미지 분류기 𝐶로 구성
입력 이미지 𝑥가 주어졌을 때, 특징 추출기 𝐹에 의해 추출된 latent feature은 로 나타낼 수 있음
분류기 𝐶가 예측한 분류 확률(classification probability)은 로 나타낼 수 있음
여기서 𝑙은 특징 벡터 차원 수 즉 임베딩의 차원을 의미하며 K는 클래스의 개수를 의미
분류 예측확률 g의 entropy는 로 나타낼 수 있으며 는 샘플이 클래스 K로 예측될 확률을 의미
이 엔트로피를 이용하여 하드샘플을 구하여 SDE과정에 사용함
4.1 Perturbation-guided Topological Structure Alignment
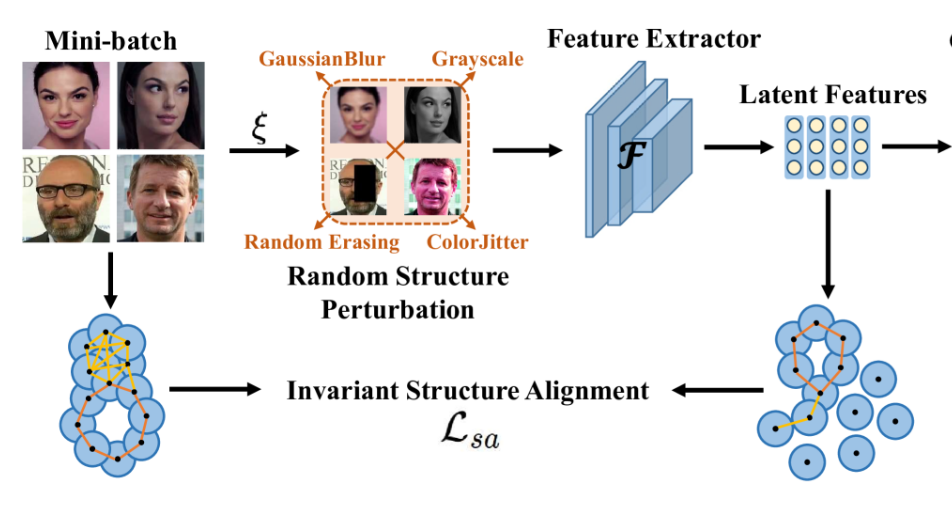
Section 1에서 input space와 latent space의 topological structure를 정렬하기 위해 PH를 직접 이용하는 것은 구조 붕괴 현상이 일어날 수 있음을 언급하였고 이를 해결하기 위해서 Perturbation-guided Topological Structure Alignment
(PTSA)전략을 제안하며 이는 2가지 매커니즘 Random Structure Perturbation(RSP)와 Invariant Structure Alignment(ISA)를 포함 함
Random Structure Perturbation(RSP): latent space의 구조를 무작위로 변형
데이터 augmentation 기법 𝒜를 4가지를 사용
: Random Erasing(이미지 일부를 무작위로 지우기)
: GaussianBlur(가우시안 블러)
: Grayscale(회색 이미지)
: ColorJitter(밝기 대비, 색상 변경)
각 샘플 에 대해 RSP는 위의 𝒜에서 무작위로 하나를 선택하여 변형을 수행함
이렇게 변형된 를 이용하여 지도학습에 사용하여 latent space의 구조적 다양성을 증가시킴
손실함수로는 arcFace loss를 사용
또한 학습 과정에서 학습 과정에서, 우리는 각 샘플에 대해 확률 ξ=0.2 로 RSP 메커니즘을 적용함 즉 모든 샘플에 RSP 메커니즘을 적용하는 것이 아님
RSP -> 20%의 확률로 데이터 augmentation 수행
Invariant Structure Alignment (ISA):
미니배치를 특징 추출기 𝐹에 입력하면 원본데이터의 특징 벡터의 집합과 변형된 데이터의 특징 벡터 집합이 출력됨
미니 배치에서 특정 샘플을 perturb한다면(0.2비율) perturb하지 않은 원본 이미지집합 𝒳와 𝒳를 perturb해서 특징 추출기 ℱ를 통과하여 얻은 latent feature 를 구할 수 있음 이를 이용하여 각 pairwise distance matrix 와 를 기반으로 와 를 구성할 수 있음
그 후 PH를 이용하여 지속성 다이어그램과 지속성 페어링을 얻고 이 둘을 이용하여 손실함수를 구성
즉 위 식에따르면 데이터가 변형되더라도 특정 벡터의 위치나 위상 구조가 변하지 않아야 모델이 일반화가 가능하며 이를 위해 원본 입력공간 𝒳와 변형된 잠재 공간 를 정렬하여(위 손실함수를 계산하여) 목표를 달성하고자 함
이전 연구에서는 두 공간 사이의 위상적 구조 차이를 측정하기 위해 지속성 다이어그램의 차이를 계산하는데 bottleneck 거리나 바서슈타인 거리를 주로 사용하였으나 이는 지속성 다이어그램 내 outliers에 민감하여 모델 학습시간을 증가시키므로 초대형 데이터셋을 사용하는 FR작업에서는 비효율적이었음
따라서 지속성 다이어그램을 직접 비교하는 대신 지속성 페어링을 이용하여 거리행렬에서 관련정보만 추출하는 식으로 최적화함
기존 FR분야에서는 대부분 data Augmentation이 얼굴이미지의 신뢰도를 손상시켜 신원이 불확실한 얼굴 이미지를 생성할 수 있어 사용하지 않았는데 이 연구에서는 데이터의 양을 늘리기 위해서 사용하는 것이 아니라 잠재공간의 구조 다양성을 증가시키는데 활용하며 이를 통해 구조 붕괴 현상문제를 해결하고자 함
결론적으로 ISA는 입력시 0.2의 확률로 이미지가 변형될 경우 원본 이미지와 변형된 이미지의 잠재백터간의 PH계산을 통해 구하는 것
4.2 Structure Damage Estimation
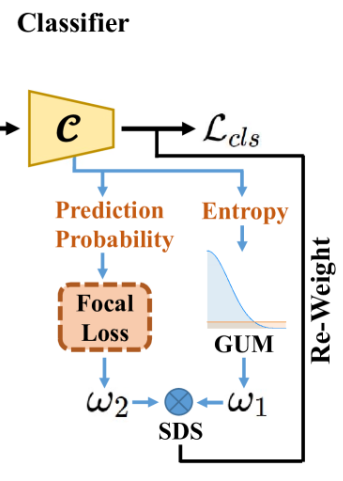
실제 FR시나리오에서는 품질이 낮은 얼굴 샘플(Hard sample)이 학습 데이터셋에 포함되는데 이러한 Hard sample은 Latent space에서 Decision boundary 근처의 비정상적인 위치에 인코딩 되는 경향이 있음
비 정상적인 위치에 인코딩되면 Latent Space의 위상적 구조를 붕괴시키고 구조 정렬을 어렵게 만듦 이를 해결하기위해 Structure Damage Estimation(SDE)를 제안
즉 SDE는 hard sample이 latent space에서 잘못 배치되는 문제를 해결하기 위한 방법
SDE는 학습 데이터셋 내에서 hard sample을 정확하게 식별하고 학습에 우선순위에 두어 최적화 과정에서 이를 정확한 위치에 되돌려 놓음으로 부정적 영향(latnet space의 topologycal structure파괴)을 완화하는 것
Prediction Uncertainty: hard sample은 dicision boundary 근처에 있으며 예측 불확실성이 높고 분류기 𝒞의 예측 엔트로피가 크다
각 샘플 에 대해 =1이면 hard sample =0이면 easy sample 즉 각 샘플마다 Hard인지 Easy인지 "확률적"으로 구분하는 과정
는 샘플이 hard sample일 확률
는 학습해야할 모델의 파라미터 집합
엔트로피를 기반으로 확률을 예측하는데
easy sample은 평균을 중심으로 모여있고 hard sample은 균등한 확률로 존재(서로 다른 확률 분포 가정) 즉 easy sample은 정규 분포 hard sampe은 균등 분포를 따른다고 가정
: uniform 분포 hard samples를 모델링
: 가우시안 분포 easy samples를 모델링
: easy sample이 존재할 확률
: 정규분포 분산
: 균등 분포의 상한 값
어떤 샘플이 hard sample 임을 구하는 확률 식
분류기가 모든 클래스에 대해 비슷한 확률을 예측하는 경우 즉 어느 클래스로 예측할 지 확신이 없는 경우 hard sample로 분류 됨 -> 1로 수렴하게 됨
이렇게 Gaussian-uniform mixture (GUM) model로(가우시안 분포와, uniform분포가 혼합된 모델)을 학습하기 위해 Expectation-Mazimization(EM)알고리즘으로 학습
단순히 hard, easy를 이진적으로 분류하여 학습을 하는 것보다 EM알고리즘을 이용하여 hard sample 여부를 확률적으로 모델링하여 부드럽게 학습하면 학습의 안정성이 증가함
단순히 모델의 결과를 나열하여 엔트로피 순으로 hard sample을 정하는 것이 아님
EM알고리즘이란 expected log-likelihood(E-step) t를 평가하여 (M-step) t+1을 update하고 이 과정을 반복하는 것
Structure Damage Score(SDS): Focal Loss에서 영감을 받아, 예측 불확실성과 예측 정확도를 결합하여 각 샘플 에 대한 SDS를 동적으로 계산하는 확률 기반 스코어링 메커니즘을 설계
SDS 는 두개의 요소 와 의 곱으로 정의되며 이는 각각 Hard sample의 확률 와 예측 정확도 를 고려한 가중치
즉 Hard sample일 확률이 클수록 예측 확률이 낮을 수록 더 높은 SDS를 가짐
SDS를 반영한 새로운 loss함수 은 기존 ArcFace Loss 에 SDS 를 곱한 형대로 정의 됨
기존의 ArcFace Loss는 얼굴임베딩을 최적화 하는 역할을 하고 여기에 SDS로 hard sample에 더 높은 가중치를 부여함으로 모델이 어려운 샘플에 대해 더 높은 가중치로 학습할 수 있도록 유도하면 FR시스템의 일반화 성능을 향상시킬 수 있음
4.3 Model Optimization
이렇게 최종 손실함수를 구하면
ℱ와 𝒞를 최적화하여 loss를 최소화 하는 것
: SDS를 포함한 분류 손실
: 구조 정렬 손실
: 하이퍼 파라미터