결정적인 assertion과 의미 기반 Eval 판단에 대해 기재한다.
결정적 Assertion
LLM 자체를 테스팅해볼 수 있겠지만, LLM을 래핑한 무언가 (서버, mcp, 에이전트 등) 도 테스트할 수 있다. 이 때, 응답값의 구조 및 형태, 필수 키 존재여부, 길이 제한 등 코드로 정확히 확인 가능한 내용에 대해서는 assert 를 사용한다.
DeepEval의 경우에는 pytest와의 통합이 가능하므로, pytest 를 import해서 사용한다.
def test_deterministic_response_contract() -> None:
    """빠르고 재현 가능한 형식 검사는 일반 pytest assertion이 담당한다."""
    failure_kind = os.getenv("DEEPEVAL_SESSION4_CONTRACT_FAIL")
    raw_response = INVALID_CONTRACT_RESPONSES.get(failure_kind, VALID_RESPONSE)

    assert_deterministic_contract(raw_response)


def assert_deterministic_contract(raw_response: str) -> dict[str, Any]:
    """코드로 정확히 판정할 수 있는 세 가지 제품 계약을 검증한다."""
    # 1. JSON 파싱이 가능해야 한다.
    payload = parse_json_object(raw_response)

    # 2. 소비자가 의존하는 필수 key가 모두 있어야 한다.
    missing_keys = REQUIRED_KEYS - payload.keys()
    assert not missing_keys, f"필수 key가 없습니다: {sorted(missing_keys)}"

    # 3. UI에 표시할 답변은 정해진 길이를 넘지 않아야 한다.
    answer = payload["answer"]
    assert isinstance(answer, str), "answer는 문자열이어야 합니다."
    assert len(answer) <= MAX_ANSWER_LENGTH, (
        f"answer가 {MAX_ANSWER_LENGTH}자를 초과했습니다: {len(answer)}자"
    )
    return payload
의미 기반 Eval
응답값의 의미 분석이 필요한 경우,
- 응답이 질문과 관련이 있는지,
- 유저에게 도움이될만한 응답인지,
- 응답이 공식 근거에 기반한 내용인지,
- threshold 이상인지
등을 판단할 때는 DeepEval을 사용한다.
def make_semantic_metrics() -> list[GEval]:
    """
    품질 차원마다 이유와 threshold를 따로 관찰할 수 있게 분리한다.
    테스트케이스에서 측정이 필요한 평가지표에 대해 선언한다.

    """

    # 관련성
    relevance = GEval(
        name="Question relevance",
        criteria=(
            "Evaluate whether the actual output directly addresses the user's "
            "refund question without irrelevant content."
        ),
        evaluation_params=[
            SingleTurnParams.INPUT,
            SingleTurnParams.ACTUAL_OUTPUT,
        ],
        threshold=0.7,
    )

    # 도움성
    helpfulness = GEval(
        name="Actionable helpfulness",
        criteria=(
            "Evaluate whether the actual output gives the user clear, useful next "
            "steps and communicates the important processing time. Use the expected "
            "output as a reference; exact wording is not required."
        ),
        evaluation_params=[
            SingleTurnParams.INPUT,
            SingleTurnParams.ACTUAL_OUTPUT,
            SingleTurnParams.EXPECTED_OUTPUT,
        ],
        threshold=0.7,
    )

    # 근거성
    groundedness = GEval(
        name="Policy groundedness",
        criteria=(
            "Evaluate whether every factual claim in the actual output is supported "
            "by the provided context and does not contradict it."
        ),
        evaluation_params=[
            SingleTurnParams.ACTUAL_OUTPUT,
            SingleTurnParams.CONTEXT,
        ],
        threshold=0.7,
    )
    return [relevance, helpfulness, groundedness]


def test_semantic_answer_quality() -> None:
    """표현이 달라도 의미상 합격할 수 있는 조건만 LLM judge에 맡긴다."""

    # judge에게 JSON 직렬화 방식까지 평가시키지 않고 사용자에게 보이는 답변만 준다.
    payload = assert_deterministic_contract(raw_response)

    test_case = LLMTestCase(
        name="refund-support-semantic-quality",
        input=QUESTION,
        actual_output=payload["answer"],
        expected_output=EXPECTED_OUTPUT,
        context=[POLICY_CONTEXT],
    )

    assert_test(test_case, make_semantic_metrics())
실행 결과
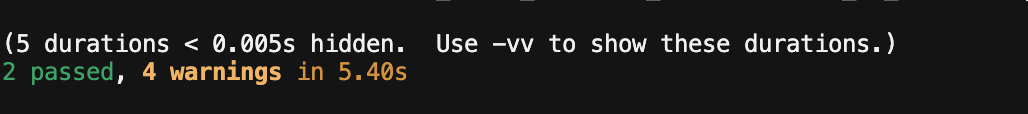
deepeval test run 를 이용해서 테스트 실행을 하면 위와 같이 결정적 테스트와 비결정적 테스트를 같이 집계해서 노출시키고,
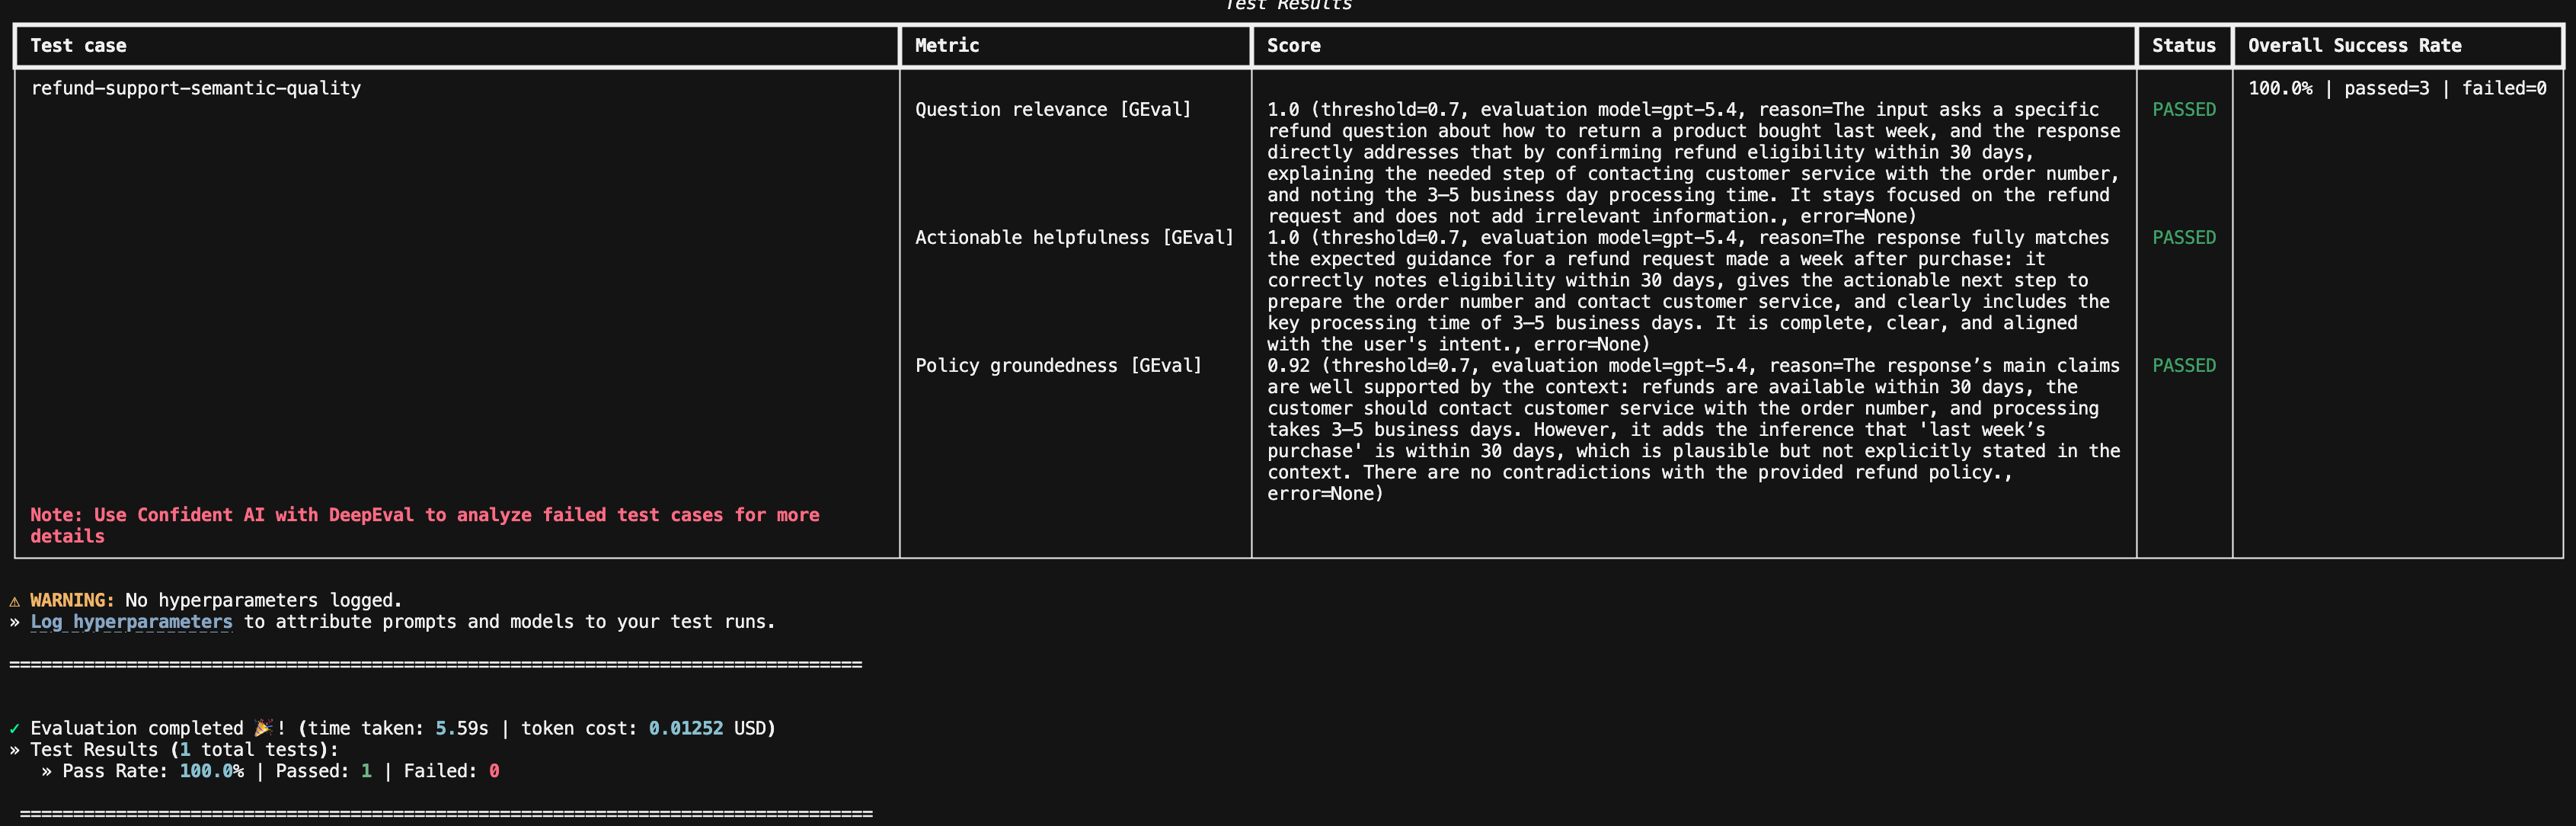
Eval 판단에 대한 출력, 점수와 이런 점수가 나오게 된 이유가 같이 출력된다.
DeepEval에는 결정적 판단 기능이 없는건가?
DeepEval에 결정적 판단 기능이 없냐면 그것은 아니다.
DeepEval이 지원하는 결정적 Metric
1. ExactMatchMetric
기대결과와 실제 결과가 문자단위로 완전히 같은지 검사한다. 그러나 이것은 assert actual_output == expected_output 와 완전히 동일하다.
2. PatternMatchMetric
출력이 정규표현식과 일치하는지 검사한다. 이것은 re.fullmatch() 를 사용해서 assert 하는 것과 동일하다.
3. JsonCorrectnessMetric
출력이 지정한 Pydantic schema에 맞는 JSON인지 검사한다.
그럼에도 왜 Pytest assertion을 써야할까?
우선 표현이 훨씬 직접적이다. 위에서 설명한 metric을 생성해서 테스트케이스와 비교하고 이런 것들이 pytest의 표현식보다 훨씬 작성해야할 코드량이 많고 복잡하다. 예를 들어 제품 요구사항이 아래와 같다고 하자.
- JSON 파싱이 가능하다.
answer,source가 존재한다.confidence는 숫자다.confidence는 0~1 사이다.- 답변은 500자를 넘지 않는다.
pytest의 경우는 아래와 같이 표현해볼 수 있다.
import json

payload = json.loads(actual_output)

assert "answer" in payload
assert "source" in payload
assert isinstance(payload["confidence"], int | float)
assert 0 <= payload["confidence"] <= 1
assert len(payload["answer"]) <= 500
이것은 DeepEval 을 이용해서 custom metric으로 구현하려면 꽤나 복잡하다.
BaseMetric상속threshold설정score계산success설정reason구성measure()구현a_measure()구현- Metric 이름 정의
다만 그럼에도 불구하고, DeepEval의 결정적 assertion을 사용해야하는 경우는, 평가 리포트에 관련 점수를 같이 표기해야할 때 사용하면 도움될 수 있다.