이전 글들을 통해 GCP에서 서버를 만들고 GPU를 할당받아 VSCode에 연결하는 것까지 진행했다. 본격적으로 첫 논문 구현을 하기 전에 프로젝트의 구조에 대한 부분을 미리 알고 있으면 좋겠다는 생각이 들어서, VGGNet의 코드를 통해 이를 알아보려고 한다. 코드도 보지만, 프로젝트 구조를 위주로 보려고 한다. 그렇기 때문에 각 py 파일이 어떤 내용과 기능을 포함하는지를 중점적으로 보게 될 것 같다. 내가 참고한 코드의 github는 Lornatang/VGG-PyTorch repository이다.
내가 코드를 살펴본 순서는 아래와 같다.
train.py -> model.py -> dataset.py -> config, utils
1. 프로젝트 구조
해당 repo를 들어가 보면, 아래와 같은 구조로 되어 있다.
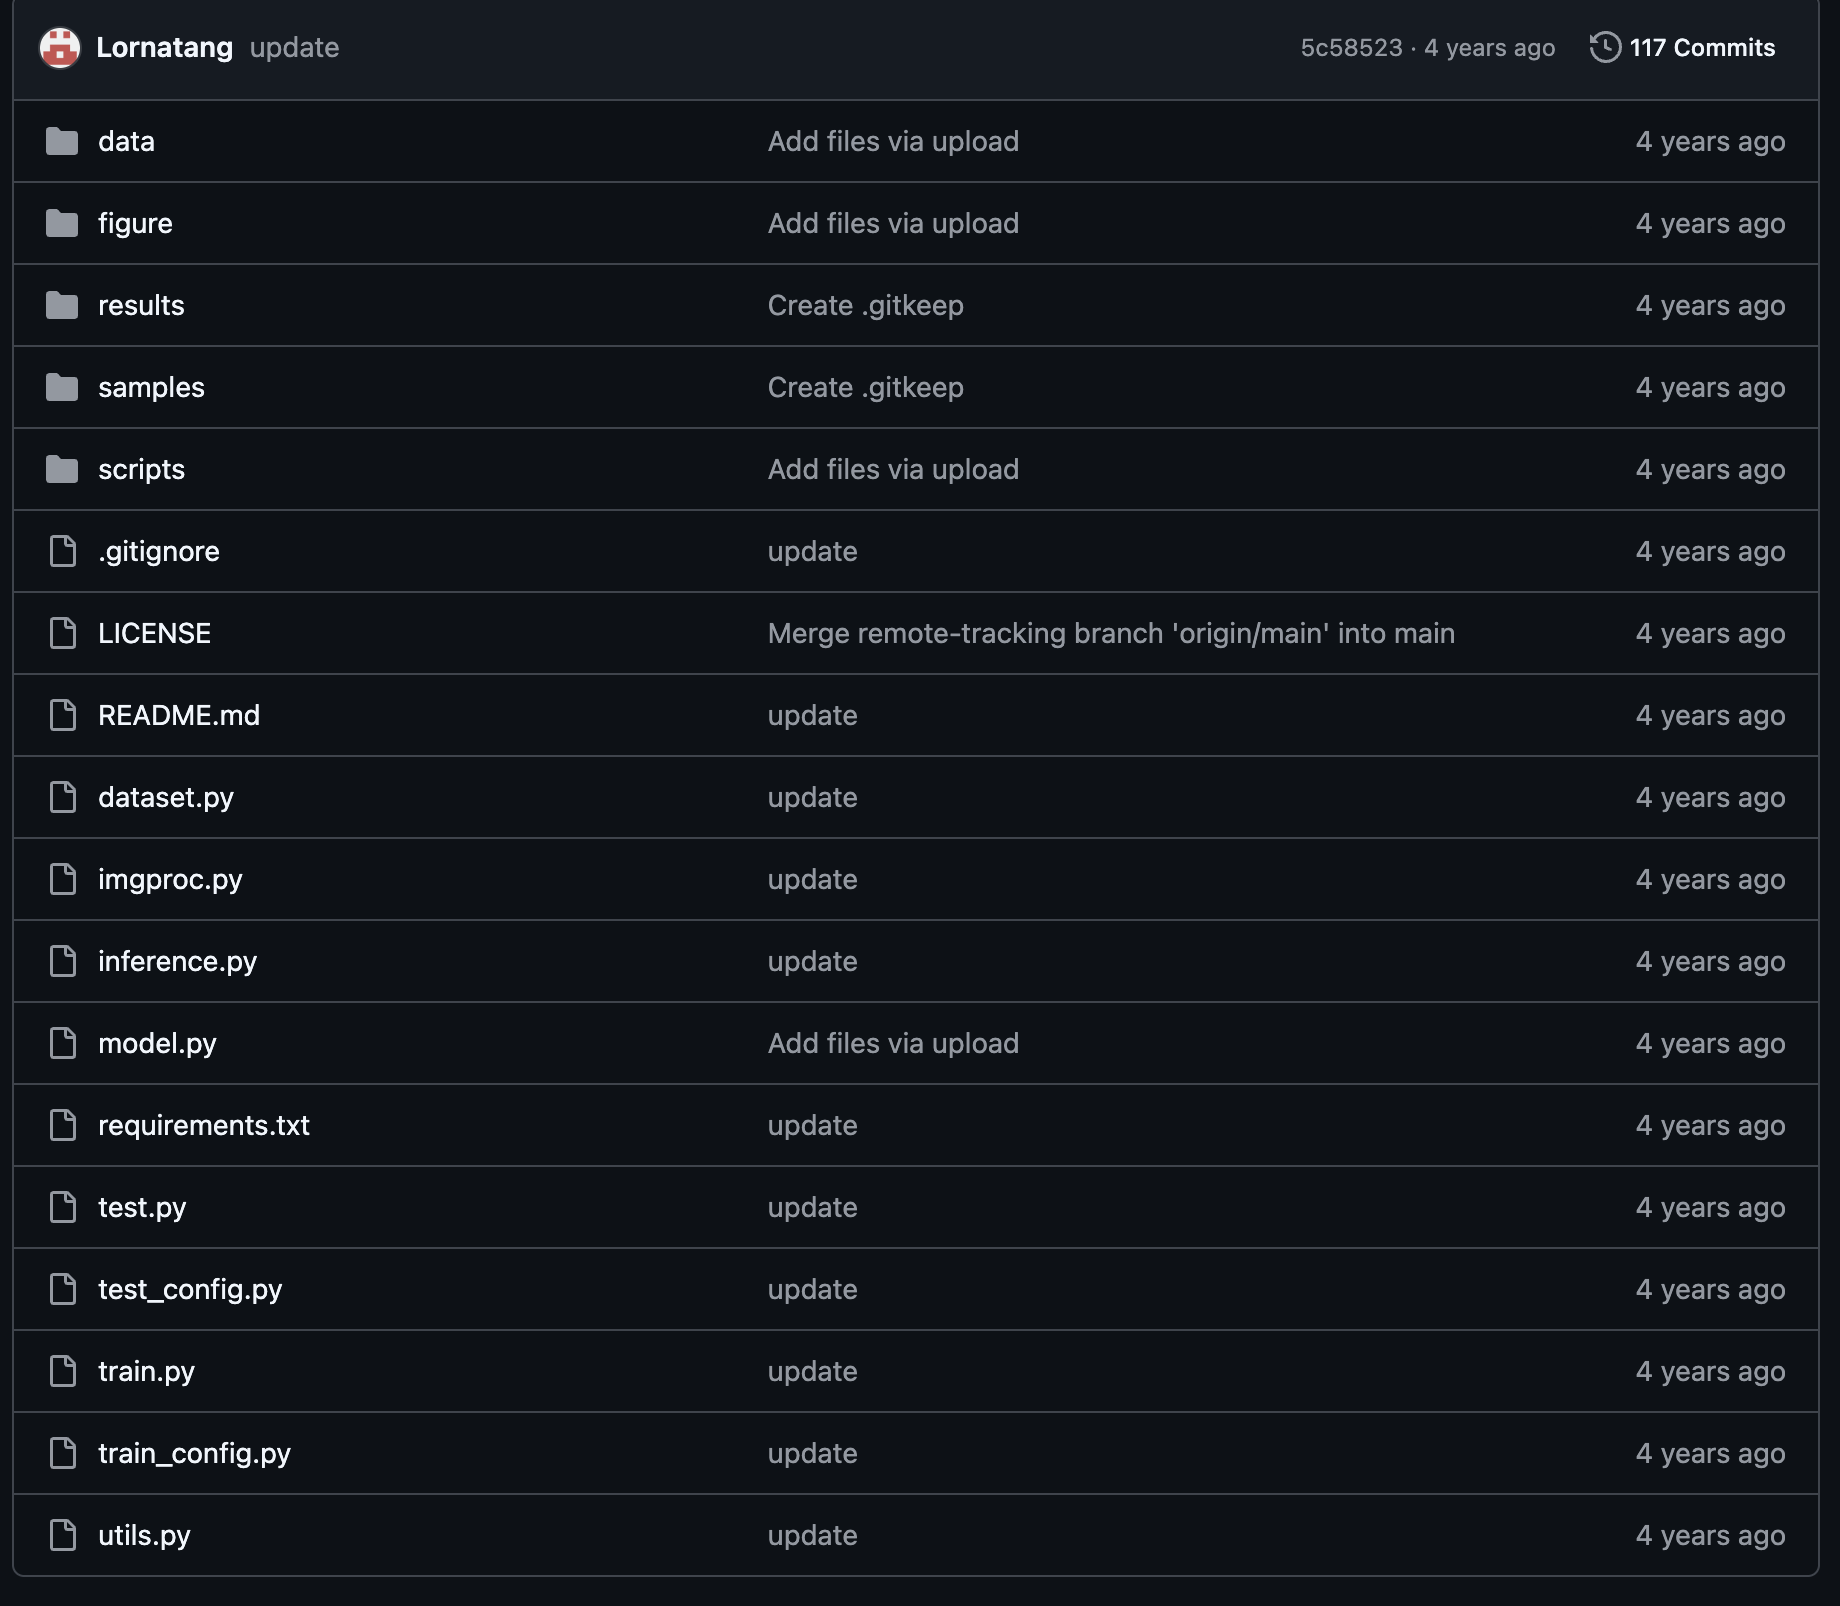
project_root/
├── data/
├── figure/
├── results/
├── samples/
├── scripts/
│
├── .gitignore
├── LICENSE
├── README.md
│
├── dataset.py
├── imgproc.py
├── inference.py
├── model.py
│
├── requirements.txt
│
├── test.py
├── test_config.py
│
├── train.py
├── train_config.py
│
└── utils.py
먼저 train.py부터 살펴보자.
2. 코드
1) train.py
train.py는 보통 main 파일격으로 사용된다. 기존에 만들어둔 파일들을 import 해서 train.py 파일에서 그 함수들을 호출하는 형태를 볼 수 있다. 이 코드에서도 dataset.py의 ImageDataset class나 CUDAPrefetcher class를 import하고 있다. 코드는 main(), load_dataset(), build_model(), define_loss(), define_optimizer(), define_scheduler(), train()의 함수들로 구성되어 있다. 무조건 이런 함수들을 다 그대로 써야지! 라기 보다는 이 코드들이 어떻게 모듈화 되어 있는지를 보자.
main()
여기서 dataset과 model, loss, optimizer, scheduler와 같은 것들을 정의한다. (dataset, model, loss, optimizer, scheduler는 또 다른 함수로 정의한다.)훈련 시의 로그를 기록하는 코드도 여기서 작성한다. 학습에 필요한 모든 값들을 선언한 뒤, train() 함수를 통해 학습을 진행한다. accuracy 계산도 해주고, 체크포인트 저장도 해준다. 이 코드는 모델을 from scratch로 훈련시킬수도 있고, pretrained 모델을 불러서 사용할 수 있는 옵션을 제공한다.
load_dataset()
dataset을 load하는 과정이다. 이 코드에서는 ImageDataset이라는 class를 사용하는데, 이는 dataset.py에서 정의되어 있다.
ImageDataset은 resize된 이미지 사이즈, crop 이미지 사이즈, training/validation/testing을 구분해주는 mode를 정의하고, 이에 따라 데이터를 준비시켜준다. 데이터 전처리도 여기서 진행된다.
training dataset, valid_dataset을 ImageDataset을 사용해서 만들고, DataLoader도 선언해준다.
build_model(), define_loss(), define_optimizer(), define_scheduler()
-
build_model(): 모델 생성에 해당하는 코드이다. 모델을 생성하고, 준비하는 단계다. 실제 모델의 훈련은 train() 함수에서 진행된다.
-
define_loss(), define_optimizer(), define_scheduler() : 말 그대로 scheduler, optimizer, loss를 선언하는 함수이다.
train()
모델을 실제로 훈련하는 함수이다. 내가 구현할 때 이 코드처럼 mixed precision도 사용하면 좋을 것 같다. 어쨌든 backprop, loss 계산 등의 우리가 아는 과정들이 진행된다.
2) model.py
이 코드는 model의 layer를 쌓는데 조금 효율적인 방법을 사용한 것 같다. 사용자가 vgg11, vgg13, vgg11_bn과 같은 것을 입력하면, 그에 맞게 layer를 넣어서 만들어주는 py 파일이다. 더 자세히 들어가진 않겠지만, 만약 공통된 layer가 반복되는 여러 종류의 모델들을 만들어야 한다면 적용해도 좋을 구현 방식인 것 같다.
3. Key Takeaways
사실 코드 리뷰는 논문의 내용이 어떻게 실제 코드로 구현되었는지 분석하는 것이 핵심이라고 생각한다. 그런데 내가 구현을 하기 전에 감을 잡기 위해 이렇게 프로젝트 구조를 중심으로 첫 코드 리뷰를 진행하게 되었다. 내가 구현할 때 사용하면 좋을 부분들을 아래 정리해봤다.
- 모듈화는 하기 나름. 기능에 따라 적당히 나누면 될 것 같다. 그러나 train.py, test.py, model.py, inference.py, dataset.py, requirements.txt정도는 들어가면 좋을 것 같다.
- magic method에 대해 확실히 공부하고,
if __name__ == "__main__":
main(train_config.seed)
과 같은 코드를 적극 활용할 것.- mixed precision을 사용할 것.
더 많이 생각할 수도 있겠지만, 이 이상 생각하는 것은 별 의미가 없다고 생각한다. 차라리 부딪히면서 코드를 짜보고, 프로젝트가 마무리 된 후에 피드백을 하는 것이 더 나을 것 같다.
이제 준비는 어느 정도 된 것 같다. python과 pytorch 개념만 후딱 짚고 넘어가면 이제 진짜 SRCNN을 구현해볼 수 있다.