1. 기능명세서 읽기
기능명세서란
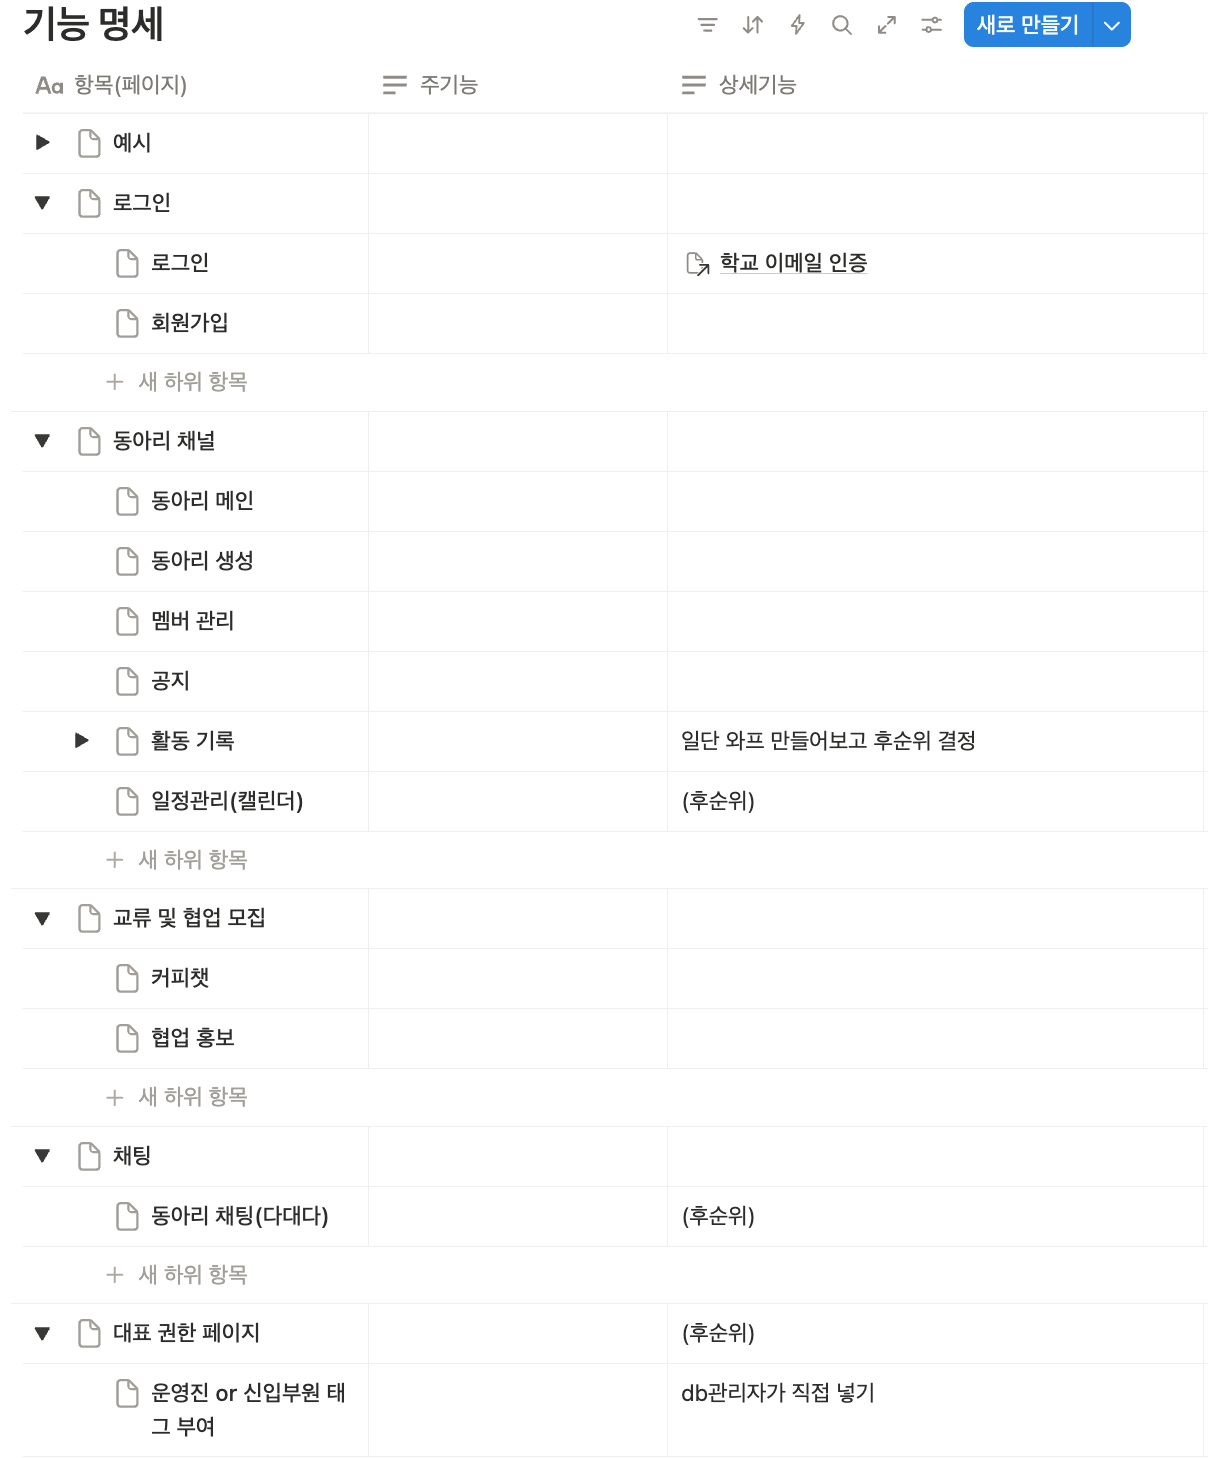
기능명세서는 "어떤 화면에 어떤 기능이 필요한지" 페이지 단위로 정리돼 있습니다!
예시 프로젝트 기준으로 보면 로그인, 동아리 채널, 커피챗, 채팅… 이렇게 화면별로 묶여 있는데, 백엔드는 이걸 그냥 읽는 게 아니라 "서버가 처리할 수 있는 단위(API)로 번역" 해야 해요.
(기능명세서는 사람마다 다른 형식(템플릿)으로 작성할 수 있어요! 설명을 위해 제가 가장 최근에 진행했던 프로젝트 기준으로 설명드립니다.)
기능 1개 = API 1개"가 아니다
가장 많이 하는 실수에요!
명세서에는 프로젝트 팀원 모집 한 줄인데, 실제로 만들면 이렇게 돼요.
| 행위 | 메서드 | 엔드포인트 |
|---|---|---|
| 모집글 목록 본다 | GET | /api/project-recruitments |
| 모집글 하나 자세히 본다 | GET | /api/project-recruitments/{id} |
| 모집글 올린다 | POST | /api/project-recruitments |
| 모집글 수정한다 | PATCH | /api/project-recruitments/{id} |
| 모집글 삭제한다 | DELETE | /api/project-recruitments/{id} |
명세 한 줄 → API 5개가 된 이유?
그 화면에서 사용자가 하는 행위가 여러 개니까요.
기능명세서를 볼 때는 항상 "이 화면에서 행동이 뭐뭐 있지?" 를 먼저 생각하세요!
명사는 URL, 동사는 메서드
엔드포인트 만드는 기본 규칙이에요.
- 다루는 대상(명사) → 경로 (예: 모집글 →
/project-recruitments) - 하려는 행동(동사) → HTTP 메서드
그래서 같은 대상이면 경로는 똑같고, 행위만 메서드로 구분해요.
GET /api/project-recruitments 랑 POST /api/project-recruitments 는 경로가 같지만 하나는 조회, 하나는 생성이에요.
CRUD — 게시판형 기능
프로젝트 팀원 모집처럼 게시판 냄새 나는 기능은 거의 항상 이 5개 세트로 떨어져요.
| 이름 | 메서드 | 설명 |
|---|---|---|
| Create | POST | 새로 만든다 |
| Read (목록) | GET | 여러 개 조회 |
| Read (상세) | GET | 하나만 조회 /{id} |
| Update | PATCH | 수정 |
| Delete | DELETE | 삭제 |
기능 보고 "게시판 같은데?" 싶으면 일단 CRUD 5개 먼저 뽑고 시작하면 돼요.
CRUD로 안 떨어지는 경우 — 채팅
채팅은 게시판이랑 달라요. 행위로 쪼개보면:
| 행위 | 메서드 | 엔드포인트 |
|---|---|---|
| 내 채팅방 목록 본다 | GET | /api/chat/rooms |
| 채팅방 만든다 | POST | /api/chat/rooms |
| 메시지 목록 본다 | GET | /api/chat/rooms/{chatRoomId}/messages |
| 메시지 보낸다 | POST | /api/chat/rooms/{chatRoomId}/messages |
| 메시지 읽음 처리 | PATCH | /api/chat/rooms/{chatRoomId}/read |
| 실시간 연결 | — | WebSocket (STOMP) |
여기서 CRUD와 다른 점을 보자면
첫 번째, 읽음 처리는 CRUD에 없는 행위예요. Create도 아니고 Update라고 하기도 애매한, 채팅 도메인 특유의 행위예요. 이런 게 있다는 걸 알아야 해요.
두 번째, 실시간 메시지 전송은 POST 엔드포인트로 못 해요. HTTP는 요청, 응답이 1번으로 끝나는데, 채팅은 서버에서 먼저 클라이언트한테 메시지를 보내줘야 하거든요. 그래서 WebSocket 이라는 별도 방식을 쓰기도 한답니다.
CRUD에 억지로 끼워 맞추려 하지 말고, "이 화면에서 사용자가 실제로 뭘 하는 거지?" 를 계속 생각하는 게 답이에요.
2. ERD 설계하기
명세서가 "어떤 기능을 만들지"를 뜻했다면, ERD는 "그 기능에 필요한 데이터를 어떻게 저장할지" 를 그림으로 표현한 거예요.
저희 학기 초반 데이터베이스 공부하면서 ERD 그리는 거 공부해봤죠? 그걸 기억해서 나타내면 됩니다.
저장해야 할 대상
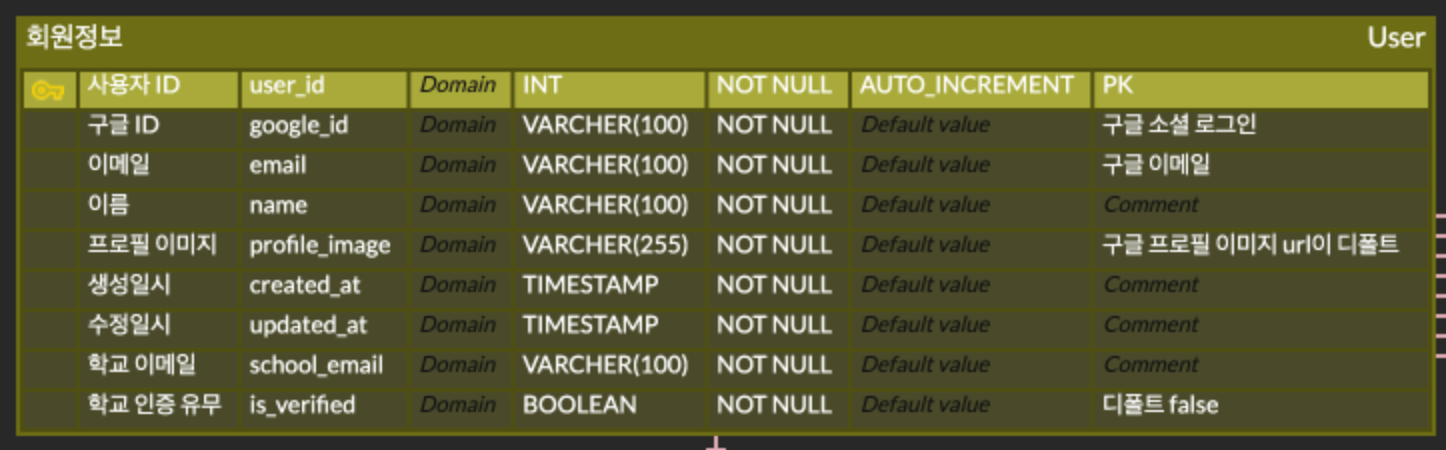
ERD에서 네모 박스 하나하나가 엔티티예요. DB 테이블 하나라고 보면 돼요.
엔티티 안에는 컬럼이 있어요. 그 테이블에 저장할 데이터 항목들이에요.
우리 프로젝트 User 테이블 보면:
| 컬럼명 | 타입 | 설명 |
|---|---|---|
user_id | INT | PK, 고유 식별자 |
email | VARCHAR | 이메일 |
name | VARCHAR | 이름 |
profile_image | VARCHAR | 프로필 이미지 URL |
school_email | VARCHAR | 학교 이메일 |
is_verified | BOOLEAN | 학교 인증 여부 (기본값 false) |
created_at | TIMESTAMP | 생성일시 |
updated_at | TIMESTAMP | 수정일시 |
여기서 꼭 알아야 할 3가지가 있어요.
PK (Primary Key) — 각 행을 구분하는 고유 번호예요. user_id가 1, 2, 3... 이렇게 자동으로 올라가요. (AUTO_INCREMENT)
NOT NULL — 이 컬럼은 반드시 값이 있어야 한다는 뜻이에요. 비워두면 에러 나요.
BOOLEAN — is_verified처럼 true/false 두 가지 상태만 저장할 때 써요. 기본값 false로 두고 인증하면 true로 바꾸는 방식이에요.
created_at, updated_at은 거의 모든 테이블에 넣어요. 나중에 "언제 만들어진 데이터야?" 추적할 때 필수예요.
엔티티끼리 어떻게 연결되나
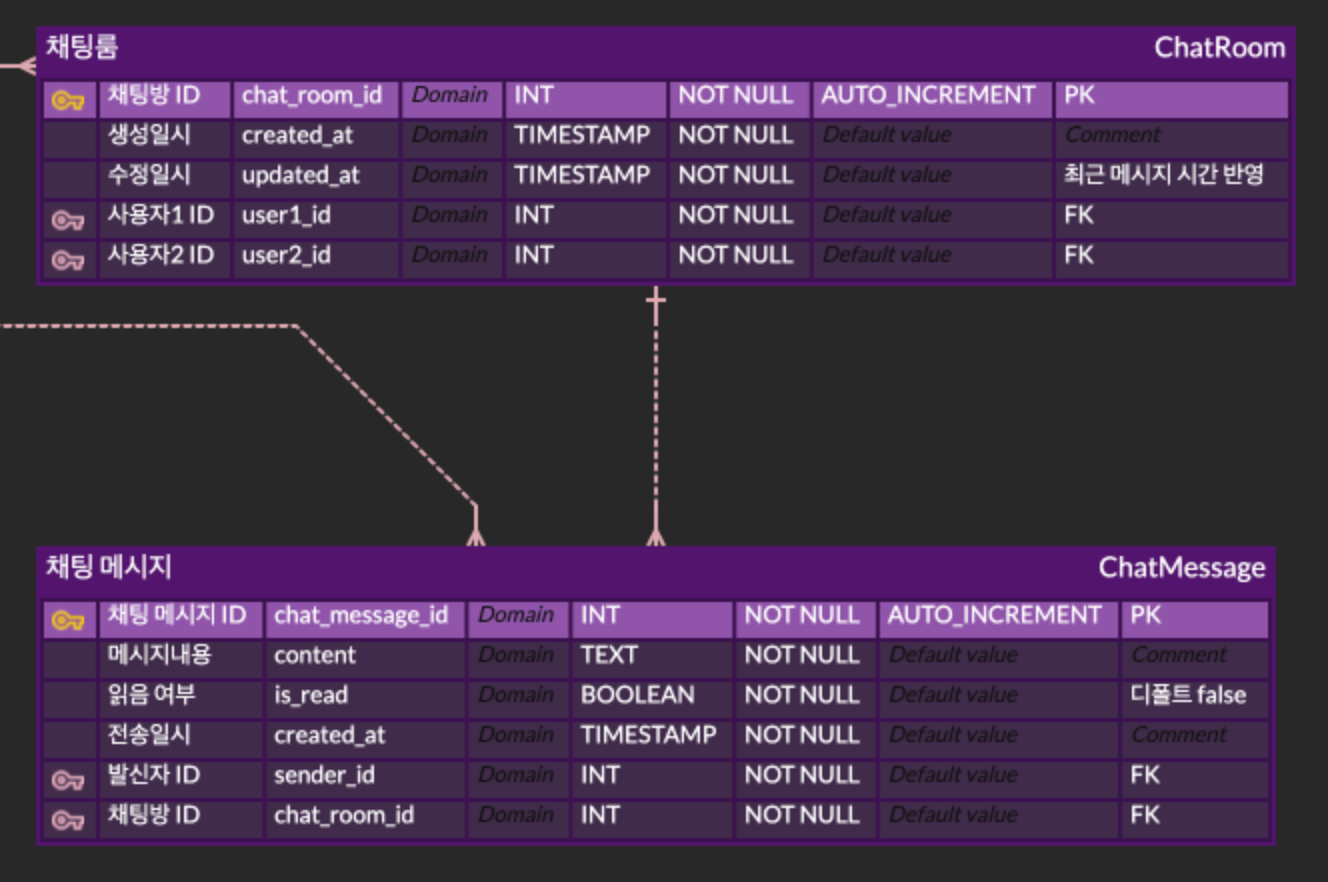
엔티티를 뽑았으면 "이 둘은 어떤 관계야?" 를 따져야 해요.
1:N (일대다) — 하나가 여러 개를 가진다
채팅방 하나에 메시지가 여러 개 →
ChatRoom1 :ChatMessageN
이걸 테이블로 표현할 때는 N쪽(ChatMessage)에 FK를 넣어요.
ChatMessage 테이블 보면:
| 컬럼명 | 타입 | 설명 |
|---|---|---|
chat_message_id | INT | PK |
content | TEXT | 메시지 내용 |
is_read | BOOLEAN | 읽음 여부 (기본값 false) |
created_at | TIMESTAMP | 전송일시 |
sender_id | INT | FK → User |
chat_room_id | INT | FK → ChatRoom |
sender_id랑 chat_room_id가 FK(Foreign Key) 예요. "이 메시지가 어떤 채팅방 것인지, 누가 보낸 건지" 를 연결해주는 열쇠예요.
N:M (다대다) —양쪽 다 여러 개
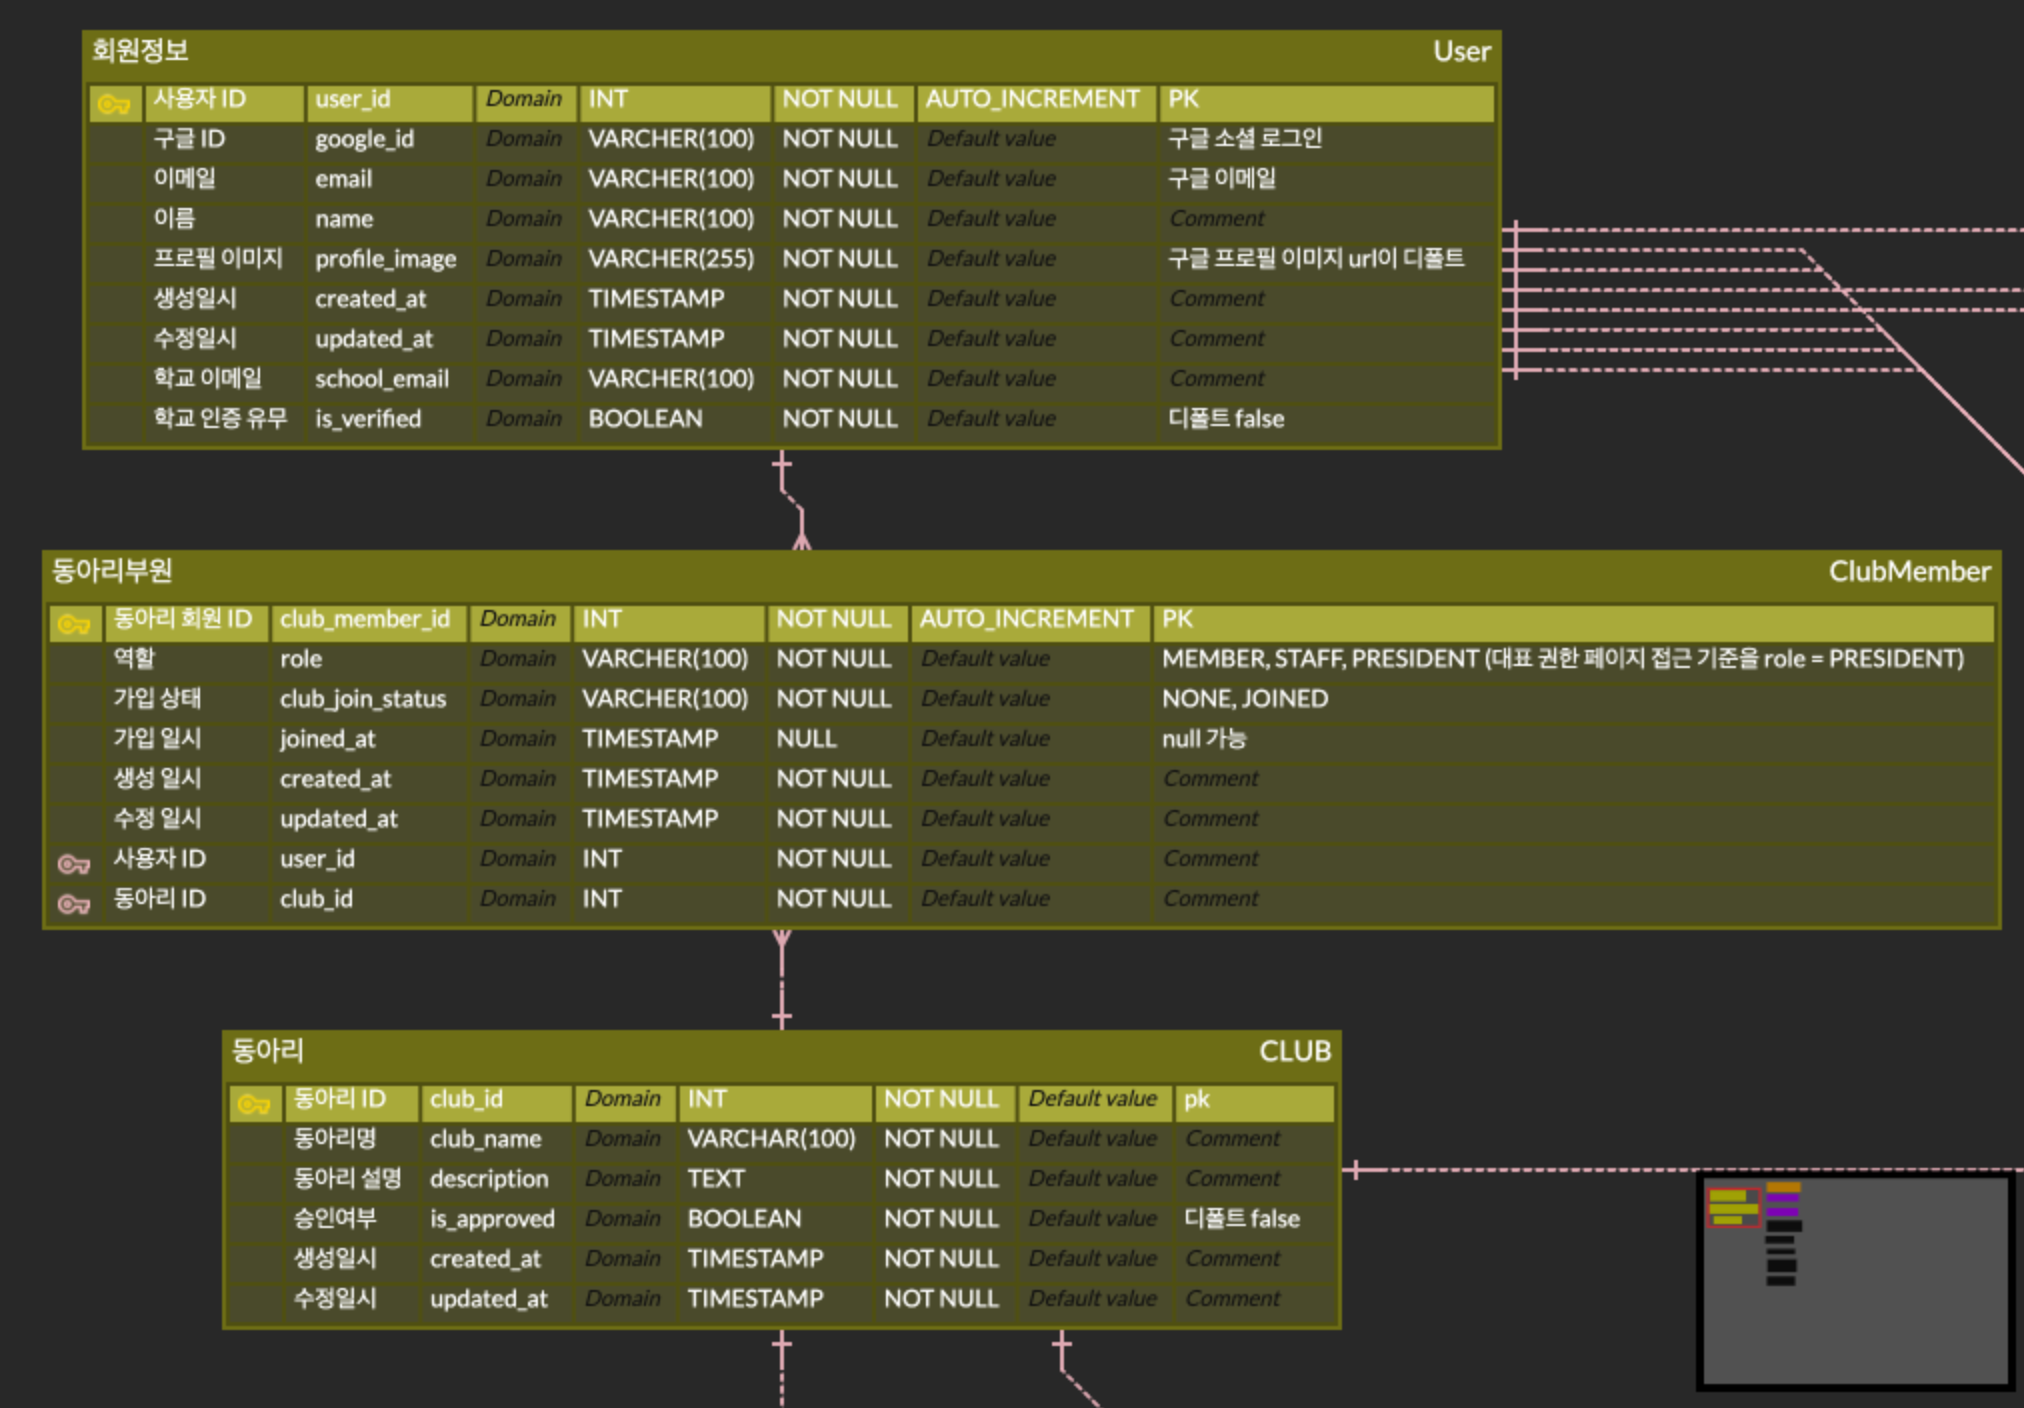
사용자 여러 명이 동아리 여러 개에 가입 가능 →
UserN :ClubM
근데 DB에서 N:M은 직접 못 써요. 그래서 중간 테이블을 만들어요.
우리 프로젝트에서 ClubMember가 바로 그 역할이에요.
| 컬럼명 | 타입 | 설명 |
|---|---|---|
club_member_id | INT | PK |
user_id | INT | FK → User |
club_id | INT | FK → Club |
role | VARCHAR | MEMBER / STAFF / PRESIDENT |
club_join_status | VARCHAR | NONE / JOINED |
joined_at | TIMESTAMP | 가입일시 (null 가능) |
user_id + club_id 두 개의 FK를 들고 있어서 User랑 Club을 연결해줘요. 덕분에 "이 사람이 어떤 동아리에 가입했는지", "이 동아리에 어떤 사람들이 있는지" 양방향으로 조회가 가능해요.
중간 테이블엔 연결 정보 외에 추가 데이터도 넣을 수 있어요.
ClubMember의role처럼요. "이 사람이 이 동아리에서 어떤 역할인지"를 같이 저장하는 거예요.
3. API 명세서 작성하기
API 명세서가 왜 필요해?
백엔드가 API 만들고 있는 동안 프론트엔드는 뭘 하냐면, 그 API 결과를 받아서 화면을 그려요. 근데 백엔드가 어떤 형태로 데이터를 줄지 모르면 프론트가 작업을 못 해요.
그래서 미리 "이 엔드포인트는 이런 요청을 받고, 이런 응답을 줄 거야" 를 문서로 정해두는 게 API 명세서예요.
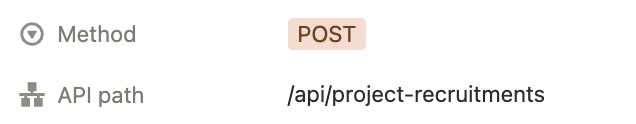
Request Body — 프론트가 백엔드한테 보내는 데이터
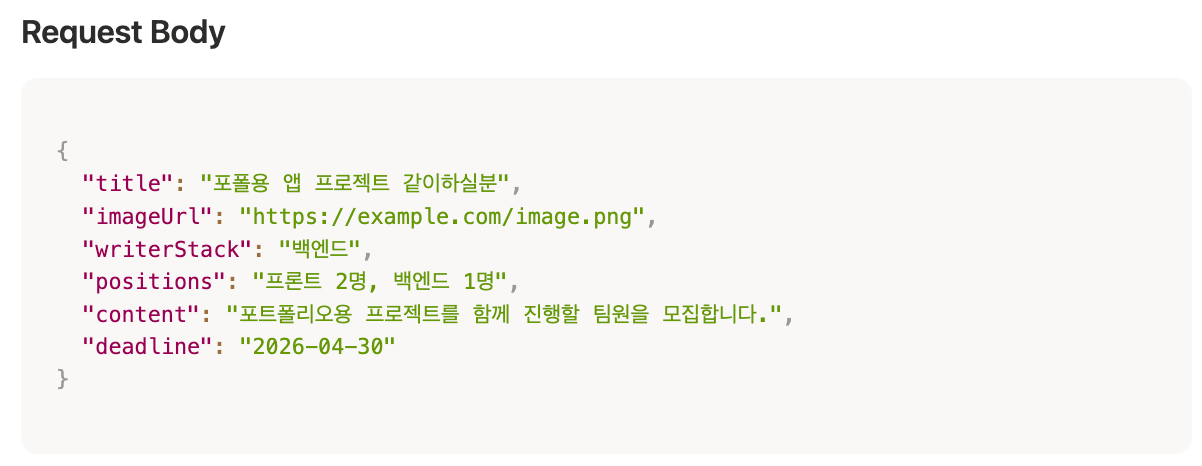
프론트가 "모집글 올려줘" 하면서 이 JSON을 담아서 보내는 거예요.
Response Body — 백엔드가 프론트한테 돌려주는 데이터
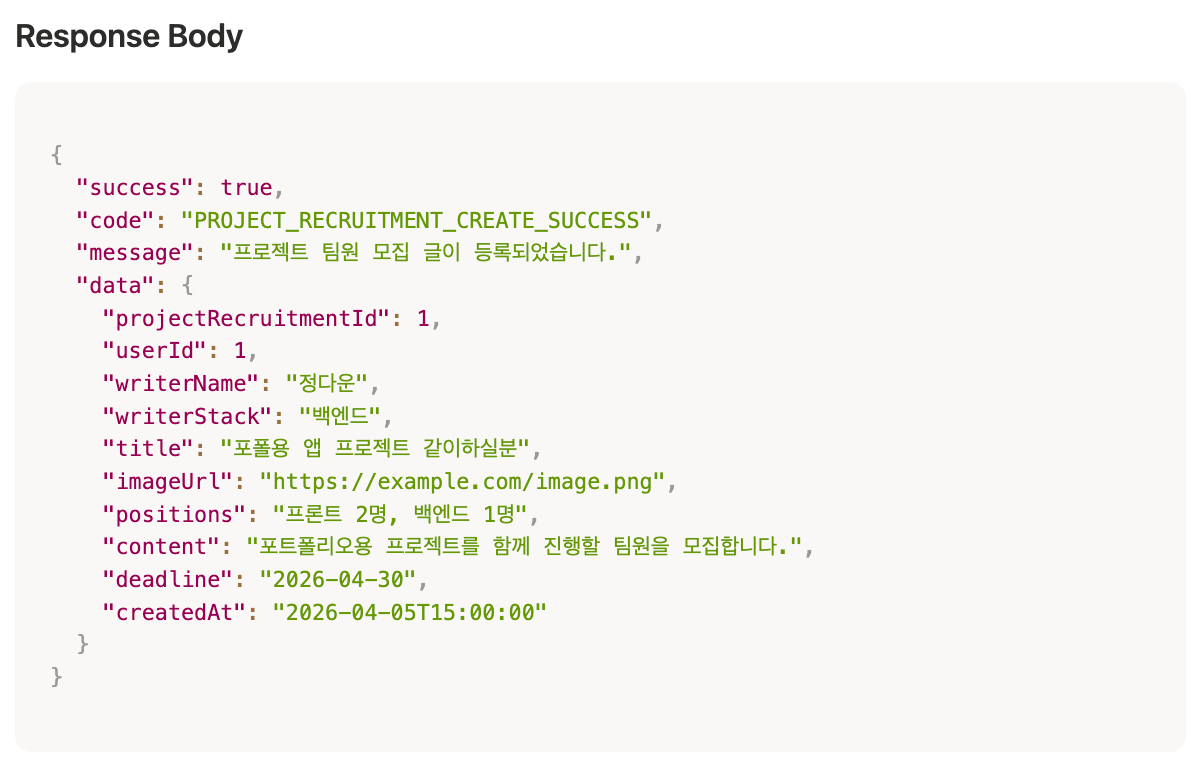
여기서 포인트가 있어요.
Request엔 없던 필드가 Response엔 생겨요.
projectRecruitmentId,writerName,createdAt같은 건 서버에서 만들어서 돌려주는 값이에요. 프론트가 보내는 게 아니에요.
응답 형식 — 팀 전체가 통일해야 합니다
이게 제일 중요해요. 저는 모든 응답을 이 4개 구조로 통일했어요.
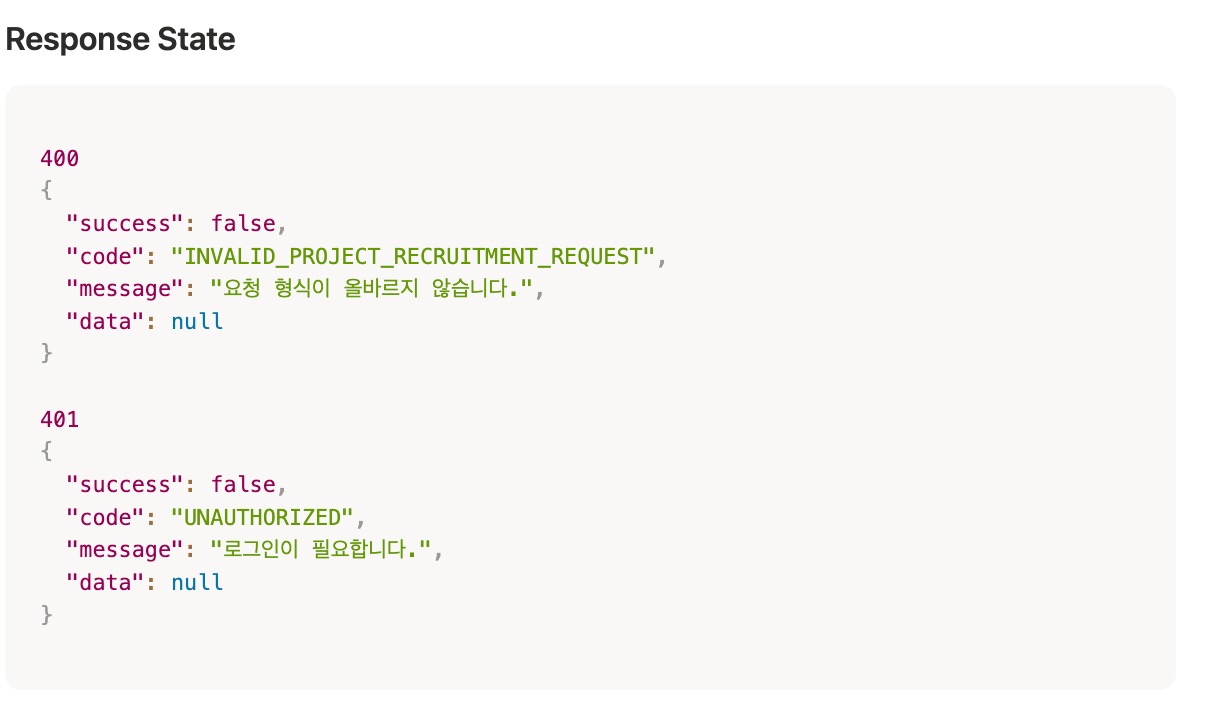
성공이면 success: true, 실패면 success: false로 바뀌고 나머지 구조는 똑같아요.
이 구조를 처음에 안 맞추면 나중에 백엔드·프론트 둘 다 전부 갈아엎어야 해요. 시작 전에 반드시 통일하세요.
스웨거와 다른점
API 명세서는 개발 전 틀 잡기!
스웨거는 테스트하며 확정된 값들 보기!
4. 개발 시작하기 (컨벤션)
혼자 만들면 상관없는데, 해커톤은 여러 명이 같은 코드베이스에서 동시에 작업해요. 규칙 없이 시작하면 나중에 코드 합칠 때 충돌나고, 누가 뭘 했는지 모르고, 구조가 뒤죽박죽 돼요.
그래서 컨벤션을 꼭 상의해야합니다.
브랜치 전략
브랜치는 "각자 작업 공간" 이에요. 규칙 없이 쓰면 나중에 합칠 때 난리나요.
저는 이렇게 쓴답니다.
main        → 최종 배포용. 여기에 직접 push 금지
develop     → 개발 통합 브랜치. 기능 다 만들면 여기에 합쳐요
feat/{이슈번호}-{기능명}  → 각자 기능 개발하는 브랜치
실제 예시:
이슈번호
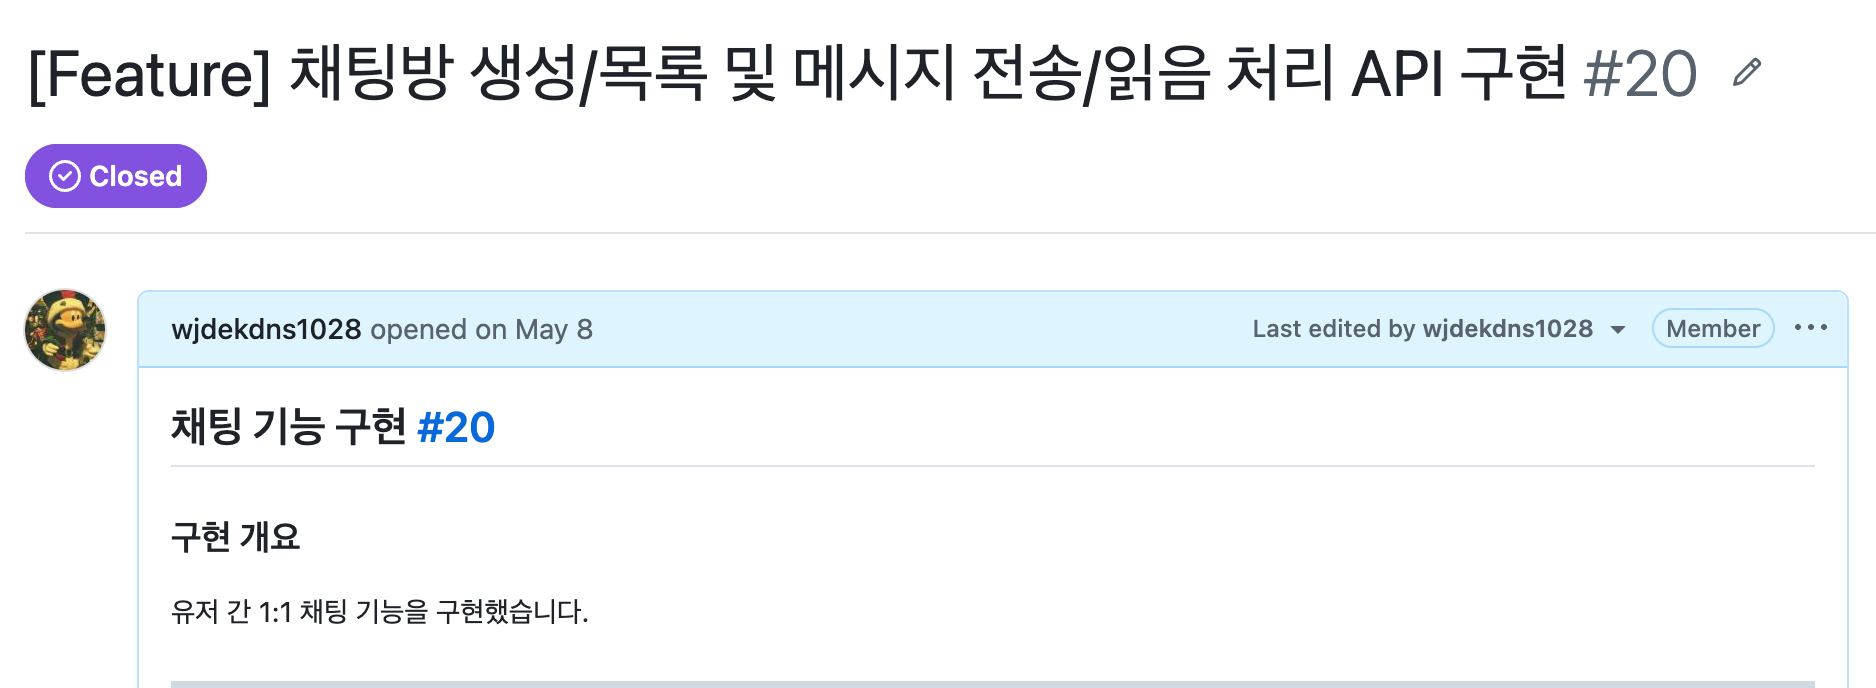
feat/20-chat실제로 쓰는 명령어:
# develop 브랜치 최신 상태로 받아오기
git checkout develop
git pull origin develop

# 새 기능 브랜치 만들고 이동
git checkout -b feat/20-chat

# 작업 후 커밋
git add .
git commit -m "feat(chat): 채팅방 생성 API 구현 #20"

# 원격 저장소에 올리기
git push origin feat/20-chat

# 이후 GitHub에서 develop으로 PR 올리기
브랜치 만들기 전에 항상
git pull먼저 해야해요.최신 코드 안 받고 작업 시작하면 나중에 충돌 엄청나요.
main에 직접 push하는 습관은 지금 당장 버리세요.
잘못 올라가면 배포 서버가 터져요.
커밋 컨벤션
커밋 메시지도 규칙 없이 쓰면 나중에 "이게 뭔 작업이지?" 알 수가 없어요.
제가 쓰는 커밋 형식:
타입(범위): 작업 내용 #이슈번호
실제 예시:
feat(user): 유저 도메인 생성 #25
자주 쓰는 타입:
| 타입 | 언제 써요 |
|---|---|
feat | 새 기능 추가 |
fix | 버그 수정 |
refactor | 코드 개선 (기능 변화 없음) |
docs | 문서 수정 |
chore | 설정 파일, 빌드 관련 |
커밋 명령어:
# 변경 파일 전체 스테이징
git add .

# 커밋
git commit -m "feat(chat): 채팅방 생성 API 구현 #20"
이슈 번호 꼭 달아요.
#20이렇게 달아두면 GitHub에서 이슈랑 커밋이 자동으로 연결돼서 나중에 추적하기 편해요.
최종적으로
최종적인 흐름으로는
- 개발할 API를 이슈로 만듭니다.
- 만든 이슈 번호를 확인 후 브랜치를 컨벤션에 맞게 만듭니다.
- 만든 브랜치에서 개발 후 push합니다.
- develop 브랜치로 pr 날려 머지 합니다. (같이 일하는 동료에게 코드리뷰 받고 머지합니다.)
- develop 브랜치에서 에러 없이 잘 적용되면 Main 브랜치에 pr 날려 머지합니다.
