AWS 람다를 사용해보았다.
- 그냥 가벼운 HTTP API 생성을 위해
- EC2를 돌릴 만큼 무거운 프로젝트는 전혀 아니었기에
비교적 단순한 편이었지만,
은근히 까다로운 스텝이 있었다...
그것은 바로 다름아닌 라이브러리 임포트.
유튜브나 벨로그, 티스토리 보면서 하면 될 거라고 생각했지만, 의외의 경우에서 계속 오류가 날 수 있었다.
그래서 한꺼번에 정리해보고자 한다.
AWS 람다란?
쉽게 설명하자면, 코드 몇 줄 적어서 바로 HTTP API를 사용할 수 있는 서비스이다.
Software as a Service(SaaS)처럼, 이 서비스는 Function as a Service(FaaS) 라고 불린다.
즉 Flask에서
@app.route
def blahblah(foo, bar):
	return "foobar"
처럼 쓸 때,
이 함수 하나를 만들어서 API 엔드포인트를 연결해 API를 뚫어주는 것과 같다.
이건 뭔가 야매식 설명이고, 배운 사람들은 이걸 Serverless라고 부르더라?
Serverless?
서버리스! 서버가 없다는 말이다.
아니, 사실 그렇지 않다 ㅠㅠ
DX(Developer Experience) 향상을 위해서 굳이 컴퓨터 하나를 둬가며 개발환경 세팅을 하고 웹에 호스팅하고 nginx 서버를 깔고... 이럴 거 없이 앞서 설명한 FaaS처럼, 서버 없이도 API를 뚫어줄 수 있는 그런 서비스를 Serverless라고 부른다.
근데 사실은, 정말 서버가 없는 것이 아니라 서버를 개발자가 생각 안 해도 되도록 편하게 만들어준 것이 바로 이 Serverless다 이런 말씀 되시겠다.
즉, 앞서 말한 개발환경 세팅, 서버 설치, 호스팅 뭐 이런 걸 누가 다 해준다? 그래 우리의 GodAmazon이 다 해준다...
아무튼!
그래서 이 유튜브를 보고(되게 설명 잘해주셨다 감사드려요),
신나게 코딩하고 있었는데...?
뙇!
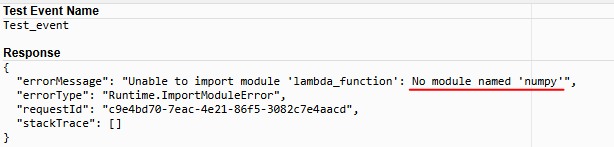
그래, 내가 모르는 뭔가가 당연히 있겠지.
생각해보면 당연했다. 아무리 Amazon이라도 pip로 설치 가능한 모든 라이브러리를 다 준비해두진 않았을 거다.
근데 그러면 어떤 방법이 있을까...?
찾아보니 계층에 라이브러리들의 zip파일을 직접 업로드하는 방법과, S3에서 가져오는 방법이 있었는데 사실 둘 다 어쨌든 수동으로 라이브러리 파일을 마운트하는 방법 같았다.
아무튼, 그래서 이것저것 블로그를 보고 하다가...
여전히 안돼서!!!
내가 한꺼번에 정리하려 이걸 만든거다.
본론
AWS에 계층 만드는거, 하라는 대로 했는데 자꾸 오류가 나요.
어떻게 해야 할까요?
이제, 딱 3가지만 주의해보자.
(이 이외의 다른 이유는 필자도 모르겠음)
1. 압축을 해제했을 때, python 폴더가 하나 있고 그 아래에 라이브러리 폴더들이 존재해야 한다.
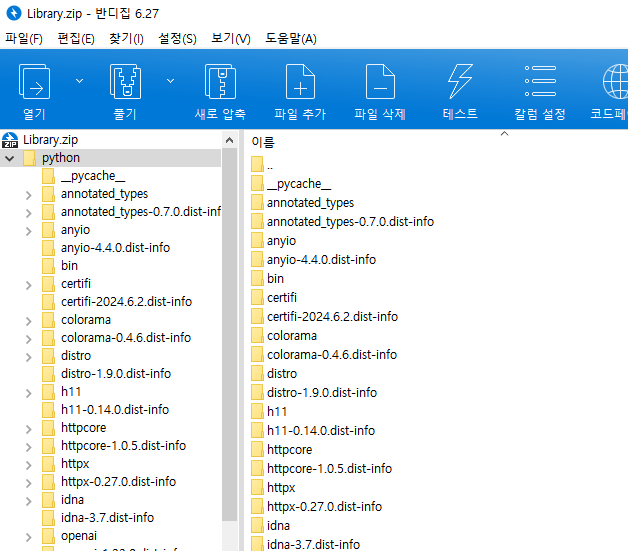
이런 식으로, zip파일에 python이라는 디렉토리가 있고 그 아래에 쫘라락 라이브러리 폴더들이 있어야 한다.
2. 라이브러리 설치 시, 아키텍처를 맞췄는가 확인해보자.
사실 뭔가 제일 많이 실수할 거 같은 부분이 이 부분이다.
필자는 서버 구축에 node.js를 사용하지 않고 python을 사용했는데,
node.js 같은 경우에는 프로젝트 경로 안에 node_modules 디렉토리가 있고 그 안에 npm 패키지(라이브러리)가 설치되지만,
파이썬의 경우에는 보통 conda 등으로 가상환경을 만들고 그 밑에 라이브러리가 설치되며, 그 가상환경으로 코드를 돌린다.
그래서 pip 등으로 설치를 하곤 하는데,
pip를 이용해 설치하면 내가 코드를 실행하는 cpu 아키텍처에 맞는 라이브러리가 자동으로 깔린다.
이렇게 설치하게 되면, aws에서 구동하는 아키텍처와 호환이 어려울 수 있다.
필자는 Windows 운영체제에서 작업하다가 AWS Lambda를 사용했는데, 여기서 호환 문제가 발생한 것 같다.
정확히는, openai 라이브러리를 굴리기 위한 pydantic_core 라이브러리에서 오류가 났다.
(스택오버플로우와 깃허브 이슈를 찾아보니 자주 있는 오류 같다)
아니, 근데.
나는 AMD64(ARM아님)를 사용하고 AWS는 x86_64를 사용하는 걸로 설정했는데 왜 오류가 난 걸까? 둘이 완벽히 호환되는 건 아닌 건가? 이건 알아봐야겠다.
pip install openai -t python
윈도우 운영체제에서는 amd64를 사용했다.
그래서 리눅스 바탕으로 사용하고 싶다면 아래 코드를 이용하면 된다.
pip install openai --platform manylinux2014_x86_64 -t python --only-binary=:all:
그러면, 이렇게 x86_64버전으로 설치되는데, binary로 설치하기도 해서 그런지 라이브러리들의 용량도 확 줄어든다.
앞으로 이 구문을 사용하여 개발환경을 세팅하고, zip파일로 옮겨보자.
3. 파이썬 버전 문제, 계층 호환 런타임 문제
의외로 파이썬 버전 문제도 많이 발생하기도 하는 것 같다. 이때는 역시 가상환경에
python --version을 입력 후 내 환경의 버전대로 람다 함수 설정을 바꿔주자.
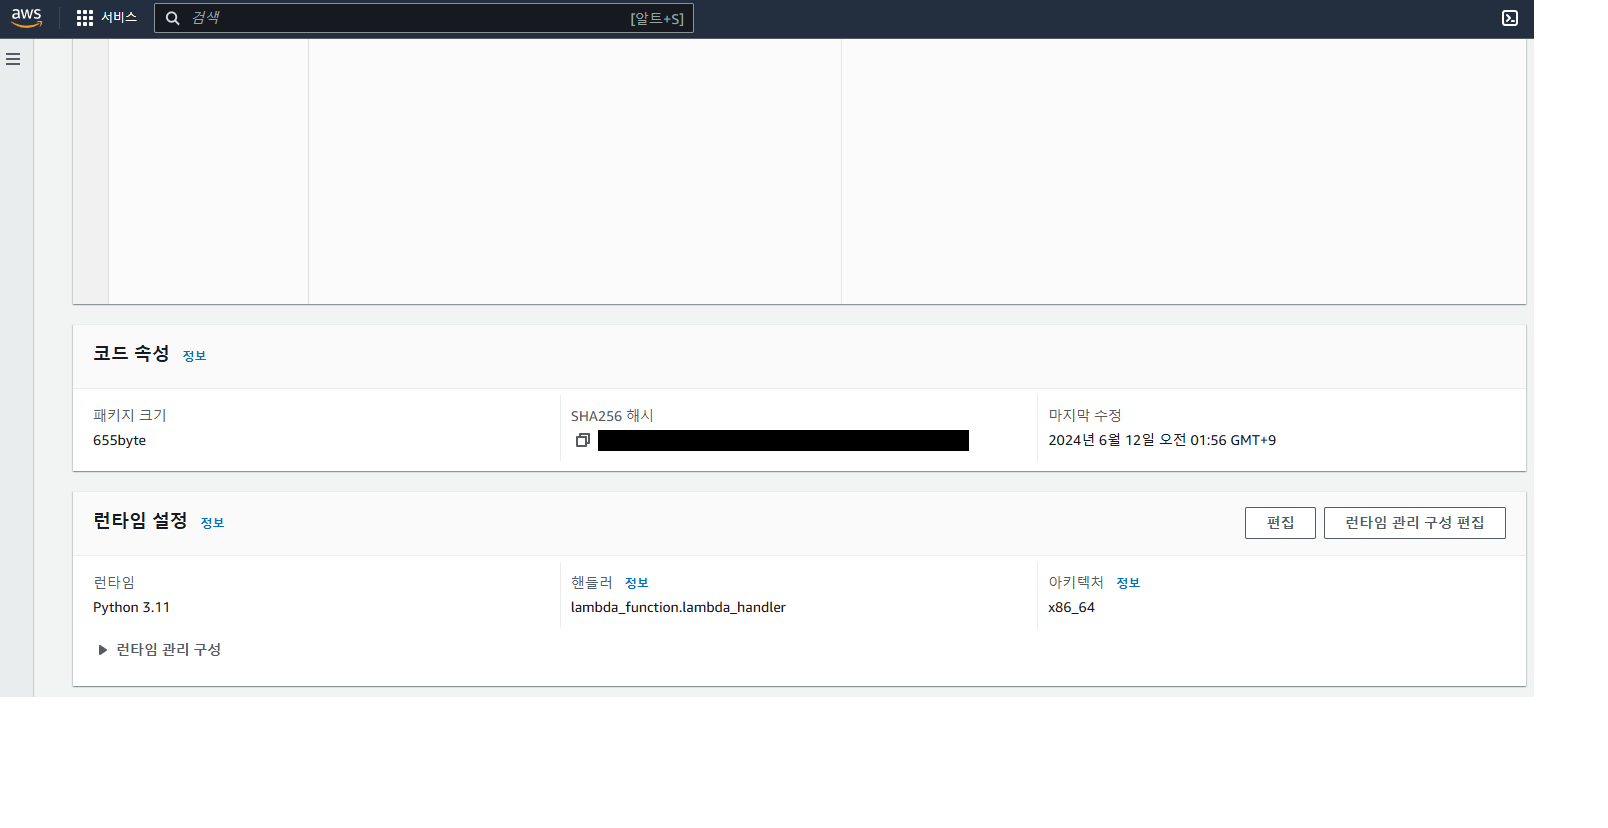
아래쪽으로 스크롤하면 런타임 설정에서 바꿀 수 있다.
그리고, 계층 호환 런타임, 호환 아키텍처 같은 거 다시 한번 확인해주자.
결론
사실, 역시 AWS Lambda도 Serverless다 뿐이지 서버가 사실은 존재한다.
그래서 라이브러리 같은 것도 이렇게 수동으로 설정해줘야 하는데, S3를 통해 라이브러리 패키지 파일을 업로드해 직접 컨테이너로 연결할 수도 있겠지만,
zip파일을 올리는 방법으로 발생할 수 있는 오류들을 알아보았다.
Serverless지만 서버에 대한 이해가 없으면 사용하기 어려울 듯한 느낌이다.
역시 코딩은 GPT 활용하는 코딩이든 뭐든, Tool이나 서비스는 단지 편리하게 해줄 뿐 그걸 모르는 채로 겉핥기식으로만 쓴다면 문제가 생길 게 뻔하다.
만약, 내가 서버와 AWS Lambda, 파이썬 등의 구동에 대해 이해하지 못한 채로 이 문제를 접했다면...?
상상도 하기 싫다.
이 간단한 HTTP API 하나 만드려고 결국엔 EC2 인스턴스 하나 생성하는 엔딩이 아니었을까.
+) 아니 그래서 왜 pydantic_core에서 오류가 자주 나는거야?
정확한 이유는 모르겠지만, 찾아보니 pydantic은 파이썬에서 data validation(데이터 유효성검사)에 자주 활용되는 라이브러리라 한다. 내가 OpenAI 라이브러리를 사용할 때 pydantic을 사용하는 걸로 보였으니 아마 OpenAI 측에서 API 통신할 때 데이터 유효성 검사에 pydantic을 활용하는 것 같다. 이때 pydantic_core는 pydantic에서 수행하는 유효성검사 및 직렬화를 효율적으로 하기 위해 만든 라이브러리 같다. 뜯어보니 자주 사용하는 함수들을 모아놓은 것 같기도.
암튼 이거 써서 엄청 속도 빨라졌다는데,
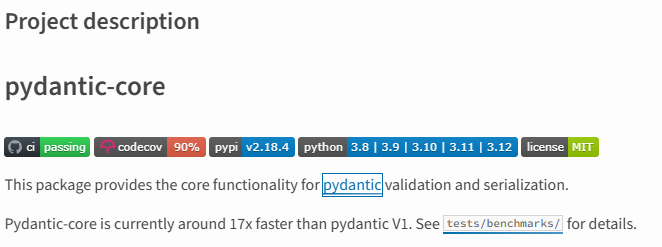
17배나 속도 빨라졌다는 거 보니까 cpu 아키텍처별로 기계코딩한 듯하다. 그래서 cpu 아키텍처의 영향을 많이 받고, 호환성 문제가 생겼나보다...