QA/QC 내일 배움 캠프 27일차
1. 통계학 기초- 다양한 분포
1. 모집단과 표본
*모집단: 관심의 대상이 되는 전체 집단. ex)한 국가의 모든 성인
*표본: 모집단에서 추출한 일부. ex)그 국가의 성인 중 일부를 조사.
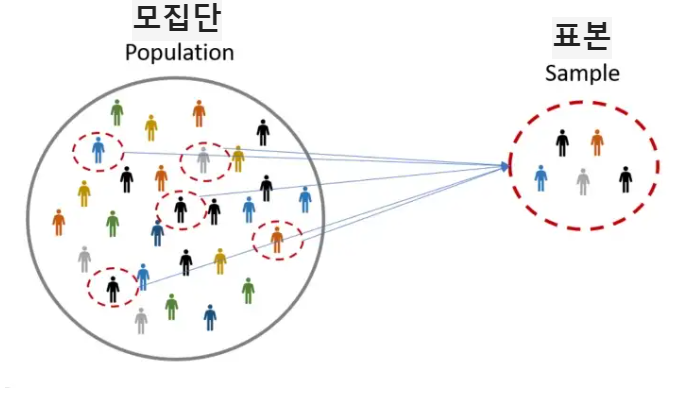
왜 표본을 사용하는가?
- 현실적인 제약: 전체 모집단을 조사하는 것은 비용과 시간이 많이 들기 때문에 대부분의 경우 불가능+ 모든 데이터를 수집하는 것이 물리적으로 불가능
- 대표성: 잘 설계된 표본은 모집단의 특성을 반영.
- 데이터 관리: 표본을 사용하는 것이 전체 데이터를 다루는 것보다 데이터 처리와 분석에 훨씬 용의.
- 모델 검증 용의: 표본 데이터를 사용하여 통계적 모델을 검증할 수 있음. 이때 모델이 표본 데이터에 잘 맞는다면, 모집단에도 잘 맞을 가능성이 높음.
전수조사와 표본조사
전수조사의 경우 모집단 전체를 조사하고, 표본 조사는 모집단에서 일부를 조사한다. 이때, 위에 내용에 따라 무조건 표본조사만 선택해서는 안되다는 것을 인지해야한다.
* 전수 조사가 적합한 경우
- 모집단이 작고 소수일 때
- 높은 정밀도가 필요할 때
- 희귀한 항목/사례 조사할 때
Ex) 인구 주택 총 조사, 자동차 브레이크 작동 여부 조사, 우주선 부품 검사 등
* 표본 조사가 적합한 경우
- 모집단이 크고 다수 일 때
- 비용 및 시간 측면에서 제약이 존재할 때
- 파괴 검사가 필요할 때
- 모집단의 정의가 불명확할 때,
Ex) 소자의 파괴검사, 시청률 조사, 사회적 인식/만족도 조사
2. 다양한 분포
1. 정규 분포
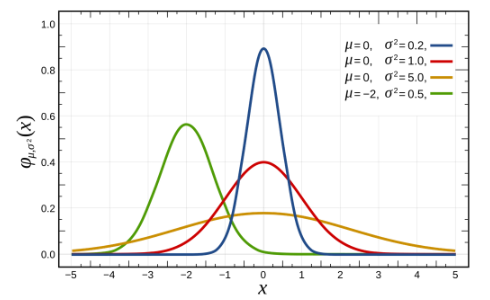
- 정규분포는 종 모양의 대칭 분포로, 대부분의 데이터가 평균 주위에 몰려 있는 분포
- 주요 요소로는 평균(), 표준 편차() 등으로 구성이 됨.
- 주요 사용처: 키와 몸무게, 시험 점수와 같이 종 모양 분포를 가질 수 있는 대부분의 데이터
2. 긴 꼬리 분포
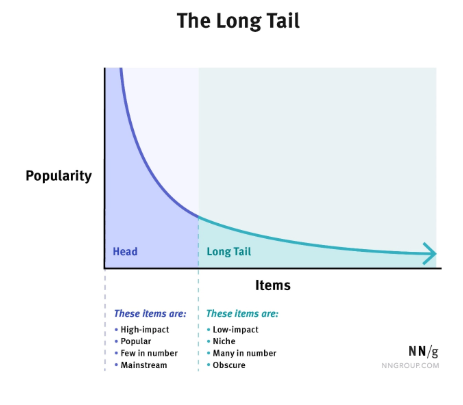
- 대부분의 데이터가 분포의 한쪽 끝에 몰려 있고, 반대쪾으로 긴 꼬리가 이어지는 분포
- 정규분포와 달리 비대칭적인 특성을 지님.
- 긴 꼬리 분포에 포함되는 분포: 파레토 분포, 지프의 법칙, 멱함수
- 주요 사용처: 소득 분포, 온라인쇼핑(인기 제품 대비 비인기 제품의 판매 기록), 도서 판매- 대부분 제품 판매 정도와 관련 있음.
3. 스튜던트 t 분포
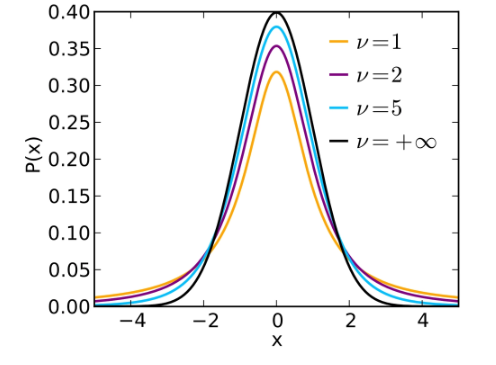
- 표본의 수가 작을 떄 정규 분포 대신 사용하는 분포
- 자유도(표본과 관련된 값)이 커질 수록 정규분포에 가까위지는 특성을 지님.
- 표본의 크기가 커지면 정규 분포에 가까워짐.
- 주요 사용처: 약물 시험, 파괴 시험.(대부분 소규모 샘플 시험이 진행되는 경우에만 사용)
4. 카이제곱분포
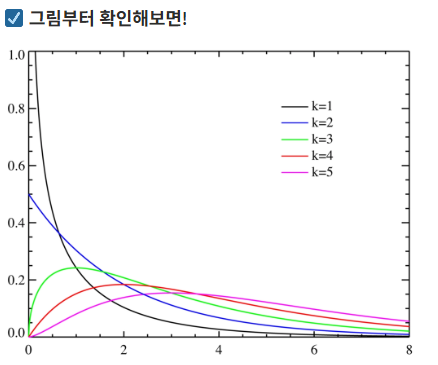
- 범주형 데이터의 독립성 검정이나 적합도 검정에 사용되는 분포
- 자유도 k값에 따라 분포가 다름(k값이 커질 수록 정규 분포에 가까워짐)
- 데이터 셋 내부에서 서로 다른 두 범주형 변수의 독립성을 판단하는 데 사용.
5. 이항 분포
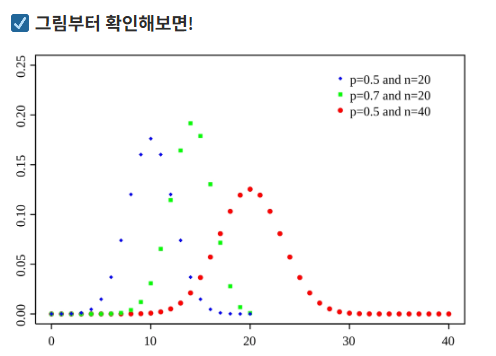
- 성공, 실패인 두가지 경우를 n번 독립적으로 반복했을 떄, 성공이 일어나는 횟수를 확률 변수로 나타낸 분포
- 연속된 값을 가지지 않고 특정한 정수 값만을 가질 수 있는 분포(이산형 분포)
- 값이 많을 수록 정규분포에 가까워짐.
- 주요 사용처: 동전 던지기, 품질 관리(불량 유무)
6. 푸아송 분포
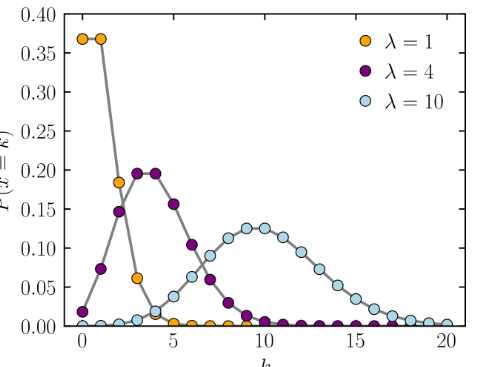
- 일정 시간, 거리, 면적 등 특정 단위 구간에서 랜덤하게 발생하는 희귀한 사건의 횟수를 모델링으로 나타낸 분포
- 평균 발생률 가 충분히 크다면, 정규 분포에 근사
- 이항 분포와 같이 연속된 값을 가지지 않기 때문에 이산형 분포에 해당.
- 주요 사용처: 콜 센터, 교통사고, 문자메시지, 웹사이트 트래픽
카이제곱 분포 집중 학습
카이제곱이란? “기대랑 실제가 얼마나 어긋났는지 점수 매긴 것”
위에 식과 같이 관측된 값이 기대값으로 부터 얼마나 떨어졌는지를 나타낼 수 있는 값.
+이걸로 어떻게 서로 독립된 값인지를 알 수 있는가?
- 가설 설정: 두 변수는 독립이다.(귀무가설)
- 가설 설정: 두 변수는 독립이다.(귀무가설)
- 기대값 생성(E)
- 기대값 생성(E)
- 실제 값(O와 비교)
- 실제 값(O와 비교)
- 판단 기준: 데이터의 자유도(k)에 해당하는 실제 분포를 통해 p-value 값을 구해야함.
* 분포는 표준화된 정규 분포와 같이 자유도에 따라 서로 다른 분포를 가지고 있음. 그러므로 분포를 수행하기 위해서는 자유도 값을 반드시 찾아야함.
- 판단 기준: 데이터의 자유도(k)에 해당하는 실제 분포를 통해 p-value 값을 구해야함.
실습.
- 데이터 셋: seaborn 라이브러리에 포함된 tips 데이터 셋 활용.
import seaborn as sns
import pandas as pd

tips = sns.load_dataset('tips')
tips.head()

table = pd.crosstab(tips['sex'], tips['smoker'], margins=True, margins_name="합계" )
table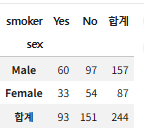
- 가설 설정: 두 변수는 서로 독립이다.(H0)
- 기대 값 생성
cross=table.copy()

for i in range(cross.shape[1]-1):
    for j in range(cross.shape[0]-1):
        cross.iloc[j,i]=round((table.iloc[j,2]*table.iloc[2,i])/table.iloc[2,2],2)

cross.iloc[:2,:2]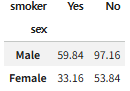
이미지와 같이 기대값을 작성.
- 실제 값( 값)
answer=0
for i in range(cross.shape[1]):
    for j in range(cross.shape[0]):
        answer+=(table.iloc[j,i]-cross.iloc[j,i])**2/cross.iloc[j,i]
print(answer)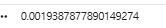
- 5.자유도(k)k=1인 정규 분포에서 의 위치를 시각화 할 경우 아래와 같아진다.
# 카이제곱분포 생성
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats
chi2_dist = np.random.chisquare(df=1, size=1000)
from scipy.stats import chi2

# 히스토그램으로 시각화
plt.hist(chi2_dist, bins=30, density=True, alpha=0.6, color='m')

# 카이제곱 5% 위치
critical_value = chi2.ppf(0.95, df=1)

# 카이제곱분포 곡선 추가
x = np.linspace(0, 10, 100)
p = stats.chi2.pdf(x, df=1)
plt.plot(x, p, 'k', linewidth=2)
plt.title('카이제곱 분포 히스토그램')
plt.axvline(x=0.0019387877890149274, color='r', linestyle='--', linewidth=2)
plt.axvline(x=critical_value, color='k', linestyle='--', linewidth=2)
plt.show()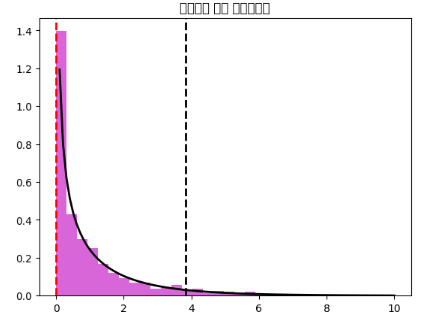
검은선: 귀무가설의 기각 영역(p-value=0.05 지점)
빨간선: 실제 tips 자료에서 성별, 담배 여부에 대한 값위치
+ 카이제곱 분포의 기각역은 늘 오른쪽에 존재!
- 분석결과: 카이제곱 값의 경우 기각역 내부에 있었기에 성별과 담배 여부는 서로 독립적인 관계에 있다고 볼 수 있다.(귀무가설을 기각하지 않는다.)
또 다른 방법
from scipy.stats import chi2_contingency

chi2, p, dof, expected = chi2_contingency(table)

print("chi2:", chi2)
print("p-value:", p)
print("자유도:", dof)
print("기대값:\n", expected)
scipy.stats에서 chi2_contingency 라이브러리를 불러올 경우 chi2_contingency(table)을 통해 , p-value, 자유도, 기대값을 모두 가져올 수 있음.

QA/QC 전문가를 목표로!