운영환경에서 문제 발생
운영환경 특성상 아침 9~10시에 트래픽이 가장 몰린다. 전날 등록된 여러 작업들이 일괄로 처리되고 사용자 대부분이 직장인이라 피크 시간대가 항상 일정하다.
이 시간대에 간헐적으로 특정 작업 처리가 실패하는 이슈가 발생하였는데 원인을 찾아 해결하기까지의 과정을 남겨보고자 한다.
분석 및 계획
가장 처음 파악했던 건 Slow Query 로그였다. 이유는 앞선 정보들을 토대로 판단했다.
- 작업 실패가 피크 시간대에서만 발생한다는 점
- 동일한 작업이 간헐적으로 실패한다는 점
- 운영환경의 HW Spec에 여유가 충분했다는 점
1번과 2번으로 보아 비즈니스 로직 에러보다는 성능적인 이슈라는 점을 눈치챌 수 있었다. 로직 결함이면 부하와 무관하게 재현되어야 한다.
3번의 정보로 보아, 전반적인 처리량 부족이 아니라 특정 작업이 자원을 과점하는 문제일 수도 있다고 생각했다.
추가적으로 Lock_time 0.000066 락 대기가 사실상 0이므로 락 경합·데드락은 우선순위에서 밀렸다.
그렇기에 Application Layer보다 DB Layer 또는 커넥션을 먼저 보기로 했다.
Slow Query ANALYZE 로그 결과
Batch Job은 2분마다 트리거되며 평균 25.64초 걸리고 있었다.
피크타임 + 무거운 작업 + DB Connection 점유로 인해 다른 작업 ( 대규모 Insert 작업 ) 이 실패하게 되는 현상으로 파악하였다. 이는 API Log로도 확인되었다.
- PK Full-Scan : 8847만건
- Lock_time : 0.000066
- Query_time : 25.287701

# explain: 1   PRIMARY       <derived2>   ALL     NULL          NULL     NULL                   33445280   0.00        100.00    100.00      Using where
# explain: 2   DERIVED       A            index   PRIMARY       11       NULL                   103799010  88475063.00 0.26      0.18        Using where
# explain: 2   DERIVED       <subquery3>  eq_ref  distinct_key  4        func                   1          0.81        100.00    100.00
# explain: 2   DERIVED       Y            eq_ref  PRIMARY       4        TABLE_NM   1          1.00        100.00    0.06        Using where
.... etc...
1차 튜닝 - 계획
- 탐색을 8847만 행에서 시작하지 않도록 구동 테이블 재설정
- 통과율 0.06%인 필터조건이 EXISTS 밖에서 수행되도록 쿼리 구조 변경
즉, 인덱스를 재설정하기보단 쿼리 구조를 최적화하도록 결정하였다.
(DDL문을 운영에 추가하는 것을 지양하는 팀 정책도 고려되었다)
1차 튜닝 - 결과
① 운영 실측 — 4배 악화
| 구분 | 읽은 행 | 소요 시간 |
|---|---|---|
| 원본 쿼리 | 88,475,063 | 약 20초 |
| 1차 튜닝안 | 약 240,000 | 80.37초 |
| 변화 | 368배 감소 | 4배 악화 |
결과적으로 튜닝 실패다....
물리적인 탐색 행은 368배가 감소하였지만 쿼리 소요 시간은 80초가 걸렸고 4배 악화되었다. 이후 Cache warm 상태에서는 약 1초가량 소요된다.
연산 문제였다면 캐시 상태와 무관하게 항상 같은 시간이 걸렸어야 한다. 그런데 cold 80초, warm 1초로 80배 차이가 났다. 연산이 아니라 Data I/O가 핵심 문제였던 것이다.
Warm Cache에서는 Slow Query가 발생 안 한다고 해서 성공했다고 볼 수 없다. Cache가 제거된 순간 동일한 문제가 발생한다. 임시방편보다는 더욱 정교한 튜닝이 필요했음으로 1차 튜닝은 실패했다.
하지만 긍정적인 부분도 있다.
Query ANALYZE
id  select_type   table        type    key       key_len  rows    r_rows    r_filtered

1   PRIMARY       Y            index   PRIMARY   4        81292   80408.00  0.10       ← 구동 역전 성공

1   PRIMARY       <subquery2>  eq_ref  distinct_key 4     1       0.61      100.00

1   PRIMARY       I            ref     PRIMARY   4        150     1607.94   0.12

2   MATERIALIZED  X            ref     ..._FK01  4        132118  80408.00  81.48      ← 8만 행 임시테이블 생성
의도했던 구동 테이블 역전은 성공했다. 탐색하는 물리적인 행 수도 줄었다.
하지만 여전히 8만 행을 index-fullscan으로 탐색 및 옵티마이저가 Materialization을 선택해 실행계획을 세웠고, 랜덤 액세스 + 8만 행 임시테이블 생성이 겹쳐 cold 상태 소요 시간이 느리게 나온 것이다.
원본 쿼리에서는 서브쿼리를 15.9만 번 조회해야 했으므로 8만 행 임시테이블 생성은 합리적인 선택이었다. 하지만 튜닝으로 필터 조건을 앞으로 당기자 그 횟수가 80번까지 줄었다. 80번 조회하자고 8만 행 임시테이블을 만드는 것은 손익분기점에 한참 못 미친다.
옵티마이저가 Materialization 선택한 이유
-- 1차 (semi-join materialization 발생)
AND      EXISTS (SELECT   1
                FROM     USER X
                WHERE    X.USER_NO = Y.USER_NO
                AND      X.USER_CODE = 10
                AND      X.USER_VALUE = 'Y')
MariaDB는 EXISTS를 그대로 실행하지 않고 semi-join으로 변환한 후 Optimizer 네가지 전략중 하나를 고른다.
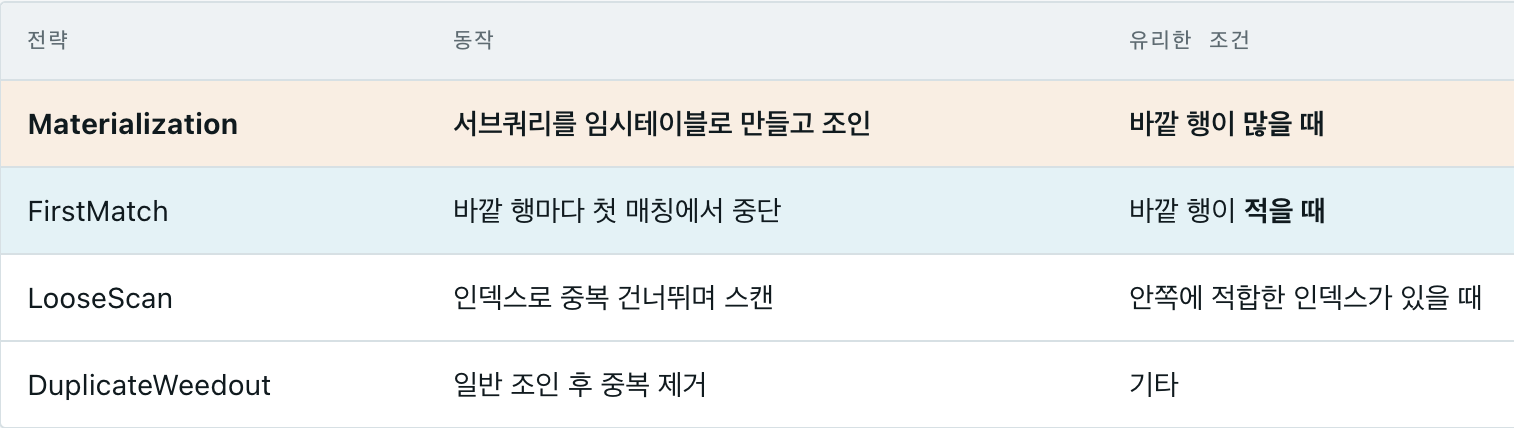
운영환경에서 Optimizer는 바깥 행이 8만 건이라고 추정했다. 그만큼 반복 액세스할 것으로 보고 임시테이블을 만든 것이다.
key_len  rows    r_rows      filtered  r_filtered
4        81292   80408.00    100.00    0.10
filtered 100은 조건이 전부 통과한다는 추정이고,r_filtered 0.10이 실측이다.
하지만 구동 테이블에 8만 행이 쌓여 있었어도 필터를 통과한 것은 80개뿐이었으므로
Materialization 손익분기점을 넘지 못했다.
1차 결론
- 구동 테이블에 8만 행이 쌓여 있었지만, r_filtered 0.10% 필터를 통과한 것은 80행뿐
- 8만 행 임시테이블을 만들어 80번 조회하는 것은 손익분기점에 못 미친다
Optimizer가 Materialization을 선택하지 못하도록 강제성을 부여하는 튜닝이 필요하다.
결론적으로 성공적인 튜닝이 되려면 작업 실행 정책과 성질 + Optimizer의 판단 메커니즘까지 함께 봐야 한다.
2차 쿼리 튜닝 - 계획
-- 2차 (semi-join 변환 대상 아님 → 바깥 행수만큼만 수행)
AND      ( SELECT 1
           FROM   USER X
           WHERE  X.USER_NO = Y.USER_NO
           AND    X.USER_CODE = 10
           AND    X.USER_VALUE = 'Y'
           LIMIT  1 ) = 1
기존 EXISTS + Materialization을 제거하고, 바깥 행 수만큼 실행되는 스칼라 서브쿼리로 변경했다.
변경은 한 줄이지만 두 가지 효과를 얻을 수 있었다. 8만 행 규모의 임시테이블 생성이 사라졌고, 임시테이블이 조인 대상에서 빠지면서 옵티마이저가 조인 순서를 다시 계산해 I를 range scan으로 구동하게 됐다. 1차에서 얻었던 Y 구동은 원복되었지만, 접근 방식이 type=index(인덱스 풀스캔)에서 type=range(구간만)로 바뀌어 스캔은 8,847만에서 16만 행으로 줄었다.
이론적으로 스칼라 서브쿼리는 지양하라고 배워왔다. 하지만 운영환경과 작업의 특수성, 그리고 임시테이블 생성의 손익분기점을 고려하면 이쪽이 최적이라고 판단했다.
1차 결과에서 80,408 × 0.10% = 약 80번. 스칼라 서브쿼리를 80번 실행하는 쪽이, 8만 행 임시테이블을 만들어 놓고 80번 조회하는 것(조회 자체는 거의 공짜ㅎㅎ..)보다 싸고 예측 가능하다.
2차 쿼리 튜닝 - 결과
id  select_type         table  type    rows    r_rows
1   PRIMARY             I      range   164883  160590.00
etc.....
2   DEPENDENT SUBQUERY  X      ref     1       1.00
DEPENDENT SUBQUERY로 실행계획이 설정된 것을 확인할 수 있다.
| 지표 | 개선 전 | 개선 후 | 개선율 |
|---|---|---|---|
| 소요 시간 | 25.64초 | 3.16초 | 8.11배 · 87.7% ↓ |
| 테이블 스캔 행 수 | 88,475,063 | 160,830 | 550배 · 99.8% |
후기
1일 기준 - 최적화 통계
| 항목 | 개선 전 | 개선 후 | 절감 |
|---|---|---|---|
| 일일 DB 점유 시간 | 5시간 8분 | 38분 | 4시간 30분 |
| 일일 누적 읽기 행 | 637억 | 1.16억 | 636억 행 |
| 회당 소요 시간 | 25.64초 | 3.16초 | 22.48초 |
TIL
- 옵티마이저의 선택이 최적이 아닐 수 있다.
- 쿼리 튜닝의 시작점은 해당 기능의 특징과 운영환경까지 파악하는 것이다.
- 추정치로 튜닝하지 말자,
log_slow_verbosity=explain설정하여r_rows와r_filtered의 실측값을 기반으로 작업하자.
3줄 요약
- 2분 주기 Batch Job이 회당 25초 이상 — 구동 테이블 index-fullscan (8,847만 행)
- 1차 : 파생 테이블 제거 + 구동 테이블 변경(8만 행 Full-Scan) → Materialization 병목으로 실패
- 2차 : EXISTS 제거로 Materialization 차단 → Range-Scan 전환(16만 행) 성공